

Opmerking vertaler.: Hier zijn de technische details over de redenen voor de recente uitval van de cloudservice, beheerd door de makers van Grafana. Dit is een klassiek voorbeeld van hoe een nieuwe en ogenschijnlijk uiterst nuttige functie, bedoeld om de kwaliteit van de infrastructuur te verbeteren, schadelijk kan zijn als niet goed rekening wordt gehouden met de vele nuancen van het gebruik in production. Het is geweldig wanneer dergelijke materialen verschijnen, die ons in staat stellen niet alleen van onze eigen fouten te leren. De details - in de vertaling van deze tekst door de vice-president product van Grafana Labs.
Op vrijdag 19 juli functioneerde de Hosted Prometheus-service in Grafana Cloud ongeveer 30 minuten niet. Mijn excuses aan alle klanten die door deze storing zijn getroffen. Onze taak is om de juiste monitoringtools te bieden, en we begrijpen dat hun onbeschikbaarheid uw leven bemoeilijkt. We nemen dit voorval zeer serieus. In deze notitie wordt uitgelegd wat er is gebeurd, hoe we hebben gereageerd en wat we doen om ervoor te zorgen dat dit niet opnieuw gebeurt.
Achtergrond
De Grafana Cloud Hosted Prometheus-service is gebaseerd op — het CNCF-project voor het creëren van een horizontaal schaalbare, zeer beschikbare, multi-tenant Prometheus-service. De Cortex-architectuur bestaat uit een set afzonderlijke microservices, die elk hun eigen functie vervullen: replicatie, opslag, aanvragen, etc. Cortex is actief in ontwikkeling, er komen voortdurend nieuwe mogelijkheden en de prestaties worden verbeterd. We implementeren regelmatig nieuwe versies van Cortex in clusters, zodat klanten gebruik kunnen maken van deze mogelijkheden - gelukkig kan Cortex zonder uitvaltijd worden bijgewerkt.
Voor uitvaltijdloze updates vereist de Ingester van Cortex een extra replica van de Ingester tijdens het bijwerkingsproces. (Opmerking vertaler.: — de basiscomponent van Cortex. Zijn taak is om een constante stroom van samples te verzamelen, deze te groeperen in chunks van Prometheus en op te slaan in een database zoals DynamoDB, BigTable of Cassandra. Dit stelt oude Ingester's in staat om actuele gegevens naar nieuwe Ingester's door te sturen. Het is belangrijk op te merken dat Ingester's veeleisend zijn qua middelen. Voor hun werking is het nodig om 4 cores en 15 GB geheugen per pod te hebben, dat wil zeggen 25% van de verwerkingskracht en het geheugen van de basismachine in onze Kubernetes-clusters. Over het algemeen hebben we meestal veel meer ongebruikte middelen in het cluster dan 4 cores en 15 GB geheugen, dus kunnen we deze extra Ingester's gemakkelijk uitvoeren tijdens updates.
Echter, het komt vaak voor dat er tijdens normaal gebruik geen van deze 25% ongebruikte middelen op een van de machines beschikbaar zijn. Ja, en we streven er ook niet naar: CPU en geheugen zijn altijd nuttig voor andere processen. Om dit probleem op te lossen, hebben we besloten om gebruik te maken van . Het idee is om Ingester's een hogere prioriteit toe te kennen dan andere (stateless) microservices. Wanneer we een extra (N+1) Ingester moeten opstarten, stoten we tijdelijk andere, kleinere pods uit. Deze pods worden verplaatst naar beschikbare middelen op andere machines, zodat er voldoende ruimte ontstaat voor het opstarten van de extra Ingester.
Op donderdag 18 juli hebben we vier nieuwe prioriteitsniveaus in onze clusters uitgerold: kritisch, hoog, gemiddeld en laag. Ze werden ongeveer een week getest in een intern cluster zonder klantverkeer. Standaard kregen pods zonder opgegeven prioriteit gemiddeld prioriteit, voor Ingester's werd een klasse met hoge prioriteit geplaatst. Kritisch werd gereserveerd voor monitoring (Prometheus, Alertmanager, node-exporter, kube-state-metrics, enz.). Onze configuratie is openbaar, en je kunt de PR bekijken .
Storing
Op vrijdag 19 juli startte een van de ingenieurs een nieuwe dedicated Cortex-cluster voor een grote klant. De configuratie voor deze cluster sloot de nieuwe pod-prioriteiten niet in, zodat alle nieuwe pods de standaard prioriteit kregen - gemiddeld.
In het Kubernetes-cluster waren er onvoldoende middelen voor de nieuwe Cortex-cluster, en de bestaande productiecluster Cortex was niet bijgewerkt (Ingester's hadden geen hoge prioriteit). Aangezien de Ingester's van de nieuwe cluster standaard gemiddeld prioriteit hadden, en de bestaande pods in productie helemaal zonder prioriteit werkten, stoten de Ingester's van de nieuwe cluster de Ingester's uit de bestaande productiecluster Cortex uit.
De ReplicaSet voor de verdrongen Ingester in het productiecluster heeft de verdrongen pod gedetecteerd en een nieuwe aangemaakt om het opgegeven aantal kopieën te handhaven. De nieuwe pod kreeg standaard gemiddeld prioriteit, waardoor een andere 'oude' Ingester in productie zijn middelen verloor. Het resultaat was een sneeuwbaleffect, dat leidde tot de verdringing van alle pods met Ingester voor de productieclusters van Cortex.
Ingester's zijn stateful en bewaren gegevens van de afgelopen 12 uur. Dit stelt ons in staat om ze efficiënter te comprimeren voordat ze naar de langdurige opslag worden geschreven. Hiervoor voert Cortex sharding van gegevens uit over series, met behulp van een gedistribueerde hash-tabel (Distributed Hash Table, DHT), en repliceert elke serie naar drie Ingester's met behulp van quorumconsistentie in de stijl van Dynamo. Cortex schrijft geen gegevens naar Ingester's die zijn uitgeschakeld. Daarom, wanneer een groot aantal Ingester's de DHT verlaat, kan Cortex niet zorgen voor voldoende replicatie van de records en vallen ze 'uit'.
Detectie en oplossing
Nieuwe meldingen van Prometheus op basis van het 'foutbudget' (error-budget-based — details volgen in een toekomstige artikel) begonnen alarm te slaan na 4 minuten na het begin van de uitval. Gedurende de volgende ongeveer vijf minuten voerden we diagnostiek uit en schalen het onderliggende Kubernetes-cluster op om zowel nieuwe als bestaande productieclusters te plaatsen.
Vijf minuten later hadden de oude Ingester's met succes hun gegevens geschreven, en de nieuwe waren opgestart, waardoor de Cortex-clusters weer toegankelijk waren.
Nog eens 10 minuten gingen voorbij aan diagnostiek en het oplossen van out-of-memory (OOM) fouten van de reverse proxy-authenticatieservers voor Cortex. De OOM-fouten werden veroorzaakt door een tienvoudige toename van QPS (vermoedelijk door overmatig agressieve verzoeken van de Prometheus-clientservers).
Gevolgen
De totale duur van de uitval was 26 minuten. Gegevens gingen niet verloren. Ingester's hebben met succes alle in-memory-gegevens in de langdurige opslag geladen. Tijdens de uitval hebben de Prometheus-servers van de klanten de verwijderde (remote) records in de buffer opgeslagen via op basis van WAL (geschreven door van Grafana Labs) en herhaalden de mislukte records na de storing.
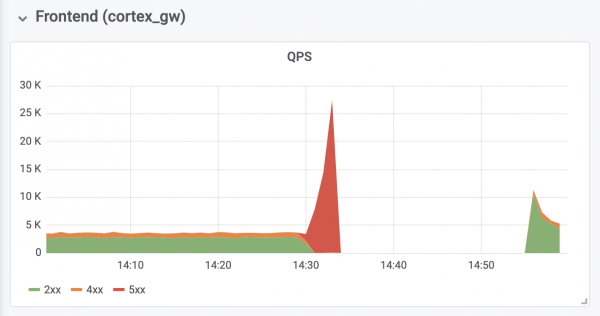
De schrijfoperaties van het productiecluster
Conclusies
Het is belangrijk om lessen te trekken uit dit voorval en de nodige maatregelen te nemen om herhaling te voorkomen.
Bij het terugkijken moeten we erkennen dat we de prioriteit niet standaard hadden moeten instellen gemiddeld totdat alle Ingester's in productie deze hadden gekregen hoog prioriteit. Daarnaast hadden we beter voor hun hoge prioriteit kunnen zorgen. Nu is alles opgelost. We hopen dat onze ervaring andere organisaties zal helpen die overwegen gebruik te maken van pod-prioriteiten in Kubernetes.
We zullen een extra niveau van controle toevoegen bij de implementatie van eventuele aanvullende objecten waarvan de configuraties globaal zijn voor het cluster. Voortaan zullen dergelijke wijzigingen beoordeeld worden doorgroter publiek.meer mensen. Bovendien werd de wijziging die tot de storing leidde als te onbeduidend beschouwd voor een afzonderlijk projectdocument — deze werd alleen besproken in een GitHub-issue. Voortaan zullen alle dergelijke configuratiewijzigingen vergezeld gaan van de bijbehorende projectdocumentatie.
Tenslotte zullen we het schalen van de authenticatie reverse proxy automatiseren om OOM-gevallen bij overbelasting te voorkomen, waarvan we getuige waren, en we zullen de standaard Prometheus-instellingen met betrekking tot terugrollen en schaling analyseren om in de toekomst soortgelijke problemen te vermijden.
De ervaren storing had ook enkele positieve gevolgen: met de benodigde middelen herstelde Cortex zich automatisch zonder extra tussenkomst. Ook verkregen we waardevolle ervaring met — onze nieuwe logaggregatiesysteem, — dat hielp te bevestigen dat alle Ingester's zich correct gedroegen tijdens en na de storing.
P.S. van de vertaler
Lees ook op onze blog:
- «»;
- «»;
- «»;
- «».
Bron: habr.com
