

Dit jaar plannen we om de thema's rond containers serieus uit te breiden, en . Een logische aanvulling op deze thema's is een verhaal over het Quarkus-framework, dat al op Habr. Dit artikel is niet alleen gewijd aan de werking van "subatomaire supersnelle Java", maar ook aan de kansen die Quarkus biedt voor Enterprise.
Java en de JVM zijn nog steeds extreem populair, maar bij het werken met serverloze technologieën en cloud-georiënteerde microservices worden Java en andere talen voor de JVM steeds minder vaak gebruikt, omdat ze te veel geheugengebruik en een te traag opstarten hebben, waardoor ze slecht geschikt zijn voor gebruik in kortdurende containers. Gelukkig begint deze situatie momenteel te veranderen dankzij Quarkus.
Supersnelle subatomaire Java heeft een nieuw niveau bereikt!
42 releases, 8 maanden gemeenschapswerk en 177 geweldige ontwikkelaars – het resultaat hiervan was de uitgave in november 2019 , een release die een belangrijke mijlpaal in de ontwikkeling van het project markeert en een heleboel geweldige functies en mogelijkheden biedt (meer hierover is te lezen in ).
Vandaag zullen we uitleggen hoe Quarkus de modellen van imperatief en reactief programmeren verenigt op basis van een enkele reactieve kern. We beginnen met een korte geschiedenisles, en daarna zullen we gedetailleerd bespreken wat de dualiteit van de reactieve kern van Quarkus inhoudt en hoe -ontwikkelaars gebruik kunnen maken van deze voordelen.
, en -functies – dit alles is tegenwoordig, zoals men zegt, in opkomst. Onlangs is het maken van cloud-georiënteerde architecturen veel eenvoudiger en toegankelijker geworden, maar de problemen blijven bestaan – vooral voor Java-ontwikkelaars. Bijvoorbeeld, bij serverless-functies en microservices is er een dringende noodzaak om de opstarttijd te verkorten, het geheugenverbruik te verlagen en de ontwikkeling ervan gemakkelijker en aangenamer te maken. Java heeft de afgelopen jaren enkele verbeteringen doorgevoerd, zoals geoptimaliseerde functionaliteit voor containers en dergelijke. Toch blijft het moeilijk om Java goed te laten werken in een container. Daarom beginnen we met een bespreking van enkele van de interne complicaties van Java, die zich bijzonder duidelijk manifesteren bij de ontwikkeling van container-georiënteerde Java-toepassingen.
Laten we beginnen met de geschiedenis.
Stromen en containers
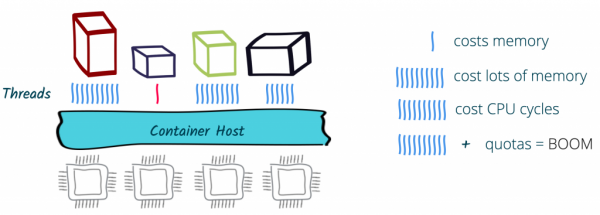
Vanaf versie 8u131 begon Java redelijk goed containers te ondersteunen door verbeteringen in de ergonomische functionaliteit. In het bijzonder weet de JVM nu op hoeveel processorkernen zij draait, en kan zij de thread pools dienovereenkomstig afstemmen – doorgaans fork/join pools. Dit is natuurlijk geweldig, maar stel dat we een traditioneel webapplicatie hebben die gebruikmaakt van HTTP-servers en draait op Tomcat, Jetty enzovoort. Het resultaat is dat deze applicatie voor elk verzoek een aparte thread aanmaakt en deze thread laat blokkeren tijdens het wachten op in- en uitvoeroperaties, bijvoorbeeld bij het benaderen van een database, bestanden of andere services. Dit betekent dat de grootte van zo'n applicatie niet afhankelijk is van het aantal beschikbare kernen, maar van het aantal gelijktijdige verzoeken. Bovendien betekent dit dat quotas of limieten in Kubernetes voor het aantal kernen hier niet echt helpen, en uiteindelijk zal het eindigen in throttling.
Geheugenuitputting
Stromen zijn geheugen. En de beperkingen van geheugen binnen containers zijn geenszins een panacee. Begin gewoon met het verhogen van het aantal applicaties en threads, en vroeg of laat zul je een kritieke toename van de schakelfrequentie tegenkomen en als gevolg daarvan een verslechtering van de prestaties. Bovendien, als de applicatie traditionele microservices-frameworks gebruikt of verbinding maakt met een database, of caching toepast, of op een andere manier extra geheugen verbruikt, heb je ongetwijfeld een hulpmiddel nodig waarmee je in de JVM kunt kijken en kunt zien hoe deze het geheugen beheert, zonder de JVM zelf te beschadigen (bijvoorbeeld XX:+UseCGroupMemoryLimitForHeap). En ondanks het feit dat de JVM vanaf Java 9 in staat is om cgroups te begrijpen en zich dienovereenkomstig aan te passen, blijft het reserveren en beheren van geheugen een behoorlijk complexe aangelegenheid.
Quotas en limieten
Met Java 11 werd ondersteuning voor CPU-quota geïntroduceerd (zoals PreferContainerQuotaForCPUCount). Kubernetes biedt ook ondersteuning voor limieten en quotas. Ja, dit alles heeft zin, maar als de applicatie weer buiten de toegewezen quota valt, komen we opnieuw tot de conclusie dat de grootte – net als bij traditionele Java-applicaties – wordt bepaald door het aantal kernen en het toekennen van een aparte thread voor elk verzoek, wat betekent dat dit alles weinig nut heeft.
Bovendien, zelfs wanneer je quota's en limieten of de functies voor horizontale (scale-out) schaling van de onderliggende Kubernetes-platform gebruikt, lost het probleem zichzelf ook niet op. We verspillen gewoon meer middelen om het oorspronkelijke probleem op te lossen of komen uiteindelijk tot een overconsumptie van middelen. Als dit een zwaarbelaste omgeving in de openbare cloud is, beginnen we vrijwel zeker meer middelen te gebruiken dan daadwerkelijk nodig is.
En wat moeten we hiermee doen?
Als we het simpel zeggen, gebruik dan asynchrone en niet-blokkerende invoer- en uitvoerbibliotheken en framework zoals Netty, of Akka. Deze zijn veel beter geschikt voor gebruik in containers vanwege hun reactieve aard. Door niet-blokkerende invoer en uitvoer kan dezelfde thread meerdere gelijktijdige verzoeken verwerken. Terwijl één verzoek wacht op invoer- en uitvoerresultaten, wordt de thread die het verwerkt vrijgegeven en gaat aan de slag met een ander verzoek. En wanneer de invoer- en uitvoerresultaten eindelijk binnenkomen, wordt de verwerking van het eerste verzoek hervat. Door de verwerking van verzoeken binnen dezelfde thread af te wisselen, kunnen we het totale aantal threads verminderen en de middelen die nodig zijn voor de verwerking van verzoeken verlagen.
Bij niet-blokkerende invoer en uitvoer wordt het aantal kernen een cruciale parameter, omdat dit bepaalt hoeveel invoer- en uitvoerthreads er parallel kunnen worden uitgevoerd. Bij correct gebruik stelt dit ons in staat om de belasting effectief te verdelen tussen de kernen en om hogere belasting te verwerken met minder middelen.
Hoe, dat is alles?
Nee, er is nog meer. Reactief programmeren helpt om middelen beter te benutten, maar brengt ook kosten met zich mee. In het bijzonder zal de code herschreven moeten worden volgens de principes van niet-blokkerendheid en moet blokkering van invoer- en uitvoerthreads vermeden worden. Dit is een heel ander model van ontwikkeling en uitvoering. En hoewel er veel nuttige bibliotheken zijn, is het toch een radicale verandering in de gebruikelijke manier van denken.
Ten eerste moet je leren om code te schrijven die asynchroon wordt uitgevoerd. Zodra je niet-blokkerende invoer en uitvoer gaat gebruiken, moet je expliciet aangeven wat er moet gebeuren wanneer een antwoord op een aanvraag binnenkomt. Gewoon blokkeren en wachten is niet langer mogelijk. In plaats daarvan kun je callbacks doorgeven, reactieve programmeertechnieken toepassen of continuaties gebruiken. Maar dat is nog niet alles: om niet-blokkerende invoer en uitvoer te gebruiken, heb je ook niet-blokkerende servers en clients nodig, idealiter overal. Met HTTP is het eenvoudig, maar er zijn ook databases, bestandssystemen en nog veel meer.
Hoewel totale doorlopende reactieve programmatuur maximale efficiëntie biedt, kan het moeilijk zijn om deze verschuiving in de praktijk te verteren. Daarom is de mogelijkheid om reactieve en imperatieve code te combineren een vereiste voor:
- Effectief gebruik van middelen in de meest belastende onderdelen van het softwaresysteem;
- Eenvoudiger geschreven code te gebruiken in de overige delen.
Maak kennis met Quarkus
Eigenlijk is dat de essentie van Quarkus: het combineren van reactieve en imperatieve modellen binnen één runtime omgeving.
Quarkus is gebouwd op basis van Vert.x en Netty, met daarbovenop diverse reactieve frameworks en extensies die de ontwikkelaar ondersteunen. Quarkus is bedoeld voor het bouwen van niet alleen HTTP-microservices, maar ook event-gedreven architecturen. Dankzij de reactieve aard werkt het zeer efficiënt met berichtenuitwisselingssystemen (Apache Kafka, AMQP, enz.).
De kunst is om dezelfde reactieve engine te gebruiken voor zowel imperatieve als reactieve code.
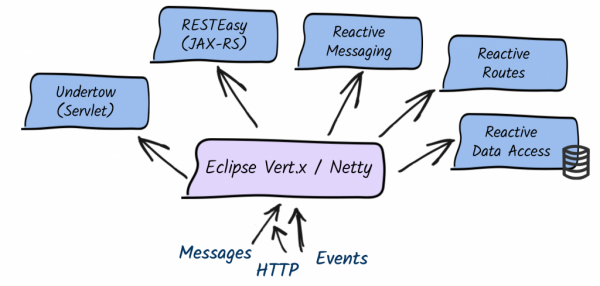
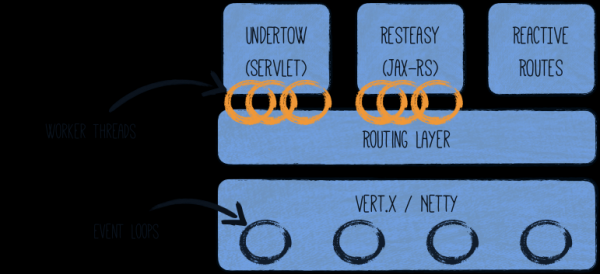
Quarkus doet dit uitstekend. De keuze tussen imperatief en reactief is duidelijk – gebruik voor beide een reactieve kern. Het helpt enorm met snelle, niet-blokkerende code die vrijwel alles verwerkt wat door de event-loop thread (ook bekend als IO thread) gaat. Maar als je klassieke REST-applicaties of client-side applicaties hebt, biedt Quarkus een imperatieve programmeermodel. De ondersteuning van HTTP in Quarkus is gebaseerd op het gebruik van een niet-blokkerende en reactieve engine (Eclipse Vert.x en Netty). Alle HTTP-verzoeken die je applicatie ontvangt, gaan eerst door de event-loop (IO Thread), en worden dan verzonden naar dat deel van de code dat de verzoeken beheert. Afhankelijk van de bestemmingscode kan de beheer code worden aangeroepen binnen een aparte thread (de zogenaamde worker thread, toegepast in het geval van servlets en Jax-RS) of de oorspronkelijke input-output thread (reactieve route).
Voor de connectoren van messaging systems worden niet-blokkerende clients gebruikt, die draaien bovenop de Vert.x engine. Hierdoor kun je effectief berichten verzenden, ontvangen en verwerken van systemen in de klasse messaging middleware.
staat geschreven: er zijn verschillende goede handleidingen verzameld om je op weg te helpen met Quarkus:
Bovendien hebben we online praktische lessen voorbereid om verschillende aspecten van reactief programmeren te leren kennen; daarvoor heb je alleen een browser nodig; een IDE is niet vereist, en een computer is niet noodzakelijk. Je kunt deze lessen vinden .
Nuttige bronnen
- De projectwebsite van Quarkus –
- Het Quarkus-project op GitHub –
- De Twitter van het Quarkus-project –
- De chat van het Quarkus-project –
- De forums van het Quarkus-project – !forum/quarkus-dev
10 video tutorials over Quarkus om je wegwijs te maken in het onderwerp
Zoals vermeld op de website, , – het is -gerichte Java-stack, geoptimaliseerd voor GraalVM en OpenJDK HotSpot en opgebouwd uit de beste Java-bibliotheken en standaarden.
Om je te helpen het onderwerp te begrijpen, hebben we 10 video tutorials geselecteerd die verschillende aspecten van Quarkus en voorbeelden van zijn gebruik behandelen:
1. Introductie tot Quarkus: een next-gen Java-framework voor Kubernetes
Auteurs: Thomas Qvarnstrom en Jason Greene
Het doel van het Quarkus-project is om een Java-platform te creëren voor Kubernetes en serverless-omgevingen, en om reactieve en imperatieve programmeermodellen te combineren binnen één runtime, zodat ontwikkelaars flexibel hun aanpak kunnen variëren bij het werken met een breed scala aan gedistribueerde architecturen van toepassingen. Lees meer in de inleidende lezing hieronder.
2. Quarkus: ultrasnelle subatomaire Java
Auteur: Burr Sutter
De video van de online lezing DevNation Live toont hoe je Quarkus kunt gebruiken om bedrijfs-Java-toepassingen, API's, microservices en serverless-functies in een Kubernetes/OpenShift-omgeving te optimaliseren, waardoor ze veel kleiner, sneller en schaalbaarder worden.
3. Quarkus en GraalVM: versnelling van Hibernate tot subatomaire snelheden en krimp tot subatomaire afmetingen
Auteur: Sanne Grinovero
In de presentatie leer je hoe Quarkus is ontstaan, hoe het werkt en hoe het complexe bibliotheken zoals Hibernate ORM compatibel maakt met native-images van GraalVM.
4. Leren ontwikkelen van serverless-toepassingen
Auteur: Marthen Luther
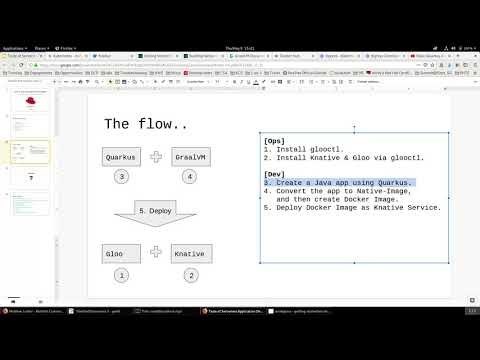
In de onderstaande video wordt getoond hoe je een eenvoudige Java-toepassing kunt maken met Quarkus en deze kunt implementeren als een serverless-toepassing op Knative.
5. Quarkus: codeer met plezier
Auteur: Edson Yanaga
Een videohandleiding voor het maken van je eerste Quarkus-project, zodat je begrijpt waarom Quarkus de harten van ontwikkelaars verovert.
6. Java en containers – wat wordt de gezamenlijke toekomst?
Auteur: Mark Little
Deze presentatie geeft een overzicht van de geschiedenis van Java en legt uit waarom Quarkus de toekomst van Java is.
7. Quarkus: ultrasnelle subatomaire Java
Auteur: Dimitris Andreadis
Een overzicht van de voordelen van Quarkus die door ontwikkelaars worden erkend: eenvoud, ultrasnelle snelheden, de beste bibliotheken en standaarden.
8. Quarkus en subatomaire reactieve systemen
Auteur: Clement Escoffier
Dankzij de integratie met GraalVM biedt Quarkus een ultrasnelle ontwikkelervaring en een subatomaire runtime-omgeving. De auteur spreekt over de reactieve kant van Quarkus en hoe deze kan worden gebruikt bij het maken van reactieve toepassingen en toepassingen met datastromen.
9. Quarkus en snelle applicatieontwikkeling in Eclipse MicroProfile
Auteur: John Clingan
Door Eclipse MicroProfile en Quarkus te combineren, kunnen ontwikkelaars volledig functionele MicroProfile-containerapplicaties maken die in enkele tientallen milliseconden opstarten. In de video wordt uitgelegd hoe je een MicroProfile-containerapplicatie kunt coderen voor implementatie op het Kubernetes-platform.
10. Java, versie 'Turbo'
Auteur: Marcus Biel
De auteur toont aan hoe je Quarkus kunt gebruiken om superkleine en super snelle Java-containers te creëren, die een echte doorbraak mogelijk maken, vooral in serverless omgevingen.
Bron: habr.com
