

Afbeelding:
Voor aggregator websites in de e-commerce is het van cruciaal belang om actuele informatie te onderhouden. Anders vervalt hun belangrijkste voordeel: de mogelijkheid om de meest relevante gegevens op één plek te zien.
Om deze taak op te lossen, is het nodig om webscraping-technieken te gebruiken. Het idee is dat er speciale software wordt gemaakt - een crawler, die de benodigde websites in de lijst bezoekt, informatie van hen verzamelt en deze op de aggregatorwebsite uploadt.
Het probleem is dat de website-eigenaren van wie de gegevens door de aggregators worden verkregen, vaak niet zo gemakkelijk toegang willen geven. Dit is begrijpelijk - als de prijsinformatie in een online winkel op de aggregatorwebsite verschijnt en hoger is dan die van concurrenten die daar ook worden gepresenteerd, verliest het bedrijf klanten.
Tegenmaathandelingsmethoden tegen scraping
Daarom verzetten website-eigenaren zich vaak tegen scraping - dat wil zeggen, tegen het downloaden van hun gegevens. Ze kunnen verzoeken identificeren die bots-crawlers per IP-adres verzenden. Gewoonlijk gebruiken dergelijke software zogenaamde server-IP's, die gemakkelijk te berekenen en te blokkeren zijn.
Bovendien wordt in plaats van het blokkeren van verzoeken vaak een andere methode gebruikt: geïdentificeerde bots krijgen irrelevante informatie te zien. Bijvoorbeeld door prijzen van producten te verhogen of te verlagen of hun beschrijvingen te wijzigen.
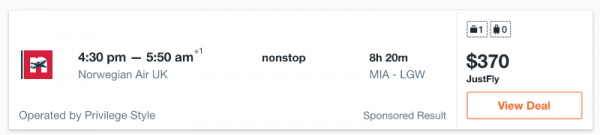
Een voorbeeld dat vaak in dit verband wordt genoemd, zijn de prijzen voor vliegtickets. Inderdaad, luchtvaartmaatschappijen en reisagentschappen kunnen vaak verschillende resultaten tonen voor dezelfde vluchten, afhankelijk van het IP-adres. Echte situatie: het zoeken naar een vlucht van Miami naar Londen op dezelfde datum met een IP-adres uit Oost-Europa en Azië levert verschillende resultaten op.
Bij een IP-adres in Oost-Europa ziet de prijs er zo uit:
En voor een IP-adres uit Azië zo:
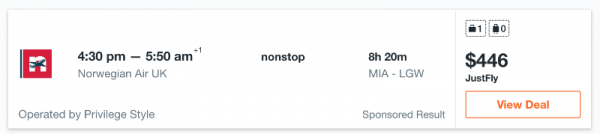
Zoals te zien is, verschilt de prijs voor dezelfde vlucht aanzienlijk - het prijsverschil bedraagt $76, wat behoorlijk veel is. Voor een aggregatorwebsite is er niets erger dan dit - als hier foutieve informatie wordt gepresenteerd, zullen gebruikers deze niet gebruiken. Bovendien, als op de aggregator een bepaalde prijs voor een product staat, en als deze verandert bij het doorklikken naar de verkoperswebsite, heeft dit ook een negatieve invloed op de reputatie van het project.
Oplossing: het gebruik van residentiële proxies
Problemen bij dataskraping voor aggregatiebehoeften kunnen worden voorkomen door gebruik te maken van residentiële proxies. Server-IP's worden geleverd door hostingproviders. Het is vrij eenvoudig om vast te stellen of een adres tot een specifiek providerpool behoort - elk IP heeft een ASN-nummer, waarin deze informatie is opgenomen.
Er zijn veel diensten voor het analyseren van ASN-nummers. Vaak worden ze geïntegreerd met anti-bot systemen die de toegang voor crawlers blokkeren of de gegevens die in reactie op hun verzoeken worden gegeven vervalsen.
Residentiële IP-adressen helpen om dergelijke systemen te omzeilen. Dergelijke IP's worden door internetproviders uitgegeven aan huiseigenaren, met de relevante aantekeningen in alle bijbehorende databases. Er zijn speciale diensten voor residentiële proxies die het mogelijk maken om gebruik te maken van residentiële adressen. Dit is precies zo'n dienst.
Verzoeken die crawlers van aggregatorwebsites met residentiële IP's verzenden, lijken alsof ze afkomstig zijn van gewone gebruikers uit een specifieke regio. Gewone bezoekers worden namelijk niet geblokkeerd - in het geval van webwinkels zijn dit potentiële klanten.
Het gebruik van roterende proxies van Infatica stelt aggregatorwebsites in staat om gegarandeerd nauwkeurige gegevens te verkrijgen en blokkades en problemen met parsing te vermijden.
Andere artikelen over het gebruik van residentiële proxies voor bedrijven:
Bron: habr.com
