

In dit artikel vind je enkele algemene sjablonen die ingenieurs helpen bij het werken met grootschalige diensten die door miljoenen gebruikers worden geraadpleegd.
Volgens de ervaring van de auteur is dit geen uitputtende lijst, maar echt effectieve adviezen. Laten we beginnen.
Vertaald met ondersteuning van .
Basisniveau
De onderstaande maatregelen zijn relatief eenvoudig uit te voeren, maar leveren een hoge return. Als je ze nog niet hebt geprobeerd, zul je verrast zijn door de aanzienlijke verbeteringen.
Infrastructuur als code
Het eerste advies is om infrastructuur als code te implementeren. Dit betekent dat je een softwarematige manier moet hebben om de gehele infrastructuur uit te rollen. Het klinkt ingewikkeld, maar we hebben het eigenlijk over de volgende code:
Het uitrollen van 100 virtuele machines
- met Ubuntu
- 2 GB RAM per stuk
- ze zullen de volgende code hebben
- met deze parameters
Je kunt veranderingen in de infrastructuur volgen en snel terugkeren naar vorige versies met een versiebeheersysteem.
De modernist in mij zegt dat je Kubernetes/Docker kunt gebruiken om alles hierboven te doen, en hij heeft gelijk.
Bovendien kan automatisering worden bereikt met behulp van Chef, Puppet of Terraform.
Continue integratie en levering
Voor het creëren van een schaalbare dienst is het belangrijk om een build- en test-pijplijn voor elke pull request te hebben. Zelfs als de test heel eenvoudig is, garandeert het ten minste dat de code die je implementeert, compileert.
Elke keer op dit punt beantwoord je de vraag: zal mijn build compilen en de tests doorstaan, is het geldig? Dit kan misschien een lage lat lijken, maar het lost veel problemen op.
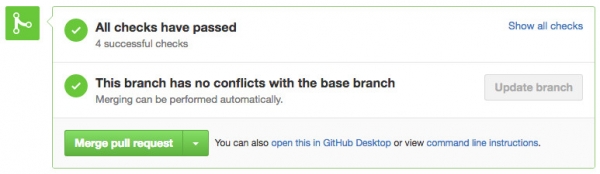
Er is niets mooier dan die vinkjes te zien
Voor deze technologie kun je Github, CircleCI of Jenkins overwegen.
Load balancers
Dus, we willen een load balancer starten om het verkeer te routeren en een gelijke belasting op alle knooppunten te garanderen of de dienst operationeel te houden in geval van een storing:
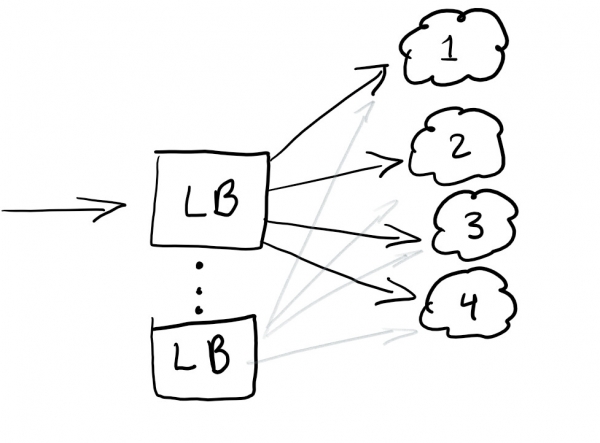
Een load balancer helpt doorgaans goed bij het verdelen van verkeer. De beste praktijk is om redundante balancing te hebben, zodat je geen enkele foutpunt hebt.
Load balancers worden meestal geconfigureerd in de cloud die je gebruikt.
RayID, correlatie-ID of UUID voor aanvragen
Heb je ooit een foutmelding in een applicatie gezien die zoiets zei als: „Er is iets misgegaan. Bewaar deze ID en stuur deze naar onze klantenservice”?
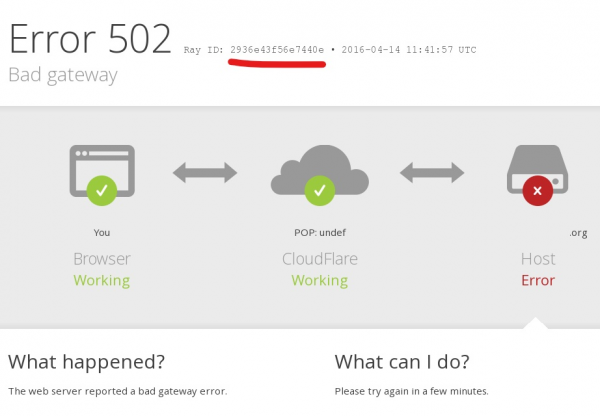
Een unieke identifier, correlation ID, RayID of een van de varianten is een unieke code waarmee je een verzoek gedurende zijn levenscyclus kunt volgen. Dit maakt het mogelijk om de gehele route van het verzoek in de logs te traceren.
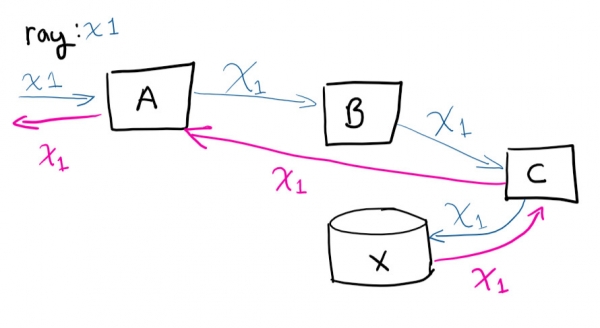
De gebruiker doet een verzoek aan systeem A, vervolgens neemt A contact op met B, dat contact opneemt met C, opslaat in X en vervolgens keert het verzoek terug naar A.
Als je op afstand verbinding zou maken met virtuele machines en de route van het verzoek zou proberen te volgen (en handmatig zou proberen te koppelen welke aanroepen plaatsvinden), zou je gek worden. Een unieke identificatie maakt het leven aanzienlijk gemakkelijker. Het is een van de eenvoudigste dingen die je kunt doen om tijd te besparen naarmate de service groeit.
Gemiddeld niveau
Hier zijn de tips moeilijker dan voorafgaand, maar de juiste tools vergemakkelijken de taak, waardoor de ROI zelfs voor kleine en middelgrote bedrijven gewaarborgd is.
Ge-centraliseerd loggen
Gefeliciteerd! Je hebt 100 virtuele machines uitgerold. De volgende dag komt de CEO binnen en klaagt over een fout die hij kreeg tijdens het testen van de service. Hij vermeldt de relevante ID waar we het hierboven over hadden, maar je moet de logs van 100 machines doorzoeken om degene te vinden die is mislukt. En je moet dat vinden vóór de presentatie van morgen.
Hoewel dit klinkt als een leuk avontuur, is het echter beter om ervoor te zorgen dat je de mogelijkheid hebt om vanuit één plek door alle logboeken te zoeken. Ik heb het probleem van gecentraliseerd loggen opgelost met behulp van de ingebouwde functionaliteit van de ELK-stack: hier wordt logverzameling met zoekmogelijkheden ondersteund. Dit zal echt helpen bij het vinden van specifieke logs. Als bonus kun je diagrammen en dergelijke leuke dingen maken.
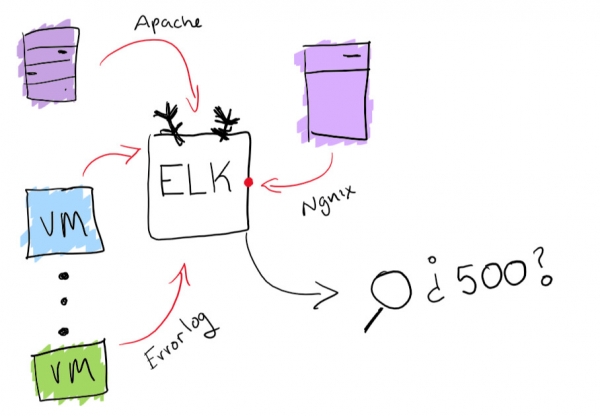
Functionaliteit van de ELK-stack
Monitoring agents
Nu je dienst operationeel is, moet je ervoor zorgen dat deze zonder problemen draait. De beste manier om dit te doen is door enkele agents, die parallel werken en controleren of deze werkt en de basisoperaties worden uitgevoerd.
In deze fase controleer je of De uitgerolde build presteert goed en werkt normaal..
Voor kleine en middengrote projecten raad ik Postman aan voor het monitoren en documenteren van API's. Maar over het algemeen moet je ervoor zorgen dat je een manier hebt om te weten wanneer er een storing is opgetreden en tijdig notificaties te ontvangen.
Automatisch schalen op basis van belasting
Het is heel eenvoudig. Als je een virtuele machine hebt die verzoeken afhandelt en deze bijna 80% van het geheugen gebruikt, kun je ofwel de middelen ervan verhogen, of meer virtuele machines aan de cluster toevoegen. Het automatisch uitvoeren van deze operaties is uitstekend voor elastische aanpassing van capaciteit onder belasting. Maar je moet altijd voorzichtig zijn met hoeveel geld je uitgeeft en redelijke limieten stellen.
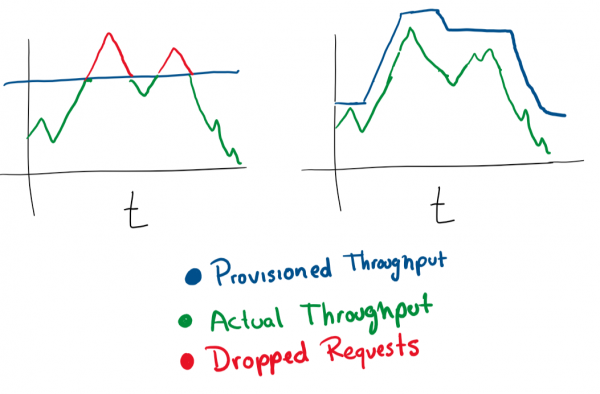
Bij de meeste cloud-diensten kun je automatische schaling instellen door meer servers of krachtigere servers te gebruiken.
Experimentsysteem
Een goede manier om updates veilig uit te rollen is de mogelijkheid om iets voor 1% van de gebruikers gedurende een uur te testen. Je hebt zulke mechanismen natuurlijk wel eens in actie gezien. Bijvoorbeeld, Facebook toont delen van het publiek een andere kleur of verandert de lettergrootte om te zien hoe gebruikers op de veranderingen reageren. Dit wordt A/B-testen genoemd.
Zelfs de release van een nieuwe functie kan als experiment worden geïntroduceerd, waarna kan worden bepaald hoe deze moet worden uitgerold. Ook krijg je de mogelijkheid om configuraties ‘terug te roepen’ of on-the-fly aan te passen gezien de functie die je service degradeert.
Gevorderd niveau
Hier zijn tips die relatief moeilijk te implementeren zijn. Je zult waarschijnlijk iets meer middelen nodig hebben, dus het kan lastig zijn voor een klein of middelgrote onderneming om hiermee om te gaan.
Blue-green deployments
Dit is wat ik de ‘Erlang’ manier van uitrollen noem. Erlang werd veel gebruikt toen telefoondiensten in opkomst waren. Voor het routeren van telefoongesprekken werden software-switches toegepast. De belangrijkste taak van de software van deze switches was het vermijden van het afbreken van gesprekken tijdens systeemupdates. Erlang heeft een prachtige manier om een nieuwe module te laden zonder de vorige te laten falen.
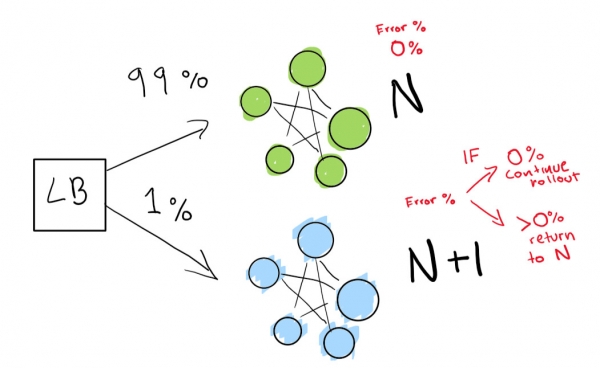
Deze stap hangt af van de beschikbaarheid van een load balancer. Stel dat u versie N van uw software heeft, en u wilt vervolgens versie N+1 implementeren.
U zou u gewoon de dienst kunnen stoppen en de volgende versie installeren op een moment dat u geschikt vindt voor uw gebruikers, en enige downtime accepteren. Maar laten we aannemen dat u inderdaad strikte SLA-vereisten heeft. Een SLA van 99,99% betekent dat u offline kunt gaan van voor 52 minuten per jaar.
Als u echt dergelijke cijfers wilt bereiken, zijn er twee implementaties tegelijk nodig:
- de huidige (N);
- de volgende versie (N+1).
U geeft de load balancer de opdracht om een percentage van het verkeer naar de nieuwe versie (N+1) te leiden, terwijl u actief regressies controleert.
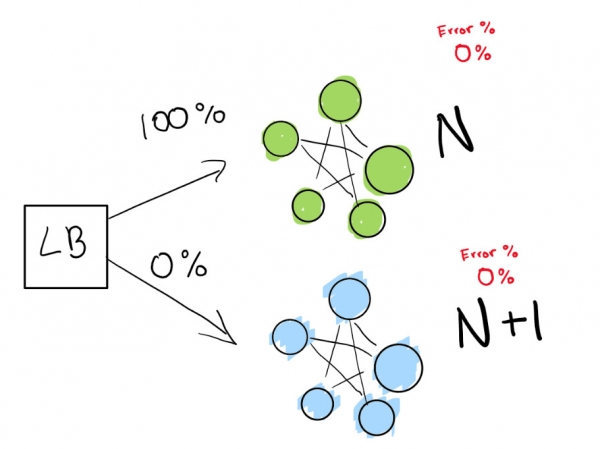
Hier hebben we de groene implementatie N die normaal werkt. We proberen over te schakelen naar de volgende versie van deze implementatie.
Eerst sturen we een echt kleine test om te zien of onze implementatie N+1 goed werkt met een kleine hoeveelheid verkeer:
Ten slotte hebben we een reeks automatische controles die we uiteindelijk uitvoeren zolang onze implementatie niet is voltooid. Als u zeer, zeer voorzichtig bent, kunt u ook uw implementatie N voor altijd behouden voor een snelle terugrol in het geval van een slechte regressie:
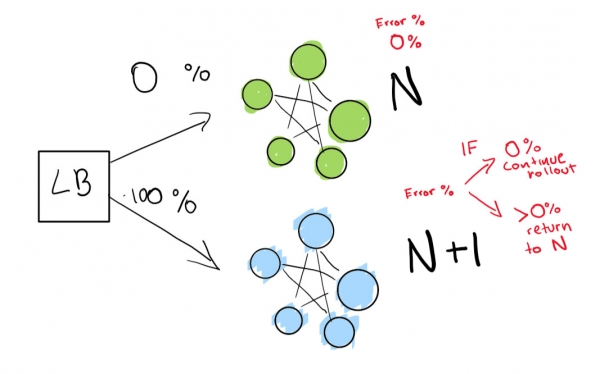
Als u naar een nog geavanceerder niveau wilt gaan, laat alles in de blue-green implementatie automatisch uitvoeren.
Detectie van anomalieën en automatische mitigatie
Gegeven dat u gecentraliseerde logging en goede logverzameling heeft, kunt u al hogere doelen stellen. Bijvoorbeeld, proactief falen voorspellen. Op monitors en in logs worden functies gevolgd en worden verschillende grafieken opgesteld—en u kunt van tevoren voorspellen wat er verkeerd zal gaan:
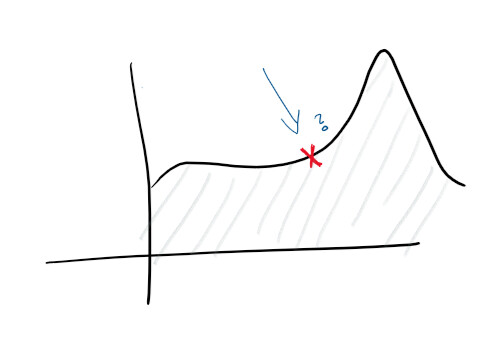
Met anomaliedetectie begint u enkele aanwijzingen te onderzoeken die de service biedt. Bijvoorbeeld, een piek in CPU-belasting kan aangeven dat de harde schijf faalt, en een piek in het aantal aanvragen betekent dat u moet opschalen. Dit soort statistieken maakt de service proactief.
Met dergelijke analytische gegevens kunt u in elke richting opschalen, proactief en reactief de eigenschappen van machines, databases, verbindingen en andere bronnen aanpassen.
Dat is alles!
Deze prioriteitenlijst zal u veel problemen besparen wanneer u een cloudservice opzet.
De auteur van het originele artikel nodigt lezers uit om hun commentaren achter te laten en wijzigingen aan te brengen. Het artikel wordt verspreid als open source, pull-requests worden door de auteur .
Wat nog meer te lezen over dit onderwerp:
Bron: habr.com
