

Hoge prestaties zijn een van de belangrijkste vereisten bij het werken met big data. Bij Data Load Management bij Sber houden we ons bezig met het verwerken van bijna alle transacties in onze Data Cloud op basis van Hadoop, en daardoor hebben we te maken met werkelijk enorme informatiestromen. Uiteraard zijn we altijd op zoek naar manieren om de prestaties te verbeteren, en nu willen we vertellen hoe het is gelukt om de RegionServer HBase en de HDFS-client te patchen, waardoor de leessnelheid aanzienlijk is verhoogd.
Echter, voordat we ingaan op de details van de aanpassingen, is het belangrijk om de beperkingen te bespreken die in principe niet te omzeilen zijn als je op HDD's zit.
Waarom HDD's en snelle random access-lezingen niet te combineren zijn
Zoals bekend, slaan HBase en veel andere databases gegevens op in blokken van enkele tientallen kilobytes. Standaard is dit ongeveer 64 KB. Stel je nu voor dat we slechts 100 bytes nodig hebben en we vragen HBase om deze gegevens op te leveren op basis van een bepaalde sleutel. Aangezien de blokgrootte in HFiles 64 KB is, zal er 640 keer meer opgevraagd worden (even terzijde!) dan nodig.
Vervolgens zal de aanvraag via HDFS gaan en zijn mechanisme voor metadata-caching ShortCircuitCache (wat directe toegang tot bestanden mogelijk maakt), leidt dit tot het lezen van al 1 MB van de schijf. Dit kan echter worden geregeld met de parameter dfs.client.read.shortcircuit.buffer.size en in veel gevallen is het zinvol om deze waarde te verlagen, bijvoorbeeld naar 126 KB.
Stel dat we dit doen, maar bovendien, wanneer we beginnen met het lezen van gegevens via de Java-API, met functies zoals FileChannel.read, en we vragen het besturingssysteem om de opgegeven hoeveelheid gegevens te lezen, dan leest het 'voor de zekerheid' twee keer zoveel, dus 256 KB in ons geval. Dit gebeurt omdat er in Java geen eenvoudige mogelijkheid is om de vlag FADV_RANDOM in te stellen, die dit gedrag voorkomt.
Uiteindelijk, om onze 100 bytes te krijgen, wordt er achter de schermen 2600 keer meer gelezen. De oplossing lijkt voor de hand liggend: laten we de blokgrootte halveren tot een kilobyte, de eerder genoemde vlag instellen en verlichting vinden in de snelheid. Maar het probleem is dat het halveren van de blokgrootte ook het aantal gelezen bytes per tijdseenheid met hetzelfde feit halveer.
Een zekere winst van het instellen van de FADV_RANDOM-vlaag is mogelijk, maar alleen bij hoge multithreading en met een blokgrootte van minimaal 128 kB; dit is echter maximaal enkele tientallen procenten.
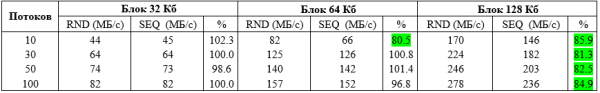
De tests zijn uitgevoerd op 100 bestanden, elk met een grootte van 1 GB, opgeslagen op 10 HDD-schijven.
Laten we berekenen waar we met zo'n snelheid eigenlijk op kunnen rekenen:
Stel, we lezen van 10 schijven met een snelheid van 280 MB/sec, dat is 3 miljoen keer 100 bytes. Maar zoals we ons herinneren, komt de benodigde data 2600 keer minder vaak voor dan wat er gelezen is. Dus we delen 3 miljoen door 2600 en krijgen 1100 records per seconde.
Teleurstellend, nietwaar? Dit is de aard van Random Access toegang tot gegevens op HDD — ongeacht de blokgrootte. Dit is de fysieke limiet van willekeurige toegang en geen enkele database kan meer bereiken onder deze omstandigheden.
Hoe kunnen databases dan veel hogere snelheden bereiken? Om deze vraag te beantwoorden, laten we eens kijken naar wat er op de volgende afbeelding gebeurt:
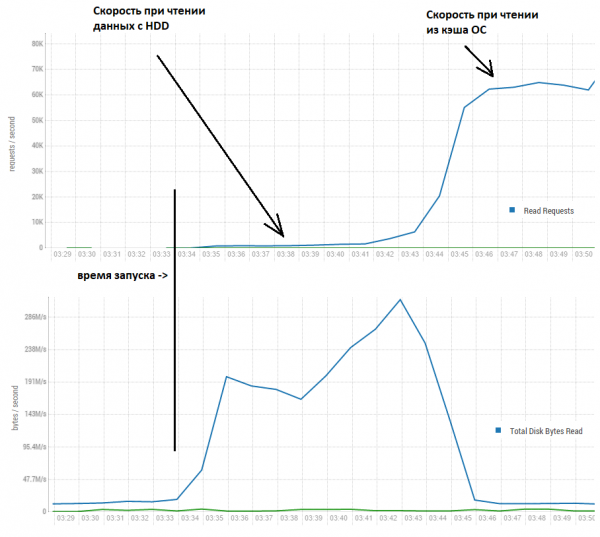
Hier zien we dat de snelheid de eerste paar minuten inderdaad rond de duizend records per seconde ligt. Maar later, doordat er veel meer wordt gelezen dan er is aangevraagd, worden de gegevens in de buff/cache van het besturingssysteem (Linux) opgeslagen en stijgt de snelheid tot een respectabele 60.000 per seconde.
Dus verder gaan we ons concentreren op het versnellen van de toegang tot alleen die gegevens die in de OS-cache zitten of zich in vergelijkbare snelle opslag bevinden, zoals SSD/NVMe.
In ons geval gaan we testen op een opstelling van 4 servers, elk van deze is als volgt geconfigureerd:
CPU: Xeon E5-2680 v4 @ 2.40GHz 64 threads.
Geheugen: 730 GB.
java versie: 1.8.0_111
En hier ligt eigenlijk de sleutel — het volume aan gegevens in de tabellen dat moet worden gelezen. Het probleem is dat als je gegevens leest uit een tabel die volledig in de HBase-cache past, de gegevens zelfs niet uit de buff/cache van het besturingssysteem hoeven te worden gelezen. Dit komt omdat HBase standaard 40% van het geheugen toewijst aan een structuur die BlockCache wordt genoemd. Dit is feitelijk een ConcurrentHashMap, waarbij de sleutel de naam van het bestand + offset van het blok is, en de waarde de gegevens op die offset.
Dus, wanneer het lezen alleen uit deze structuur komt, , ongeveer een miljoen verzoeken per seconde. Maar laten we ons voorstellen dat we niet honderden gigabytes aan geheugen kunnen toewijzen alleen voor databasebehoeften, omdat er veel andere nuttige dingen op deze servers draaien.
In ons geval is de grootte van de BlockCache op één RS ongeveer 12 GB. We hebben twee RS op één node geplaatst, dus voor BlockCache is er 96 GB toegewezen op alle nodes. En de gegevens zijn in feite veel meer, laten we zeggen dat dit 4 tabellen zijn, met 130 regio's, waarin bestanden van elk 800 MB zijn, gecomprimeerd met FAST_DIFF, dat is in totaal 410 GB (dit zijn schone gegevens, dus zonder rekening te houden met de replicatiefactor).
Zodoende vertegenwoordigt de BlockCache slechts ongeveer 23% van het totale gegevensvolume en dat ligt veel dichter bij de echte omstandigheden van wat Big Data wordt genoemd. En hier begint het interessant te worden — het is immers duidelijk dat hoe minder hits in de cache, hoe slechter de prestaties. Bij een misser moeten we veel werk verzetten — dat wil zeggen, we moeten terug naar het aanroepen van systeemfuncties. Maar dat valt niet te vermijden, laten we daarom eens een heel ander aspect bekijken — wat gebeurt er met de gegevens binnen de cache?
Laten we de situatie vereenvoudigen en aannemen dat we een cache hebben waarin slechts 1 object kan worden geplaatst. Hier is een voorbeeld van wat er gebeurt als we proberen te werken met een gegevensvolume dat 3 keer groter is dan de cache.
1. Plaats blok 1 in de cache.
2. Verwijder blok 1 uit de cache.
3. Plaats blok 2 in de cache.
4. Verwijder blok 2 uit de cache.
5. Plaats blok 3 in de cache.
Vijf acties uitgevoerd! Toch kan deze situatie niet als normaal worden beschouwd; in feite dwingen we HBase om een enorme hoeveelheid volkomen nutteloos werk te verrichten. Het leest constant gegevens uit de OS-cache, plaatst deze in BlockCache, om het bijna onmiddellijk weer te verwijderen omdat er een nieuwe lading gegevens binnenkwam. De animatie aan het begin van het bericht toont de kern van het probleem — de Garbage Collector loopt vol, de aarde warmt op, kleine Greta in het verre en hete Zweden maakt zich zorgen. En wij, IT'ers, houden er niet van als kinderen verdrietig zijn, dus beginnen we te denken aan wat we hieraan kunnen doen.
Wat als we niet alle blokken in de cache plaatsen, maar slechts een bepaald percentage, zodat de cache niet overvol raakt? Laten we in eerste instantie gewoon een paar regels code toevoegen aan het begin van de functie die gegevens in de BlockCache plaatst:
  public void cacheBlock(BlockCacheKey cacheKey, Cacheable buf, boolean inMemory) {
    if (cacheDataBlockPercent != 100 && buf.getBlockType().isData()) {
      if (cacheKey.getOffset() % 100 >= cacheDataBlockPercent) {
        return;
      }
    }
...
De essentie is als volgt: de offset is de positie van het blok in het bestand, en de laatste cijfers zijn willekeurig en gelijkmatig verdeeld van 00 tot 99. Daarom zullen we alleen de blokken overslaan die in het voor ons relevante bereik vallen.
Stel bijvoorbeeld cacheDataBlockPercent = 20 in en laten we zien wat er gebeurt:
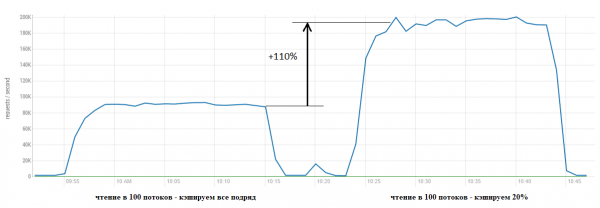
Het resultaat is duidelijk. In de grafieken hieronder wordt duidelijk hoe deze versnelling is bereikt — we besparen veel middelen voor de GC door niet de Sisyphean taak uit te voeren van het plaatsen van data in de cache, alleen om ze meteen naar de Marsaanse honden te gooien:
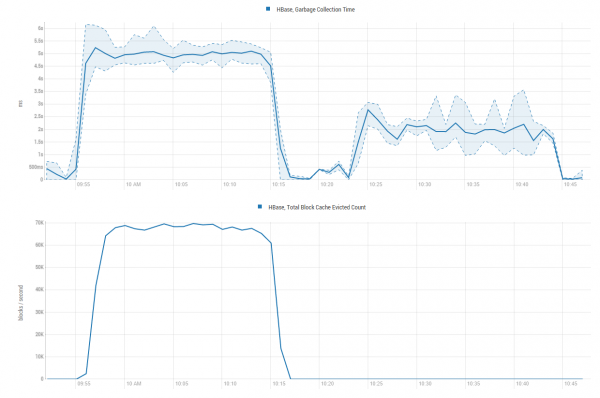
De CPU-utilisatie neemt hierdoor toe, maar veel minder dan de prestaties:
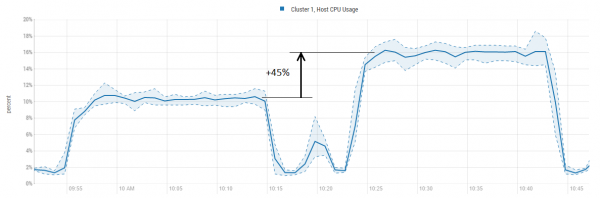
Het is ook belangrijk op te merken dat de blokken die in de BlockCache worden opgeslagen verschillend kunnen zijn. Het grootste deel, ongeveer 95%, zijn daadwerkelijk data. De rest bestaat uit metadata, zoals Bloom-filters of LEAF_INDEX en Deze data is weinig, maar zeer nuttig, aangezien HBase voordat het rechtstreeks naar de data verwijst, eerst naar de metadata kijkt om te bepalen of verdere zoekopdrachten nodig zijn, en zo ja, waar het relevante blok zich bevindt.
Daarom zien we in de code de conditiecontrole buf.getBlockType().isData() en dankzij deze metadata zullen we ze in de cache laten, ongeacht wat.
Laten we nu de belasting verhogen en tegelijkertijd een beetje de functie optimaliseren. In de eerste test stelden we het afsnijdpercentage in op 20 en was de BlockCache een beetje onderbelast. Laten we nu 23% instellen en om de 5 minuten 100 threads toevoegen om te zien op welk moment verzadiging optreedt:
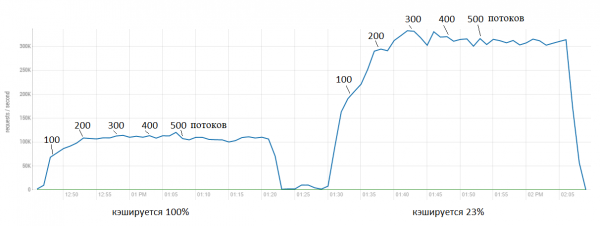
Hier zien we dat de oorspronkelijke versie vrijwel onmiddellijk tegen een limiet komt van ongeveer 100.000 aanvragen per seconde. Terwijl de patch een versnelling tot 300.000 biedt. Het is duidelijk dat verdere versnelling al minder 'gratis' is; de CPU-utilisatie stijgt eveneens.
Echter, dit is geen zeer elegante oplossing, aangezien we van tevoren niet weten welk percentage van de blokken we moeten cachen; dit hangt af van het belastingprofiel. Daarom is er een mechanisme voor automatische aanpassing van deze parameter geïmplementeerd, afhankelijk van de activiteit van de leesoperaties.
Voor het beheer hiervan zijn er drie parameters toegevoegd:
hbase.lru.cache.heavy.eviction.count.limit — stelt in hoeveel keer het proces voor het verwijderen van gegevens uit de cache moet worden uitgevoerd voordat we optimalisatie gaan gebruiken (d.w.z. blokken overslaan). Standaard is het gelijk aan MAX_INT = 2147483647 en betekent het in feite dat de functie nooit begint te werken met deze waarde. Omdat het verwijderingsproces elke 5 — 10 seconden wordt uitgevoerd (afhankelijk van de belasting) en 2147483647 * 10 / 60 / 60 / 24 / 365 = 680 jaar. We kunnen deze parameter echter op 0 instellen en de functie onmiddellijk laten werken na de start.
Er is echter een nuttige lading in deze parameter. Als we een belasting hebben die voortdurend afwisselend is tussen kortetermijnlezen (bijvoorbeeld overdag) en langetermijnlezen (s nachts), kunnen we het zo instellen dat de functie alleen wordt ingeschakeld wanneer er langdurige leesbewerkingen plaatsvinden.
Bijvoorbeeld, we weten dat kortetermijnlezen meestal ongeveer 1 minuut duurt. Dan hoeven we geen blokken te verwijderen, de cache veroudert niet en dan kunnen we deze parameter bijvoorbeeld op 10 instellen. Dit betekent dat de optimalisatie pas begint te werken wanneer er langdurige actieve leesbewerkingen zijn, d.w.z. na 100 seconden. Als we kortetermijnlezen hebben, komen alle blokken in de cache en zijn ze toegankelijk (behalve diegene die door het standaardalgoritme worden verwijderd). En wanneer we langetermijnlezen doen, wordt de functie ingeschakeld en hebben we een veel hogere prestaties.
hbase.lru.cache.heavy.eviction.mb.size.limit — stelt in hoeveel megabyte we willen plaatsen in de cache (en uiteraard verwijderen) in 10 seconden. De functie probeert deze waarde te bereiken en te handhaven. Het idee is als volgt, als we gigabytes in de cache duwen, moeten we ook gigabytes verwijderen, en dat is, zoals we hierboven hebben gezien, vrij kostbaar. We hoeven het echter niet te klein in te stellen, want dat zou leiden tot vroegtijdig verlaten van de blokkenoverslaanmodus. Voor krachtige servers (ongeveer 20-40 fysieke kernen) is het optimaal om rond de 300-400 MB in te stellen. Voor gemiddelde systemen (~10 kernen) 200-300 MB. Voor zwakkere systemen (2-5 kernen) kan 50-100 MB redelijk zijn (hierop is niet getest).
Laten we bekijken hoe dit werkt: stel dat we hbase.lru.cache.heavy.eviction.mb.size.limit = 500 hebben ingesteld, er is een bepaalde belasting (leesbewerkingen) en dan berekenen we om de ~10 seconden hoeveel bytes er zijn vrijgegeven volgens de formule:
Overhead = Vrijgegeven Bytes Totaal (MB) * 100 / Limiet (MB) - 100;
Als er in werkelijkheid 2000 MB is vrijgegeven, dan is de Overhead gelijk aan:
2000 * 100 / 500 - 100 = 300%
De algoritmes proberen echter te zorgen dat niet meer dan een paar tientallen procenten wordt gehandhaafd, zodat de functie het percentage van gecachete blokken zal verlagen, en daarmee een auto-tuning mechanisme zal implementeren.
Maar als de belasting daalt, bijvoorbeeld als er slechts 200 MB is vrijgegeven en de Overhead negatief wordt (het zogenaamde overshooting):
200 * 100 / 500 - 100 = -60%
Dan zal de functie daarentegen het percentage gecachete blokken verhogen totdat de Overhead positief wordt.
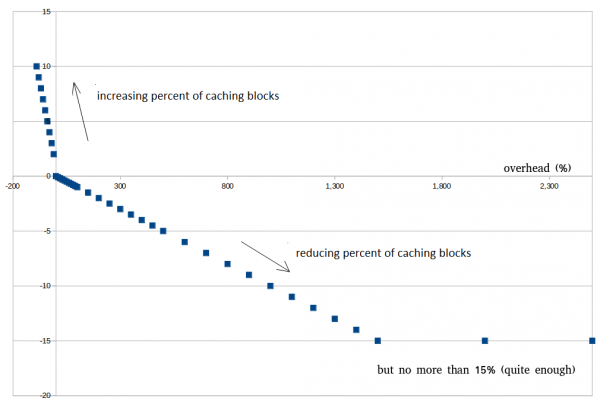
Hieronder is een voorbeeld van hoe dit eruitziet met echte gegevens. Probeer niet 0% te bereiken, dat is onmogelijk. Het is heel goed als we rond de 30 - 100% zijn, dat helpt om voortijdig uit de optimalisatiestatus te komen bij kortstondige pieken.
hbase.lru.cache.heavy.eviction.overhead.coefficient — stelt in hoe snel we het resultaat willen verkrijgen. Als we zeker weten dat onze leesbewerkingen voornamelijk langdurig zijn en we niet willen wachten, kunnen we deze coëfficiënt verhogen en sneller hoge prestaties behalen.
Bijvoorbeeld, als we deze coëfficiënt = 0,01 hebben ingesteld. Dit betekent dat de Overhead (zie hierboven) met dit getal wordt vermenigvuldigd met het verkregen resultaat en het percentage gecachete blokken zal worden verlaagd. Stel dat de Overhead = 300% en de coëfficiënt = 0,01, dan zal het percentage gecachete blokken met 3% worden verminderd.
Een soortgelijke 'Backpressure' logica is ook geïmplementeerd voor negatieve waarden van Overhead (overshooting). Aangezien er altijd kortstondige schommelingen in de lees-vrijgavevolumes mogelijk zijn, stelt dit mechanisme ons in staat om voortijdig uit de optimalisatiestatus te blijven. Backpressure heeft een omgekeerde logica: hoe sterker de overshooting, hoe meer blokken worden gecached.
Implementatiecode
        LruBlockCache cache = this.cache.get();
        if (cache == null) {
          break;
        }
        freedSumMb += cache.evict() / 1024 / 1024;
        /*
        * Soms lezen we meer gegevens dan in de BlockCache past
        * en dit veroorzaakt een hoge evacuatiegraad.
        * Dit leidt op zijn beurt tot zware Garbage Collector-werkzaamheden.
        * Veel blokken worden in de BlockCache geplaatst maar nooit gelezen,
        * en verbruiken veel CPU-bronnen.
        * Hier zullen we analyseren hoeveel bytes werden vrijgegeven en beslissen
        * of het tijd is om het aantal cache-blokken te verminderen.
        * Dit helpt voorkomen dat er teveel blokken in de BlockCache worden geplaatst
        * wanneer evict() zeer actief werkt en CPU bespaart voor andere taken.
        * Meer details: https://issues.apache.org/jira/browse/HBASE-23887
        */

        // Allereerst moeten we controleren hoeveel tijd
        // is verstreken sinds de vorige evict() werd gestart
        // Dit zou bijna dezelfde tijd moeten zijn (+/- 10s)
        // omdat we telkens vergelijkbare volumes vrijgegeven bytes krijgen.
        // 10s omdat dit de standaardperiode is om evict() uit te voeren (zie hierboven this.wait)
        long stopTime = System.currentTimeMillis();
        if ((stopTime - startTime) > 1000 * 10 - 1) {
          // Hier moeten we berekenen welke situatie we hebben gekregen.
          // We hebben de limiet "hbase.lru.cache.heavy.eviction.bytes.size.limit"
          // en kunnen de overhead erop berekenen.
          // We zullen deze informatie gebruiken om te beslissen,
          // hoe we het percentage van de cache-blokken moeten veranderen.
          freedDataOverheadPercent =
            (int) (freedSumMb * 100 / cache.heavyEvictionMbSizeLimit) - 100;
          if (freedSumMb > cache.heavyEvictionMbSizeLimit) {
            // Nu bevinden we ons in de situatie waarin we boven de limiet zijn
            // Maar misschien willen we het negeren omdat het vrij snel zal eindigen
            heavyEvictionCount++;
            if (heavyEvictionCount > cache.heavyEvictionCountLimit) {
              // Dit duurt al een lange tijd en we moeten het aantal caching
              // blokken nu verminderen. Dus we berekenen hier hoeveel blokken we willen overslaan.
              // Het hangt af van:
              // 1. Overhead - als de overhead groot is, kunnen we agressiever
              // het aantal cache-blokken verminderen.
              // 2. Hoe snel we het resultaat willen krijgen. Als we weten dat onze
              // zware lezing langere tijd aanhoudt, willen we niet wachten en kunnen we
              // de coëfficiënt verhogen en vrij snel goede prestaties krijgen.
              // Maar als we het niet zeker weten, kunnen we het langzaam doen en kan het helpen
              // om een voortijdige exit uit deze modus te voorkomen. Dus, wanneer de coëfficiënt is
              // hoger, kunnen we betere prestaties behalen wanneer het zware lezen stabiel is.
              // Maar wanneer het lezen verandert, kunnen we ons daarop aanpassen en de
              // coëfficiënt op een lagere waarde zetten.
              int change =
                (int) (freedDataOverheadPercent * cache.heavyEvictionOverheadCoefficient);
              // Maar de praktijk toont aan dat 15% vermindering behoorlijk genoeg is.
              // We zijn niet hebzuchtig (dat kan leiden tot voortijdige exit).
              change = Math.min(15, change);
              change = Math.max(0, change); // Ik denk niet dat dit ooit zal gebeuren, maar controleer het voor de zekerheid
              // Dus dit is het belangrijkste punt, hier verminderen we % van de cache-blokken
              cache.cacheDataBlockPercent -= change;
              // Als we te diep naar beneden gaan, moeten we hier stoppen, op zijn minst 1% moet er zijn.
              cache.cacheDataBlockPercent = Math.max(1, cache.cacheDataBlockPercent);
            }
          } else {
            // Welnu, we hebben overshooting gekregen.
            // Misschien is dit slechts een kortstondige fluctuatie en kunnen we in deze modus blijven.
            // Dit helpt om voortijdige exit tijdens kortstondige fluctuaties te voorkomen.
            // Als de overshooting minder is dan 90%, zullen we proberen het percentage
            // van cache-blokken te verhogen en hopen dat dit voldoende is.
            if (freedSumMb >= cache.heavyEvictionMbSizeLimit * 0.1) {
              // Eenvoudige logica: meer overshooting - meer cache-blokken (backpressure)
              int change = (int) (-freedDataOverheadPercent * 0.1 + 1);
              cache.cacheDataBlockPercent += change;
              // Maar het kan niet meer dan 100% zijn, dus controleer het.
              cache.cacheDataBlockPercent = Math.min(100, cache.cacheDataBlockPercent);
            } else {
              // Het lijkt erop dat het zware lezen voorbij is.
              // Verlaat gewoon deze modus.
              heavyEvictionCount = 0;
              cache.cacheDataBlockPercent = 100;
            }
          }
          LOG.info("BlockCache geëvacueerd (MB): {}, overhead (%): {}, " +
            "zware evacuatie teller: {}, " +
            "huidige caching DataBlock (%): {}",
            freedSumMb, freedDataOverheadPercent,
            heavyEvictionCount, cache.cacheDataBlockPercent);

          freedSumMb = 0;
          startTime = stopTime;
       }
Laten we dit nu bekijken aan de hand van een echt voorbeeld. We hebben het volgende testscenario:
- We beginnen met het uitvoeren van de scan (25 threads, batch = 100)
- Na 5 minuten voegen we multi-gets toe (25 threads, batch = 100)
- Na 5 minuten schakelen we de multi-gets uit (terug alleen scan)
We voeren twee runs uit, eerst met hbase.lru.cache.heavy.eviction.count.limit = 10000 (wat de functie feitelijk uitschakelt), en daarna zetten we de limiet op 0 (om in te schakelen).
In de onderstaande logs zien we hoe de functie wordt ingeschakeld, overshooting reset naar 14-71%. Van tijd tot tijd daalt de belasting, wat backpressure activeert en HBase weer meer blokken cachet.
RegionServer-log
verwijderd (MB): 0, ratio 0.0, overhead (%): -100, zware verwijderingscounter: 0, huidige caching DataBlock (%): 100
verwijderd (MB): 0, ratio 0.0, overhead (%): -100, zware verwijderingscounter: 0, huidige caching DataBlock (%): 100
verwijderd (MB): 2170, ratio 1.09, overhead (%): 985, zware verwijderingscounter: 1, huidige caching DataBlock (%): 91 < start
verwijderd (MB): 3763, ratio 1.08, overhead (%): 1781, zware verwijderingscounter: 2, huidige caching DataBlock (%): 76
verwijderd (MB): 3306, ratio 1.07, overhead (%): 1553, zware verwijderingscounter: 3, huidige caching DataBlock (%): 61
verwijderd (MB): 2508, ratio 1.06, overhead (%): 1154, zware verwijderingscounter: 4, huidige caching DataBlock (%): 50
verwijderd (MB): 1824, ratio 1.04, overhead (%): 812, zware verwijderingscounter: 5, huidige caching DataBlock (%): 42
verwijderd (MB): 1482, ratio 1.03, overhead (%): 641, zware verwijderingscounter: 6, huidige caching DataBlock (%): 36
verwijderd (MB): 1140, ratio 1.01, overhead (%): 470, zware verwijderingscounter: 7, huidige caching DataBlock (%): 32
verwijderd (MB): 913, ratio 1.0, overhead (%): 356, zware verwijderingscounter: 8, huidige caching DataBlock (%): 29
verwijderd (MB): 912, ratio 0.89, overhead (%): 356, zware verwijderingscounter: 9, huidige caching DataBlock (%): 26
verwijderd (MB): 684, ratio 0.76, overhead (%): 242, zware verwijderingscounter: 10, huidige caching DataBlock (%): 24
verwijderd (MB): 684, ratio 0.61, overhead (%): 242, zware verwijderingscounter: 11, huidige caching DataBlock (%): 22
verwijderd (MB): 456, ratio 0.51, overhead (%): 128, zware verwijderingscounter: 12, huidige caching DataBlock (%): 21
verwijderd (MB): 456, ratio 0.42, overhead (%): 128, zware verwijderingscounter: 13, huidige caching DataBlock (%): 20
verwijderd (MB): 456, ratio 0.33, overhead (%): 128, zware verwijderingscounter: 14, huidige caching DataBlock (%): 19
verwijderd (MB): 342, ratio 0.33, overhead (%): 71, zware verwijderingscounter: 15, huidige caching DataBlock (%): 19
verwijderd (MB): 342, ratio 0.32, overhead (%): 71, zware verwijderingscounter: 16, huidige caching DataBlock (%): 19
verwijderd (MB): 342, ratio 0.31, overhead (%): 71, zware verwijderingscounter: 17, huidige caching DataBlock (%): 19
verwijderd (MB): 228, ratio 0.3, overhead (%): 14, zware verwijderingscounter: 18, huidige caching DataBlock (%): 19
verwijderd (MB): 228, ratio 0.29, overhead (%): 14, zware verwijderingscounter: 19, huidige caching DataBlock (%): 19
verwijderd (MB): 228, ratio 0.27, overhead (%): 14, zware verwijderingscounter: 20, huidige caching DataBlock (%): 19
verwijderd (MB): 228, ratio 0.25, overhead (%): 14, zware verwijderingscounter: 21, huidige caching DataBlock (%): 19
verwijderd (MB): 228, ratio 0.24, overhead (%): 14, zware verwijderingscounter: 22, huidige caching DataBlock (%): 19
verwijderd (MB): 228, ratio 0.22, overhead (%): 14, zware verwijderingscounter: 23, huidige caching DataBlock (%): 19
verwijderd (MB): 228, ratio 0.21, overhead (%): 14, zware verwijderingscounter: 24, huidige caching DataBlock (%): 19
verwijderd (MB): 228, ratio 0.2, overhead (%): 14, zware verwijderingscounter: 25, huidige caching DataBlock (%): 19
verwijderd (MB): 228, ratio 0.17, overhead (%): 14, zware verwijderingscounter: 26, huidige caching DataBlock (%): 19
verdrongen (MB): 456, verhouding 0.17, overhead (%): 128, zware verdringingsaccount: 27, huidige caching DataBlock (%): 18 < toegevoegd krijgt (maar tabel hetzelfde)
verdrongen (MB): 456, verhouding 0.15, overhead (%): 128, zware verdringingsaccount: 28, huidige caching DataBlock (%): 17
verdrongen (MB): 342, verhouding 0.13, overhead (%): 71, zware verdringingsaccount: 29, huidige caching DataBlock (%): 17
verdrongen (MB): 342, verhouding 0.11, overhead (%): 71, zware verdringingsaccount: 30, huidige caching DataBlock (%): 17
verdrongen (MB): 342, verhouding 0.09, overhead (%): 71, zware verdringingsaccount: 31, huidige caching DataBlock (%): 17
verdrongen (MB): 228, verhouding 0.08, overhead (%): 14, zware verdringingsaccount: 32, huidige caching DataBlock (%): 17
verdrongen (MB): 228, verhouding 0.07, overhead (%): 14, zware verdringingsaccount: 33, huidige caching DataBlock (%): 17
verdrongen (MB): 228, verhouding 0.06, overhead (%): 14, zware verdringingsaccount: 34, huidige caching DataBlock (%): 17
verdrongen (MB): 228, verhouding 0.05, overhead (%): 14, zware verdringingsaccount: 35, huidige caching DataBlock (%): 17
verdrongen (MB): 228, verhouding 0.05, overhead (%): 14, zware verdringingsaccount: 36, huidige caching DataBlock (%): 17
verdrongen (MB): 228, verhouding 0.04, overhead (%): 14, zware verdringingsaccount: 37, huidige caching DataBlock (%): 17
verdrongen (MB): 109, verhouding 0.04, overhead (%): -46, zware verdringingsaccount: 37, huidige caching DataBlock (%): 22 < terugdruk
verdrongen (MB): 798, verhouding 0.24, overhead (%): 299, zware verdringingsaccount: 38, huidige caching DataBlock (%): 20
verdrongen (MB): 798, verhouding 0.29, overhead (%): 299, zware verdringingsaccount: 39, huidige caching DataBlock (%): 18
verdrongen (MB): 570, verhouding 0.27, overhead (%): 185, zware verdringingsaccount: 40, huidige caching DataBlock (%): 17
verdrongen (MB): 456, verhouding 0.22, overhead (%): 128, zware verdringingsaccount: 41, huidige caching DataBlock (%): 16
verdrongen (MB): 342, verhouding 0.16, overhead (%): 71, zware verdringingsaccount: 42, huidige caching DataBlock (%): 16
verdrongen (MB): 342, verhouding 0.11, overhead (%): 71, zware verdringingsaccount: 43, huidige caching DataBlock (%): 16
verdrongen (MB): 228, verhouding 0.09, overhead (%): 14, zware verdringingsaccount: 44, huidige caching DataBlock (%): 16
verdrongen (MB): 228, verhouding 0.07, overhead (%): 14, zware verdringingsaccount: 45, huidige caching DataBlock (%): 16
verdrongen (MB): 228, verhouding 0.05, overhead (%): 14, zware verdringingsaccount: 46, huidige caching DataBlock (%): 16
verdrongen (MB): 222, verhouding 0.04, overhead (%): 11, zware verdringingsaccount: 47, huidige caching DataBlock (%): 16
verdrongen (MB): 104, verhouding 0.03, overhead (%): -48, zware verdringingsaccount: 47, huidige caching DataBlock (%): 21 < onderbreking krijgt
verdrongen (MB): 684, verhouding 0.2, overhead (%): 242, zware verdringingsaccount: 48, huidige caching DataBlock (%): 19
verdrongen (MB): 570, verhouding 0.23, overhead (%): 185, zware verdringingsaccount: 49, huidige caching DataBlock (%): 18
verdrongen (MB): 342, verhouding 0.22, overhead (%): 71, zware verdringingsaccount: 50, huidige caching DataBlock (%): 18
verdrongen (MB): 228, verhouding 0.21, overhead (%): 14, zware verdringingsaccount: 51, huidige caching DataBlock (%): 18
verdrongen (MB): 228, verhouding 0.2, overhead (%): 14, zware verdringingsaccount: 52, huidige caching DataBlock (%): 18
verdrongen (MB): 228, verhouding 0.18, overhead (%): 14, zware verdringingsaccount: 53, huidige caching DataBlock (%): 18
verdrongen (MB): 228, verhouding 0.16, overhead (%): 14, zware verdringingsaccount: 54, huidige caching DataBlock (%): 18
verdrongen (MB): 228, verhouding 0.14, overhead (%): 14, zware verdringingsaccount: 55, huidige caching DataBlock (%): 18
verdrongen (MB): 112, verhouding 0.14, overhead (%): -44, zware verdringingsaccount: 55, huidige caching DataBlock (%): 23 < terugdruk
verdrongen (MB): 456, verhouding 0.26, overhead (%): 128, zware verdringingsaccount: 56, huidige caching DataBlock (%): 22
verdrongen (MB): 342, verhouding 0.31, overhead (%): 71, zware verdringingsaccount: 57, huidige caching DataBlock (%): 22
uitgezet (MB): 342, ratio 0.33, overhead (%): 71, zware uitzettings teller: 58, huidige caching DataBlock (%): 22
uitgezet (MB): 342, ratio 0.33, overhead (%): 71, zware uitzettings teller: 59, huidige caching DataBlock (%): 22
uitgezet (MB): 342, ratio 0.33, overhead (%): 71, zware uitzettings teller: 60, huidige caching DataBlock (%): 22
uitgezet (MB): 342, ratio 0.33, overhead (%): 71, zware uitzettings teller: 61, huidige caching DataBlock (%): 22
uitgezet (MB): 342, ratio 0.33, overhead (%): 71, zware uitzettings teller: 62, huidige caching DataBlock (%): 22
uitgezet (MB): 342, ratio 0.33, overhead (%): 71, zware uitzettings teller: 63, huidige caching DataBlock (%): 22
uitgezet (MB): 342, ratio 0.32, overhead (%): 71, zware uitzettings teller: 64, huidige caching DataBlock (%): 22
uitgezet (MB): 342, ratio 0.33, overhead (%): 71, zware uitzettings teller: 65, huidige caching DataBlock (%): 22
uitgezet (MB): 342, ratio 0.33, overhead (%): 71, zware uitzettings teller: 66, huidige caching DataBlock (%): 22
uitgezet (MB): 342, ratio 0.32, overhead (%): 71, zware uitzettings teller: 67, huidige caching DataBlock (%): 22
uitgezet (MB): 342, ratio 0.33, overhead (%): 71, zware uitzettings teller: 68, huidige caching DataBlock (%): 22
uitgezet (MB): 342, ratio 0.32, overhead (%): 71, zware uitzettings teller: 69, huidige caching DataBlock (%): 22
uitgezet (MB): 342, ratio 0.32, overhead (%): 71, zware uitzettings teller: 70, huidige caching DataBlock (%): 22
uitgezet (MB): 342, ratio 0.33, overhead (%): 71, zware uitzettings teller: 71, huidige caching DataBlock (%): 22
uitgezet (MB): 342, ratio 0.33, overhead (%): 71, zware uitzettings teller: 72, huidige caching DataBlock (%): 22
uitgezet (MB): 342, ratio 0.33, overhead (%): 71, zware uitzettings teller: 73, huidige caching DataBlock (%): 22
uitgezet (MB): 342, ratio 0.33, overhead (%): 71, zware uitzettings teller: 74, huidige caching DataBlock (%): 22
uitgezet (MB): 342, ratio 0.33, overhead (%): 71, zware uitzettings teller: 75, huidige caching DataBlock (%): 22
uitgezet (MB): 342, ratio 0.33, overhead (%): 71, zware uitzettings teller: 76, huidige caching DataBlock (%): 22
uitgezet (MB): 21, ratio 0.33, overhead (%): -90, zware uitzettings teller: 76, huidige caching DataBlock (%): 32
verwijderd (MB): 0, ratio 0.0, overhead (%): -100, zware verwijderingscounter: 0, huidige caching DataBlock (%): 100
verwijderd (MB): 0, ratio 0.0, overhead (%): -100, zware verwijderingscounter: 0, huidige caching DataBlock (%): 100
Scans waren nodig om hetzelfde proces in de vorm van een grafiek weer te geven van de verhouding tussen twee delen van de cache - single (waar block dat nog nooit is opgevraagd binnenkomt) en multi (hier worden 'gevraagde' gegevens bewaard die minstens één keer zijn opgevraagd):
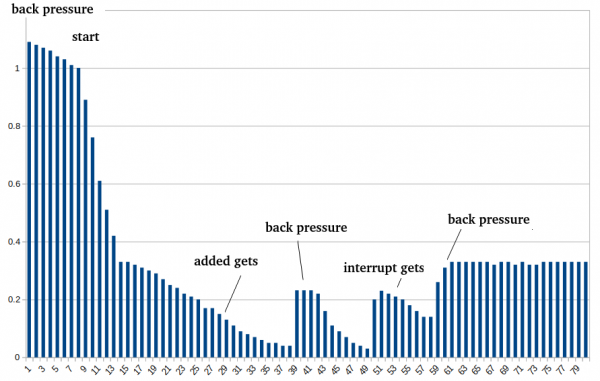
En tot slot, hoe de werking van de parameters eruitziet in de vorm van een grafiek. Ter vergelijking was de cache in het begin volledig uitgeschakeld, daarna werd HBase gestart met caching en een uitgestelde start van de optimalisatie van 5 minuten (30 cyclus-uitzettingen).
De volledige code is te vinden in de Pull Request op github.
Echter, 300 duizend lezingen per seconde is niet alles wat je uit deze hardware onder deze omstandigheden kunt halen. Het probleem is dat wanneer je gegevens via HDFS moet benaderen, er een mechanisme is genaamd ShortCircuitCache (verder SSC), die toegang tot gegevens rechtstreeks mogelijk maakt, wat netwerkinvoer vermijdt.
Profilering heeft aangetoond dat deze mechanisme, hoewel het een grote winst oplevert, op een bepaald moment zelf ook een knelpunt wordt, omdat vrijwel alle zware bewerkingen binnen de lock plaatsvinden, wat leidt tot blokkeringen gedurende een groot deel van de tijd.
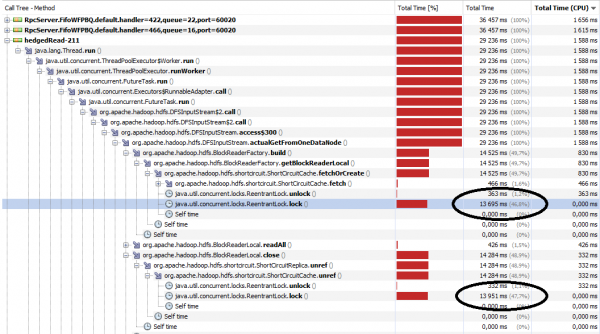
Door dit te beseffen, begrepen we dat we het probleem konden omzeilen door een array van onafhankelijke SSC's te creëren:
private final ShortCircuitCache[] shortCircuitCache;
...
shortCircuitCache = new ShortCircuitCache[this.clientShortCircuitNum];
for (int i = 0; i < this.clientShortCircuitNum; i++)
  this.shortCircuitCache[i] = new ShortCircuitCache(…);
En daarna hiermee werken, waarbij we over overlappingen heen stappen op basis van de laatste cijfer van de offset:
public ShortCircuitCache getShortCircuitCache(long idx) {
    return shortCircuitCache[(int) (idx % clientShortCircuitNum)];
}
Nu kunnen we met de tests beginnen. Hiervoor gaan we bestanden uit HDFS lezen met een eenvoudige multi-threaded applicatie. We stellen de parameters in:
conf.set("dfs.client.read.shortcircuit", "true");
conf.set("dfs.client.read.shortcircuit.buffer.size", "65536"); // standaard = 1 MB en dit vertraagt het lezen aanzienlijk, dus het is beter om het af te stemmen op de werkelijke behoeften
conf.set("dfs.client.short.circuit.num", num); // van 1 tot 10
En we lezen gewoon de bestanden:
FSDataInputStream in = fileSystem.open(path);
for (int i = 0; i  900000000)
        position = 0L;
    int res = in.read(position, byteBuffer, 0, 65536);
}
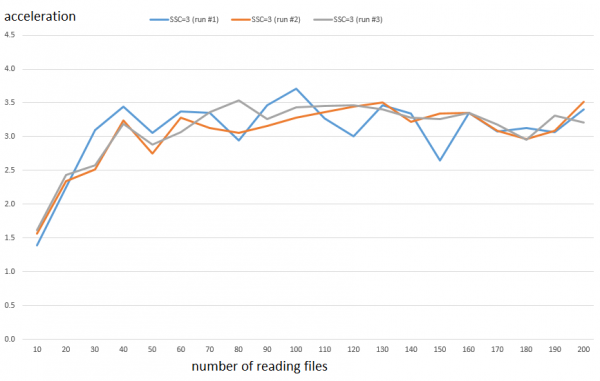
Deze code wordt uitgevoerd in aparte threads en we zullen het aantal gelijktijdig gelezen bestanden verhogen (van 10 tot 200 — horizontale as) en het aantal caches (van 1 tot 10 — grafieken). De verticale as toont de versnelling die toeneemt bij het verhogen van SSC in vergelijking met de situatie met slechts één cache.
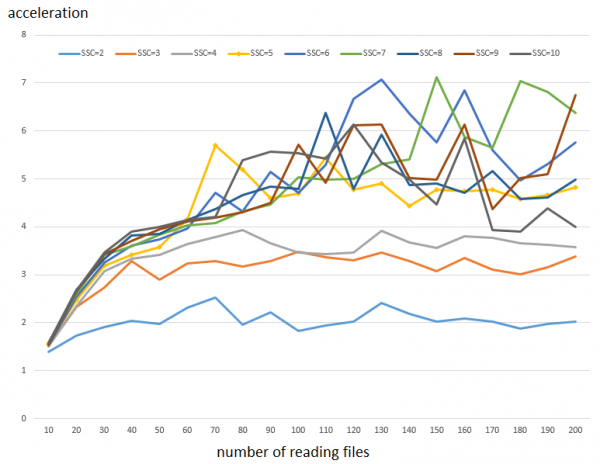
Hoe het diagram te lezen: de tijd die nodig is voor 100.000 leesbewerkingen in blokken van 64 KB met één cache vereist 78 seconden. Terwijl dit met 5 caches in 16 seconden wordt uitgevoerd. Dit betekent een versnelling van ~5 keer. Zoals te zien is in het diagram, is het effect met een klein aantal gelijktijdige lezingen niet erg merkbaar; dit begint een aanzienlijke rol te spelen wanneer het aantal leesstromen meer dan 50 is. Ook valt op dat het verhogen van het aantal SSC van 6 en hoger aanzienlijk minder prestatieverbetering oplevert.
Opmerking 1: Omdat de testresultaten vrij volatiel zijn (zie hieronder), zijn er 3 runs uitgevoerd en zijn de verkregen waarden gemiddeld.
Opmerking 2: De prestatieverbetering van de instelling voor willekeurige toegang is hetzelfde, hoewel de toegang zelf iets langzamer is.
Het is echter belangrijk op te merken dat, in tegenstelling tot de situatie met HBase, deze versnelling niet altijd gratis is. Hier 'ontgrendelen' we meer de mogelijkheden van de CPU om werk te verrichten, in plaats van dat deze vastloopt op locks.
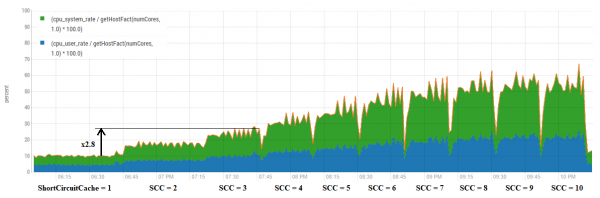
Hieruit blijkt dat in het algemeen een toename van het aantal caches leidt tot een ongeveer proportionele toename van het CPU-verbruik. Er zijn echter enkele combinaties die gunstiger zijn.
Laten we bijvoorbeeld eens iets nader kijken naar de instelling SSC = 3. De prestatieverbetering in het bereik is ongeveer 3,3 keer. Hieronder staan de resultaten van alle drie afzonderlijke runs.
Terwijl het CPU-verbruik ongeveer met 2,8 keer toeneemt. Het verschil is niet heel groot, maar de kleine Greta is er al blij mee en het geeft misschien de mogelijkheid om naar school en lessen te gaan.
Dit zal dus een positief effect hebben voor elk hulpmiddel dat massale toegang tot HDFS gebruikt (bijvoorbeeld Spark, enz.), op voorwaarde dat de applicatiecode licht is (d.w.z. de bottleneck ligt aan de kant van de HDFS-client) en er vrije CPU-capaciteit is. Laten we testen welk effect het gezamenlijke gebruik van BlockCache-optimalisatie en SSC-tuning voor het lezen uit HBase zal hebben.
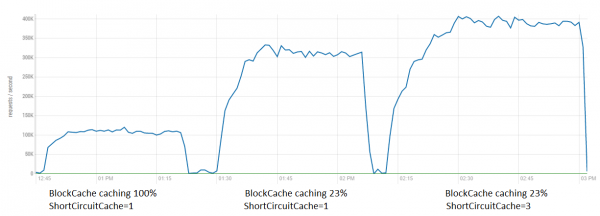
Hier is te zien dat onder dergelijke omstandigheden het effect niet zo groot is als in verfijnde tests (lezen zonder enige verwerking), maar het is heel goed mogelijk om nog eens 80K extra te realiseren. Samen zorgen beide optimalisaties voor een versnelling tot 4 keer.
Er is ook een PR gemaakt voor deze optimalisatie , die is samengevoegd en deze functionaliteit zal beschikbaar zijn in de volgende versies.
Ten slotte was het interessant om de leesprestaties van een soortgelijke wide-column database, Cassandra, en HBase te vergelijken.
Hiervoor zijn instanties van de standaard belastingstesttool YCSB vanaf twee hosts uitgevoerd (totaal 800 threads). Aan de serverzijde — 4 instanties van RegionServer en Cassandra op 4 hosts (niet dezelfde als waar de clients draaien, om hun invloed te vermijden). Het lezen vond plaats vanuit tabellen met een grootte van:
HBase — 300 GB op HDFS (100 GB schone gegevens)
Cassandra — 250 GB (replicatiefactor = 3)
Dus de omvang was ongeveer hetzelfde (iets meer in HBase).
HBase-instellingen:
dfs.client.short.circuit.num = 5 (optimalisatie van de HDFS-client)
hbase.lru.cache.heavy.eviction.count.limit = 30 — dit betekent dat de patch begint te werken na 30 uitzettingen (~5 minuten)
hbase.lru.cache.heavy.eviction.mb.size.limit = 300 — doelgrootte voor caching en uitzetting
De logs van YCSB zijn geparsed en samengevoegd in Excel-grafieken:
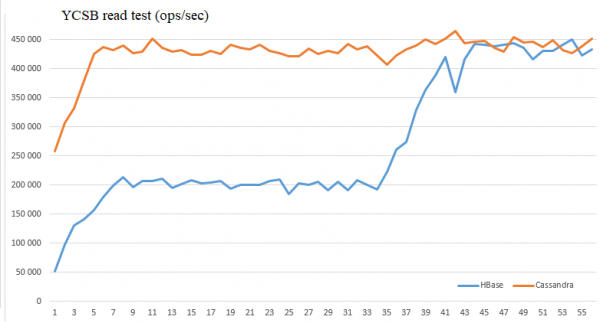
Zoals blijkt, stelt deze optimalisatie het mogelijk om de prestaties van deze databases onder deze omstandigheden gelijk te trekken en 450.000 lezingen per seconde te bereiken.
We hopen dat deze informatie nuttig kan zijn voor iemand in de boeiende strijd om prestaties.
Bron: habr.com
