

Velen zijn bekend met de database PostgreSQL, en deze heeft zich uitstekend bewezen in kleine installaties. Echter, de trend naar Open Source wordt steeds duidelijker, zelfs als het gaat om grote bedrijven en enterprise vereisten. In dit artikel bespreken we hoe we Postgres kunnen integreren in een zakelijke omgeving, en delen we ervaringen over het opzetten van een back-upsysteem (BKS) voor deze database met behulp van het Commvault back-upsysteem.
PostgreSQL heeft zijn waarde al bewezen — de database functioneert perfect, wordt gebruikt door trendy digitale bedrijven zoals Alibaba en TripAdvisor, en het ontbreken van licentiekosten maakt het een aantrekkelijke optie in vergelijking met giganten zoals MS SQL of Oracle DB. Maar zodra we beginnen na te denken over PostgreSQL in het enterprise landschap, stuiten we meteen op strenge eisen: "Hoe zit het met de beschikbaarheid van de configuratie? Hoe zit het met de rampenbestendigheid? Waar is de uitgebreide monitoring? En hoe zit het met de geautomatiseerde back-ups? En het gebruik van tape bibliotheken, zowel direct als voor secundaire opslag?"
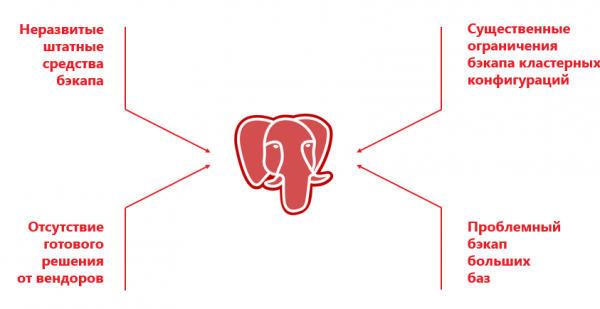
Aan de ene kant heeft PostgreSQL geen ingebouwde back-up mogelijkheden zoals de ‘volwassen’ databases RMAN van Oracle DB of SAP Database Backup. Aan de andere kant ondersteunen leveranciers van enterprise back-upsystemen (Veeam, Veritas, Commvault) PostgreSQL, maar werken feitelijk alleen met een specifieke (meestal standalone) configuratie en een reeks beperkingen.
Speciaal ontwikkelde back-upsystemen voor PostgreSQL, zoals Barman, Wal-g en pg_probackup, zijn uiterst populair in kleine installaties van de PostgreSQL database of waar zware back-ups van andere IT-onderdelen niet nodig zijn. Bijvoorbeeld, naast PostgreSQL kan de infrastructuur fysieke en virtuele componenten bevatten. servers, OpenShift, Oracle, MariaDB, Cassandra, enzovoorts. Dit alles is wenselijk om met één hulpmiddel te back-uppen. Een aparte oplossing enkel voor PostgreSQL opzetten is geen goed idee: gegevens worden ergens naar een schijf gekopieerd, en daarna moeten ze naar tape worden overgebracht. Deze dubbele back-up vergroot de tijd voor het maken van een back-up en, wat nog kritischer is, het herstel.
In enterprise solutions, the backup of installations occurs with a certain number of nodes dedicated to the cluster. For instance, Commvault can only work with a two-node cluster where the Primary and Secondary are strictly tied to specific nodes. Moreover, there is little point in backing up from the Secondary, as it has its own limitations. Due to the characteristics of the DBMS, a dump is not created on the Secondary, so only the option of file backup remains.
To reduce the risk of downtime, a 'live' cluster configuration is created when establishing a fault-tolerant system, and the Primary can gradually migrate between different servers. For example, the Patroni software automatically starts the Primary on a randomly selected node in the cluster. The SRB has no way to track this 'out of the box', and if the configuration changes, the processes break. In other words, the introduction of external management interferes with the effective operation of the SRB because the management server simply does not understand where and what data needs to be copied.
Another issue is the implementation of backup in Postgres. It is possible through a dump, and it works well for small databases. However, for large databases, creating a dump takes a long time, requires many resources, and can lead to a failure of the database instance.
File backup corrects the situation, but on large databases, it proceeds slowly because it operates in single-threaded mode. Additionally, vendors have a whole range of additional limitations. Sometimes you can't use both file and dump backups simultaneously, and sometimes deduplication is not supported. There are many issues, and often it is easier to choose an expensive but proven DBMS instead of Postgres.
There is no turning back! Behind us is Moscow, the developers!
However, recently our team faced a challenging task: in the project of creating the AIS OSAGO 2.0, where we built the IT infrastructure, the developers for the new system chose PostgreSQL.
For large software developers, it is much easier to use 'trendy' open-source solutions. Facebook has enough specialists on staff to support the operation of this DBMS. In the case of RSA, all 'next day' tasks fell on our shoulders. We were required to ensure fault tolerance, assemble the cluster, and, of course, set up backup. The logic of our actions was as follows:
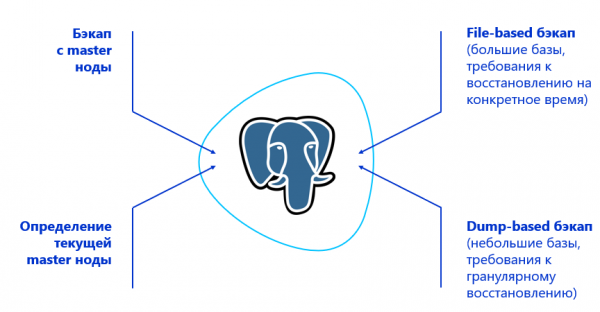
- De SRK leren om een back-up te maken van de primaire knoop van het cluster. Hiervoor moet de SRK deze kunnen vinden – wat betekent dat er een integratie met een of andere oplossing voor clusterbeheer van PostgreSQL nodig is. In het geval van RSA werd hiervoor de software Patroni gebruikt.
- Bepaal het type back-up, afhankelijk van de datavolumes en de herstelvereisten. Bijvoorbeeld, als pagina's granular moeten worden hersteld, gebruik dan een dump, en als de databases groot zijn en granular herstel niet nodig is, werk dan op het niveau van bestanden.
- Voeg de mogelijkheid van block-level back-up toe aan de oplossing, zodat er een back-up in multithreaded modus kan worden gemaakt.
In eerste instantie stelden we ons ten doel om een efficiënte en eenvoudige systeem te creëren zonder een monsterlijke omkadering van extra componenten. Hoe minder tijdelijke oplossingen, hoe minder belasting voor het personeel en hoe lager het risico dat de SRK uitvalt. Benaderingen waarbij Veeam en RMAN werden gebruikt, hebben we onmiddellijk uitgesloten, omdat een combinatie van twee oplossingen al wijst op de onbetrouwbaarheid van het systeem.
Een beetje magie voor enterprise
Dus, we moesten betrouwbare back-ups garanderen voor 10 clusters, elk met 3 knopen, terwijl in de back-up datacenter een identieke infrastructuur spiegelt. De datacenters werken volgens het active-passive principe in termen van PostgreSQL. De totale databaseomvang bedroeg 50 TB. Dit is gemakkelijk te beheren voor elke enterprise-level SRK. Maar het punt is dat er aanvankelijk in Postgres geen houvast is voor volledige en diepgaande compatibiliteit met back-upsystemen. Daarom moesten we een oplossing zoeken die vanaf het begin over maximale functionaliteit beschikt in combinatie met PostgreSQL en het systeem verder uitbreiden.
We hebben 3 interne hackathons gehouden – meer dan vijftig projecten bekeken, getest, wijzigingen aangebracht op basis van onze hypotheses en opnieuw getest. Na het analyseren van de beschikbare opties hebben we Commvault gekozen. Dit product kon al ‘out of the box’ werken met de eenvoudigste clusterinstallatie van PostgreSQL, en zijn open architectuur gaf hoop (die werd waargemaakt) op een succesvolle uitbreiding en integratie. Bovendien kan Commvault back-ups van PostgreSQL-logs uitvoeren. Bijvoorbeeld, Veritas NetBackup kan alleen volledige back-ups van PostgreSQL maken.
Meer over de architectuur. De beheerserver van Commvault is in elke van de twee datacenters (DC) geïnstalleerd in een CommServ HA-configuratie. Het systeem is spiegelbeeldig, bestuurd via één console en voldoet vanuit een HA-oogpunt aan alle enterprise-eisen.
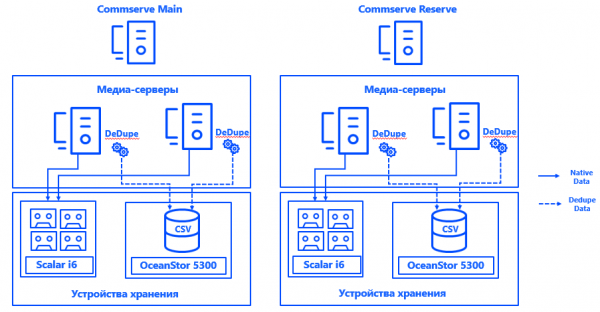
Daarnaast hebben we in elk datacenter twee fysieke mediaservers geïmplementeerd, waaraan via SAN over Fibre Channel speciaal voor back-ups toegewezen opslagarrays en tape-bibliotheken zijn verbonden. De verspreide deduplicatie-databases zorgen voor de fouttolerantie van de mediaservers, terwijl de verbinding van elke server met elk CSV de mogelijkheid biedt voor continue werking bij uitval van een component. De architectuur van het systeem stelt ons in staat om door te gaan met back-uppen, zelfs als een van de datacenters uitvalt.
Patroni bepaalt de primaire node voor elk cluster. Dit kan elke beschikbare node in het datacenter zijn - maar alleen de primaire. In de reserve zijn alle nodes secundair.
Om Commvault te laten begrijpen welke node van het cluster de primaire is, hebben we het systeem geïntegreerd (dankzij de open architectuur van de oplossing) met Postgres. Hiervoor is een script gemaakt dat de huidige locatie van de primaire node aan de beheerder meldt. server Commvault.
Over het algemeen ziet het proces er als volgt uit:
Patroni selecteert de primaire → Keepalived activeert het IP-cluster en voert het script uit → de Commvault-agent op de geselecteerde node van het cluster ontvangt een melding dat dit de primaire is → Commvault past automatisch de back-upinstellingen aan binnen de pseudoklanten.
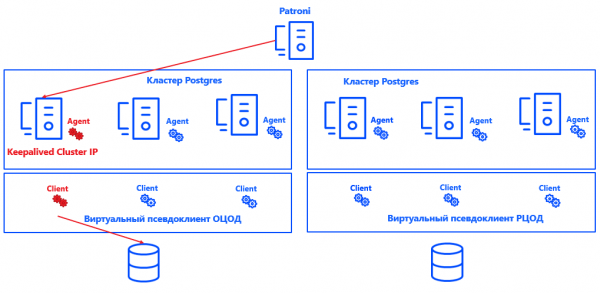
Een voordeel van deze benadering is dat de oplossing geen invloed heeft op de consistentie, de juistheid van logs, of het herstel van de Postgres-instantie. Het is ook eenvoudig schaalbaar, omdat het niet langer nodig is om primaire en secundaire nodes voor Commvault vast te leggen. Het is voldoende dat het systeem begrijpt waar de primaire is, en het aantal nodes kan praktisch tot elke waarde worden verhoogd.
De oplossing claimt niet perfect te zijn en heeft zijn nuances. Commvault kan alleen de gehele instantie back-uppen, niet afzonderlijke databases. Daarom is voor elke database een aparte instantie gecreëerd. Werkelijke klanten zijn samengevoegd in virtuele pseudoklanten. Elke pseudoklant van Commvault vertegenwoordigt een UNIX-cluster. Hierin worden die nodes van het cluster toegevoegd waarop de Commvault-agent voor Postgres is geïnstalleerd. Als gevolg hiervan worden alle virtuele nodes van de pseudoklant als één instantie geback-upt.
Binnen elke pseudo-client staat een actieve cluster-node vermeld. Dit is de node die onze integratieoplossing voor Commvault vastlegt. Het principe van de werking is vrij eenvoudig: als er een cluster-IP op de node omhoog komt, stelt het script de parameter 'actieve node' in de Commvault-agent in — feitelijk plaatst het script '1' op het juiste deel van het geheugen. De agent verstuurt deze gegevens naar CommServe, en Commvault maakt een backup vanaf de benodigde node. Bovendien controleert het script de juistheid van de configuratie, zodat fouten bij het starten van de backup worden voorkomen.
Grote databases worden geback-upt in blokken in meerdere streams, waardoor wordt voldaan aan de RPO-eisen en de backup-vensters. De belasting van het systeem is verwaarloosbaar: Full-backups komen niet zo vaak voor; op de andere dagen worden alleen logs verzameld, en dat tijdens periodes van lage belasting.
Overigens hebben we aparte beleidsregels toegepast voor het back-uppen van archieflogs van PostgreSQL — deze worden onder andere regels bewaard, worden volgens een ander schema gekopiëerd en voor hen wordt geen deduplicatie ingeschakeld, omdat deze logs unieke gegevens bevatten.
Om de consistentie van de gehele IT-infrastructuur te waarborgen, zijn afzonderlijke file-clients van Commvault op elke node van het cluster geïnstalleerd. Deze sluiten PostgreSQL-bestanden uit van de backups en zijn uitsluitend bedoeld voor het back-uppen van besturingssystemen en applicaties. Voor deze gegevens is ook een eigen beleid en bewaartermijn vastgesteld.
Momenteel heeft SRK geen invloed op de productieve diensten, maar als de situatie verandert, kan het systeem voor belastingbeperking in Commvault worden ingeschakeld.
Gaat het zo? Het gaat zo!
Dus, we hebben niet alleen een werkende, maar ook een volledig geautomatiseerde backup gekregen voor de clusterinstallatie van PostgreSQL, en die voldoet aan alle eisen voor enterprise-uitdagingen.
De RPO- en RTO-parameters van 1 uur en 2 uur zijn met een marge gedekt, wat betekent dat het systeem ook zal voldoen aan deze eisen bij een aanzienlijke toename van de hoeveelheid opgeslagen gegevens. Ondanks vele twijfels blijkt PostgreSQL goed te passen binnen een enterprise-omgeving. En nu weten we uit ervaring dat backups voor dergelijke DBMS'en mogelijk zijn in de meest uiteenlopende configuraties.
Natuurlijk hebben we op deze weg zeven paren ijzeren laarzen versleten, verschillende moeilijkheden overwonnen, een paar keer de plank misslagen en een aantal fouten gecorrigeerd. Maar nu is de aanpak beproefd en kan deze worden toegepast voor de implementatie van Open Source in plaats van propriëtaire databasesystemen in de zware enterprise-omstandigheden.
Heeft u al geprobeerd om met PostgreSQL in een zakelijke omgeving te werken?
Authors:
Oleg Lavrenov, systeemontwerpingeneer voor datopslag bij 'Infosystem Jet'
Dmitry Erykin, systeemontwerpingeneer voor computercomplexen bij 'Infosystem Jet'
Bron: habr.com
