

Men zegt dat je in het leven alles minstens één keer moet proberen. En als je gewend bent om met relationele databases te werken, is het de moeite waard om NoSQL in de praktijk te leren kennen, in ieder geval voor je algemene ontwikkeling. Nu, door de snelle ontwikkeling van deze technologie, zijn er veel tegenstrijdige meningen en vurig debat over dit onderwerp, wat de belangstelling extra aanwakkert.
Als je in de kern van al deze discussies duikt, zie je dat ze ontstaan door een verkeerde benadering. Degenen die NoSQL-databases gebruiken waar ze nodig zijn, zijn tevreden en halen alle voordelen uit deze oplossing. Maar de experimentators die op deze technologie vertrouwen als een panacea op plekken waar het helemaal niet toepasbaar is, ervaren teleurstelling doordat ze de sterke punten van relationele databases verliezen zonder significante voordelen te behalen.
Ik zal vertellen over onze ervaring met de implementatie van een oplossing gebaseerd op de Cassandra-database: met welke uitdagingen we te maken hebben gehad, hoe we uit moeilijke situaties zijn gekomen, of we winst hebben kunnen behalen uit het gebruik van NoSQL en waar we extra moeite/geld moesten investeren.
De oorspronkelijke taak is het opzetten van een systeem dat gesprekken in een bepaalde opslag inneemt.
Het principe van het systeem is als volgt. Bestanden met een bepaalde structuur beschrijven de structuur van de oproep. Vervolgens zorgt de applicatie ervoor dat deze structuur in de bijbehorende kolommen wordt opgeslagen. De opgeslagen oproepen worden later gebruikt - om informatie over het dataverbruik voor abonnees weer te geven (vergoedingen, gesprekken, balanst geschiedenis).
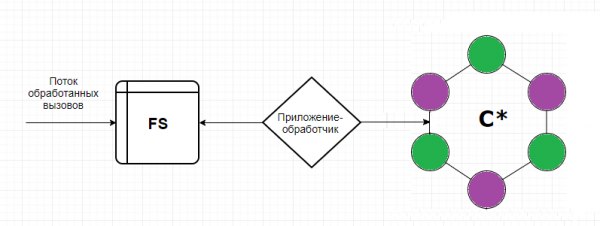
Waarom we voor Cassandra hebben gekozen is heel begrijpelijk - ze schrijft als een mitrailleur, is gemakkelijk schaalbaar en fouttolerant.
Dus, hier is wat onze ervaring ons heeft geleerd.
Ja, een uitgevallen node is geen tragedie. Dat is de essentie van de fouttolerantie van Cassandra. Maar een node kan wel levend zijn en toch beginnen te slepen in prestaties.. Zoals bleek, heeft dit onmiddellijk invloed op de prestaties van het hele cluster.
Cassandra biedt geen bescherming daar waar Oracle zijn constraints biedt.. En als de auteur van de applicatie dit van tevoren niet heeft begrepen, is een binnengekomen duplicaat voor Cassandra helemaal niet slechter dan het origineel. Het is gekomen, dus laten we het invoegen.
De gratis Cassandra ‘out of the box’ viel enorm tegen bij de beveiliging: er is geen logging van gebruikersacties, noch zijn er beperkingen van rechten.Informatie over oproepen betreft persoonlijke gegevens, wat betekent dat alle pogingen om deze op de een of andere manier op te vragen of te wijzigen, moeten worden gelogd met de mogelijkheid tot latere audit. Het is ook nodig om te beseffen dat de rechten op verschillende niveaus voor verschillende gebruikers moeten worden gescheiden. Een eenvoudige operationele ingenieur en een superadmin, die vrijelijk de hele keyspace kan verwijderen, zijn verschillende rollen met verschillende verantwoordelijkheden en competenties. Zonder deze scheiding van toegangsrechten komt de waarde en integriteit van gegevens sneller in kwestie dan bij een consistentieniveau ANY.
We hebben niet in aanmerking genomen dat er zowel serieuze analyses als periodieke steekproeven op verschillende voorwaarden nodig zijn. Aangezien de geselecteerde records daarna moeten worden verwijderd en overschreven (in het kader van de taak moeten we het proces van dataverificatie ondersteunen bij oorspronkelijk onjuist ingebrachte gegevens), is Cassandra hier geen goede keuze. Cassandra, als spaarpot – je kunt er gemakkelijk in stoppen, maar je kunt er niet mee rekenen.
We stonden voor het probleem van het overdragen van gegevens naar testzones. (5 nodes in de test tegen 20 in productie). In dit geval kunnen we geen dump gebruiken.
Probleem van updates van het datamodel van de applicatie die naar Cassandra schrijft. Terugrol zal een groot aantal tombstones opleveren, wat op een onvoorspelbare manier onze prestaties kan verlagen.Cassandra is geoptimaliseerd voor schrijven, en voordat het schrijft, denkt het er niet veel over na. Elke operatie met bestaande gegevens in Cassandra is ook een schrijfoperatie. Dat wil zeggen, door overbodige records te verwijderen, creëren we gewoon nog meer records, en slechts een deel daarvan zal als tombstones worden gemarkeerd.
Timeouts bij het invoegen. Cassandra is geweldig in schijven, maar soms kan de inkomende stroom haar aanzienlijk verwarren.Dit gebeurt wanneer de applicatie enkele records die om een of andere reden niet kunnen worden ingevoegd, in een lus begint te draaien. We zullen dan een echte DBA nodig hebben, die de gc.log, system logs en debuglogs in de gaten houdt op trage queries, en metrics voor compaction pending.
Meerdere datacentra in het cluster. Waarvan lezen en waar schrijven?
Is it possible to separate reading and writing? And if so, should the DC for writing be closer to the application or for reading? Won't we end up with a true split brain if we choose the wrong consistency level? So many questions, lots of unexplored settings and possibilities we want to experiment with.
How we solved it
To prevent the node from crashing, we disabled SWAP.. And now, when memory runs short, the node should crash instead of causing long gc pauses.
So, we no longer rely on logic in the DB. Application developers are rethinking their strategies and starting to actively safeguard their own code. An ideal clear separation of data storage and processing.
We purchased support from DataStax. The boxed version of Cassandra is no longer being developed (the last commit was in February 2018). At the same time, Datastax offers excellent service and a large number of refined solutions tailored to existing information systems.
I also want to note that Cassandra is not very convenient for query selection. Of course, CQL is a big step towards users (compared to Thrift). But if you have entire departments used to such convenient joins, free filtering by any field, and query optimization capabilities, and those departments are focused on addressing issues and outages, then a solution based on Cassandra may seem hostile and foolish to them. We started to address how our colleagues can make selections.
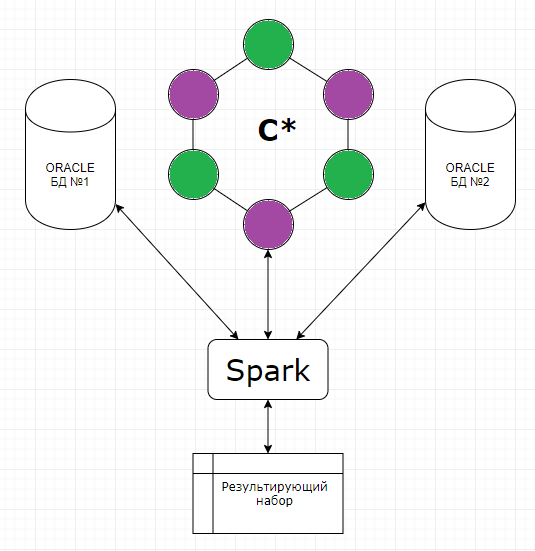
We considered two options. In the first option, we write calls not only in C*, but also in the archival Oracle DB. However, unlike C*, this DB only stores calls for the current month (which is enough for the requirements of re-pricing cases). Here, the next issue became apparent: if we write synchronously, we lose all the advantages of C* related to fast insertion; if asynchronously, there is no guarantee that all necessary calls have actually made it to Oracle. There was one significant benefit, though: for operations, we still have the familiar PL/SQL Developer, meaning we can practically implement the 'Facade' pattern. Alternative option. We implement a mechanism that extracts calls from C*, pulls some data for enrichment from the corresponding tables in Oracle, joins the results, and gives us the final output, which we can then use in some way (revert, repeat, analyze, marvel at). Downsides: the process turns out to be quite multi-step, and in addition, there is no interface for the operational staff.
In the end, we still settled on the second option. For selections from various databases, we used Apache Spark. The essence of the mechanism boiled down to Java code that extracts data from C* based on specified keys (subscriber, call time - section keys) and the necessary enrichment data from any other DB. After that, it joins them in memory and outputs the results into a result table. We created a web interface over Spark, and it turned out to be quite usable for operations.
Bij het oplossen van de taak voor het bijwerken van gegevens, overwoog het prom-testteam opnieuw verschillende manieren om dit te doen. Zowel de overdracht via Sstloader als de optie om de cluster in de testomgeving in twee delen te splitsen, waarvan elk om de beurt in één cluster met de productieomgeving moet worden opgenomen, waardoor het van daaruit van stroom wordt voorzien. Bij het bijwerken van de test was het de bedoeling om ze om te wisselen: dat deel dat in de test werkte, zou worden gewist en in de productie worden ingevoerd, terwijl de andere begon te werken met de gegevens apart. Echter, na nog eens goed te hebben nagedacht, hebben we de gegevens die we willen overdragen rationeler beoordeeld en realizeerden we ons dat de aanroepen op zichzelf een inconsistente entiteit voor tests zijn, snel gegenereerd indien nodig, en dat precies de productiedataset geen waarde heeft om naar de test te verplaatsen. Er zijn enkele accumulatorobjecten die het waard zijn om te verplaatsen, maar dat zijn letterlijk een paar tabellen, en bovendien niet erg zwaar. Daarom hebben we als oplossing opnieuw hulp gekregen van Spark, waarmee we een script hebben geschreven voor het actief gebruiken van gegevensoverdracht tussen tabellen in de productie-test.
Ons huidige deploymentbeleid stelt ons in staat om zonder terugrol te werken. Voor de productie is er een verplichte update naar de test, waar fouten minder kostbaar zijn. In geval van een mislukking kan de keyspace altijd worden gedropt en kan het hele schema vanaf het begin worden opnieuw geladen.
Om continue beschikbaarheid van Cassandra te waarborgen, is er een DBA nodig en niet alleen hij. Iedereen die met de applicatie werkt, moet begrijpen waar en hoe ze de huidige situatie kunnen bekijken en hoe ze tijdig problemen kunnen diagnosticeren. Daarom maken we actief gebruik van DataStax OpsCenter (beheer en monitoring van workloads), systeemstatistieken van de Cassandra-driver (aantal time-outs bij schrijven naar C*, aantal time-outs bij lezen uit C*, maximale latentie, etc.), en we monitoren de werking van de applicatie die met Cassandra werkt.
Toen we nadachten over de vorige vraag, realiseerden we ons waar ons grootste risico kan liggen. Dit zijn de vormen van gegevensweergave die gegevens uit meerdere onafhankelijke aanvragen aan de opslag ophalen. Hierdoor kunnen we behoorlijk inconsistente informatie verkrijgen. Maar dit probleem zou ook relevant zijn als we alleen met één datacenter werkten. Dus het meest verstandige hier is natuurlijk om een batch-gegevensleesfunctie op een externe applicatie te maken, die ervoor zorgt dat gegevens in één tijdsperiode worden verkregen. Wat betreft de scheiding tussen lezen en schrijven in termen van prestaties, werden we hier tegengehouden door het risico dat bij enige verlies van verbinding tussen datacenters, we twee volkomen inconsistente clusters kunnen krijgen.
Uiteindelijk, op dit moment hebben we gekozen voor een schrijfconsistentieniveau van EACH_QUORUM, voor het lezen – LOCAL_QUORUM
Korte indrukken en conclusies
Om de uiteindelijke oplossing te beoordelen vanuit het oogpunt van operationele ondersteuning en toekomstige ontwikkelingsperspectieven, hebben we besloten na te denken over waar we deze ontwikkeling nog meer kunnen toepassen.
Als we even snel kijken, dan is dat data scoring voor programma's zoals "Betaal, wanneer je het wilt" (we laden gegevens in S*, berekeningen op Spark-scripts), het bijhouden van klachten met aggregatie naar richting, het opslaan van rollen en het berekenen volgens de rolmatrix van gebruikersrechten.
Zoals we zien, is het repertoire breed en divers. En als we een keuze moeten maken tussen de voor- en tegenstanders van NoSQL, zullen we ons aansluiten bij de voorstanders, omdat we voordelen hebben behaald, juist daar waar we het verwachtten.
Zelfs de standaardversie van Cassandra biedt de mogelijkheid tot horizontale schaalvergroting in realtime, waardoor het probleem van gegevensvergroting in het systeem volledig pijnloos wordt opgelost. We hebben een aparte contour kunnen ontwikkelen voor een zeer zwaar belaste aggregator op basis van oproepen, evenals het scheiden van de structuur en logica van de applicatie, en ons ontdaan van de slechte praktijk van het schrijven van aangepaste jobs en objecten in de database zelf. We hebben de mogelijkheid gekregen om te kiezen en aan te passen, om de verwerking te versnellen, in welke datacenters we berekeningen zullen uitvoeren en in welke we gegevens zullen opslaan, en onszelf te beschermen tegen uitval van afzonderlijke nodes, evenals van datacenters in het algemeen.
Bij het toepassen van onze architectuur op nieuwe projecten, en met enige ervaring in het achterhoofd, zouden we graag onmiddellijk rekening houden met de hierboven beschreven nuances en enkele fouten willen voorkomen, en scherpe hoeken willen verzachten die aanvankelijk onvermijdelijk waren.
Bijvoorbeeld, op tijd de updates van Cassandra volgen, omdat veel van de problemen die we ondervonden, al bekend waren en zijn opgelost.
Zorg ervoor dat zowel de database als Spark niet op dezelfde knooppunten draaien (of strikt scheiden volgens het toegestane gebruik van middelen), omdat Spark meer geheugen kan verbruiken dan toegestaan, wat ons snel het probleem nummer 1 uit onze lijst zal opleveren.
De monitoring en exploitatie-competentie al in de testfase van het project verbeteren. Aanvankelijk moet maximaal rekening worden gehouden met alle potentiële afnemers van onze oplossing, omdat dit uiteindelijk de structuur van de database zal bepalen.
Draai het verkregen schema meerdere keren om mogelijke optimalisatie te overwegen. Bepaal welke velden kunnen worden geserialiseerd. Begrijp welke extra tabellen we moeten aanmaken om de vereiste informatie op de meest correcte en optimale manier te registreren en vervolgens op aanvraag uit te geven (bijvoorbeeld, met de aanname dat dezelfde gegevens in verschillende tabellen kunnen worden opgeslagen, rekening houdend met verschillende splitsingen volgens verschillende criteria, kunnen we aanzienlijk procesortijd besparen bij leesverzoeken).
Niet slecht van tevoren het instellen van TTL en het opschonen van verouderde gegevens voorzien.
Bij het exporteren van gegevens uit Cassandra moet de logica van de applicatie volgens het FETCH-principe werken, zodat niet alle rijen in één keer in het geheugen worden geladen, maar in batches worden geselecteerd.
Bij voorkeur vóór de migratie van het project naar de beschreven oplossing de bedrijfscontinuïteit van het systeem testen door een serie crash-tests uit te voeren, zoals dataverlies in één datacenter, het herstellen van corrupte gegevens over een bepaalde periode, en netwerkinstabiliteit tussen datacenters. Dergelijke tests zullen niet alleen de voor- en nadelen van de voorgestelde architectuur evalueren, maar bieden ook waardevolle oefening voor de ingenieurs die ze uitvoeren, en de verworven vaardigheden zullen zeker van pas komen als systeemstoringen zich in productie voordoen.
Als we met kritieke informatie werken (zoals gegevens voor facturering, het berekenen van de uitstaande schuld van een abonnee), is het ook belangrijk aandacht te besteden aan de tools die de risico's kunnen verlagen die voortkomen uit de specifieke kenmerken van de database. Bijvoorbeeld, door gebruik te maken van de nodesync-tool (Datastax) en een optimale strategie voor het gebruik ervan te ontwikkelen, zodat we om de consistentie te waarborgen geen overmatige belasting op Cassandra creëren. en deze alleen gebruiken voor bepaalde tabellen gedurende een bepaalde periode.
Hoe gaat het ondertussen, na een half jaar gebruik van Cassandra? Over het algemeen zijn er geen onopgeloste problemen. We hebben ook geen ernstige storingen of gegevensverlies toegestaan. Ja, we moesten nadenken over het compenseren van enkele problemen die eerder niet verschenen, maar uiteindelijk heeft dit ons architecturale besluit niet echt beïnvloed. Als je wilt en niet bang bent om iets nieuws te proberen, en je wilt niet teveel teleurgesteld worden, bereid je dan voor op het feit dat er niets gratis is. Je moet je meer verdiepen in de documentatie en je eigen unieke uitdagingen leren kennen dan bij een oude legacy-oplossing, en geen enkele theorie zal je van tevoren vertellen welke specifieke uitdagingen jou te wachten staan.
Bron: habr.com
