

Veel mensen hebben ervaring met Elasticsearch. Maar wat gebeurt er als je het gebruikt om logs "in bijzonder grote hoeveelheden" op te slaan? En dat zonder de pijn van een storing in een van de meerdere datacenters te moeten doorstaan? Hoe moet de architectuur eruitzien, en welke valkuilen kun je tegenkomen?
Bij Odnoklassniki hebben we besloten om met behulp van Elasticsearch de kwestie van logbeheer op te lossen, en nu delen we onze ervaringen met Habr: zowel over de architectuur als over de valkuilen.
Ik ben Petr Zaytsev, systeembeheerder bij Odnoklassniki. Daarvoor was ik ook admin en werkte ik met Manticore Search, Sphinx search, Elasticsearch. Als er nog een andere ...search verschijnt, zal ik daar vermoedelijk ook mee werken. Tevens neem ik deel aan verschillende open-sourceprojecten op vrijwillige basis.
Toen ik bij Odnoklassniki kwam, zei ik ondoordacht tijdens het sollicitatiegesprek dat ik met Elasticsearch kon werken. Nadat ik er bekend mee was geraakt en enkele eenvoudige taken had uitgevoerd, kreeg ik een grote taak toegewezen om het logbeheer systeem dat op dat moment bestond te hervormen.
Vereisten
De vereisten voor het systeem waren als volgt geformuleerd:
- Als frontend moest Graylog worden gebruikt. Omdat het bedrijf al ervaring had met dit product, waren de programmeurs en testers er mee bekend en vonden ze het handig.
- Volume van de data: gemiddeld 50-80.000 berichten per seconde, maar als er iets kapot gaat, is de verkeerscapaciteit niet beperkt en kan het oplopen tot 2-3 miljoen regels per seconde.
- Na bespreking van de vereisten met de klanten met betrekking tot de snelheid van het verwerken van zoekopdrachten, realiseerden we ons dat het typische gebruikspatroon van een dergelijk systeem als volgt is: mensen zoeken logs van hun applicatie van de afgelopen twee dagen en willen niet langer dan een seconde wachten op de resultaten van hun aanvraag.
- Admins drongen erop aan dat het systeem indien nodig gemakkelijk schaalbaar moest zijn, zonder dat zij diepgaand hoefden te begrijpen hoe het was opgezet.
- De enige onderhoudstaak die deze systemen periodiek vereisten, was het vervangen van hardware.
- Bovendien heeft Odnoklassniki een prachtige technische traditie: elke service die we lanceren, moet een datacenterstoring (plotseling, ongepland en op elk moment) kunnen doorstaan.
De laatste vereiste in de uitvoering van dit project heeft ons de meeste moeite gekost, waarover ik later meer zal vertellen.
Omgeving
We werken met vier datacenters, waarbij de datanodes van Elasticsearch zich alleen in drie kunnen bevinden (om enkele niet-technische redenen).
In deze vier datacenters bevinden zich ongeveer 18.000 verschillende logbronnen — apparatuur, containers, virtuele machines.
Belangrijke opmerking: de clusterstart gebeurt in containers niet op fysieke machines, maar op . Containers krijgen 2 cores toegewezen, vergelijkbaar met 2.0Ghz v4 met de mogelijkheid om andere cores te gebruiken in geval van idle.
Met andere woorden:
Topologie
Het algemene beeld van de oplossing zag er in het begin als volgt uit:
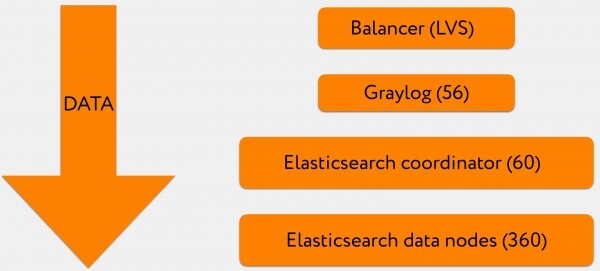
- 3-4 VIP's staan achter het A-record van het domein Graylog, dit is het adres waar de logs naartoe worden gestuurd.
- Elke VIP is een LVS-loadbalancer.
- Daarna komen de logs terecht in de Graylog-batterij, waarvan een deel van de gegevens in GELF-formaat is en een deel in syslog-formaat.
- Vervolgens wordt dit alles in grote batches geschreven naar de batterij van Elasticsearch-coördinatoren.
- Zij sturen op hun beurt lees- en schrijfverzoeken naar de relevante datanodes.
Terminologie
Misschien zijn niet iedereen goed bekend met de terminologie, daarom wil ik daar even bij stilstaan.
In Elasticsearch zijn er verschillende typen nodes — master, coordinator, data node. Er zijn nog twee andere types voor verschillende transformaties van logs en verbindingen tussen clusters, maar wij hebben alleen de genoemde gebruikt.
Master
Pingt alle aanwezige nodes in het cluster, houdt de actuele kaart van het cluster bij en verspreidt deze tussen de nodes, verwerkt event-logica, en doet allerlei clusterbreed onderhoud.
Coördinator
Voert één enkele taak uit: accepteert verzoeken van klanten voor lezen of schrijven en routert dit verkeer. In het geval van een schrijfverzoek vraagt hij waarschijnlijk de master in welke shard van de relevante index dit geplaatst moet worden en leidt het verzoek verder.
Data node
Bewaart gegevens, voert zoekopdrachten uit die van buiten komen en bewerkingen uit op de shards die erop liggen.
Graylog
Dit is iets als een combinatie van Kibana met Logstash in de ELK-stack. Graylog combineert zowel een UI als een pipeline voor het verwerken van logs. Onder de motorkap werkt Graylog met Kafka en Zookeeper, die de connectiviteit van Graylog als cluster waarborgen. Graylog kan logs cachen (Kafka) voor het geval Elasticsearch niet beschikbaar is en kan mislukte lees- en schrijfverzoeken opnieuw proberen, terwijl het logs groepeert en labelt op basis van gedefinieerde regels. Net als Logstash heeft Graylog functionaliteit om strings te modificeren voordat ze in Elasticsearch worden opgeslagen.
Bovendien heeft Graylog ingebouwde service discovery, waarmee je op basis van één beschikbare Elasticsearch-node de volledige clusterkaart kunt verkrijgen en deze kunt filteren op een bepaalde tag, wat de mogelijkheid biedt om verzoeken naar specifieke containers te sturen.
Visueel ziet dit er ongeveer zo uit:

Dit is een screenshot van een specifieke instantie. Hier bouwen we een histogram op basis van een zoekopdracht en tonen we relevante rijen.
Indexen
Terugkomend op de systeemarchitectuur, wil ik meer gedetailleerd ingaan op hoe we het indexmodel hebben opgebouwd om ervoor te zorgen dat alles correct functioneert.
In het eerder weergegeven diagram is dit het laagste niveau: Elasticsearch data nodes.
Een index is een grote virtuele entiteit die bestaat uit shards van Elasticsearch. Elke shard is in feite niets anders dan een Lucene-index. En elke Lucene-index bestaat op zijn beurt uit een of meer segmenten.
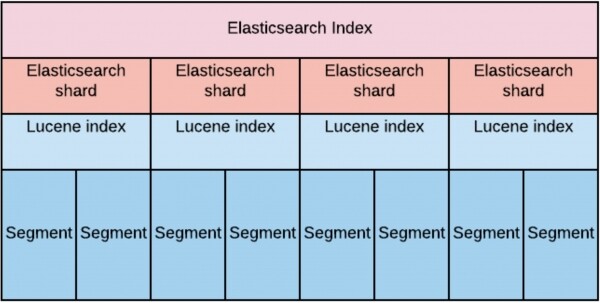
Bij het ontwerp hebben we geschat dat we om aan de snelheidseisen te voldoen, deze gegevens gelijkmatig over de data nodes moesten 'verdammen'.
Dit resulteerde erin dat het aantal shards per index (met replicaties) strikt gelijk moest zijn aan het aantal data nodes. Ten eerste om een replication factor van twee te waarborgen (dat wil zeggen, we kunnen de helft van het cluster verliezen). Ten tweede om ervoor te zorgen dat lees- en schrijfverzoeken op zijn minst op de helft van het cluster kunnen worden afgehandeld.
We hebben de bewaartijd eerst vastgesteld op 30 dagen.
De verdeling van shards kan grafisch als volgt worden weergegeven:
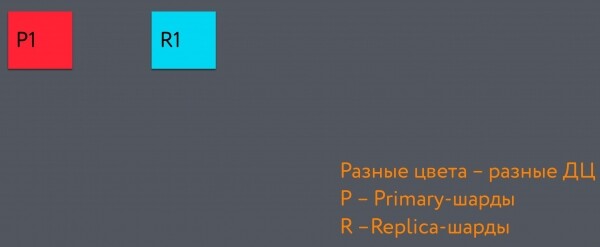
Het hele donkergrijze rechthoek is de index. De linkse rode vierkant daarin is de primary shard, de eerste in de index. Het blauwe vierkant is de replica-shard. Ze bevinden zich in verschillende datacenters.
Wanneer we een extra shard toevoegen, komt deze in het derde datacentrum. Uiteindelijk krijgen we zo'n structuur die het mogelijk maakt om een datacentrum te verliezen zonder dataverlies.
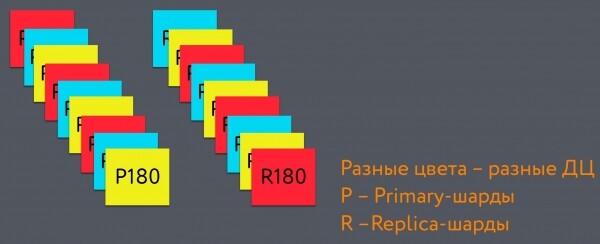
We hebben de rotatie van indexen, dat wil zeggen het aanmaken van een nieuwe index en het verwijderen van de oudste index, gelijkgesteld aan 48 uur (op basis van de indexgebruikspatronen: de laatste 48 uur worden het vaakst doorzocht).
Deze rotatieperiode van indexen is om de volgende redenen vastgesteld:
Wanneer een specifieke data-node een zoekopdracht ontvangt, is het vanuit prestatieperspectief voordeliger om één shard te raadplegen, mits de grootte ervan vergelijkbaar is met de heap-grootte van de node. Dit stelt ons in staat om het 'hete' deel van de index in de heap te houden en er snel toegang toe te krijgen. Wanneer er veel 'hete delen' zijn, vermindert de zoekprestaties van de index.
Wanneer een node begint met het uitvoeren van een zoekopdracht op een shard, wijst deze een aantal threads toe, gelijk aan het aantal hyper-threaded kernen van de fysieke machine. Als de zoekopdracht meerdere shards betreft, groeit het aantal threads proportioneel. Dit heeft een nadelige invloed op de zoekprestaties en schaadt de indexering van nieuwe gegevens.
Om de nodige zoektijd te waarborgen, hebben we ervoor gekozen om SSD's te gebruiken. Voor de snelle verwerking van verzoeken moesten de machines waarop deze containers werden gehost, minstens 56 kernen hebben. Het aantal van 56 werd gekozen als een voorwaardelijk voldoende hoeveelheid die het aantal threads bepaalt dat Elasticsearch tijdens het gebruik genereert. In Elasticsearch zijn veel parameters van de threadpool direct afhankelijk van het aantal beschikbare kernen, wat op zijn beurt direct invloed heeft op het benodigde aantal nodes in het cluster volgens het principe 'minder kernen — meer nodes'.
Het resultaat is dat een shard gemiddeld ongeveer 20 gigabyte weegt, en er 360 shards per index zijn. Als we deze om de 48 uur roteren, hebben we dus 15 stuks. Elke index bevat gegevens van 2 dagen.
Schemas voor het schrijven en lezen van gegevens
Laten we eens kijken hoe gegevens in dit systeem worden geschreven.
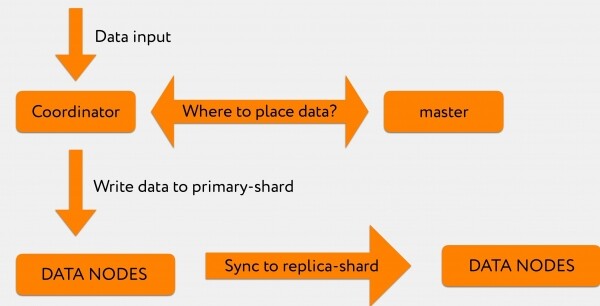
Stel dat er een verzoek van Graylog naar de coördinator komt. Bijvoorbeeld, we willen 2-3 duizend rijen indexeren.
De coördinator ontvangt een verzoek van Graylog en vraagt de master: "In het indexeringsverzoek was specifiek de index vermeld, maar niet in welke shard dit geschreven moet worden."
De master antwoordt: "Schrijf deze informatie in shard nummer 71", waarna het verzoek direct naar de relevante data-knoop wordt gestuurd, waar primary-shard nummer 71 zich bevindt.
Vervolgens wordt het transactie-log gerepliceerd naar de replica-shard, die zich al in een ander datacenter bevindt.
Een zoekopdracht komt van Graylog naar de coördinator. De coördinator leidt deze om via de index, terwijl Elasticsearch de aanvragen op basis van round-robin verdeelt tussen primary-shard en replica-shard.
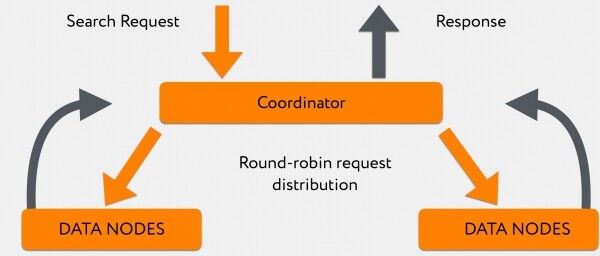
De 180 knopen reageren ongelijkmatig, en terwijl zij antwoorden, verzamelt de coördinator informatie die al eerder door snellere data-knooppunten is "gespuwd". Wanneer alle informatie is binnengekomen of de tijdslimiet is bereikt, geeft hij alles direct aan de klant.
Dit hele systeem verwerkt in gemiddeld 300-400 ms zoekopdrachten voor de afgelopen 48 uur, met uitzondering van de verzoeken met leading wildcard.
"Bloemetjes" met Elasticsearch: Java configureren
Om dit alles te laten werken zoals we oorspronkelijk wilden, hebben we heel lang verschillende zaken in het cluster geoptimaliseerd.
Het eerste deel van de ontdekte problemen had te maken met hoe Java standaard in Elasticsearch is ingesteld.
Probleem één
We zagen een zeer groot aantal meldingen dat er op het niveau van Lucene, wanneer achtergrondtaken worden uitgevoerd, merges van Lucene-segmenten met fouten eindigen. In de logs was te zien dat dit een OutOfMemoryError-fout was. Aan de telemetrie konden we zien dat de heap vrij was, en het was onduidelijk waarom deze operatie faalde.
Het bleek dat de merges van Lucene-indexen buiten de heap plaatsvonden. De containers waren behoorlijk beperkt in hun verbruikte hulpbronnen. Alleen de heap viel binnen deze middelen (de waarde van heap.size was ongeveer gelijk aan RAM), terwijl sommige off-heap operaties faalden met geheugenallocatiefouten als ze om een of andere reden niet binnen de ~500 MB bleven die overbleven tot de limiet.
De oplossing was behoorlijk triviaal: we hebben het beschikbare RAM voor de container verhoogd, waarna we vergeten zijn dat zulke problemen ooit zijn voorgekomen.
Probleem twee
Na ongeveer 4-5 dagen na de lancering van het cluster merkten we dat de data-knooppunten af en toe uit het cluster vielen en na ongeveer 10-20 seconden weer binnenkwamen.
Toen we de zaken onder de loep namen, bleek dat dit zogenaamde off-heap geheugen in Elasticsearch vrijwel helemaal niet wordt gecontroleerd. Toen we de container meer geheugen gaven, kregen we de mogelijkheid om diverse informatie in direct buffer pools te plaatsen, en dit werd pas gewist nadat een expliciete GC vanuit Elasticsearch werd gestart.
In sommige gevallen duurde deze operatie behoorlijk lang, en in die tijd had het cluster al deze node als non-actief gemarkeerd. Dit probleem is goed gedocumenteerd. .
De oplossing was als volgt: we beperkten de mogelijkheden van Java om het grootste deel van het geheugen buiten de heap voor deze operaties te gebruiken. We stelden een limiet in van 16 gigabyte (-XX:MaxDirectMemorySize=16g), waardoor expliciete GC veel vaker werd aangeroepen en aanzienlijk sneller werkte, wat het cluster stabiliseerde.
Probleem drie
Als je denkt dat de problemen met 'nodes die het cluster op het meest onvoorspelbare moment verlaten' hiermee zijn afgelopen, heb je het mis.
Toen we de configuratie voor indexen instelden, kozen we voor mmapfs om voor verse shards met een hoge segmentatie. Dit was een behoorlijk grove fout, want bij het gebruik van mmapfs wordt het bestand in het RAM gemapt, en daarna werken we met het gemapte bestand. Hierdoor duurt het bij een poging van GC om de threads in de applicatie te stoppen, lang voordat we in safepoint zijn, en onderweg naar safepoint reageert de applicatie niet meer op de verzoeken van de master of het nog leeft. Als gevolg hiervan denkt de master dat de node niet langer in het cluster aanwezig is. Na ongeveer 5-10 seconden wordt de garbage collector actief, komt de node tot leven, gaat weer het cluster in en start de initiatie van de shards. Dit deed sterk denken aan 'de productie die we verdienden' en was niet geschikt voor iets serieus.
Om dit gedrag te verhelpen, zijn we eerst overgestapt op standaard niofs en daarna, toen we van de vijfde versies van Elastic naar de zesde waren gemigreerd, hebben we hybridfs geprobeerd, waar dit probleem zich niet voordeed. Meer over de soorten opslag kun je lezen. .
Probleem vier
Daarna hadden we nog een heel intrigerend probleem dat we recordtijd moesten oplossen. We hebben het 2-3 maanden gevangen omdat het patroon absoluut niet te begrijpen was.
Soms hadden we dat coördinatoren in Full GC terechtkwamen, meestal ergens na de lunch, en zij keerden daar niet meer terug. Tijdens het loggen van GC-vertragingen zag het er zo uit: alles ging goed, goed, goed, en dan opeens — en alles is plotseling slecht.
In het begin dachten we dat we een lastige gebruiker hadden die een verzoek opstartte dat de coördinator uit zijn werkmodus gooide. We hebben heel lang verzoeken gelogd, in een poging te achterhalen wat er aan de hand was.
Uiteindelijk bleek dat op het moment dat een gebruiker een enorm verzoek opstart, en dit terechtkomt bij een specifieke Elasticsearch-coördinator, sommige knooppunten langer antwoordden dan de andere.
En de tijd die de coördinator wacht op antwoorden van alle knooppunten, verzamelt hij de resultaten die al van de knooppunten zijn ontvangen. Voor GC betekent dit dat onze gebruikspatronen van de heap zeer snel veranderen. En de GC die we gebruikten, kon deze taak niet aan.
De enige fix die we vonden om het gedrag van de cluster in zo'n situatie te veranderen, was migratie naar JDK13 en het gebruik van de Shenandoah-garbage collector. Dit loste het probleem op; onze coördinatoren stopten met vallen.
Hiermee eindigden de problemen met Java en begonnen de problemen met de doorvoercapaciteit.
«Berry's» met Elasticsearch: doorvoercapaciteit
Problemen met de doorvoercapaciteit betekenen dat onze cluster stabiel werkt, maar op pieken van het aantal geïndexeerde documenten en tijdens manoeuvres is de prestaties onvoldoende.
Het eerste symptoom dat we tegenkwamen: bij bepaalde «explosies» in de productie, wanneer er een zeer groot aantal logs plotseling wordt gegenereerd, verschijnt de foutmelding es_rejected_execution vaak in Graylog.
Dit gebeurde omdat thread_pool.write.queue op één data-knooppunt, voordat Elasticsearch het verzoek om indexeren kan verwerken en de informatie naar de shard op schijf kan schrijven, standaard slechts 200 verzoeken kan cachen. En in wordt er erg weinig over deze parameter gezegd. Alleen het maximale aantal threads en de standaardgrootte worden vermeld.
Natuurlijk zijn we deze waarde gaan aanpassen en ontdekten we het volgende: specifiek in onze setup kan tot 300 verzoeken behoorlijk goed worden gecached, maar een hogere waarde leidt ertoe dat we weer in Full GC terechtkomen.
Bovendien, omdat dit batches van berichten zijn die binnen één aanvraag aankomen, moest Graylog ook zo worden aangepast dat het niet vaak en in kleine batches schrijft, maar in grote batches of eens in de 3 seconden, als de batch nog niet volledig is. In dat geval wordt de informatie die we in Elasticsearch schrijven niet binnen twee seconden beschikbaar, maar binnen vijf (wat ons prima uitkomt), maar het aantal retries dat nodig is om een grote batch informatie door te geven, vermindert.
Dit is vooral belangrijk op momenten dat er iets ergens is uitgevallen en dit dat heftig meldt, om te voorkomen dat Elastic volledig wordt volgespetterd en dat we na enige tijd niet-werkende Graylog-nodes hebben vanwege volgelopen buffers.
Bovendien, wanneer deze explosies op productie plaatsvonden, ontvingen we klachten van programmeurs en testers: op het moment dat ze deze logs echt nodig hadden, werden ze heel langzaam weergegeven.
We zijn gaan onderzoeken. Aan de ene kant was het duidelijk dat zoekopdrachten en indexeerverzoeken in wezen op dezelfde fysieke machines werden verwerkt, en dat er onvermijdelijk enkele vertragingen zouden zijn.
Maar dit kon gedeeltelijk worden omzeild doordat in de zesde versie van Elasticsearch een algoritme is geïntroduceerd dat het mogelijk maakt om verzoeken te verdelen over relevante data-nodes, niet willekeurig via round-robin (de container die de indexing verzorgt en de primary shard houdt, kan erg druk zijn, waardoor snel antwoorden niet mogelijk is), maar om dit verzoek te richten op een minder belaste container met een replica-shard, die veel sneller kan antwoorden. Met andere woorden, we kwamen tot use_adaptive_replica_selection: true.
Het leesbeeld begint er als volgt uit te zien:
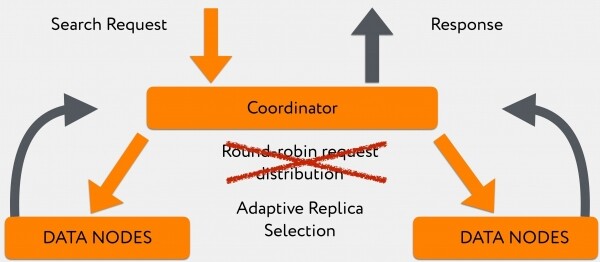
De overstap naar dit algoritme heeft de querytijd aanzienlijk verbeterd op momenten dat er een grote stroom van logs naar schrijfactie was.
Ten slotte was het belangrijkste probleem het soepel afschakelen van het datacenter.
Wat we van de cluster immediate na het verlies van verbinding met één datacenter wilden:
- Als de huidige master in het uitgevallen datacenter zit, zal deze opnieuw worden gekozen en als rol naar een andere node in een ander datacenter verhuizen.
- De master zal snel alle onbereikbare nodes uit het cluster verwijderen.
- Op basis van wat overblijft, zal hij begrijpen: in het verloren datacenter hadden we bepaalde primary shards, hij zal snel de complementaire replica shards in de overgebleven datacenters promoten, en we zullen doorgaan met het indexeren van gegevens.
- Als gevolg hiervan zal de bandbreedte van het cluster voor schrijven en lezen geleidelijk afnemen, maar in het algemeen zal alles werken, zij het langzaam, maar stabiel.
Blijkbaar wilden we iets als dit:
En kregen we het volgende:
Hoe is dit gebeurd?
Op het moment van de ineenstorting van het datacenter was onze bottleneck de master.
Waarom?
Het probleem is dat de master een TaskBatcher heeft, die verantwoordelijk is voor het verspreiden van bepaalde taken en evenementen in het cluster. Elke uitval van een node, elke promotie van een shard van replica naar primary, elke taak voor het creëren van een shard ergens - dit alles komt eerst binnen bij de TaskBatcher, waar het sequentially en in één thread wordt verwerkt.
Op het moment van de uitval van één datacenter dacht elke data-node in de overgebleven datacenters dat het zijn plicht was om de master te informeren: "we hebben bepaalde shards en data-nodes verloren."
Tegelijkertijd stuurden de overgebleven data-nodes al deze informatie naar de huidige master en probeerden te wachten op bevestiging dat hij deze had ontvangen. Dit wachtten ze niet af, omdat de master de taken sneller ontving dan hij kon reageren. Nodes herhaalde de verzoeken na een time-out, terwijl de master op dat moment zelfs niet meer probeerde te reageren, maar volledig was opgegaan in de taak om de verzoeken op prioriteit te sorteren.
In extreme gevallen spammden de data-nodes de master zodanig dat hij in full GC ging. Daarna verhuisde de rol van master naar een volgende node, met hetzelfde resultaat, en uiteindelijk viel het cluster volledig uiteen.
We hebben metingen verricht, en tot versie 6.4.0, waar dit is opgelost, was het voldoende om slechts 10 data-nodes tegelijk uit de 360 uit te schakelen om het cluster volledig neer te halen.
Het leek ongeveer zo:
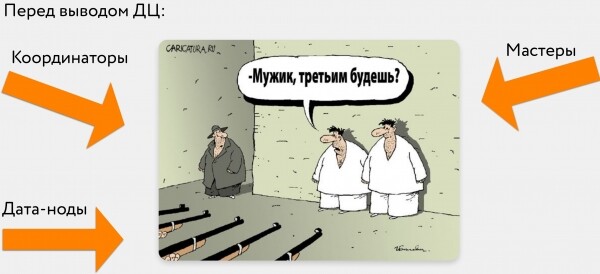
Na versie 6.4.0, waarin deze vervelende bug werd verholpen, stopten de data-nodes met het doden van de master. Maar hij werd er niet 'slimmer' van. Namelijk: wanneer we 2, 3 of 10 (elke hoeveelheid anders dan één) data-nodes uitschakelen, ontvangt de master een eerste bericht dat zegt dat node A is uitgevallen en probeert hij dit verslag te doen aan node B, node C, node D.
En op dit moment kan dit alleen worden aangepakt door een time-out in te stellen voor pogingen om iemand iets te vertellen, gelijk aan ongeveer 20-30 seconden, en zo de snelheid van het datacenter uit het cluster te beheren.
In principe valt dit binnen de eisen die aanvankelijk aan het eindproduct binnen het project werden gesteld, maar vanuit het oogpunt van 'schone wetenschap' is dit een bug. Deze is trouwens succesvol opgelost door de ontwikkelaars in versie 7.2.
Wanneer een bepaalde datanode eruit viel, bleek het belangrijker om informatie over haar uitval te verspreiden dan om de hele cluster te vertellen dat bepaalde primary-shards daarop zaten (om de replica-shard in een ander datacenter naar primary te promoten, zodat daarop informatie geschreven kon worden).
Daarom worden de uitgevallen datanodes, zodra alles 'tot rust is gekomen', niet onmiddellijk gemarkeerd als stale. We moeten dus wachten tot alle pings naar de uitgevallen datanodes zijn getime-out en pas daarna begint onze cluster te vertellen dat daar en daar de opname van informatie moet worden voortgezet. Meer gedetailleerde informatie hierover kan hier worden gelezen. .
Uiteindelijk kost de operatie van het eruit halen van een datacenter ons vandaag ongeveer 5 minuten tijdens de piekuren. Voor zo'n grote en logge machine is dit een behoorlijk goed resultaat.
Uiteindelijk zijn we tot de volgende oplossing gekomen:
- We hebben 360 datanodes met schijven van 700 gigabyte.
- 60 coördinatoren voor het routeren van verkeer tussen deze datanodes.
- 40 masters, die we als een soort erfgoed uit de versies voor 6.4.0 hebben behouden - om de uitval van het datacenter te overleven, waren we moreel bereid om enkele machines te verliezen, zodat we zelfs bij het slechtste scenario zeker een quorum van masters zouden hebben.
- Elke poging tot het combineren van rollen op één container stuitte op het feit dat vroeg of laat de node onder de belasting bezweek.
- In de hele cluster wordt een heap.size van 31 gigabyte gebruikt: alle pogingen om de grootte te verkleinen leidden ertoe dat bij zware zoekopdrachten met een leading wildcard bepaalde nodes werden gedood of de circuit breaker in Elasticsearch zelf werd geactiveerd.
- Bovendien probeerden we voor het waarborgen van de zoekprestaties het aantal objecten in de cluster zo laag mogelijk te houden, zodat we zo min mogelijk evenementen in het meest kritieke punt, dat we in de master kregen, moesten verwerken.
Tot slot over monitoring
Om ervoor te zorgen dat alles werkt zoals bedoeld, monitoren we het volgende:
- Elke datacenter node geeft aan ons cloud aan dat hij bestaat, en dat daar bepaalde shards op liggen. Wanneer we ergens iets uitschakelen, rapporteert het cluster na 2-3 seconden dat we in datacenter A node 2, 3 en 4 hebben uitgeschakeld - dit betekent dat we in andere datacenters absoluut die nodes niet kunnen uitschakelen waar nog shards in enkele exemplaren op staan.
- Gezien het gedrag van de master, letten we heel nauwlettend op het aantal pending-taken. Want zelfs één vastgelopen taak kan, als die niet tijdig uitloopt, theoretisch in een noodsituatie de reden zijn dat we bijvoorbeeld de promotie van de replica-shard naar primary niet kunnen uitvoeren, wat de indexering zou verstoren.
- Daarnaast kijken we heel zorgvuldig naar de vertragingen van de garbage collector, omdat we daar al grote problemen mee hebben gehad tijdens de optimalisatie.
- Rejects per thread, om van tevoren te begrijpen waar de bottleneck zich bevindt.
- En de standaard metrics zoals heap, RAM en I/O.
Bij het opzetten van monitoring moet absoluut rekening worden gehouden met de kenmerken van de Thread Pool in Elasticsearch. beschrijft de mogelijkheden voor configuratie en de standaardwaarden voor zoeken en indexeren, maar zwijgt volledig over thread_pool.management. Deze threads verwerken onder andere verzoeken van het type _cat/shards en andere vergelijkbare verzoeken die handig zijn bij het schrijven van monitoring. Hoe groter het cluster, hoe meer van dergelijke verzoeken er tegelijkertijd worden uitgevoerd, en de eerder genoemde thread_pool.management is niet alleen niet opgenomen in de officiële documentatie, maar is bovendien standaard beperkt tot 5 threads, wat heel snel wordt gebruikt, waarna de monitoring niet meer correct werkt.
Wat ik tot slot wil zeggen: we hebben het voor elkaar gekregen! We hebben onze programmeurs en ontwikkelaars een tool gegeven die in bijna elke situatie snel en betrouwbaar informatie kan geven over wat er gebeurt in de productie.
Ja, het was best ingewikkeld, maar desondanks is het ons gelukt om onze wensen onder te brengen in bestaande producten, die we niet hoefden te patchen of herschrijven voor onze behoeften.
Bron: habr.com
