

Waar we over zullen vertellen:
Hoe je snel een gedeelde opslag voor twee servers op basis van drbd+ocfs2-oplossingen kunt implementeren.
Voor wie dit nuttig zal zijn:
Deze tutorial is nuttig voor systeembeheerders en iedereen die een manier zoekt om opslag te implementeren of het systeem wil uitproberen.
Van welke oplossingen we hebben afgezien en waarom
Vaak komen we in de situatie dat we op een klein webcluster een gedeelde opslag met goede lees- en schrijfsnelheid moeten realiseren. We hebben verschillende varianten van gedeelde opslag voor onze projecten geprobeerd, maar weinig kon ons meteen aan meerdere eisen voldoen. We vertellen nu waarom.
- Glusterfs voldeed niet aan onze eisen voor lees- en schrijfsnelheid; er waren problemen met het gelijktijdig lezen van een groot aantal bestanden en hoge CPU-belasting. Het probleem met het lezen van bestanden kon worden opgelost door direct naar de bricks te verwijzen, maar dat is niet altijd toepasbaar en in het algemeen verkeerd.
- Ceph beviel ons niet vanwege de overmatige complexiteit, die schadelijk kan zijn voor projecten met 2-4 servers, vooral als het project later door anderen wordt beheerd. Ook hier zijn er ernstige prestatiebeperkingen, waardoor het nodig is aparte storage-clusters te bouwen, net als bij glusterfs.
- Het gebruik van één nfs-server voor gedeelde opslag roept vragen op met betrekking tot fouttolerantie.
- s3 is een uitstekende populaire oplossing voor bepaalde taken, maar het is geen besturingssysteem, wat de toepassingsmogelijkheden beperkt.
- lsyncd. Als we het al hebben over 'geen-besturingssystemen', dan moeten we ook deze populaire oplossing bespreken. Behalve dat het niet geschikt is voor bidirectionele communicatie (maar als je het echt wilt, is het mogelijk), werkt het ook niet stabiel met een groot aantal bestanden. Een aangename aanvulling op dit alles is dat het enkelvoudig is. De reden hiervoor ligt in de architectuur van het programma: het gebruikt inotify om de werkobjecten te monitoren die bij het starten en opnieuw scannen worden ingesteld. Voor verzending wordt rsync gebruikt.
Tutorial: hoe je een gedeelde opslag op basis van drbd+ocfs2 kunt implementeren
Een van de handigste oplossingen voor ons was de combinatie ocfs2+drbd. Nu zullen we uitleggen hoe je snel een gedeelde opslag kunt opzetten voor twee servers op basis van oplossingsgegevens. Maar eerst iets over de componenten:
DRBD — een opslag systeem dat standaard wordt geleverd met Linux, waarmee gegevens blokgewijs tussen servers kunnen worden gerepliceerd. Het belangrijkste gebruik is het opbouwen van storingsbestendige opslag.
OCFS2 — een bestandssysteem dat het delen van dezelfde opslag door meerdere systemen mogelijk maakt. Het is inbegrepen in de Linux-distributie en bestaat uit een kernelmodule en tools voor gebruikersruimte om met het bestandssysteem te werken. OCFS2 kan niet alleen bovenop DRBD worden gebruikt, maar ook bovenop iSCSI met meerdere verbindingen. In ons voorbeeld gebruiken we DRBD.
Alle acties worden uitgevoerd op ubuntu server 18.04 in een minimale configuratie.
Stap 1. Configureer DRBD:
In het bestand /etc/drbd.d/drbd0.res beschrijven we onze virtuele blokapparaat /dev/drbd0:
resource drbd0 {
    syncer { rate 1000M; }
    net {
        allow-two-primaries;
        after-sb-0pri discard-zero-changes;
        after-sb-1pri discard-secondary;
        after-sb-2pri disconnect;
    }
    startup { become-primary-on both; }
    on drbd1 {
        meta-disk internal;
        device /dev/drbd0;
        disk /dev/vdb1;
        address 10.10.10.192:7789;
}
    on drbd2 {
        meta-disk internal;
        device /dev/drbd0;
        disk /dev/vdb1;
        address 10.10.10.193:7789;
}
}
meta-disk internal — gebruik dezelfde blokapparaten voor het opslaan van metadata
device /dev/drbd0 — gebruik /dev/drbd0 als het pad naar drbd.
disk /dev/vdb1 — gebruik /dev/vdb1
syncer { rate 1000M; } — gebruik een gigabit bandbreedte
allow-two-primaries — een belangrijke optie die wijzigingen op twee primaire servers toestaat
after-sb-0pri, after-sb-1pri, after-sb-2pri — opties die verantwoordelijk zijn voor de acties van de knoop bij het ontdekken van splitbrain. Meer informatie is te vinden in de documentatie.
become-primary-on both — stelt beide knooppunten in op primary.
In ons geval hebben we twee absoluut identieke VM's, met een toegewezen virtueel netwerk met een bandbreedte van 10 gigabit.
In ons voorbeeld zijn de netwerk namen van de twee cluster knooppunten — drbd1 en drbd2. Voor een goede werking moet je in /etc/hosts de namen en ip-adressen van de knooppunten toewijzen.
10.10.10.192 drbd1
10.10.10.193 drbd2
Stap 2. Configureer de knooppunten:
Voer het volgende uit op beide servers:
drbdadm create-md drbd0 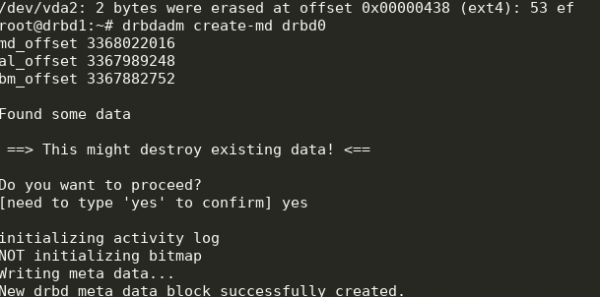
modprobe drbd
drbdadm up drbd0
cat /proc/drbd
We krijgen het volgende:
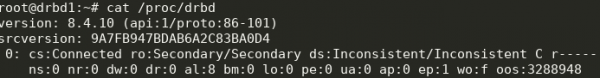
Synchronisatie kan worden gestart. Op de eerste knoop moet je het volgende uitvoeren:
drbdadm primary --force drbd0Bekijk de status:
cat /proc/drbd 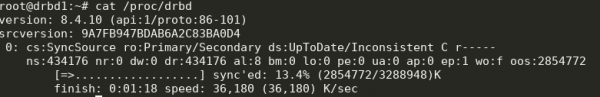
Geweldig, de synchronisatie is begonnen. Laten we wachten tot het is voltooid en zien wat er gebeurt:
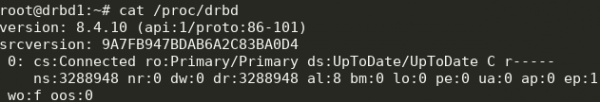
Stap 3. Start de synchronisatie op de tweede node:
drbdadm primary --force drbd0
We krijgen het volgende:
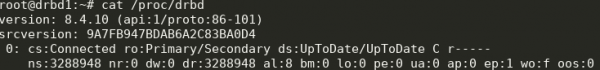
Nu kunnen we schrijven naar drbd vanaf twee servers.
Stap 4. Installatie en configuratie van ocfs2.
We zullen een vrij triviale configuratie gebruiken:
cluster:
     node_count = 2
     name = ocfs2cluster

node:
     number = 1
     cluster = ocfs2cluster
     ip_port = 7777
     ip_address = 10.10.10.192
     name = drbd1

node:
     number = 2
     cluster = ocfs2cluster
     ip_port = 7777
     ip_address = 10.10.10.193
     name = drbd2
Dit moet worden vastgelegd in /etc/ocfs2/cluster.conf op beide nodes.
Laten we een FS maken op drbd0 op een willekeurige node:
mkfs.ocfs2 -L "testVol" /dev/drbd0
Hier hebben we een FS met het label testVol op drbd0 gemaakt, met de standaardinstellingen.
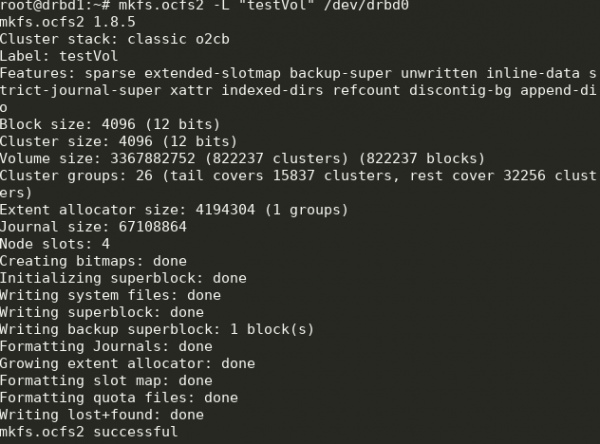
In /etc/default/o2cb moet worden ingesteld (zoals in ons configuratiebestand)
O2CB_ENABLED=true
O2CB_BOOTCLUSTER=ocfs2cluster
en voer op elke node uit:
o2cb register-cluster ocfs2clusterDaarna schakelen we alle benodigde eenheden in en voegen we deze toe aan de opstart:
systemctl enable drbd o2cb ocfs2
systemctl start drbd o2cb ocfs2
Een deel hiervan zal al worden uitgevoerd tijdens de configuratie.
Stap 5. Voeg de mountpunten toe aan fstab op beide nodes:
/dev/drbd0 /media/shared ocfs2 defaults,noauto,heartbeat=local 0 0De directory /media/shared moet van tevoren zijn aangemaakt.
Hier gebruiken we de opties noauto, wat betekent dat de FS niet wordt gemonteerd bij de opstart (ik geef er de voorkeur aan om netwerk-FS via systemd te monteren) en heartbeat=local, wat betekent dat de heartbeat-service op elke node wordt gebruikt. Er is ook een globale heartbeat, die meer geschikt is voor grote clusters.
Vervolgens kan worden gemonteerd /media/shared en de inhoud van de synchronisatie kan worden gecontroleerd.
Klaar! Het resultaat is een min of meer fouttolerante opslag met schaalbaarheid en behoorlijke prestaties.
Bron: habr.com
