

Hallo, Habr-Bewoners! Dit boek is geschikt voor elke ontwikkelaar die de kneepjes van streamingverwerking wil begrijpen. Begrip van gedistribueerd programmeren helpt je om Kafka en Kafka Streams beter te leren kennen. Het is niet nodig om het Kafka-framework zelf te kennen, maar het zou mooi zijn: ik zal je alles vertellen wat je moet weten. Zowel ervaren Kafka-ontwikkelaars als beginners zullen dankzij dit boek in staat zijn om interessante toepassingen voor streamingverwerking te ontwikkelen met de Kafka Streams-bibliotheek. Java-ontwikkelaars van gemiddeld en hoog niveau, die al vertrouwd zijn met concepten zoals serialisatie, zullen leren hun vaardigheden toe te passen voor het creëren van Kafka Streams-toepassingen. De broncode van het boek is geschreven in Java 8 en maakt wezenlijk gebruik van de syntax van lambda-expressies in Java 8, dus de vaardigheid om met lambda-functies te werken (zelfs in een andere programmeertaal) zal je van pas komen.
Fragment. 5.3. Aggregeren en vensteroperaties
In dit gedeelte gaan we de meest veelbelovende onderdelen van Kafka Streams bestuderen. Tot nu toe hebben we de volgende aspecten van Kafka Streams behandeld:
- het creëren van een verwerkingsarchitectuur;
- het gebruik van status in streamingtoepassingen;
- het uitvoeren van data stream-verbindingen;
- de verschillen tussen evenementgestreamde gegevens (KStream) en bijgewerkte gegevens (KTable).
In de volgende voorbeelden zullen we al deze elementen samenbrengen. Bovendien zul je kennismaken met vensteroperaties — weer een geweldige mogelijkheid voor streamingtoepassingen. Ons eerste voorbeeld zal een eenvoudige aggregatie zijn.
5.3.1. Aggregatie van aandelenverkoopvolumes per industrie
Aggregatie en groepering zijn essentiële tools bij het werken met streamingdata. Het onderzoeken van afzonderlijke records naarmate ze binnenkomen is vaak niet genoeg. Om extra informatie uit de gegevens te halen, zijn groepering en combinatie noodzakelijk.
In dit voorbeeld zul je de rol van een intraday trader op je nemen, die de verkoopvolumes van aandelen van bedrijven in verschillende industrieën moet bijhouden. In het bijzonder ben je geïnteresseerd in vijf bedrijven met de hoogste verkoopvolumes van aandelen in elke sector.
Voor deze aggregatie zijn enkele stappen nodig om de gegevens in de juiste vorm te krijgen (in algemene termen).
- Een bron maken op basis van een onderwerp dat ruwe informatie over aandelenhandel publiceert. We moeten een object van het type StockTransaction naar een object van het type ShareVolume converteren. Het punt is dat het object StockTransaction metadata over verkopen bevat, terwijl we alleen gegevens over het aantal verkochte aandelen nodig hebben.
- De ShareVolume-gegevens groeperen op aandelenymbolen. Na het groeperen op de symbolen kunnen we deze gegevens samenvoegen tot tussentijdse totalen van de verkochte aandelenvolumes. Het is vermeldenswaard dat de methode KStream.groupBy een instantie van het type KGroupedStream retourneert. Een instantie van KTable kan worden verkregen door de KGroupedStream.reduce-methode aan te roepen.
Wat is de KGroupedStream-interface?
De methoden KStream.groupBy en KStream.groupByKey retourneren een instantie van KGroupedStream. KGroupedStream is een tussenweergave van de stroom van gebeurtenissen na groepering op sleutels. Het is absoluut niet bedoeld om er direct mee te werken. In plaats daarvan wordt KGroupedStream gebruikt voor aggregerende bewerkingen, waarvan het resultaat altijd een KTable is. En omdat de resultaten van aggregerende bewerkingen een KTable zijn en deze gebruik maken van een statusopslag, worden mogelijk niet alle updates als resultaat verder door de pijplijn gestuurd.
De methode KTable.groupBy retourneert een vergelijkbare KGroupedTable - een tussenweergave van de stroom van updates, opnieuw gegroepeerd op sleutel.
Laten we even pauzeren en kijken naar fig. 5.9, waarin te zien is wat we hebben bereikt. Deze topologie zal je al bekend zijn.
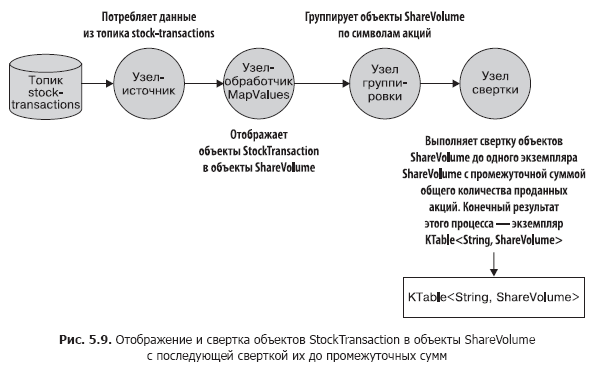
Laten we nu naar de code voor deze topologie kijken (te vinden in het bestand src/main/java/bbejeck/chapter_5/AggregationsAndReducingExample.java) (lijst 5.2).
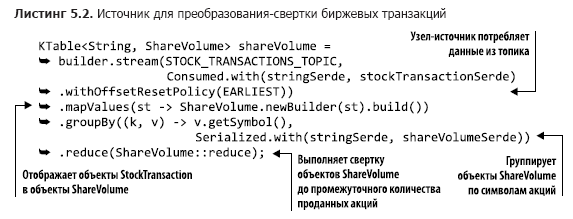
De gegeven code is beknopt en bevat een groot aantal acties die in enkele regels worden uitgevoerd. In de eerste parameter van de methode builder.stream zie je iets nieuws: de waarde van het enumeratietype AutoOffsetReset.EARLIEST (ook LATEST beschikbaar), ingesteld met de methode Consumed.withOffsetResetPolicy. Met dit enumeratietype kan je een strategie voor het resetten van offset bepalen voor elke KStream of KTable, die prioriteit heeft boven de resetparameter uit de configuratie.
GroupByKey en GroupBy
In de KStream-interface zijn er twee methoden voor het groeperen van records: GroupByKey en GroupBy. Beide retourneren een KGroupedTable, dus je zou je kunnen afvragen: wat is het verschil tussen hen en wanneer moet je welke gebruiken?
De GroupByKey-methode wordt toegepast wanneer de sleutels in KStream al niet leeg zijn. En belangrijker nog, de vlag 'vereist herpartitionering' is nooit ingesteld.
De GroupBy-methode gaat ervan uit dat je de sleutels voor groepering hebt gewijzigd, zodat de herpartitioneringsvlag op true is ingesteld. Het uitvoeren van aansluitingen, aggregaties, enzovoort na de GroupBy-methode zal automatisch leiden tot herpartitionering.
Samenvatting: probeer waar mogelijk GroupByKey te gebruiken in plaats van GroupBy.
Wat de methoden mapValues en groupBy doen is duidelijk, dus laten we eens kijken naar de sum() methode (je kunt het vinden in het bestand src/main/java/bbejeck/model/ShareVolume.java) (listing 5.3).
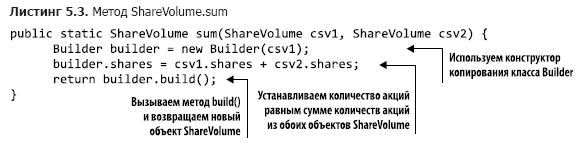
De ShareVolume.sum methode retourneert de tussenliggende som van het aandeel verkoopvolume, terwijl het resultaat van de gehele rekenketen een KTable<String, ShareVolume> object is. Nu begrijp je welke rol KTable speelt. Wanneer ShareVolume-objecten binnenkomen, wordt de laatste actuele update in het overeenkomstige KTable-object opgeslagen. Het is belangrijk om niet te vergeten dat alle updates worden weergegeven in de voorgaande shareVolumeKTable, maar niet alles wordt verder verzonden.
Vervolgens voeren we met dit KTable aggregatie uit (op basis van het aantal verkochte aandelen) om de vijf bedrijven met de hoogste aandelenverkoop in elke industrie te krijgen. Onze acties zullen hierbij vergelijkbaar zijn met die bij de eerste aggregatie.
- Voer nog een groupBy-operatie uit om afzonderlijke ShareVolume-objecten te groeperen op basis van industrie.
- Begin met het samenvatten van ShareVolume-objecten. Dit keer is het aggregatie-object een prioriteitsqueue van vaste grootte. In zo'n prioriteitsqueue van vaste grootte worden alleen de vijf bedrijven met de meeste verkochte aandelen bewaard.
- Weergeef de queues uit de vorige stap als een stringwaarde en retourneer de vijf meest verkochte aandelen per industrie.
- Schrijf de resultaten als een string in het topic.
Figuur 5.10 toont de grafiek van de gegevensbewegingstopologie. Zoals je kunt zien, is de tweede kring van verwerking vrij eenvoudig.
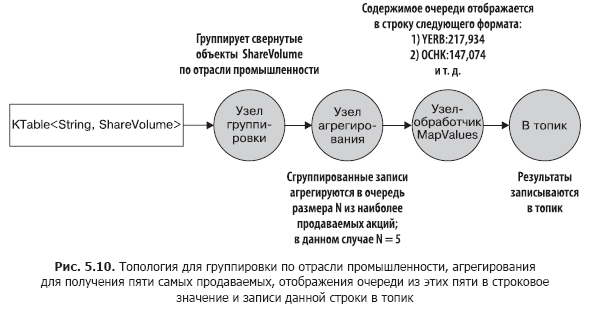
Nu we de structuur van deze tweede verwerkingsronde duidelijk hebben, kunnen we de broncode ervan bekijken (je vindt het in het bestand src/main/java/bbejeck/chapter_5/AggregationsAndReducingExample.java) (listing 5.4).
In deze initializer is er een variabele fixedQueue. Dit is een gebruikersobject — een adapter voor java.util.TreeSet, dat wordt gebruikt om de N grootste resultaten in aflopende volgorde van verkoop van aandelen bij te houden.
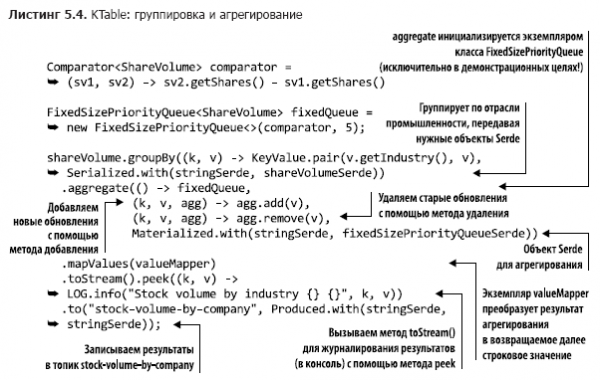
Je bent al bekend met de aanroepen groupBy en mapValues, dus laten we daar niet bij stilstaan (we roepen de methode KTable.toStream aan, omdat de methode KTable.print als verouderd wordt beschouwd). Maar je hebt de KTable-versie van de methode aggregate() nog niet gezien, dus we nemen even de tijd om dat te bespreken.
Zoals je je herinnert, onderscheidt KTable zich doordat records met dezelfde sleutels als updates worden beschouwd. KTable vervangt het oude record door een nieuw record. Aggregatie gebeurt op een vergelijkbare manier: de laatste records met dezelfde sleutel worden geaggregeerd. Wanneer een record binnenkomt, wordt deze toegevoegd aan een instantie van de klasse FixedSizePriorityQueue met behulp van de summator (de tweede parameter in de aanroep van de methode aggregate), maar als er al een ander record met dezelfde sleutel bestaat, wordt het oude record verwijderd met behulp van de afnemer (de derde parameter in de aanroep van de methode aggregate).
Dit betekent dat onze aggregator, FixedSizePriorityQueue, niet alle waarden met dezelfde sleutel aggregeert, maar een glijdende som bijhoudt van de N meest verkochte soorten aandelen. In elk binnenkomend record zit het totale aantal tot nu toe verkochte aandelen. KTable geeft je informatie over welke bedrijven momenteel de meeste aandelen verkopen, een glijdende aggregatie van elke update is niet vereist.
We hebben geleerd om twee belangrijke dingen te doen:
- waarden in KTable te groeperen op een gemeenschappelijke sleutel;
- handelingen uit te voeren op deze gegroepeerde waarden, zoals samenvatten en aggregeren.
Het vermogen om deze handelingen uit te voeren is belangrijk om de betekenis van de gegevens die door de Kafka Streams-applicatie gaan te begrijpen en te achterhalen welke informatie ze bevatten.
We have also brought together some of the key concepts discussed earlier in this book. In chapter 4, we explained how important fault tolerance and local state are for a streaming application. The first example in this chapter demonstrated why local state is so crucial — it allows you to track what information you have already seen. Local access helps avoid network delays, making the application more efficient and resilient to errors.
When performing any aggregation or folding operation, you must specify the state store name. Aggregation and folding operations return an instance of KTable, and KTable uses the state store to replace old results with new ones. As you have seen, not all updates are sent further along the pipeline, which is significant because aggregation operations are meant to provide final information. Without local state, KTable will send all aggregation and folding results further along.
Next, we will look at executing operations such as aggregation within specific time intervals — the so-called window operations.
5.3.2. Window Operations
In the previous section, we were introduced to ‘sliding’ aggregation and folding. The application performed continuous folding of sales volumes followed by the aggregation of the five best-selling stocks on the exchange.
Sometimes such continuous aggregation and folding of results is necessary. At other times, operations need to be performed only over a specified time interval. For example, calculating how many stock trades occurred for a specific company in the last 10 minutes. Or how many users clicked on a new advertisement banner in the last 15 minutes. The application can perform such operations repeatedly, but with results relevant only to the specified time intervals (time windows).
Counting stock transactions by buyer
In the next example, we will focus on tracking stock transactions for several traders — either large organizations or savvy solo financiers.
Er zijn twee mogelijke redenen voor dergelijk toezicht. De eerste is de noodzaak om te weten wat de marktleiders kopen/verkopen. Als deze grote spelers en ervaren investeerders kansen zien, is het de moeite waard om hun strategie te volgen. De tweede reden is de wens om mogelijke tekenen van illegale transacties te ontdekken met behulp van interne informatie. Hiervoor moet je de correlatie van grote pieken in verkopen met belangrijke persberichten analyseren.
Dit toezicht bestaat uit stappen zoals:
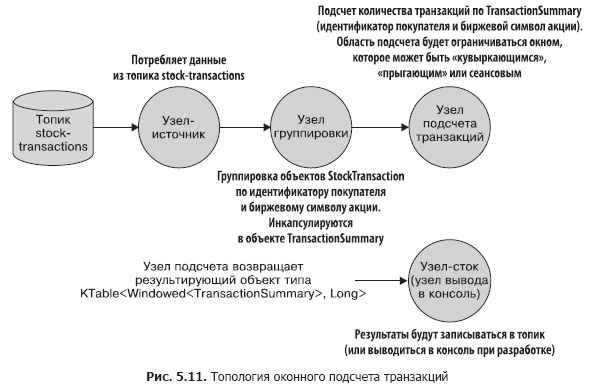
- het creëren van een leesstroom vanuit het topic stock-transactions;
- het groeperen van binnenkomende recorden op basis van de identificatie van de koper en de beurscode van het aandeel. De aanroep van de method groupBy retourneert een instantie van de klasse KGroupedStream;
- het retourneren van een gegevensstroom met de methode KGroupedStream.windowedBy, die is beperkt tot een tijdsraam, wat vensteraggregatie mogelijk maakt. Afhankelijk van het type venster wordt ofwel TimeWindowedKStream of SessionWindowedKStream geretourneerd;
- het tellen van transacties voor de aggregatieoperatie. De venstergegevensstroom bepaalt of een specifiek record in deze telling wordt meegenomen;
- het opslaan van de resultaten in een topic of het weergeven ervan in de console tijdens de ontwikkeling.
De topologie van deze applicatie is eenvoudig, maar een visuele afbeelding ervan zal nuttig zijn. Laten we eens kijken naar afbeelding 5.11.
Vervolgens bekijken we de functionaliteit van vensteroperaties en de bijbehorende code.
Soorten vensters
In Kafka Streams zijn er drie soorten vensters:
- sessie-vensters;
- ‘tumbling’ vensters;
- sliding/‘hopping’ vensters.
Welke te kiezen hangt af van de zakelijke vereisten. ‘Tumbling’ en ‘hopping’ vensters zijn tijdgebonden, terwijl sessiebeperkingen afhankelijk zijn van het gedrag van de gebruikers — de duur van de sessie(s) wordt uitsluitend bepaald door hoe actief de gebruiker zich gedraagt. Vergeet niet dat alle venstertypen gebaseerd zijn op datums/tijdstempels van de records en niet op systeemtijd.
Vervolgens implementeren we onze topologie met elk van de venstertypes. De volledige code wordt alleen in het eerste voorbeeld gegeven; voor de andere venstertypes verandert er niets, behalve het type vensteroperatie.
Sessie-vensters
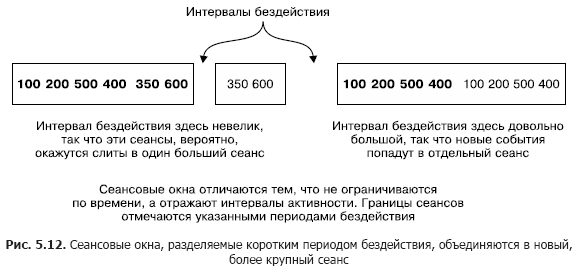
Sessiewindows verschillen sterk van alle andere soorten vensters. Ze zijn niet zozeer tijdgebonden, maar afhankelijk van de activiteit van de gebruiker (of de activiteit van de entiteit die u wilt volgen). Sessiewindows worden afgebakend door periodes van inactiviteit.
Figuur 5.12 illustreert het concept van sessiewindows. Een kleinere sessie zal samensmelten met de sessie links van hem. En de sessie rechts zal apart zijn, omdat deze volgt na een lange periode van inactiviteit. Sessiewindows zijn gebaseerd op gebruikersacties, maar gebruiken tijd-/datumlabels uit de records om te bepalen tot welke sessie een record behoort.
Het gebruik van sessiewindows voor het volgen van beurs-transacties
Laten we sessiewindows gebruiken om informatie over beurs-transacties te verzamelen. De implementatie van sessiewindows is te zien in listing 5.5 (die te vinden is in het bestand src/main/java/bbejeck/chapter_5/CountingWindowingAndKTableJoinExample.java).
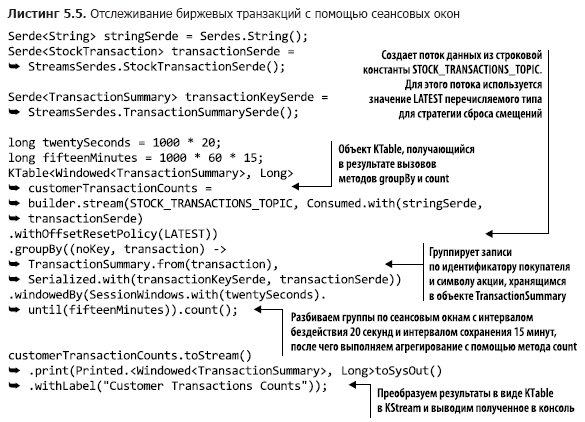
De meeste operaties in deze topologie heeft u al eerder gezien, dus het is niet nodig om ze hier opnieuw te bespreken. Maar er zijn hier ook een aantal nieuwe elementen die we nu zullen bespreken.
Bij elke groupBy-operatie wordt meestal een bepaalde aggregatie uitgevoerd (aggregatie, samenvatting of telling). U kunt ofwel cumulatieve aggregatie met een lopend totaal uitvoeren, of venster-aggregatie, waarbij records binnen een bepaald tijdsvenster worden bekeken.
De code uit listing 5.5 telt het aantal transacties binnen sessiewindows. In fig. 5.13 worden deze acties stap voor stap geanalyseerd.
Met de aanroep windowedBy(SessionWindows.with(twentySeconds).until(fifteenMinutes)) creëren we een sessiewindow met een inactiviteitsinterval van 20 seconden en een bewaartijd van 15 minuten. Een inactiviteitsinterval van 20 seconden betekent dat de applicatie een record zal opnemen dat binnen 20 seconden na het einde of begin van de huidige sessie binnenkomt in de huidige (actieve) sessie.
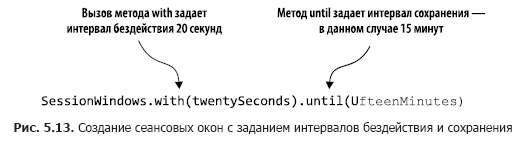
Vervolgens geven we aan welke aggregatieoperatie moet worden uitgevoerd in het sessievenster — in dit geval count. Als de binnenkomende opname buiten de inactiviteitsperiode valt (van beide kanten van de tijdstempel), wordt er een nieuwe sessie aangemaakt. De bewaartermijn betekent dat de sessie gedurende een bepaalde tijd actief blijft en laat vertraagde gegevens toe, die buiten de inactiviteitsperiode van de sessie vallen, maar nog steeds kunnen worden toegevoegd. Bovendien komen het begin en het einde van de nieuwe sessie, die ontstaat door samenvoegen, overeen met de vroegste en de laatste tijdstempel.
Laten we enkele opnames van de count-methode bekijken om te zien hoe sessies werken (tabel 5.1).
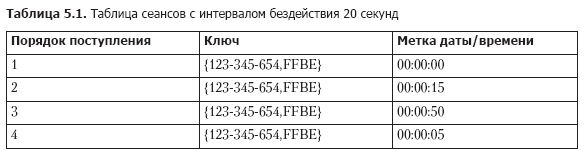
Bij het binnenkomen van opnames zoeken we naar al bestaande sessies met dezelfde sleutel, die eindigen voor de huidige tijdstempel — de inactiviteitsperiode en beginnen na de huidige tijdstempel + de inactiviteitsperiode. Gezien dit worden de vier opnames uit tabel 5.1 samengevoegd in één sessie als volgt.
1. Als eerste komt opname 1 binnen, zodat de starttijd gelijk is aan de eindtijd en deze is 00:00:00.
2. Vervolgens komt opname 2 binnen, en we zoeken naar sessies die eindigen niet eerder dan 23:59:55 en beginnen niet later dan 00:00:35. We vinden opname 1 en voegen de sessies 1 en 2 samen. We nemen de starttijd van sessie 1 (de vroegere) en de eindtijd van sessie 2 (de latere), zodat onze nieuwe sessie begint om 00:00:00 en eindigt om 00:00:15.
3. Opname 3 komt binnen, we zoeken naar sessies tussen 00:00:30 en 00:01:10 en vinden er geen. We voegen een tweede sessie toe voor de sleutel 123-345-654,FFBE, die begint en eindigt om 00:00:50.
4. Opname 4 komt binnen, en we zoeken naar sessies tussen 23:59:45 en 00:00:25. Deze keer worden beide sessies — 1 en 2 — gevonden. Alle drie de sessies worden samengevoegd tot één, met een begintijd van 00:00:00 en een eindtijd van 00:00:15.
Van wat in dit deel is besproken, zijn de volgende belangrijke punten te onthouden:
- sessies zijn geen vensters van vaste grootte. De duur van een sessie wordt bepaald door de activiteit binnen een bepaalde tijdsperiod;
- tijdstempels in de gegevens bepalen of een gebeurtenis binnen een bestaande sessie valt of in een inactiviteitsperiode.
Vervolgens bespreken we de volgende soort vensters — "rollebollen" vensters.
"Rollebollen" vensters
‘Tumbling’ vensters vangen gebeurtenissen die binnen een bepaalde tijdsperiode vallen. Stel je voor dat je alle beurstransacties van een bedrijf elke 20 seconden wilt vastleggen, zodat je alle gebeurtenissen in deze tijdsperiode verzamelt. Aan het einde van het 20-seconde-interval 'tuimelt' het venster en gaat het naar een nieuw 20-seconde-observatie-interval. Figuur 5.14 illustreert deze situatie.
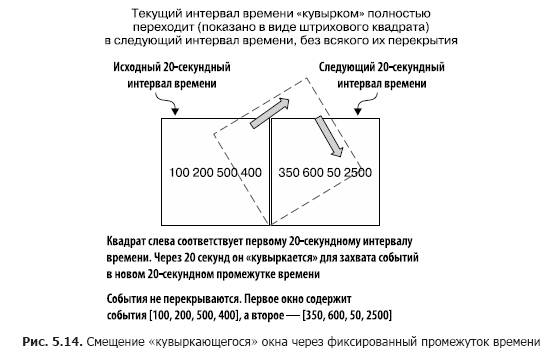
Zoals je kunt zien, zijn alle gebeurtenissen die in de afgelopen 20 seconden zijn binnengekomen, opgenomen in het venster. Aan het einde van deze periode wordt een nieuw venster aangemaakt.
In listing 5.6 staat de code die het gebruik van ‘tumbling’ vensters laat zien voor het vastleggen van beurstransacties elke 20 seconden (je kunt deze vinden in het bestand src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java).
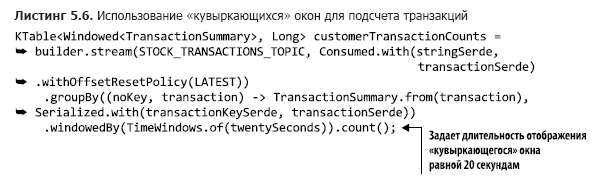
Dankzij deze kleine wijziging in het aanroepen van de TimeWindows.of-methode kan een ‘tumbling’ venster worden gebruikt. In dit voorbeeld is er geen aanroep van de until()-methode, waardoor de standaard bewaartermijn van 24 uur wordt gebruikt.
Ten slotte is het tijd om over te schakelen naar de laatste venstervariant - ‘hopping’ vensters.
Sliding (‘hopping’) vensters
Sliding/‘hopping’ (glijdende/‘hoppende’) vensters zijn vergelijkbaar met ‘tumbling’ vensters, maar met een klein verschil. Glijdende vensters wachten niet tot het einde van de tijdsperiode voordat een nieuw venster voor het verwerken van recente gebeurtenissen wordt aangemaakt. Ze starten nieuwe berekeningen na een wachttijd die korter is dan de duur van het venster.
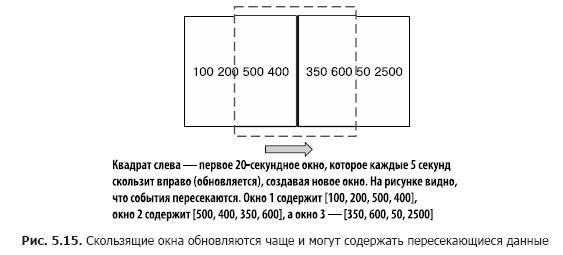
Om de verschillen tussen ‘tumbling’ en ‘hopping’ vensters te illustreren, keren we terug naar het voorbeeld van het tellen van beurstransacties. Ons doel is nog steeds om het aantal transacties te tellen, maar we willen niet wachten tot het volledige tijdsinterval is verstreken voordat we de teller bijwerken. In plaats daarvan zullen we de teller na kortere tijdsintervallen bijwerken. Bijvoorbeeld, we zullen nog steeds om de 20 seconden het aantal transacties tellen, maar de teller elke 5 seconden bijwerken, zoals weergegeven in fig. 5.15. Dit resulteert in drie resultaatvensters met overlappende gegevens.
In listing 5.7 staat de code voor het instellen van glijdende vensters (je kunt deze vinden in het bestand src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java).
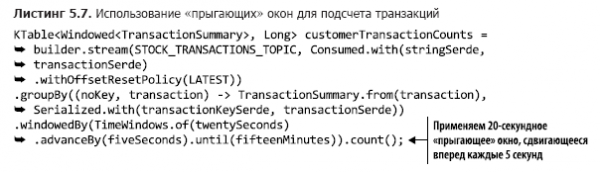
Een "rollend" venster kan worden omgevormd tot een "springend" venster door de methode advanceBy() aan te roepen. In het onderstaande voorbeeld bedraagt het opslaan van de intervaltijd 15 minuten.
In dit gedeelte heeft u gezien hoe u aggregatieresultaten kunt beperken met tijdvensters. In het bijzonder wilt u de volgende drie dingen uit dit gedeelte onthouden:
- de grootte van sessievensters wordt beperkt door de activiteit van gebruikers, niet door de tijdsperiode;
- "rollende" vensters geven inzicht in gebeurtenissen binnen een bepaalde tijdsperiode;
- de duur van "springende" vensters is vast, maar deze worden vaak bijgewerkt en kunnen overlappende records in alle vensters bevatten.
Vervolgens zullen we leren hoe we KTable terug kunnen converteren naar KStream voor een join.
5.3.3. Verbinding van KStream- en KTable-objecten
In hoofdstuk 4 hebben we de verbinding van twee KStream-objecten besproken. Nu moeten we leren hoe we KTable en KStream kunnen verbinden. Dit is nodig om de eenvoudige reden dat KStream een stroom van records is, terwijl KTable een stroom van updates van records is, maar soms is het nodig om extra context aan de stroom van records toe te voegen met behulp van updates uit KTable.
Laten we gegevens over het aantal beurstransacties nemen en deze verbinden met beursnieuws over de bijbehorende industrieën. Dit is wat we moeten doen om dit te bereiken, rekening houdend met de bestaande code.
- Het KTable-object met gegevens over het aantal beurstransacties omzetten naar KStream en daarbij de sleutel vervangen door de sleutel die de relevante industrie voor dat aandelenlabel aangeeft.
- Een KTable-object aanmaken dat gegevens leest uit het topic met beursnieuws. Deze nieuwe KTable zal worden gecategoriseerd op industrie.
- Updates van het nieuws verbinden met informatie over het aantal beurstransacties per industrie.
Laten we nu kijken naar hoe we dit actieplan kunnen implementeren.
KTable omzetten naar KStream
Om KTable naar KStream om te zetten, moet je het volgende doen.
- De methode KTable.toStream() aanroepen.
- Met de aanroep van de methode KStream.map de sleutel vervangen door de naam van de industrie, en vervolgens het TransactionSummary-object uit het Windowed-exemplaar extraheren.
We zullen deze bewerkingen als volgt aan elkaar schakelen (de code is te vinden in het bestand src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java) (listing 5.8).
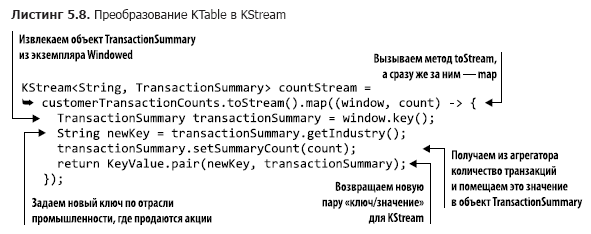
Aangezien we de KStream.map-bewerking uitvoeren, wordt het opnieuw partitioneren voor het geretourneerde KStream-exemplaar automatisch uitgevoerd wanneer het wordt gebruikt in een join.
We hebben het conversieproces voltooid, nu moeten we een KTable-object maken om beursnieuws te lezen.
Een KTable maken voor beursnieuws
Gelukkig is één regel code voldoende om een KTable-object te creëren (deze code is te vinden in het bestand src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java) (listing 5.9).
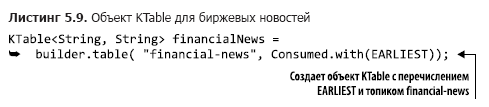
Het is belangrijk op te merken dat er geen Serde-objecten hoeven te worden opgegeven, aangezien er string Serde's in de instellingen worden gebruikt. Ook wordt door het gebruik van de enumeratie EARLIEST de tabel vanaf het begin gevuld met records.
Nu kunnen we naar de laatste stap gaan — de join.
Het verbinden van nieuwsupdates met transactiegegevens
Het aanmaken van een join is niet moeilijk. We zullen een left join gebruiken voor het geval er geen beursnieuws voor de betreffende industrie is (de benodigde code is te vinden in het bestand src/main/java/bbejeck/chapter_5/CountingWindowingAndKtableJoinExample.java) (listing 5.10).
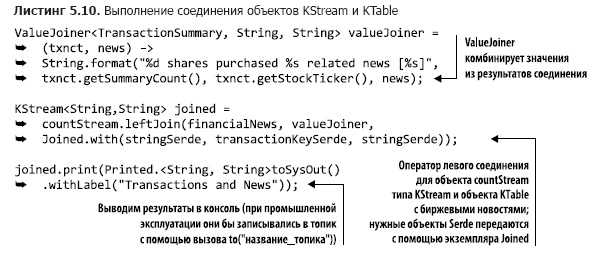
Deze leftJoin-operator is vrij eenvoudig. In tegenstelling tot de join in hoofdstuk 4 wordt de methode JoinWindow niet gebruikt, aangezien er bij het uitvoeren van de KStream-KTable join voor elke sleutel in de KTable slechts één record aanwezig is. Deze join heeft geen tijdslimiet: het record is ofwel in de KTable, of het is afwezig. De belangrijkste conclusie is dat met KTable-objecten de KStream kan worden verrijkt met minder vaak bijgewerkte referentiegegevens.
Laten we nu een efficiëntere manier bekijken om evenementen uit de KStream te verrijken.
5.3.4. GlobalKTable-objecten
Zoals u heeft begrepen, is er behoefte aan het verrijken van datastromen of het toevoegen van context aan hen. In hoofdstuk 4 heeft u de joins van twee KStream-objecten gezien, en in het voorgaande gedeelte — de join van KStream en KTable. In al deze gevallen is het noodzakelijk om de datastroom opnieuw te partitioneren bij het mappen van sleutels naar een nieuw type of waarde. Soms gebeurt deze herpartitionering expliciet, en soms doet Kafka Streams dit automatisch. Herpartitionering is noodzakelijk omdat de sleutels zijn veranderd en de records in nieuwe secties moeten komen, anders is de join niet mogelijk (dit werd besproken in hoofdstuk 4, in het punt 'Herpartitionering van gegevens' subsectie 4.2.4).
Hertelijke herpartitionering heeft zijn prijs
Hertelijke herpartitionering vereist kosten - extra middelen om tussenliggende onderwerpen te creëren, het behouden van dubbele gegevens in nog een onderwerp; het betekent ook verhoogde latentie door het schrijven en lezen uit dit onderwerp. Bovendien, als het nodig is om verbinding te maken over meer dan één aspect of dimensie, moet men verbindingen in een keten organiseren, records met nieuwe sleutels weergeven en het herpartitioneringsproces opnieuw uitvoeren.
Verbinding met datasets van kleinere omvang
In sommige gevallen is het volume van de referentiegegevens waarmee verbinding wordt gemaakt relatief klein, zodat volledige kopieën ervan lokaal op elk van de knooppunten passen. Voor dergelijke situaties is in Kafka Streams de klasse GlobalKTable voorzien.
Instellingen van GlobalKTable zijn uniek, omdat de applicatie alle gegevens op elk van de knooppunten replicaat. En omdat op elk van de knooppunten alle gegevens aanwezig zijn, is het niet nodig om de stroom gebeurtenissen te partitioneren op basis van de sleutel van de referentiegegevens, zodat deze toegankelijk is voor alle secties. Met behulp van GlobalKTable-objecten kunnen ook keyless joins worden uitgevoerd. Laten we terugkeren naar een van de eerdere voorbeelden om deze mogelijkheid te demonstreren.
Verbinding van KStream-objecten met GlobalKTable-objecten
In sectie 5.3.2 hebben we vensteraggregatie van beurs-transacties per klanten uitgevoerd. De resultaten van deze aggregatie zagen er ongeveer als volgt uit:
{customerId='074-09-3705', stockTicker='GUTM'}, 17
{customerId='037-34-5184', stockTicker='CORK'}, 16
Hoewel deze resultaten overeenkwamen met het gestelde doel, zou het handig zijn als ook de naam van de klant en de volledige naam van het bedrijf werden weergegeven. Om de naam van de klant en de bedrijfsnaam toe te voegen, kunnen normale verbindingen worden uitgevoerd, maar dit vereist twee sleutelmappingen en opnieuw partitioneren. Met behulp van GlobalKTable kunnen dergelijke kosten worden vermeden.
Hiervoor gebruiken we het object countStream uit listing 5.11 (de bijbehorende code is te vinden in het bestand src/main/java/bbejeck/chapter_5/GlobalKTableExample.java), door het te combineren met twee GlobalKTable-objecten.
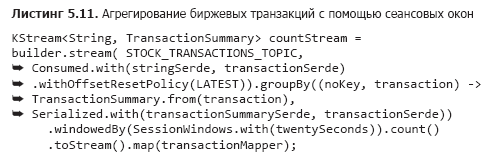
We hebben dit eerder besproken, dus ik zal niet herhalen. Maar ik wil opmerken dat de code in de functie toStream().map is geabstraheerd in een object-functie voor de leesbaarheid, in plaats van in een inline lambda-uitdrukking.
De volgende stap is het declareren van twee instanties van GlobalKTable (de bijbehorende code is te vinden in het bestand src/main/java/bbejeck/chapter_5/GlobalKTableExample.java) (lijst 5.12).
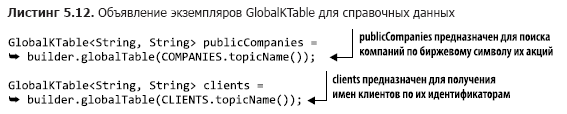
Let op dat de namen van de topics worden beschreven met behulp van enumeraties.
Nu we alle componenten hebben voorbereid, moeten we de code voor de join schrijven (die te vinden is in het bestand src/main/java/bbejeck/chapter_5/GlobalKTableExample.java) (lijst 5.13).
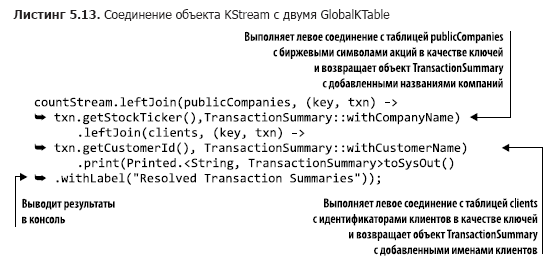
Hoewel deze code twee joins bevat, zijn ze georganiseerd in een keten omdat geen van de resultaten apart wordt gebruikt. De resultaten worden aan het einde van de hele operatie weergegeven.
Bij het uitvoeren van de bovenstaande join-operatie krijgt u resultaten van het volgende type:
{customer='Barney, Smith' company="Exxon", transactions= 17}De essentie is niet veranderd, maar deze resultaten zijn duidelijker.
Als we hoofdstuk 4 meerekenen, heeft u al verschillende soorten joins in actie gezien. Deze zijn opgenomen in tabel 5.2. Deze tabel reflecteert de mogelijkheden van joins die relevant zijn voor versie 1.0.0 van Kafka Streams; in toekomstige releases kan er iets veranderen.
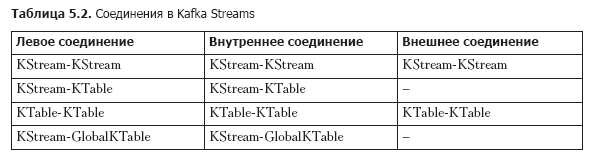
Tot slot herinner ik u aan het belangrijkste: u kunt event streams (KStream) en update streams (KTable) samenvoegen met behulp van lokale staat. Bovendien, als de omvang van de referentiegegevens niet te groot is, kan het GlobalKTable-object worden gebruikt. GlobalKTable replicateert alle partitities naar elk van de knooppunten van de Kafka Streams-applicatie, waardoor alle gegevens toegankelijk zijn, ongeacht welke partitie de sleutel heeft.
Vervolgens zullen we de mogelijkheid van Kafka Streams bekijken om de statuswijzigingen te observeren zonder gegevens uit de Kafka-topic te consumeren.
5.3.5. Toegankelijke status voor aanvragen
We hebben al verschillende operaties uitgevoerd met betrekking tot status en we hebben de resultaten altijd in de console weergegeven (voor ontwikkelingsdoeleinden) of in een topic geschreven (voor industriële toepassingen). Bij het schrijven van resultaten in een topic moet een Kafka-consumer worden gebruikt om deze te bekijken.
Het lezen van gegevens uit deze onderwerpen kan worden beschouwd als een soort gematerialiseerde weergaven (materialized views). Voor onze doeleinden kunnen we de definitie van een gematerialiseerde weergave uit Wikipedia gebruiken: "... een fysiek object in een database dat de resultaten bevat van een query. Het kan bijvoorbeeld een lokale kopie zijn van externe gegevens, of een subset van rijen en/of kolommen van een tabel of de resultaten van een join, of een draaitabel verkregen door aggregatie" (https://en.wikipedia.org/wiki/Materialized_view).
Kafka Streams maakt ook interactieve queries (interactive queries) mogelijk naar statusopslag, wat directe toegang tot deze gematerialiseerde weergaven biedt. Het is belangrijk op te merken dat de query naar de statusopslag een "alleen-lezen" operatie is. Hierdoor hoeft u zich geen zorgen te maken dat de status inconsistent wordt tijdens de gegevensverwerking door de applicatie.
De mogelijkheid om directe queries naar statusopslag uit te voeren is van groot belang. Het betekent dat je applicaties - dashboards kunt maken zonder eerst gegevens van de Kafka-consument te hoeven ophalen. Het verhoogt ook de efficiëntie van de applicatie, omdat het niet nodig is om gegevens opnieuw te schrijven:
- doordat de gegevens lokaal zijn, kunnen ze snel worden benaderd;
- duplicatie van gegevens wordt uitgesloten, omdat ze niet naar externe opslag worden geschreven.
Het belangrijkste dat ik wil dat je onthoudt: je kunt direct queries naar de status vanuit de applicatie uitvoeren. De mogelijkheden die dit biedt, kunnen niet worden overschat. In plaats van gegevens uit Kafka te consumeren en records in de database voor de applicatie op te slaan, kun je queries naar statusopslag uitvoeren met hetzelfde resultaat. Directe queries naar statusopslag betekenen minder hoeveelheid code (geen consument) en minder software (geen behoefte aan een database-tabel om de resultaten op te slaan).
We have covered a significant amount of information in this chapter, so we will temporarily stop our discussion of interactive queries to state stores. But don't worry: in Chapter 9 we will create a simple application—a dashboard with interactive queries. To demonstrate interactive queries and the capabilities of adding them to Kafka Streams applications, it will use some examples from this and previous chapters.
Samenvatting
- KStream objects represent event streams, comparable to inserts in a database. KTable objects represent streams of updates, which are more similar to updates in a database. The size of a KTable object does not grow; old records are replaced with new ones.
- KTable objects are necessary for aggregation operations.
- Window operations can be used to split aggregated data into time buckets.
- With GlobalKTable objects, you can access reference data from anywhere in the application, regardless of partitioning.
- Joins between KStream, KTable, and GlobalKTable objects are possible.
So far, we have focused on creating Kafka Streams applications using the high-level DSL KStream. While the high-level approach allows for neat and concise programs, its use represents a certain trade-off. Working with the DSL KStream means increasing code conciseness at the expense of control. In the next chapter, we will look at the low-level API of processor nodes and try out other trade-offs. Programs will become longer than they have been so far, but we will gain the ability to create virtually any processor node that we may need.
→ For more details about the book, visit
→ For Habr users, a 25% discount with the coupon— Kafka Streams
→ Upon payment for the paper version of the book, the electronic book will be sent to your email.
Bron: habr.com
