

Connection tracking (“conntrack”) is a core function of the Linux kernel's network stack. It enables the kernel to monitor all logical network connections or streams and thereby identify all packets that make up each stream, so they can be processed together in sequence.
Conntrack is an important kernel feature used in several key scenarios:
- NAT relies on information from conntrack, allowing it to handle all packets from a single stream uniformly. For example, when a pod accesses a Kubernetes service, the kube-proxy load balancer uses NAT to route traffic to a specific pod within the cluster. Conntrack records that for a specific connection, all packets to the service's IP should be directed to the same pod, and that packets returned by the backend pod should be routed back by NAT to the pod from which the request came.
- Stateful firewalls, such as Calico, rely on information from conntrack to whitelist 'reply' traffic. This allows you to write a network policy that states: 'allow my pod to connect to any remote IP address' without needing to write a policy to explicitly allow reply traffic. (Without this, you would have to add a much less secure rule 'allow packets into my pod from any IP'.)
Additionally, conntrack typically enhances system performance (reducing CPU consumption and packet latency) since only the first packet in a stream
needs to go through the full network stack processing to determine what to do with it. See the post '' for an example of how this works.
However, conntrack has its limitations…
So, where did it all go wrong?
The conntrack table has a configurable maximum size, and when it fills up, connections typically start to get dropped or terminated. For most applications' traffic, there is usually enough free space in the table so this never becomes a problem. However, there are several scenarios where it’s worth considering the use of the conntrack table:
- De meest voor de hand liggende situatie is wanneer uw server een extreem groot aantal gelijktijdig actieve verbindingen verwerkt. Bijvoorbeeld, als uw conntrack-tabel is ingesteld op 128k records, maar u heeft > 128k gelijktijdige verbindingen, dan zult u zeker problemen tegenkomen!
- Een iets minder voor de hand liggende situatie is wanneer uw server een zeer groot aantal verbindingen per seconde verwerkt. Zelfs als de verbindingen kortdurend zijn, worden ze gedurende een bepaalde periode (standaard 120s) door Linux gevolgd. Bijvoorbeeld, als uw conntrack-tabel is ingesteld op 128.000 records en u probeert 1100 verbindingen per seconde te verwerken, zullen ze de grootte van de conntrack-tabel overschrijden, zelfs als de verbindingen zeer kortdurend zijn (128k / 120s = 1092 verbindingen / s).
Er zijn verschillende nichetypen toepassingen die in deze categorieën vallen. Bovendien, als u veel kwaadwillenden heeft, kan het vullen van de conntrack-tabel van uw server met talloze half-open verbindingen worden gebruikt in een denial-of-service (DoS) aanval. In beide gevallen kan conntrack een beperkende factor in uw systeem worden. In sommige gevallen kan het voldoende zijn om de instellingen van de conntrack-tabel aan te passen — door de grootte te vergroten of de time-outs van conntrack te verkorten (maar als u dit verkeerd doet, kunt u tegen grote problemen aanlopen). In andere gevallen zal het noodzakelijk zijn om conntrack te omzeilen voor agressieve verkeer.
Een werkelijk voorbeeld
Laten we een specifiek voorbeeld geven: een grote SaaS-provider waarmee we hebben samengewerkt, had een aantal memcached-servers op hosts (geen virtuele machines), waarvan er elke meer dan 50K kortdurende verbindingen per seconde verwerkten.
Ze experimenteerden met de configuratie van conntrack, vergrootten de tabellen en verkortten de tracking-tijd, maar de configuratie was onbetrouwbaar, het geheugenverbruik steeg aanzienlijk, wat een probleem was (enkele GB!), en de verbindingen waren zo kort dat conntrack zijn gebruikelijke prestatievoordelen (vermindering van CPU-verbruik of vertraging van pakketten) niet kon behalen.
Als alternatief hebben ze gekozen voor Calico. De netwerkbeleid van Calico stelt hen in staat om conntrack niet te gebruiken voor een bepaald soort verkeer (door de optie doNotTrack voor beleid te gebruiken). Dit gaf hen het vereiste prestatieniveau, plus een extra beveiligingslaag die door Calico werd geboden.
Wat moet je doen om conntrack te omzeilen?
- Do-not-track netwerkbeleid moet over het algemeen symmetrisch zijn. In het geval van een SaaS-aanbieder: hun applicaties werkten binnen een beveiligd gebied en met behulp van netwerkbeleid konden ze het verkeer van andere specifieke applicaties op de witte lijst zetten, die toegang tot memcached kregen.
- Het do-not-track beleid houdt geen rekening met de verbindingrichting. In theorie zou het mogelijk zijn om een verbinding te maken met een van de memcached-clients als deze de juiste bronpoort gebruikt, wanneer een memcached-server is gecompromitteerd. Als je echter het netwerkbeleid voor je memcached-clients correct hebt ingesteld, worden deze verbindingspogingen nog steeds aan de clientzijde afgewezen.
- Het do-not-track beleid wordt op elk pakket toegepast, in tegenstelling tot gewone beleid dat alleen op het eerste pakket van een stroom wordt toegepast. Dit kan de CPU-ressources per pakket verhogen, omdat het beleid voor elk pakket moet worden toegepast. Maar voor kortdurende verbindingen wordt deze overhead gecompenseerd door de vermindering van resourceverbruik voor het verwerken van conntrack. Bijvoorbeeld, in het geval van een SaaS-provider was het aantal pakketten per verbinding zeer beperkt, waardoor de extra CPU-kosten voor het toepassen van beleid op elk pakket gerechtvaardigd waren.
Laten we beginnen met de tests
We voerden een test uit op een pod met een memcached-server en meerdere pods met memcached-clients die op externe nodes draaiden, zodat we een zeer groot aantal verbindingen per seconde konden genereren. De server met de pod van de memcached-server had 8 kernen en 512k vermeldingen in de conntrack-tabel (de standaard ingestelde grootte van de tabel voor de host).
We hebben het prestatieniveau gemeten tussen: zonder netwerkbeleid; met regulier Calico beleid; en met Calico do-not-track beleid.
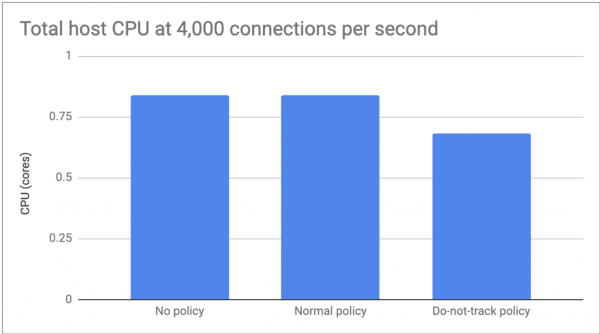
Voor de eerste test hebben we het aantal verbindingen tot 4.000 per seconde ingesteld, zodat we ons konden concentreren op het verschil in CPU-verbruik. Hier waren er geen significante verschillen tussen het ontbreken van een beleid en het gewone beleid, maar de do-not-track verhoogde het CPU-verbruik met ongeveer 20%;
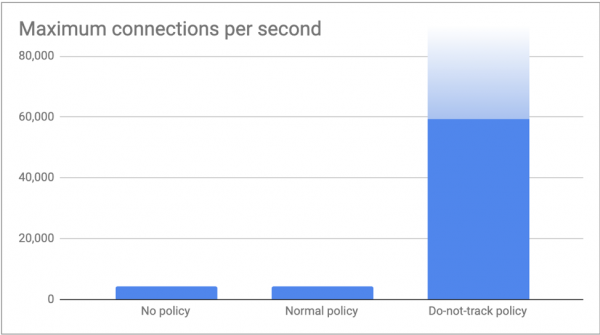
In de tweede test hebben we zoveel verbindingen gestart als onze klanten konden genereren en hebben we het maximale aantal verbindingen per seconde gemeten dat onze memcached-server aankon. Zoals verwacht, bereikten in het geval van 'geen beleid' en 'gewone beleid' beide de limiet van conntrack met meer dan 4.000 verbindingen per seconde (512k / 120s = 4.369 verbindingen/s). Met het do-not-track beleid verzonden onze klanten 60.000 verbindingen per seconde zonder enige problemen. We zijn ervan overtuigd dat we dit nummer konden verhogen door meer klanten aan te sluiten, maar we voelen dat deze cijfers al voldoende zijn om de boodschap van dit artikel te illustreren!
Conclusie
Conntrack is een belangrijke functie in de kernel. Het doet zijn werk uitstekend. Vaak wordt het gebruikt door de belangrijkste componenten van het systeem. Echter, in bepaalde specifieke scenario's, weegt de belasting door conntrack zwaarder dan de gebruikelijke voordelen die het biedt. In dit scenario kunnen de netwerkbeleid van Calico worden gebruikt om selectief het gebruik van conntrack uit te schakelen, terwijl de netwerksveiligheid wordt verhoogd. Voor al het andere verkeer blijft conntrack uw maatje!
Lees ook andere artikelen op onze blog:
Bron: habr.com
