

Een tijd geleden stonden we voor de vraag welk ETL-gereedschap we moesten kiezen voor het werken met Big Data. De eerder gebruikte oplossing Informatica BDM voldeed niet aan onze verwachtingen vanwege de beperkte functionaliteit. Het gebruik ervan beperkte zich tot een framework voor het uitvoeren van spark-submit commando's. Op de markt waren er niet veel alternatieven die in staat waren om met de enorme datavolumes te werken waarmee we dagelijks te maken hebben. Uiteindelijk kozen we voor Ab Initio. Tijdens de pilotdemonstraties toonde het product een zeer hoge verwerkingssnelheid voor gegevens. Er is bijna geen informatie over Ab Initio in het Russisch, dus besloten we onze ervaringen op Habr te delen.
Ab Initio biedt talloze klassieke en ongebruikelijke transformaties, waarvan de code kan worden uitgebreid met behulp van de eigen PDL-taal. Voor kleine bedrijven zal zo’n krachtig hulpmiddel waarschijnlijk overbodig zijn, en veel van de mogelijkheden kunnen duur en ongebruikt blijven. Maar als je schaal in de buurt van die van Sberkrant komt, kan Ab Initio interessant voor je zijn.
Het helpt bedrijven wereldwijd kennis op te bouwen en een ecosysteem te ontwikkelen, terwijl het ontwikkelaars in staat stelt hun vaardigheden in ETL te verbeteren, hun kennis van shell uit te breiden, de mogelijkheid biedt om de PDL-taal te leren, een visueel overzicht van de laadprocessen biedt en de ontwikkeling vereenvoudigt dankzij de overvloed aan functionele componenten.
In deze post zal ik de mogelijkheden van Ab Initio bespreken en vergelijkende kenmerken geven van de werking met Hive en GreenPlum.
- Beschrijving van het MDW-framework en werk aan de aanpassing ervan voor GreenPlum
- Vergelijkende kenmerken van de prestaties van Ab Initio bij het werken met Hive en GreenPlum
- De werking van Ab Initio met GreenPlum in de Near Real Time-modus
De functionaliteit van dit product is zeer breed en vereist veel tijd om te leren. Echter, met de juiste vaardigheden en de juiste prestatie-instellingen kunnen de verwerkingsresultaten van gegevens behoorlijk indrukwekkend zijn. Het gebruik van Ab Initio kan een ontwikkelaar interessante ervaring opleveren. Het biedt een nieuw perspectief op ETL-ontwikkeling, een hybride tussen een visuele omgeving en het gebruik van een script-achtige taal voor het laden.
Bedrijven ontwikkelen hun ecosystemen en dit instrument komt hen op het juiste moment van pas. Met Ab Initio kan men kennis over het huidige bedrijf verzamelen en deze kennis gebruiken om bestaande bedrijven uit te breiden en nieuwe bedrijven op te richten. Alternatieven voor Ab Initio zijn de visuele ontwikkelomgevingen zoals Informatica BDM en de niet-visuele omgevingen zoals Apache Spark.
Beschrijving van Ab Initio
Ab Initio, net als andere ETL-tools, bestaat uit een set producten.
Ab Initio GDE (Graphical Development Environment) is een ontwikkelomgeving waar de ontwikkelaar datatransformaties instelt en deze verbindt met datastromen in de vorm van pijlen. Deze set transformaties wordt een graf genoemd:
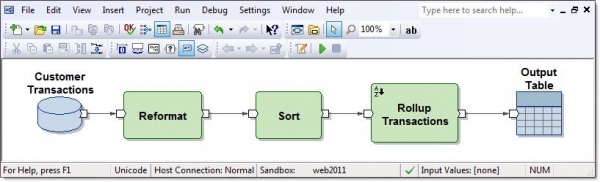
In- en uitgangsverbindingen van functionele componenten zijn poorten en bevatten velden die binnen de transformaties zijn berekend. Meerdere grafen, verbonden met stromen in de vorm van pijlen in de volgorde van uitvoering, worden een plan genoemd.
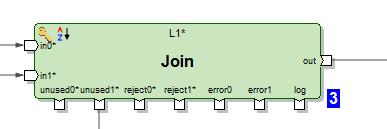
Er zijn enkele honderden functionele componenten, wat erg veel is. Veel van deze componenten zijn sterk gespecialiseerd. De mogelijkheden van klassieke transformaties in Ab Initio zijn breder dan die in andere ETL-tools. Bijvoorbeeld, Join heeft meerdere uitgangen. Naast de output van de samengevoegde datasets kun je ook records van de invoerdatasets krijgen voor de sleutels waarmee niet kon worden samengevoegd. Daarnaast kunnen rejects, errors en een log van de transformatieoutput worden verkregen, die in dezelfde graf als een tekstbestand kan worden gelezen en door andere transformaties kan worden verwerkt:
Of bijvoorbeeld, je kunt de gegevensontvanger materialiseren als een tabel en in dezelfde graf gegevens eruit lezen.
Er zijn originele transformaties. Bijvoorbeeld, de transformatie Scan heeft functionaliteit zoals bij analytische functies. Er zijn transformaties met sprekende namen: Create Data, Read Excel, Normalize, Sort within Groups, Run Program, Run SQL, Join with DB, enz. Grafen kunnen gebruikmaken van runtime-parameters, waaronder het doorgeven van parameters van of naar het besturingssysteem. Bestanden met een set van parameters die aan de graf moeten worden doorgegeven, worden parameter sets (psets) genoemd.
Zoals het hoort, heeft Ab Initio GDE zijn eigen repository, genaamd EME (Enterprise Meta Environment). Ontwikkelaars hebben de mogelijkheid om met lokale versies van de code te werken en hun ontwikkelingen in de centrale repository in te checken.
Het is mogelijk om tijdens of na de uitvoering van een grafiek op elke verbindingsflow te klikken en de gegevens te bekijken die tussen deze transformaties zijn doorgevoerd.
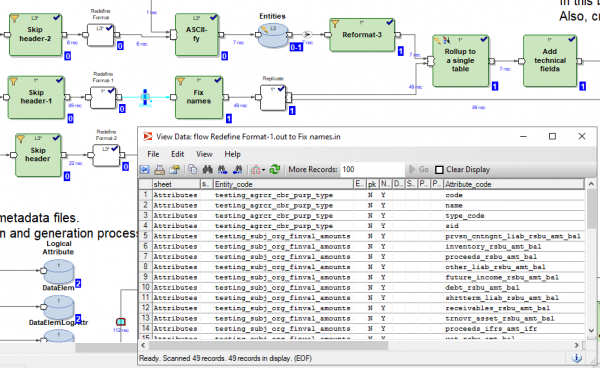
Daarnaast is er de mogelijkheid om op elke flow te klikken en trackingdetails te bekijken – hoeveel parallelle uitvoeringen er waren, hoeveel rijen en bytes in welke parallel zijn geladen.
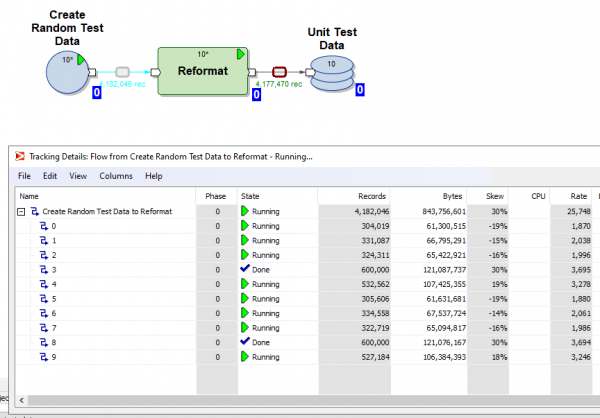
Het is mogelijk om de uitvoering van de grafiek in fasen te verdelen en aan te geven dat sommige transformaties eerst moeten worden uitgevoerd (in de nul-fase), de volgende in de eerste fase, de volgende in de tweede fase, enzovoort.
Bij elke transformatie kan een zogenaamde layout worden gekozen (waar deze zal worden uitgevoerd): zonder parallelle uitvoeringen of in parallelle streams, waarvan het aantal kan worden ingesteld. Tijdelijke bestanden die Ab Initio genereert tijdens de uitvoering van de transformaties kunnen zowel in het bestandssysteem worden geplaatst de server, als in HDFS.
In elke transformatie op basis van het standaardtemplate kan een eigen script in de PDL-taal worden gemaakt, wat enigszins lijkt op shell.
Met de PDL-taal kunt u de functionaliteit van transformaties uitbreiden en, in het bijzonder, kunt u dynamisch (tijdens uitvoering) willekeurige codefragmenten genereren, afhankelijk van uitvoeringsparameters.
Bovendien heeft Ab Initio een goed ontwikkelde integratie met het besturingssysteem via shell. Specifiek in Sberbank wordt linux ksh gebruikt. U kunt variabelen met shell uitwisselen en deze als parameters voor grafieken gebruiken. Vanuit shell kunt u de uitvoering van Ab Initio-grafieken aanroepen en Ab Initio beheren.
Naast Ab Initio GDE bevat de levering veel andere producten. Er is een eigen Co>Operation System dat pretentieus als besturingssysteem wordt aangeduid. Er is een Control>Center, waarin u belastingstromen kunt plannen en monitoren. Er zijn producten voor ontwikkeling op een meer primitief niveau dan Ab Initio GDE toelaat.
Beschrijving van het MDW-framework en werk aan de aanpassing ervan voor GreenPlum
Samen met zijn producten levert de leverancier het MDW (Metadata Driven Warehouse), een grafiekconfigurator die is ontworpen om te helpen bij typische taken voor het vullen van gegevensopslagen of data vaults.
Het bevat gebruikersspecifieke (projectspecifieke) metadata-parsers en kant-en-klare codegeneratoren 'uit de doos'.
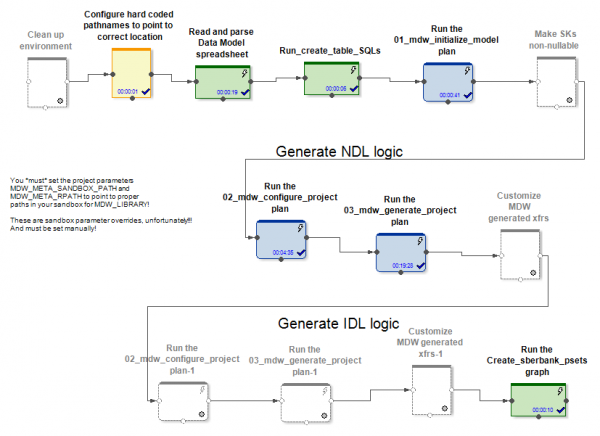
MDW ontvangt een datamodel, een configuratiebestand voor de databaseverbinding (Oracle, Teradata of Hive) en enkele andere instellingen. Project-specifieke onderdelen implementeren de modellen in de database. De standaardonderdelen van het product genereren grafieken en configuratiebestanden bij het laden van gegevens in de modeltabellen. Hierbij worden grafieken (en psets) gemaakt voor verschillende modi van initiële en incrementele updates van entiteiten.
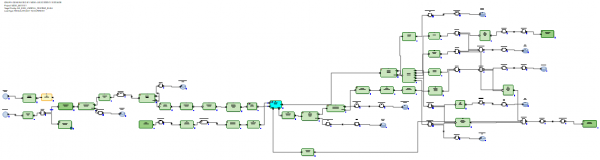
In het geval van Hive en RDBMS worden verschillende grafieken gegenereerd voor de initiële en incrementele gegevensupdates.
Voor Hive worden binnenkomende deltagegevens verbonden met behulp van Ab Initio Join aan de gegevens die vóór de update in de tabel stonden. De gegevensladers in MDW (zowel in Hive als in RDBMS) voegen niet alleen nieuwe gegevens uit de delta toe, maar sluiten ook de actualiteitsperiodes van de gegevens af, op basis van de primaire sleutels waarvan de delta is ontvangen. Daarnaast moet ook het onveranderde deel van de gegevens opnieuw worden geschreven. Dit is echter noodzakelijk omdat Hive geen delete- of update-operaties ondersteunt.
In het geval van RDBMS ziet het proces van de incrementele gegevensupdates er optimaler uit, omdat RDBMS echte update-mogelijkheden hebben.
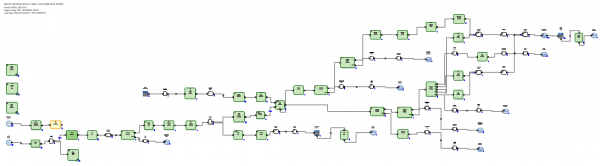
De binnenkomende delta wordt geladen in een tussenliggende tabel in de database. Vervolgens worden de delta-gegevens verbonden met de gegevens die vóór de update in de tabel stonden. Dit gebeurt via SQL met behulp van de gegenereerde SQL-query. Vervolgens worden met SQL-commando's delete+insert nieuwe gegevens uit de delta in de doeltabel ingevoegd en worden de actualiteitsperiodes van de gegevens die met de primaire sleutels zijn ontvangen, afgesloten.
Het is niet nodig om onveranderde gegevens opnieuw te schrijven.
Zo zijn we tot de conclusie gekomen dat MDW in het geval van Hive de gehele tabel moet herschrijven, omdat Hive geen updatefunctie heeft. Bij een update is er niets beter dan het volledig herschrijven van de gegevens. In het geval van RDBMS vonden de productontwikkelaars daarentegen het nodig om de verbinding en update van tabellen aan SQL over te laten.
Voor het project bij Sberbank hebben we een nieuwe herbruikbare implementatie van een database-loader voor GreenPlum ontwikkeld. Dit is gedaan op basis van de versie die MDW genereert voor Teradata. Teradata, en niet Oracle, bleek hiervoor de beste en meest geschikte keuze, aangezien het ook een MPP-systeem is. De werkwijzen en de syntaxis van Teradata en GreenPlum bleken naast elkaar te liggen.
Voorbeelden van kritische MDW-verschillen tussen verschillende RDBMS zijn als volgt. In GreenPlum moet bij het aanmaken van tabellen in tegenstelling tot Teradata de clausule geschreven worden.
distributed byIn Teradata schrijf je
Verwijder afbeeldingen <table> all, terwijl je in GreenPlum schrijft
verwijder van <table>In Oracle schrijf je ter optimalisatie
delete from t where rowid in (), terwijl je in Teradata en GreenPlum schrijft
delete from t where exists (select * from delta where delta.pk=t.pk)Daarnaast dient opgemerkt te worden dat voor het gebruik van Ab Initio met GreenPlum de GreenPlum-client op alle nodes van het Ab Initio-cluster moest worden geïnstalleerd. Dit kwam doordat we tegelijkertijd van alle nodes van ons cluster naar GreenPlum verbonden waren. Om ervoor te zorgen dat het lezen uit GreenPlum parallel kon verlopen en elke parallelle thread van Ab Initio zijn eigen gegevensportie uit GreenPlum kon lezen, moest in de sectie "where" van de SQL-query een constructie worden geplaatst die door Ab Initio begrepen werd.
where ABLOCAL()en de waarde van deze constructie moet worden gedefinieerd door de parameter te specificeren voor de DB-lezende transformatie.
ablocal_expr="string_concat("mod(t.", string_filter_out("{$TABLE_KEY}","{}"), ",", (decimal(3))(number_of_partitions()),")=", (decimal(3))(this_partition()))", wat compileert naar iets als
mod(sk,10)=3, wat betekent dat je GreenPlum een expliciete filter voor elke partitite moet geven. Voor andere databases (Teradata, Oracle) kan Ab Initio deze parallelisatie automatisch uitvoeren.
Vergelijkende kenmerken van de prestaties van Ab Initio bij het werken met Hive en GreenPlum
Bij Sberbank is een experiment uitgevoerd ter vergelijking van de prestaties van de door MDW gegenereerde grafen ten aanzien van Hive en GreenPlum. In het kader van het experiment had Hive 5 nodes in hetzelfde cluster als Ab Initio, terwijl GreenPlum 4 nodes in een apart cluster had. Dat wil zeggen, Hive had een bepaald voordeel ten opzichte van GreenPlum ‘qua hardware’.
Er zijn twee paren grafen bekeken, die dezelfde taak voor het bijwerken van gegevens in Hive en GreenPlum uitvoeren. Hierbij zijn de grafen, gegenereerd door de MDW-configurator, uitgevoerd:
- initiёle lading + incrementele lading van willekeurig gegenereerde gegevens in de Hive-tabel.
- initiёle lading + incrementele lading van willekeurig gegenereerde gegevens in dezelfde GreenPlum-tabel.
In beide gevallen (Hive en GreenPlum) werden de uploads uitgevoerd in 10 parallelle stroomprocessen op dezelfde Ab Initio-cluster. De tussenresultaten voor de berekeningen werden opgeslagen in HDFS (in Ab Initio-termen werd de MFS-layout met HDFS gebruikt). Eén regel willekeurig gegenereerde gegevens nam in beide gevallen 200 byte in beslag.
Het resultaat was als volgt:
Hive:
Initiële upload in Hive
Ingevoegde rijen
6 000 000
60 000 000
600 000 000
Duur van de initiële
upload in seconden
41
203
1 601
Incrementele upload in Hive
Aantal rijen in de
doeltabel aan het begin van het experiment
6 000 000
60 000 000
600 000 000
Aantal delta-rijen dat is toegepast op
de doeltabel tijdens het experiment
6 000 000
6 000 000
6 000 000
Duur van de incrementele
upload in seconden
88
299
2 541
GreenPlum:
Initiële upload in GreenPlum
Ingevoegde rijen
6 000 000
60 000 000
600 000 000
Duur van de initiële
upload in seconden
72
360
3 631
Incrementele upload in GreenPlum
Aantal rijen in de
doeltabel aan het begin van het experiment
6 000 000
60 000 000
600 000 000
Aantal delta-rijen dat is toegepast op
de doeltabel tijdens het experiment
6 000 000
6 000 000
6 000 000
Duur van de incrementele
upload in seconden
159
199
321
We zien dat de snelheid van de initiële upload zowel in Hive als in GreenPlum lineair afhankelijk is van het datavolume en, om redenen van betere hardware, is deze iets sneller voor Hive dan voor GreenPlum.
De incrementele upload in Hive is ook lineair afhankelijk van de hoeveelheid eerder geladen gegevens in de doeltabel en verloopt relatief langzaam met toenemende volumes. Dit komt door de noodzaak om de doeltabel volledig opnieuw te schrijven. Dit betekent dat het aanbrengen van kleine wijzigingen aan enorme tabellen geen goede gebruiksoptie voor Hive is.
De incrementele upload in GreenPlum is daarentegen zwak afhankelijk van de hoeveelheid eerder opgeslagen gegevens in de doeltabel en verloopt relatief snel. Dit is mogelijk gemaakt door SQL Joins en de architectuur van GreenPlum, die de delete-operatie toestaat.
Dus, GreenPlum voegt de delta samen met delete+insert-methoden toe, terwijl Hive geen delete of update-operaties heeft, waardoor de gehele dataset bij incrementele updates volledig opnieuw geschreven moest worden. De vergelijking van de vetgedrukte cellen is het meest illustratief, omdat het overeenkomt met de meest voorkomende manier van resource-intensieve uploads. We zien dat GreenPlum in deze test 8 keer beter presteert dan Hive.
De werking van Ab Initio met GreenPlum in de Near Real Time-modus
In dit experiment zullen we de mogelijkheid van Ab Initio onderzoeken om de GreenPlum-tabel te updaten met willekeurig gegenereerde datastromen in een modus die dicht bij real-time is. We zullen kijken naar de GreenPlum-tabel dev42_1_db_usl.TESTING_SUBJ_org_finval, waarmee we aan de slag gaan.
We zullen drie Ab Initio-grafieken gebruiken voor de interactie met deze tabel:
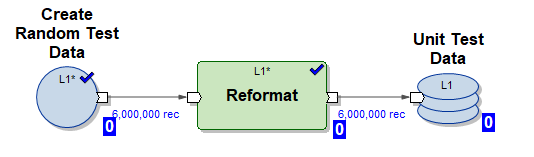
1) Graf Create_test_data.mp – genereert in 10 gelijktijdige threads bestanden met gegevens in HDFS met 6.000.000 regels. De gegevens zijn willekeurig en hun structuur is georganiseerd voor invoeging in onze tabel.
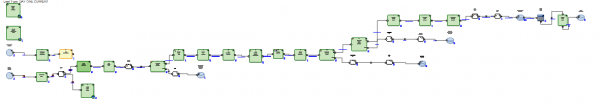
2) Graf mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset – gegenereerde MDW graf voor de initiële invoeging van gegevens in onze tabel in 10 gelijktijdige threads (testgegevens zijn gegenereerd door graf (1)).
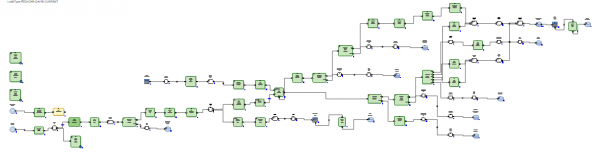
3) Graf mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset – gegenereerde MDW graf voor de incrementele update van onze tabel in 10 gelijktijdige threads met vers binnengekomen gegevens (delta's), gegenereerd door graf (1).
Laten we het onderstaande script uitvoeren in NRT-modus:
- genereer 6.000.000 testregels.
- voeren we een initiële laad in van 6.000.000 testregels in een lege tabel.
- herhaal de incrementele laad 5 keer.
- genereer 6.000.000 testregels.
- voeren we een incrementele invoeging van 6.000.000 testregels in de tabel uit (terwijl de oude gegevens een vervaldatum valid_to_ts krijgen en nieuwere gegevens met dezelfde primaire sleutel worden ingevoegd).
Dit scenario emuleert de werking van een bepaald bedrijfsysteem – in realtime komt er een aanzienlijke hoeveelheid nieuwe gegevens binnen en wordt deze direct in GreenPlum gevoegd.
Laten we nu het log van het script bekijken:
Start Create_test_data.input.pset at 2020-06-04 11:49:11.
Einde Create_test_data.input.pset at 2020-06-04 11:49:37.
Start mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:49:37.
Einde mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:50:42.
Start Create_test_data.input.pset at 2020-06-04 11:50:42.
Einde Create_test_data.input.pset at 2020-06-04 11:51:06.
Start mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:51:06.
Einde mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:53:41.
Start Create_test_data.input.pset at 2020-06-04 11:53:41.
Einde Create_test_data.input.pset at 2020-06-04 11:54:04.
Start mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:54:04.
Einde mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:56:51.
Start Create_test_data.input.pset at 2020-06-04 11:56:51.
Einde Create_test_data.input.pset at 2020-06-04 11:57:14.
Start mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:57:14.
Einde mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:59:55.
Start Create_test_data.input.pset at 2020-06-04 11:59:55.
Einde Create_test_data.input.pset at 2020-06-04 12:00:23.
Start mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 12:00:23.
Einde mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 12:03:23.
Start Create_test_data.input.pset at 2020-06-04 12:03:23.
Einde Create_test_data.input.pset at 2020-06-04 12:03:49.
Start mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 12:03:49
Finish mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 12:06:46
Het resultaat is als volgt:
Grafiek
Starttijd
Eindtijd
Lengte
Create_test_data.input.pset
04.06.2020 11:49:11
04.06.2020 11:49:37
00:00:26
mdw_load.day_one.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:49:37
04.06.2020 11:50:42
00:01:05
Create_test_data.input.pset
04.06.2020 11:50:42
04.06.2020 11:51:06
00:00:24
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:51:06
04.06.2020 11:53:41
00:02:35
Create_test_data.input.pset
04.06.2020 11:53:41
04.06.2020 11:54:04
00:00:23
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:54:04
04.06.2020 11:56:51
00:02:47
Create_test_data.input.pset
04.06.2020 11:56:51
04.06.2020 11:57:14
00:00:23
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:57:14
04.06.2020 11:59:55
00:02:41
Create_test_data.input.pset
04.06.2020 11:59:55
04.06.2020 12:00:23
00:00:28
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 12:00:23
04.06.2020 12:03:23
00:03:00
Create_test_data.input.pset
04.06.2020 12:03:23
04.06.2020 12:03:49
00:00:26
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 12:03:49
04.06.2020 12:06:46
00:02:57
We zien dat 6.000.000 rijen incrementen binnen 3 minuten worden verwerkt, wat behoorlijk snel is.
De gegevens in de doel tabel zijn als volgt verdeeld:
select valid_from_ts, valid_to_ts, count(1), min(sk), max(sk) from dev42_1_db_usl.TESTING_SUBJ_org_finval group by valid_from_ts, valid_to_ts order by 1,2; 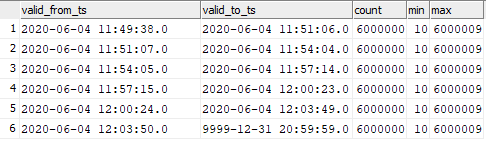
We kunnen de overeenkomsten van de ingevoerde gegevens met de startmomenten van de grafieken zien.
Dit betekent dat je in Ab Initio een incrementele dataload in GreenPlum met een zeer hoge frequentie kunt uitvoeren en de hoge snelheid van invoer van deze gegevens in GreenPlum kunt observeren. Natuurlijk zal het niet elke seconde mogelijk zijn om te starten, aangezien Ab Initio, net als elk ETL-systeem, tijd nodig heeft voor 'opwarmtijd' bij het starten.
Conclusie
Momenteel wordt Ab Initio gebruikt bij Sberbank voor het opbouwen van de Eenheid Semantische Laag (ESL) van gegevens. Dit project houdt in dat er een enkele versie van de status van verschillende bancaire business-entiteiten wordt gebouwd. Informatie komt uit verschillende bronnen, waarvan de replica's zijn voorbereid op Hadoop. Op basis van de behoeften van het bedrijf wordt een datamodel voorbereid en worden de datatransformaties beschreven. Ab Initio laadt informatie in de ESL en de geladen gegevens zijn niet alleen van belang voor het bedrijf op zichzelf, maar dienen ook als bron voor het opbouwen van datavitrines. Bovendien stelt de functionaliteit van het product ons in staat om verschillende systemen (Hive, Greenplum, Teradata, Oracle) als ontvangers te gebruiken, wat het mogelijk maakt om gegevens zonder al te veel moeite voor het bedrijf in verschillende gewenste formaten voor te bereiden.
De mogelijkheden van Ab Initio zijn breed, bijvoorbeeld het bijgeleverde MDW-framework biedt de mogelijkheid om technische en zakelijke geschiedenissen van gegevens 'uit de doos' te bouwen. Voor ontwikkelaars biedt Ab Initio de mogelijkheid om 'het wiel niet opnieuw uit te vinden' en gebruik te maken van tal van beschikbare functionele componenten, die in wezen bibliotheken zijn die nodig zijn bij de omgang met gegevens.
Auteur — expert van de professionele gemeenschap van Sberbank SberProfi DWH/BigData. De professionele gemeenschap SberProfi DWH/BigData is verantwoordelijk voor de ontwikkeling van competenties in gebieden zoals het Hadoop-ecosysteem, Teradata, Oracle DB, GreenPlum, en BI-tools zoals Qlik, SAP BO, Tableau en anderen.
Bron: habr.com
