

Ik wil een interessant mechanisme van het werken met de configuratie van een gedistribueerd systeem bespreken. De configuratie wordt rechtstreeks in de compileertaal (Scala) gepresenteerd met gebruik van veilige typen. In deze post behandelen we een voorbeeld van zo'n configuratie en bespreken we verschillende aspecten van de implementatie van een compileerbare configuratie in het algemene ontwikkelingsproces.
()
Inleiding
Het opbouwen van een betrouwbare gedistribueerde systeem impliceert dat alle knooppunten een correcte configuratie gebruiken, gesynchroniseerd met andere knooppunten. Gewoonlijk worden DevOps-technologieën (zoals terraform, ansible of een soortgelijke) gebruikt voor het automatisch genereren van configuratiebestanden (vaak eigen voor elk knooppunt). We willen er ook zeker van zijn dat op alle interagerende knooppunten identieke protocollen worden gebruikt (inclusief dezelfde versie). Anders zal er incompatibiliteit in ons gedistribueerde systeem zijn. In de wereld van de JVM is een van de gevolgen van deze eis de noodzaak om overal dezelfde versie van de bibliotheek te gebruiken die het protocolbericht bevat.
Wat betreft het testen van een gedistribueerd systeem? Natuurlijk gaan we ervan uit dat voor alle componenten unit tests zijn voorzien voordat we verder gaan met integratietests. (Om de testresultaten te extrapoleren naar runtime, moeten we ook zorgen voor een identieke set bibliotheken tijdens de testfase en in de runtime.)
Bij het werken met integratietests is het vaak eenvoudiger om overal dezelfde classpath op alle knooppunten te gebruiken. We moeten er alleen voor zorgen dat dezelfde classpath ook in de runtime wordt gebruikt. (Hoewel het heel goed mogelijk is om verschillende knooppunten met verschillende classpaths te draaien, leidt dit tot complicaties in de hele configuratie en problemen met implementatie en integratietests.) In deze post gaan we ervan uit dat overal dezelfde classpath op alle knooppunten wordt gebruikt.
Configuratie ontwikkelt zich samen met de applicatie. Voor de identificatie van verschillende stadia van de evolutie van software gebruiken we versies. Het lijkt dan ook logisch om verschillende versies van configuraties te identificeren. En de configuratie zelf in een versiebeheersysteem te plaatsen. Als er in de productie slechts één configuratie bestaat, kunnen we eenvoudigweg het versienummer gebruiken. Als er echter meerdere instanties van de productie worden gebruikt, hebben we verschillende
configuratiebranches en een extra label naast de versie (bijvoorbeeld de naam van de branch) nodig. Op deze manier kunnen we de exacte configuratie eenduidig identificeren. Elke configuratie-id komt overeen met een specifieke combinatie van gedistribueerde knooppunten, poorten, externe hulpbronnen en versies van bibliotheken. In deze post gaan we ervan uit dat er slechts één branch is en dat we de configuratie op de gebruikelijke manier kunnen identificeren met behulp van drie cijfers, gescheiden door punten (1.2.3).
In moderne omgevingen worden configuratiebestanden handmatig zelden aangemaakt. Meestal worden ze gegenereerd tijdens de implementatie en worden ze daarna niet meer aangeraakt (omdat ). Dit roept de vraag op waarom we nog steeds een tekstformaat gebruiken voor het opslaan van configuratie? Een levensvatbaar alternatief lijkt het gebruik van reguliere code voor configuratie, waarbij we voordelen kunnen behalen door controles tijdens de compilatie.
In deze post onderzoeken we juist het idee van het voorstellen van configuratie binnen een gecompileerd artefact.
Gecompileerde configuratie
In deze sectie bekijken we een voorbeeld van een statische gecompileerde configuratie. Er worden twee eenvoudige diensten geïmplementeerd – een echo-dienst en een client van de echo-dienst. Op basis van deze twee diensten worden twee varianten van het systeem opgebouwd. In de ene variant bevinden beide diensten zich op één knooppunt, in de andere variant – op verschillende knooppunten.
Gewoonlijk bevat een gedistribueerd systeem meerdere knooppunten. Knooppunten kunnen worden geïdentificeerd aan de hand van waarden van een bepaald type NodeId:
sealed trait NodeId
case object Backend extends NodeId
case object Frontend extends NodeId
of
case class NodeId(hostName: String)of zelfs
object Singleton
type NodeId = Singleton.type
Knooppunten vervullen verschillende rollen, ze draaien diensten en TCP/HTTP-verbindingen kunnen tussen hen worden ingesteld.
Voor het beschrijven van TCP-verbindingen hebben we ten minste een poortnummer nodig. We willen ook het protocol weergeven dat op deze poort wordt ondersteund, om te garanderen dat zowel de client als de server hetzelfde protocol gebruiken. We zullen de verbinding beschrijven met de volgende klasse:
case class TcpEndPoint[Protocol](node: NodeId, port: Port[Protocol])waar Poort — gewoon een geheel getal Int met de specificatie van het bereik van toegestane waarden:
type PortNumber = Refined[Int, Closed[_0, W.`65535`.T]]Gespecificeerde types
Zie de bibliotheek en . In het kort, de bibliotheek maakt het mogelijk om beperkingen toe te voegen aan types die tijdens de compilatie worden gecontroleerd. In dit geval zijn de toegestane waarden voor het poortnummer gehele 16-bits getallen. Het gebruik van de refined-bibliotheek is niet verplicht voor de gecompileerde configuratie, maar het verbetert de verificatiemogelijkheden van de compiler voor de configuratie.
Voor HTTP (REST) protocollen hebben we naast het poortnummer ook een pad naar de service nodig:
type UrlPathPrefix = Refined[String, MatchesRegex[W.`"[a-zA-Z_0-9\/]*"`.T]]
case class PortWithPrefix[Protocol](portNumber: PortNumber, pathPrefix: UrlPathPrefix)
Fantomtypes
Voor het identificeren van het protocol tijdens de compilatie gebruiken we een typeparameter die niet binnen de klasse wordt gebruikt. Deze benadering is te wijten aan het feit dat we in runtime de instantie van het protocol niet gebruiken, maar we willen dat de compiler de compatibiliteit van de protocollen controleert. Door het protocol aan te geven, kunnen we geen ongeschikte service als afhankelijkheid doorgeven.
Een van de gangbare protocollen is REST API met Json-serialisatie:
sealed trait JsonHttpRestProtocol[RequestMessage, ResponseMessage]waar RequestMessage — type verzoek, ResponseMessage — type antwoord.
Uiteraard kunnen we ook andere beschrijvingen van protocollen gebruiken die de benodigde nauwkeurigheid van de beschrijving bieden.
Voor de doeleinden van deze post gebruiken we een vereenvoudigde versie van het protocol:
sealed trait SimpleHttpGetRest[RequestMessage, ResponseMessage]Hier is het verzoek een string die aan de url wordt toegevoegd, en het antwoord is de string die in de body van het HTTP-antwoord wordt teruggegeven.
De configuratie van de service wordt beschreven door de naam van de service, poorten en afhankelijkheden. Deze elementen kunnen in Scala op verschillende manieren worden weergegeven (bijvoorbeeld, HList-en, algebraïsche datatypes). Voor de doeleinden van deze post gebruiken we het Cake Pattern en vertegenwoordigen we modules met behulp van traitHet Cake Pattern is geen verplicht element van de beschreven aanpak. Het is slechts een van de mogelijke implementaties.
Afhankelijkheden tussen services kunnen worden weergegeven als methoden die poorten retourneren. EndPointvan andere knooppunten:
  type EchoProtocol[A] = SimpleHttpGetRest[A, A]

  trait EchoConfig[A] extends ServiceConfig {
    def portNumber: PortNumber = 8081
    def echoPort: PortWithPrefix[EchoProtocol[A]] = PortWithPrefix[EchoProtocol[A]](portNumber, "echo")
    def echoService: HttpSimpleGetEndPoint[NodeId, EchoProtocol[A]] = providedSimpleService(echoPort)
  }
Voor het creëren van een echo-service is alleen het poortnummer en de specificatie van de ondersteuning van het echo-protocol nodig. We zouden de specifieke poort misschien niet eens hoeven op te geven, aangezien traits het mogelijk maken om methoden zonder implementatie (abstracte methoden) te declareren. In dat geval zou de compiler bij het creëren van een specifieke configuratie van ons vereisen om een implementatie van de abstracte methode te verstrekken en het poortnummer op te geven. Aangezien we de methode hebben geïmplementeerd, kunnen we bij het creëren van een specifieke configuratie een andere poort weglaten. De standaardwaarde zal worden gebruikt.
In de configuratie van de cliënt declareren we de afhankelijkheid van de echo-service:
  trait EchoClientConfig[A] {
    def testMessage: String = "test"
    def pollInterval: FiniteDuration
    def echoServiceDependency: HttpSimpleGetEndPoint[_, EchoProtocol[A]]
  }
De afhankelijkheid heeft hetzelfde type als de geëxporteerde service echoService. In het bijzonder vereisen we in de echo-cliënte dezelfde protcol. Daarom kunnen we er bij het verbinden van twee services zeker van zijn dat alles correct zal werken.
Implementatie van services
Voor het starten en stoppen van de service is een functie vereist. (De mogelijkheid om de service te stoppen is van cruciaal belang voor testen.) Er zijn opnieuw verschillende manieren om zo'n functie te implementeren (bijvoorbeeld, we zouden typeklassen op basis van het type configuratie kunnen gebruiken). Voor de doeleinden van dit bericht gebruiken we het Cake Pattern. We zullen de service weergeven met behulp van de klasse cats.Resource, aangezien deze klasse al middelen biedt voor veilige, gegarandeerde vrijgave van middelen in geval van problemen. Om middelen te verkrijgen, moeten we de configuratie en de gereed runtime-context verstrekken. De functie voor het starten van de service kan er als volgt uitzien:
  type ResourceReader[F[_], Config, A] = Reader[Config, Resource[F, A]]

  trait ServiceImpl[F[_]] {
    type Config
    def resource(
      implicit
      resolver: AddressResolver[F],
      timer: Timer[F],
      contextShift: ContextShift[F],
      ec: ExecutionContext,
      applicative: Applicative[F]
    ): ResourceReader[F, Config, Unit]
  }
waar
Config— configuratietype voor deze serviceAddressResolver— runtime-object dat de adressen van andere knooppunten kan opvragen (zie verderop)
en andere types uit de bibliotheek cats:
F[_]— type effect (in de eenvoudigste vormF[A]kan het gewoon een functie zijn() => A. In deze post zullen we gebruikmaken vancats.IO.)Reader[A,B]— min of meer een synoniem voor functieA => Bcats.Resource— een resource die kan worden verkregen en vrijgegevenTimer— timer (maakt het mogelijk om een bepaalde tijd te wachten en tijdsintervallen te meten)ContextShift— analogonExecutionContextApplicative— effecttypeklasse die het combineren van afzonderlijke effecten mogelijk maakt (vrijwel een monade). In complexere toepassingen is het waarschijnlijk beter omMonad/ConcurrentEffect.
Met deze functiehandtekening kunnen we verschillende services implementeren. Bijvoorbeeld, een service die niets doet:
  trait ZeroServiceImpl[F[_]] extends ServiceImpl[F] {
    type Config  Resource.pure[F, Unit](())
  }
(Zie , waarin andere services zijn geïmplementeerd — ,
en .)
Een knooppunt is een object dat meerdere services kan starten (de initiatie van de resource-chain wordt verzekerd door middel van het Cake Pattern):
object SingleNodeImpl extends ZeroServiceImpl[IO]
  with EchoServiceService
  with EchoClientService
  with FiniteDurationLifecycleServiceImpl
{
  type Config = EchoConfig[String] with EchoClientConfig[String] with FiniteDurationLifecycleConfig
}
Let op dat we het exacte type configuratie opgeven dat nodig is voor dit knooppunt. Als we vergeten om een van de configuratietypes die door een afzonderlijke service vereist worden, op te geven, krijgt men een compilatiefout. Ook kunnen we het knooppunt niet starten als we geen object met het juiste type en alle benodigde gegevens aanleveren.
Resolutie van knooppuntnamen
Om verbinding te maken met een extern knooppunt hebben we een echt IP-adres nodig. Het is heel goed mogelijk dat het adres later bekend wordt dan de andere configuratie-onderdelen. Daarom hebben we een functie nodig die de knooppunt-id naar een adres afbeeldt:
case class NodeAddress[NodeId](host: Uri.Host)
trait AddressResolver[F[_]] {
  def resolve[NodeId](nodeId: NodeId): F[NodeAddress[NodeId]]
}
Er zijn verschillende manieren om zo'n functie te implementeren:
- Als de adressen voor de uitrol bekend zijn, kunnen we Scala-code genereren met
adressen en vervolgens de build uitvoeren. Daarbij zal compilatie plaatsvinden en worden tests uitgevoerd.
In dit geval zal de functie statisch bekend zijn en kan deze in de code worden weergegeven als een weergave.Map[NodeId, NodeAddress]. - In sommige gevallen wordt het werkelijke adres pas bekend nadat de node is gestart.
In dit geval kunnen we een "detectiedienst" (discovery) implementeren die wordt gestart voordat de andere nodes, waarbij alle nodes zich registreren in deze dienst en adresinformatie opvragen van andere nodes. - Als we kunnen modificeren
/etc/hosts, kunnen we vooraf gedefinieerde hostnamen gebruiken (zoalsmy-project-main-nodeenecho-backend) en deze namen eenvoudig koppelen
aan IP-adressen tijdens de uitrol.
In deze post zullen we deze gevallen niet verder behandelen. Voor ons
speelvoorbeeld zullen alle nodes één IP-adres hebben — 127.0.0.1.
Laten we twee varianten van een gedistribueerd systeem bekijken:
- Alle services op één node plaatsen.
- En de echo-service en echo-client op verschillende nodes plaatsen.
Configuratie voor :
Configuratie voor één node
object SingleNodeConfig extends EchoConfig[String]
  met EchoClientConfig[String] met FiniteDurationLifecycleConfig
{
  case object Singleton \/\/ identifier van de enkele node
  \/\/ configuratie van de server
  type NodeId = Singleton.type
  def nodeId = Singleton

  \/** Type veilige servicepoort specificatie. *\/
  override def portNumber: PortNumber = 8088

  \/\/ configuratie van de client

  \/** We zullen de service gebruiken die door dezelfde host wordt aangeboden. *\/
  def echoServiceDependency = echoService

  override def testMessage: UrlPathElement = "hallo"

  def pollInterval: FiniteDuration = 1.second

  \/\/ lifecycle controller configuratie
  def lifetime: FiniteDuration = 10500.milliseconds \/\/ extra 0.5 seconden zodat er 10 aanvragen zijn, niet 9.
}
Dit object implementeert de configuratie voor zowel de client als de server. Daarnaast wordt configuratie van de levensduur gebruikt om de programmatuur na een interval af te sluiten. levensduur af te sluiten. (Ctrl-C werkt ook en geeft alle middelen correct vrij.)
Dezelfde set traits van configuraties en implementaties kan worden gebruikt om een systeem te creëren dat bestaat uit :
Configuratie voor twee nodes
  object NodeServerConfig extends EchoConfig[String] with SigTermLifecycleConfig
  {
    type NodeId = NodeIdImpl

    def nodeId = NodeServer

    override def portNumber: PortNumber = 8080
  }

  object NodeClientConfig extends EchoClientConfig[String] with FiniteDurationLifecycleConfig
  {
    \/\/ NB! specificatie van afhankelijkheid
    def echoServiceDependency = NodeServerConfig.echoService

    def pollInterval: FiniteDuration = 1.second

    def lifetime: FiniteDuration = 10500.milliseconds \/\/ extra 0.5 seconden zodat er 10 aanvragen zijn, niet 9.

    def testMessage: String = "dolly"
  }
Belangrijk! Let op hoe de koppeling van services wordt uitgevoerd. We geven de service aan die door één knoop wordt geïmplementeerd als de implementatie van de afhankelijkheidsmethode van een andere knoop. Het type afhankelijkheid wordt gecontroleerd door de compiler, omdat het het protocoltype bevat. Bij de uitvoering zal de afhankelijkheid een geldige ID van de doelknop bevatten. Dankzij deze opzet geven we het poortnummer precies één keer op en refereren we altijd gegarandeerd naar de juiste poort.
Implementatie van twee knopen van het systeem
Voor deze configuratie gebruiken we dezelfde implementaties van services zonder wijzigingen. Het enige verschil is dat we nu twee objecten hebben die verschillende sets van services implementeren:
  object TwoJvmNodeServerImpl extends ZeroServiceImpl[IO] met EchoServiceService met SigIntLifecycleServiceImpl {
    type Config = EchoConfig[String] met SigTermLifecycleConfig
  }

  object TwoJvmNodeClientImpl extends ZeroServiceImpl[IO] met EchoClientService met FiniteDurationLifecycleServiceImpl {
    type Config = EchoClientConfig[String] met FiniteDurationLifecycleConfig
  }
De eerste knoop implementeert de server en heeft alleen serverconfiguratie nodig. De tweede knoop implementeert de client en gebruikt een ander deel van de configuratie. Beide knopen hebben ook tijdbeheer nodig. De serverknop werkt onbeperkt, totdat deze wordt gestopt, SIGTERMterwijl de clientknop na enige tijd wordt beëindigd. Zie. .
Algemeen ontwikkelingsproces
Laten we eens kijken hoe deze aanpak voor configuratie invloed heeft op het algemene ontwikkelingsproces.
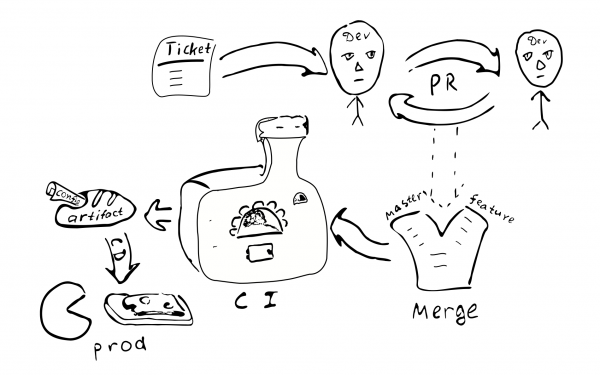
De configuratie zal samen met de rest van de code worden gecompileerd en er zal een artefact (.jar) worden gegenereerd. Het lijkt logisch om de configuratie in een apart artefact te plaatsen. Dit komt omdat we meerdere configuraties kunnen hebben op basis van dezelfde code. Nogmaals, het is mogelijk om artefacten te genereren die overeenkomen met verschillende configuratievertakkingen. Samen met de configuratie worden de afhankelijkheden van specifieke bibliotheekversies opgeslagen, en deze versies worden voorgoed bewaard, wat er ook gebeurt met de implementatie van deze specifieke configuratieversie.
Elke wijziging van de configuratie leidt tot een wijziging van de code. En dus zal elke dergelijke
wijziging worden opgenomen in het gebruikelijke kwaliteitsborgingsproces:
Ticket in de bugtracker -> PR -> beoordeling -> samensmelting met de bijbehorende takken ->
integratie -> implementatie
Belangrijkste gevolgen van de invoering van compileerbare configuraties:
De configuratie wordt op alle knooppunten van het gedistribueerde systeem afgestemd. Aangezien alle knooppunten dezelfde configuratie uit een enkele bron ontvangen.
Het is problematisch om de configuratie alleen op één van de knooppunten te wijzigen. Daarom is 'configuratie-afwijking' (configuration drift) onwaarschijnlijk.
Het wordt moeilijker om kleine wijzigingen in de configuratie aan te brengen.
De meeste configuratiewijzigingen zullen plaatsvinden binnen het algemene ontwikkelingsproces en zullen onderworpen zijn aan review.
Is er een aparte repository nodig voor het opslaan van de productieconfiguratie? In zo'n configuratie kunnen wachtwoorden en andere geheime informatie zitten waarvoor we de toegang willen beperken. Gezien dit, lijkt het logisch om de uiteindelijke configuratie in een aparte repository op te slaan. De configuratie kan in twee delen worden verdeeld: een deel met openbare configuratieparameters en een ander deel met parameters met beperkte toegang. Dit stelt de meeste ontwikkelaars in staat om toegang te hebben tot de algemene parameters. Deze scheiding is eenvoudig te bereiken door tussenliggende trait's te gebruiken met standaardwaarden.
Mogelijke variaties
Laten we proberen de gecompileerde configuratie te vergelijken met enkele veelvoorkomende alternatieven:
- Een tekstbestand op de doelsystemen.
- Centralesleutel-waardeopslag (
etcd/zookeeper). - Componenten van het proces die opnieuw geconfigureerd/geherstart kunnen worden zonder het proces opnieuw te starten.
- Configuratie opslaan buiten artefacten en versiebeheer.
Tekstbestanden bieden aanzienlijke flexibiliteit voor kleine wijzigingen. Een systeembeheerder kan inloggen op een extern knooppunt, wijzigingen in de betreffende bestanden aanbrengen en de service opnieuw starten. Voor grote systemen kan deze flexibiliteit echter ongewenst zijn. Er blijven geen sporen van de aangebrachte wijzigingen in andere systemen. Niemand voert een review van de wijzigingen uit. Het is moeilijk vast te stellen wie de wijzigingen heeft aangebracht en om welke reden. Wijzigingen worden niet getest. Als het systeem gedistribueerd is, kan de beheerder vergeten om de overeenkomstige wijziging op andere knooppunten aan te brengen.
(Daarnaast dient opgemerkt te worden dat het gebruik van een gecompileerde configuratie de mogelijkheid om in de toekomst tekstbestanden te gebruiken niet uitsluit. Het is voldoende om een parser en validator toe te voegen die hetzelfde type uitvoert, Config, en dan kunnen we tekstbestanden gebruiken. Hieruit volgt direct dat de complexiteit van een systeem met een gecompileerde configuratie iets minder is dan de complexiteit van een systeem dat tekstbestanden gebruikt, aangezien extra code nodig is voor tekstbestanden.)
Een gecentraliseerde sleutel-waarde opslag is een goed mechanisme voor het distribueren van meta-parameters van een gedistribueerde applicatie. We moeten duidelijk maken wat configuratieparameters zijn en wat gewoon gegevens zijn. Stel dat we de functie hebben C => A => B, waarbij de parameters C zeldzaam veranderen, en gegevens A — vaak. In dit geval kunnen we zeggen dat C — configuratieparameters zijn, terwijl A — gegevens zijn. Het lijkt erop dat configuratieparameters zich onderscheiden van gegevens doordat ze in het algemeen minder vaak veranderen dan gegevens. Ook komen gegevens meestal uit één bron (van de gebruiker), terwijl configuratieparameters uit een andere bron (van de systeembeheerder) komen.
Als parameters die zelden veranderen moeten worden bijgewerkt zonder de applicatie opnieuw op te starten, kan dit vaak leiden tot een verhoging van de complexiteit van de applicatie, omdat we op de een of andere manier deze parameters moeten leveren, opslaan, parseren en valideren, en onjuiste waarden verwerken. Daarom, vanuit het oogpunt van het verlagen van de complexiteit van de applicatie, is het zinvol om het aantal parameters dat kan veranderen tijdens de werking van de applicatie te verminderen (of dergelijke parameters helemaal niet te ondersteunen).
In dit bericht zullen we statische en dynamische parameters onderscheiden. Als de logica van de service vereist dat parameters tijdens de uitvoering van het programma worden gewijzigd, noemen we deze parameters dynamisch. In andere gevallen zijn de parameters statisch en kunnen ze worden geconfigureerd met behulp van een compileerbare configuratie. Voor dynamische reconfiguratie hebben we mogelijk een mechanisme nodig om delen van het programma opnieuw te starten met nieuwe parameters, vergelijkbaar met hoe processen van het besturingssysteem worden opnieuw opgestart. (Naar onze mening is het wenselijk om reconfiguratie in real-time te vermijden, omdat dit de complexiteit van het systeem verhoogt. Indien mogelijk is het beter om gebruik te maken van de standaardmogelijkheden van het besturingssysteem voor het opnieuw starten van processen.)
Een van de belangrijke aspecten van het gebruik van statische configuratie, dat mensen ertoe aanzet om dynamische reconfiguratie te overwegen, is de tijd die het systeem nodig heeft om opnieuw op te starten na het bijwerken van de configuratie (downtime). Inderdaad, als we wijzigingen in de statische configuratie moeten aanbrengen, moeten we het systeem opnieuw opstarten om de nieuwe waarden van kracht te laten worden. Het probleem van downtime heeft verschillende urgentie voor verschillende systemen. In sommige gevallen kan de herstart worden gepland op een tijdstip wanneer de belasting minimaal is. In het geval dat continue service moet worden gewaarborgd, kan het worden geïmplementeerd . Wanneer we het systeem moeten herstarten, starten we een parallelle instantie van dat systeem, schakelen we de load balancer naar die instantie en wachten we tot oude verbindingen zijn beëindigd. Nadat alle oude verbindingen zijn beëindigd, schakelen we de oude instantie van het systeem uit.
Laten we nu eens kijken naar de kwestie van het opslaan van configuratie binnen of buiten het artifact. Als we de configuratie binnen het artifact opslaan, hebben we op zijn minst de mogelijkheid gehad om tijdens de bouw van het artifact de correctheid van de configuratie te verifiëren. In het geval dat de configuratie buiten het gecontroleerde artifact staat, is het moeilijk om te traceren wie en waarom wijzigingen in dit bestand heeft aangebracht. Hoe belangrijk is dit? Naar onze mening is het voor veel productie-systemen belangrijk om een stabiele en hoogwaardige configuratie te hebben.
De versie van het artefact maakt het mogelijk om te bepalen wanneer het is gemaakt, welke waarden het bevat, welke functies zijn ingeschakeld of uitgeschakeld, en wie verantwoordelijk is voor enige wijziging in de configuratie. Uiteraard vereist het opslaan van de configuratie binnen het artefact enige inspanning, dus moet er een weloverwogen beslissing worden genomen.
Voor- en nadelen
Ik wil graag stilstaan bij de plus- en minpunten van de aangeboden technologie.
Voordelen
Hieronder volgt een lijst met de belangrijkste mogelijkheden van de gecompileerde configuratie van het gedistribueerde systeem:
- Statische configuratiecontrole. Zorgt ervoor dat
de configuratie correct is. - Rijke configuratietaal. Gewoonlijk zijn andere configuratiemethoden beperkt tot het vervangen van stringvariabelen. Bij het gebruik van Scala wordt een breed scala aan mogelijkheden van de taal beschikbaar om de configuratie te verbeteren. Bijvoorbeeld, we kunnen gebruikmaken van
traits voor standaardwaarden, om parameters te groeperen met behulp van objecten, en we kunnen verwijzen naar val-waarden die één keer zijn gedeclareerd (DRY) binnen de omringende scope. We kunnen zelfs rechtstreeks binnen de configuratie instantiëren welke klassen dan ook (Seq,Map, aangepaste klassen). - DSL. In Scala zijn er verschillende taalcapaciteiten die het creëren van DSL vergemakkelijken. We kunnen deze mogelijkheden aangrijpen en een configuratietaal implementeren die gebruiksvriendelijker is voor de doelgroep, zodat de configuratie minstens leesbaar is voor domeinexperts. Experts kunnen bijvoorbeeld deelnemen aan het reviewproces van de configuratie.
- Integriteit en synchronisatie tussen knooppunten. Een van de voordelen van het opslaan van de configuratie van een heel gedistribueerd systeem op één centrale plek is dat alle waarden precies één keer worden gedeclareerd en vervolgens overal hergebruikt waar ze nodig zijn. Het gebruik van phantom types voor het declareren van poorten garandeert dat in alle geldige configuraties van het systeem de knooppunten compatibele protocollen gebruiken. Het hebben van expliciete verplichte afhankelijkheden tussen knooppunten verzekert dat alle diensten met elkaar zijn verbonden.
- Hoge kwaliteit van wijzigingen. Wijzigingen in de configuratie, met behulp van een gedeeld ontwikkelingsproces, maken hoge kwaliteitsnormen ook voor de configuratie beschikbaar.
- Gelijktijdige configuratie-updates. Automatische implementatie van het systeem na wijzigingen in de configuratie garandeert dat alle knooppunten worden bijgewerkt.
- Vereenvoudiging van de applicatie. De applicatie heeft geen parsering, configuratiecontrole en verwerking van ongeldige waarden nodig. Dit vermindert de complexiteit van de applicatie. (Bepaalde complicaties in de configuratie die we in ons voorbeeld zien, zijn geen kenmerk van de gecompileerde configuratie, maar zijn alleen een bewuste beslissing, voortkomend uit de wens om grotere typeveiligheid te waarborgen.) Het is relatief eenvoudig om terug te keren naar de standaardconfiguratie — voer gewoon de ontbrekende delen uit. Daarom kan men bijvoorbeeld beginnen met een gecompileerde configuratie, terwijl de implementatie van overbodige delen kan worden uitgesteld tot het moment dat het echt nodig is.
- Geverseerde configuratie. Aangezien configuratiewijzigingen hetzelfde lot ondergaan als andere wijzigingen, krijgen we een artifact met een unieke versie. Dit stelt ons in staat om bijvoorbeeld terug te keren naar een vorige versie van de configuratie indien nodig. We kunnen zelfs een configuratie van een jaar oud gebruiken en het systeem zal precies hetzelfde functioneren. Een stabiele configuratie verbetert de voorspelbaarheid en betrouwbaarheid van het gedistribueerde systeem. Aangezien de configuratie is vastgelegd op het moment van compilatie, is het relatief moeilijk om deze in productie te vervalsen.
- Modulariteit. Het voorgestelde framework is modulair, en modules kunnen in verschillende combinaties worden samengevoegd om verschillende systemen te creëren. In het bijzonder kan er in één configuratie een systeem voor één knooppunt worden ingericht, terwijl het in een andere configuratie voor meerdere knooppunten kan worden ingesteld. Het is mogelijk om verschillende configuraties voor productie-exemplaren van het systeem te creëren.
- Testing. Door specifieke services te vervangen door mock-objects, kunnen meerdere versies van het systeem worden verkregen die handig zijn voor testing.
- Integratietesten. Het hebben van één enkele configuratie voor het volledige gedistribueerde systeem maakt het mogelijk om alle componenten te draaien in een gecontroleerde omgeving als onderdeel van integratietesten. Het is eenvoudig om bijvoorbeeld een situatie te emuleren waarin sommige knooppunten niet bereikbaar zijn.
Nadelen en beperkingen
Een gecompileerde configuratie verschilt van andere configuratiebenaderingen en is mogelijk niet geschikt voor sommige toepassingen. Hieronder volgen enkele nadelen:
- Statistische configuratie. Soms is het nodig om de configuratie snel aan te passen in de productieomgeving, waarbij alle beschermingsmechanismen worden omzeild. In het kader van deze aanpak kan dit ingewikkelder zijn. Tenminste compilatie en automatische implementatie zijn nog steeds vereist. Dit is zowel een nuttig kenmerk van de aanpak als een nadeel in sommige gevallen.
- Generatie van configuratie. Indien het configuratiebestand door een automatisch instrument wordt gegenereerd, kunnen extra inspanningen voor de integratie van het build-script nodig zijn.
- Hulpmiddelen. Momenteel zijn de tools en methoden voor het werken met configuratie gebaseerd op tekstbestanden. Niet alle dergelijke tools/methoden zullen beschikbaar zijn in het geval van een gecompileerde configuratie.
- Verandering van perspectief vereist. Ontwikkelaars en DevOps zijn gewend aan tekstbestanden. Het idee van de compilatie van configuratie kan wat onverwacht en ongebruikelijk zijn en kan weerstand oproepen.
- Een hoogwaardig ontwikkelingsproces is vereist. Om comfortabel te kunnen werken met een gecompileerde configuratie is volledige automatisering van het build- en implementatieproces (CI/CD) noodzakelijk. Anders zal het ongemakkelijk zijn.
Laten we ook een aantal beperkingen van het besproken voorbeeld bekijken die niet gerelateerd zijn aan het idee van gecompileerde configuratie:
- Als we onnodige configuratie-informatie verstrekken die door het knooppunt niet wordt gebruikt, zal de compiler ons niet helpen om het ontbreken van implementatie te ontdekken. Dit probleem kan worden opgelost door het Cake Pattern los te laten en strengere types te gebruiken, bijvoorbeeld
HListof algebraïsche datatypes (case classes) om de configuratie weer te geven. - In het configuratiebestand zijn er regels die niet specifiek gerelateerd zijn aan de configuratie: (
package,import, objectdeclaraties;override defvoor parameters met standaardwaarden). Dit kan gedeeltelijk worden vermeden door je eigen DSL te implementeren. Bovendien leggen andere soorten configuratie (zoals XML) ook bepaalde beperkingen op aan de bestandsstructuur. - In dit bericht behandelen we de dynamische herconfiguratie van een cluster van soortgelijke knooppunten niet.
Conclusie
In dit bericht hebben we het idee besproken om configuratie in de broncode weer te geven met behulp van de geavanceerde mogelijkheden van het type-systeem van Scala. Deze aanpak kan in verschillende toepassingen worden gebruikt als vervanging voor traditionele configuratiemethoden op basis van XML- of tekstbestanden. Hoewel ons voorbeeld in Scala is geïmplementeerd, kunnen dezelfde ideeën worden overgebracht naar andere gecompileerde talen (zoals Kotlin, C#, Swift, …). Deze aanpak kan worden getest in een van de volgende projecten en, als het niet geschikt blijkt, kan er worden overgestapt naar tekstbestanden, waarbij de ontbrekende details worden toegevoegd.
Natuurlijk vereist gecompileerde configuratie een hoogwaardig ontwikkelproces. In ruil daarvoor zorgt het voor hoge kwaliteit en betrouwbaarheid van configuraties.
De besproken aanpak kan worden uitgebreid:
- Macros kunnen worden gebruikt om controles tijdens de compilatie uit te voeren.
- Er kan een DSL worden geïmplementeerd voor de weergave van configuratie in een toegankelijke vorm voor eindgebruikers.
- Dynamisch resourcebeheer kan worden geïmplementeerd met automatische aanpassing van de configuratie. Bijvoorbeeld, wanneer het aantal knooppunten in een cluster verandert, moet (1) elk knooppunt een iets andere configuratie krijgen; (2) moet de clusterbeheerder op de hoogte worden gesteld van de nieuwe knooppunten.
Waardering
Ik wil Andrey Saksonov, Pavel Popov en Anton Nekhaev bedanken voor hun constructieve kritiek op de conceptversie van het artikel.
Bron: habr.com
