

Platform maakt het mogelijk om de creatie op gang te brengen , inclusief in de infrastructuur van cloudproviders, op virtualisatieplatforms of in bare-metal systemen. Om in de volle zin van het woord een cloudplatform te creëren, moesten we alle toegepaste elementen strenger onder controle nemen en zo de betrouwbaarheid van het complexe automatiseringsproces verhogen.
Een voor de hand liggende oplossing was het gebruik van Red Hat Enterprise Linux CoreOS (een variant van Red Hat Enterprise Linux) en CRI-O als standaard, en hier is waarom...
Aangezien de maritieme thematiek bijzonder geschikt is voor het vinden van analogieën bij het uitleggen van hoe Kubernetes en containers werken, laten we de zakelijke problemen die CoreOS en CRI-O oplossen, illustreren aan de hand van het voorbeeld . In 1803 kreeg Mark Brunel de opdracht om 100.000 takels te vervaardigen voor de behoeften van de groeiende Britse zeeflott. Een takel is een type tuigage dat wordt gebruikt om touwen aan zeilen te bevestigen. Tot het begin van de 19e eeuw werden deze takels handmatig gemaakt, maar Brunel slaagde erin om de productie te automatiseren en gestandaardiseerde takels te vervaardigen met behulp van machines. Automatisering van dit proces betekende dat alle takels vrijwel identiek waren, gemakkelijk konden worden vervangen in geval van een storing en in grote hoeveelheden konden worden geproduceerd.
Stel je nu voor dat Brunel dit werk voor 20 verschillende modellen schepen (versies van Kubernetes) en voor vijf verschillende planeten met volledig verschillende zeestromingen en winden (cloudproviders) had moeten doen. Bovendien was het noodzakelijk dat alle schepen (OpenShift-clusters), ongeacht de planeten waarop ze navigeerden, zich vanuit het perspectief van de kapiteins (operators die de clusterwerking beheren) op dezelfde manier gedroegen. Om de maritieme analogie voort te zetten, maakt het de kapiteins van de schepen helemaal niet uit welke takels (CRI-O) op hun schepen worden gebruikt – voor hen is het belangrijkste dat deze takels sterk en betrouwbaar zijn.
Voor OpenShift 4, als cloudplatform, staat een vergelijkbare zakelijke uitdaging. Nieuwe knooppunten moeten worden aangemaakt op het moment dat het cluster wordt opgezet, in geval van een storing in een van de knooppunten, of bij het schalen van het cluster. Bij het maken en initialiseren van een nieuw knooppunt moeten ook de kritische hostcomponenten, waaronder CRI-O, correct worden geconfigureerd. Net als in elke andere productie, moet in het begin 'grondstof' worden aangeleverd. In het geval van schepen vormen metaal en hout de grondstoffen. Maar bij het creëren van een host voor het implementeren van containers in het OpenShift 4-cluster, moeten er configuratiebestanden en aangeboden API-servers voorhanden zijn. Daarna zal OpenShift zorgen voor het benodigde niveau van automatisering gedurende de hele levenscyclus, waarbij het de noodzakelijke productondersteuning voor eindgebruikers biedt en op die manier de investeringen in het platform terugverdient.
OpenShift 4 is zo ontworpen dat het eenvoudig kan worden bijgewerkt gedurende de hele levenscyclus van het platform (voor versies 4.X) voor alle grote cloudproviders, virtualisatieplatforms en zelfs bare metal-systemen. Hiervoor moeten knooppunten worden aangemaakt op basis van vervangbare elementen. Wanneer het cluster een nieuwe versie van Kubernetes vereist, ontvangt het ook de bijbehorende versie van CRI-O op CoreOS. Aangezien de versie van CRI-O direct aan Kubernetes is gekoppeld, vergemakkelijkt dit in belangrijke mate de herindelingen voor test-, foutopsporings- of ondersteuningsdoeleinden. Bovendien maakt deze aanpak het mogelijk om de kosten voor eindgebruikers en Red Hat te verlagen.
Dit is een fundamenteel nieuwe kijk op Kubernetes-clusters, die de basis legt voor het plannen van nieuwe zeer nuttige en aantrekkelijke functies. CRI-O (het project van de Open Container Initiative — Container Runtime Interface, kortweg CRI-OCI) is de meest geschikte keuze gebleken voor de massale uitrol van knooppunten die nodig zijn voor het werken met OpenShift. CRI-O zal de eerder gebruikte Docker-engine vervangen en biedt OpenShift-gebruikers – ja, u heeft het goed gehoord – saaie containerengine, speciaal ontworpen voor gebruik met Kubernetes.
De wereld van open containers
De wereld beweegt al lang naar open containers. Of het nu in Kubernetes is of op lagere niveaus, leidt tot een ecosysteem van innovaties op elk niveau.
Alles begon met de oprichting van de Open Containers Initiative In deze vroege fase werden de specificaties voor container- en Dit zorgde ervoor dat tools een enkele standaard konden gebruiken en een uniform formaat voor het werken met hen. Later werden specificaties toegevoegd voor waardoor gebruikers eenvoudig containerbeelden konden uitwisselen. .
de Container Runtime Interface (CRI). Ingenieurs van Red Hat en Google zagen een bestaande behoefte op de markt voor een containerengine die verzoeken van Kubelet via het CRI-protocol kon accepteren en introduceerden containers die compatibel waren met de bovengenoemde OCI-specificaties. Zo
ontstond OCID. van versie 1.0 Figuur 1.
Innovaties met CRI-O en CoreOS.
Met de lancering van het OpenShift 4-platform werd de
containerengine Wacht, hoe zit dat?
Juist zo, met de komst van OpenShift 4 is het nu niet meer nodig om verbinding te maken met afzonderlijke hosts en de containerengine te installeren, opslag te configureren, servers in te stellen voor zoeken of netwerken te configureren. Het OpenShift 4-platform is volledig herzien om gebruik te maken van de
Operator Framework. niet alleen vanuit het perspectief van eindgebruikersapplicaties, maar ook vanuit het perspectief van basisoperaties op platformniveau, zoals het implementeren van images, het configureren van het systeem of het installeren van updates.
Kubernetes heeft gebruikers altijd in staat gesteld om applicaties te beheren door de gewenste staat te definiëren en , om ervoor te zorgen dat de werkelijke staat in maximale overeenstemming is met de gedefinieerde staat. Deze biedt grote mogelijkheden vanuit zowel ontwikkelings- als operationeel perspectief. Ontwikkelaars kunnen de vereiste staat definiëren, aan de operator in de vorm van een YAML- of JSON-bestand, waarna de operator de noodzakelijke instantie van de applicatie in de operationele omgeving kan creëren, waarbij de status van deze instantie volledig overeenkomt met de gedefinieerde.
Door gebruik te maken van operators binnen het platform breng OpenShift 4 dit nieuwe paradigma (met gebruik van het concept van gedefinieerde en werkelijke staten) in het beheer van RHEL CoreOS en CRI-O. Taken zoals configuratie en versiebeheer van het besturingssysteem en de containerengine worden geautomatiseerd met behulp van de zogenaamde . MCO vereenvoudigt het werk van de clusterbeheerder aanzienlijk, door in feite de laatste stappen van de installatie te automatiseren, evenals de daaropvolgende operaties na de installatie (day two operations). Dit alles maakt van OpenShift 4 een echte cloudplatform. Hier zullen we later verder op ingaan.
Containeruitvoering
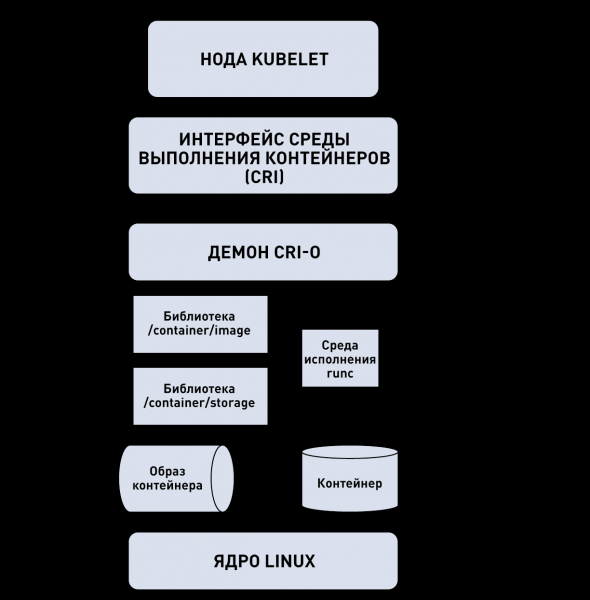
Gebruikers hadden de mogelijkheid om de CRI-O-engine in het OpenShift-platform te gebruiken vanaf versie 3.7 in de status Tech Preview en vanaf versie 3.9 in de status Generally Available (momenteel ondersteund). Bovendien maakt Red Hat op grote schaal gebruik van in OpenShift Online vanaf versie 3.10. Dit alles heeft het team dat aan CRI-O werkt, in staat gesteld om enorme ervaring op te doen met het grootschalig draaien van containers op grote Kubernetes-clusters. Voor een basisinzicht in hoe Kubernetes CRI-O gebruikt, laten we de volgende illustratie bekijken, die het principe van de architectuur laat zien.
Figuur 2. Hoe containers werken in een Kubernetes-cluster
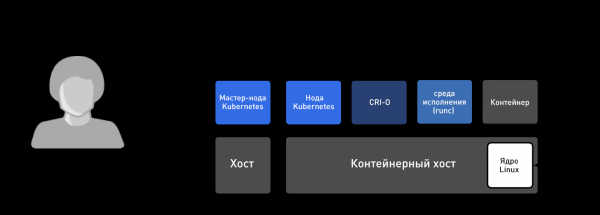
CRI-O vereenvoudigt het creëren van nieuwe containerhosts door synchronisatie van het volledige bovenste niveau bij de initialisatie van nieuwe knooppunten en bij de uitgave van nieuwe versies van het OpenShift-platform. Het herzien van het volledige platform stelt transactionele updates / terugrollingen mogelijk, en voorkomt ook deadlocks in afhankelijkheden tussen de containerhostkernel, de containerengine, de knooppunten (Kubelets) en de Kubernetes Master-knoop. Met gecentraliseerd beheer van alle componenten van het platform, inclusief versiecontrole en -beheer, kan er altijd een duidelijke route van staat A naar staat B worden gevolgd. Dit vereenvoudigt het updateproces, verhoogt de veiligheid, verbetert de rapportage van prestaties en helpt de kosten van updates en installatie van nieuwe versies te verlagen.
Demonstratie van de kracht van verwisselbare componenten
Zoals eerder vermeld, biedt het gebruik van de Machine Config Operator voor het beheren van de containerhost en de containerengine in OpenShift 4 een nieuw niveau van automatisering dat eerder niet mogelijk was op het Kubernetes-platform. Om de nieuwe mogelijkheden te demonstreren, laten we zien hoe je wijzigingen in het bestand crio.conf kunt aanbrengen. Probeer je te concentreren op de resultaten om in de terminologie niet verward te raken.
Laten we beginnen met het creëren van wat een container-runtimeconfiguratie wordt genoemd – Container Runtime Config. Beschouw dit als een Kubernetes-resource die de configuratie voor CRI-O vertegenwoordigt. In werkelijkheid is dit een gespecialiseerde versie van wat MachineConfig wordt genoemd, dat elke configuratie vertegenwoordigt die op een RHEL CoreOS-machine in een OpenShift-cluster wordt uitgerold.
Deze aangepaste resource, die ContainerRuntimeConfig wordt genoemd, is ontworpen om clusterbeheerders te helpen bij het configureren van CRI-O. Het is een krachtig hulpmiddel dat alleen kan worden toegepast op bepaalde knooppunten, afhankelijk van de instellingen van MachineConfigPool. Beschouw dit als een groep machines die voor hetzelfde doel dienen.
Let op de laatste twee regels die we gaan wijzigen in het bestand /etc/crio/crio.conf. Deze twee regels lijken veel op de regels in het bestand crio.conf, namelijk:
vi ContainerRuntimeConfig.yaml
Uitvoer:
apiVersion: machineconfiguration.openshift.io/v1
kind: ContainerRuntimeConfig
metadata:
 name: set-log-and-pid
spec:
 machineConfigPoolSelector:
   matchLabels:
     debug-crio: config-log-and-pid
 containerRuntimeConfig:
   pidsLimit: 2048
   logLevel: debug
Nu zullen we dit bestand naar de Kubernetes-cluster sturen en controleren of het daadwerkelijk is aangemaakt. Let op, de werkwijze is precies hetzelfde als voor elke andere Kubernetes-resource:
oc create -f ContainerRuntimeConfig.yaml
oc get ContainerRuntimeConfig
Uitvoer:
NAAM              LEEFTIJD
set-log-and-pid   22u
Nadat we de ContainerRuntimeConfig hebben gemaakt, moeten we een van de MachineConfigPools wijzigen om Kubernetes te laten weten dat we deze configuratie op een bepaalde groep machines in de cluster willen toepassen. In dit geval zullen we de MachineConfigPool voor de master-nodes wijzigen:
oc edit MachineConfigPool/master
Uitvoer (voor de duidelijkheid is de essentie behouden):
...
metadata:
 creationTimestamp: 2019-04-10T23:42:28Z
 generation: 1
 labels:
   debug-crio: config-log-and-pid
   operator.machineconfiguration.openshift.io/required-for-upgrade: ""
...
Op dit moment begint de MCO een nieuw bestand crio.conf voor de cluster aan te maken. Het voltooide configuratiebestand kan worden bekeken via de Kubernetes API. Houd er rekening mee dat ContainerRuntimeConfig alleen een gespecialiseerde versie van MachineConfig is, daarom kunnen we het resultaat zien door naar de benodigde regels in MachineConfigs te kijken:
oc get MachineConfigs | grep rendered
Uitvoer:
rendered-master-c923f24f01a0e38c77a05acfd631910b                  4.0.22-201904011459-dirty 2.2.0 16u
rendered-master-f722b027a98ac5b8e0b41d71e992f626                  4.0.22-201904011459-dirty 2.2.0 4m
rendered-worker-9777325797fe7e74c3f2dd11d359bc62                  4.0.22-201904011459-dirty 2.2.0 16u
Let op, dat het verkregen configuratiebestand voor de master-nodes een nieuwere versie is dan de oorspronkelijke configuraties. Om deze te bekijken, voert u de volgende opdracht uit. Terzijde, dit is misschien wel een van de beste one-liners in de geschiedenis van Kubernetes:
python3 -c "import sys, urllib.parse; print(urllib.parse.unquote(sys.argv[1]))" $(oc get MachineConfig/rendered-master-f722b027a98ac5b8e0b41d71e992f626 -o YAML | grep -B4 crio.conf | grep source | tail -n 1 | cut -d, -f2) | grep pid
Uitvoer:
pids_limit = 2048
Laten we nu controleren of de configuratie op alle master-nodes is toegepast. Eerst krijgen we een lijst van de nodes in de cluster:
oc get node | grep master

Uitvoer:

ip-10-0-135-153.us-east-2.compute.internal   Klaar master 23u v1.12.4+509916ce1

ip-10-0-154-0.us-east-2.compute.internal     Klaar master 23u v1.12.4+509916ce1

ip-10-0-166-79.us-east-2.compute.internal    Klaar master 23u v1.12.4+509916ce1
Laten we nu het geïnstalleerde bestand bekijken. U zult zien dat het bestand is bijgewerkt met de nieuwe waarden voor de pid- en debug-richtlijnen die we hebben opgegeven in de ContainerRuntimeConfig. De elegantie zelf:
oc debug node/ip-10-0-135-153.us-east-2.compute.internal — cat /host/etc/crio/crio.conf | egrep 'debug||pid’
Uitvoer:
...
pids_limit = 2048
...
log_level = "debug"
...
Al deze wijzigingen in het cluster zijn aangebracht zonder SSH uit te voeren. Al het werk is gedaan door te communiceren met de master-node van Kubernetes. Dit betekent dat deze nieuwe parameters alleen zijn geconfigureerd op de master-nodes. De worker-nodes zijn op dat moment niet gewijzigd, wat de voordelen van de Kubernetes-methodologie aantoont met betrekking tot gedefinieerde en actuele toestanden voor containerhosts en container-engines met vervangbare componenten.
Het bovenstaande voorbeeld laat zien dat er wijzigingen kunnen worden aangebracht in een klein cluster van OpenShift Container Platform 4 met drie worker-nodes of in een enorme productiecluster met 3000 nodes. In beide gevallen zal de hoeveelheid werk hetzelfde zijn – en heel klein – het is voldoende om het ContainerRuntimeConfig-bestand te configureren en één label in MachineConfigPool te wijzigen. En je kunt dit doen met elke versie van de gebruikte Kubernetes OpenShift Container Platform 4.X gedurende de hele levenscyclus.
Vaak groeien technologiebedrijven zo snel dat we niet in staat zijn uit te leggen waarom we bepaalde technologieën kiezen voor basiscomponenten. Container-engines waren historisch gezien de component waarmee gebruikers direct interactie hadden. Aangezien de populariteit van containers logisch begon met de opkomst van container-engines, hebben gebruikers vaak interesse in hen. Dit is nog een reden waarom Red Hat heeft gekozen voor CRI-O. Containers evolueren, en de focus ligt tegenwoordig op orkestratie, en we zijn tot de conclusie gekomen dat CRI-O de beste ervaring biedt bij het werken met OpenShift 4.
Bron: habr.com
