

En opnieuw, hallo! De titel van het artikel spreekt voor zich. Voorafgaand aan de start van de cursus stellen we voor om te onderzoeken wie dataverwerkers eigenlijk zijn. In het artikel staan veel nuttige links. Veel leesplezier.
Een eenvoudige gids over hoe je de golf van Data Engineering kunt vangen en niet in de afgrond kunt worden getrokken.
Het lijkt wel alsof tegenwoordig iedereen datascientist (Data Scientist) wil worden. Maar hoe zit het met Data Engineering? In wezen is het een soort hybride tussen data-analist en data-scientist; een data-engineer is doorgaans verantwoordelijk voor het beheer van workflows, verwerkingspijplijnen en ETL-processen. Gezien het belang van deze functies, is het momenteel weer een populaire professionele term die actief aan populariteit wint.
Een hoog salaris en een enorme vraag zijn slechts een klein deel van wat deze baan uiterst aantrekkelijk maakt! Als je je wilt voegen bij de helden, is het nooit te laat om te leren. In deze post heb ik alle nodige informatie verzameld om je te helpen je eerste stappen te zetten.
Laten we beginnen!
Wat is Data Engineering?
Eerlijk gezegd is er geen betere uitleg dan dit:
„Een wetenschapper kan een nieuwe ster ontdekken, maar kan deze niet creëren. Hij zal de ingenieur moeten vragen dit voor hem te doen.”
–Gordon Lindsey Glegg
Dus, de rol van de data-engineer is vrij aanzienlijk.
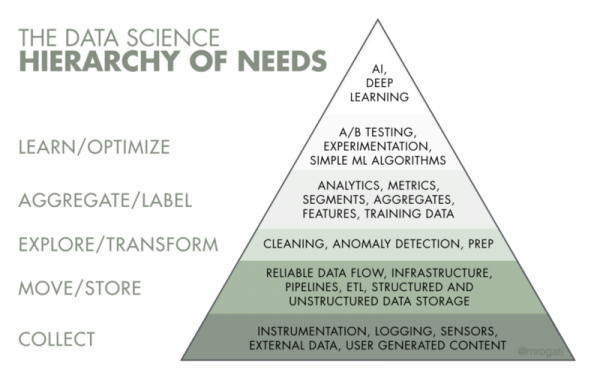
Uit de naam blijkt dat data-engineering gerelateerd is aan data, namelijk hun levering, opslag en verwerking. Dienovereenkomstig is de hoofdfunctie van ingenieurs het waarborgen van een betrouwbare infrastructuur voor data. Als we kijken naar de hiërarchie van behoeften in AI, bevinden de data-engineeringprocessen zich in de eerste 2-3 fasen: verzameling, verplaatsing en opslag, gegevensvoorbereiding.
Waar houdt een data-engineer zich mee bezig?
Met de komst van big data is het verantwoordelijkheidsgebied drastisch veranderd. Waar deze experts vroeger grote SQL-queries schreven en gegevens verwerkten met hulpmiddelen zoals Informatica ETL, Pentaho ETL, Talend, zijn de eisen aan data-engineers 'nu gestegen.
De meeste bedrijven die vacatures hebben voor data-engineers stellen de volgende eisen:
- Uitstekende kennis van SQL en Python.
- Ervaring met cloudplatforms, met name Amazon Web Services.
- Bij voorkeur kennis van Java/Scala.
- Een goed begrip van SQL- en NoSQL-databases (gegevensmodellering, opslag van gegevens).
Houd er rekening mee dat dit alleen het noodzakelijke is. Uit deze lijst kan worden afgeleid dat data-engineers specialisten zijn op het gebied van softwareontwikkeling en back-end.
Als bijvoorbeeld een bedrijf begint met het genereren van een grote hoeveelheid gegevens uit verschillende bronnen, is het jouw taak als data-engineer om de informatieverzameling, verwerking en opslag te organiseren.
De lijst met tools die in dit geval worden gebruikt, kan verschillen, afhankelijk van de hoeveelheid gegevens, de snelheid van binnenkomst en de heterogeniteit. De meeste bedrijven komen helemaal niet in aanraking met grote gegevens, dus als een gecentraliseerde opslag, het zogenaamde datawarehouse, kan een SQL-database (PostgreSQL, MySQL, enz.) worden gebruikt met een kleine set scripts die de gegevens naar de opslag sturen.
IT-giganten zoals Google, Amazon, Facebook of Dropbox stellen hogere eisen: kennis van Python, Java of Scala.
- Ervaring met big data: Hadoop, Spark, Kafka.
- Kennis van algoritmen en datastructuren.
- Begrip van de fundamenten van gedistribueerde systemen.
- Ervaring met datavisualisatietools zoals Tableau of ElasticSearch is een grote plus.
Hieruit blijkt een duidelijke verschuiving naar big data, met name in hun verwerking bij hoge belasting. Deze bedrijven hebben verhoogde eisen aan de systeemweerstand.
Data-engineers versus data-scientists
Oké, dat was een eenvoudige en leuke vergelijking (niets persoonlijks), maar in werkelijkheid is het veel ingewikkelder.
Ten eerste moet je weten dat er veel onduidelijkheid is over de afbakening van de rollen en vaardigheden van data-scientists en data-engineers. Dat betekent dat je gemakkelijk in de war kunt raken over welke vaardigheden nodig zijn voor een succesvolle data-engineer. Natuurlijk zijn er bepaalde vaardigheden die overlappen tussen beide rollen. Maar er zijn ook een aantal diametraal tegenovergestelde vaardigheden.
Data science is serieus werk, maar we bewegen naar een wereld met functionele data science, waar praktijkmensen in staat zijn om hun eigen analyses te doen. Om data pipelines en geïntegreerde datastructuren te benutten, heb je data-engineers nodig, geen wetenschappers.
Is een data-engineer meer gevraagd dan een data-scientist?
— Ja, want voordat je een worteltaart kunt maken, moet je eerst wortels verzamelen, schillen en voorraad inslaan!
Een data-engineer is beter in programmeren dan een data-scientist, maar als het op statistiek aankomt, is het precies andersom.
Maar dit is het voordeel van een data-engineer:
zonder hem/haar is de waarde van een prototype-model, dat meestal bestaat uit een fragment code van slechte kwaliteit in een Python-bestand, verkregen van een data-scientist en op de een of andere manier resultaat oplevert, geneigd naar nul.
Zonder een data-engineer zal deze code nooit een project worden en zal geen enkel zakelijke probleem effectief worden opgelost. Een data-engineer probeert dit allemaal om te zetten in een product.
Basisinformatie die een data-engineer moet weten
Dus als deze baan je enthousiast maakt en je gemotiveerd bent - je kunt het leren, je kunt alle benodigde vaardigheden beheersen en een echte rockster worden op het gebied van data-ontwikkeling. En ja, je kunt dit zelfs zonder programmeervaardigheden of andere technische kennis bereiken. Het is moeilijk, maar mogelijk!
Wat zijn de eerste stappen?
Je moet een algemeen idee hebben van wat wat is.
Allereerst verwijst Data Engineering naar informatica. Specifiek - je moet effectieve algoritmes en datastructuren begrijpen. Ten tweede, aangezien data-engineers met gegevens werken, is begrip van de principes van databases en de structuren die eraan ten grondslag liggen noodzakelijk.
Bijvoorbeeld, gewone B-tree SQL-databases zijn gebaseerd op een datastructuur genaamd B-Tree, evenals in moderne gedistribueerde repositories, LSM-Tree en andere varianten van hash-tabellen.
* Deze stappen zijn gebaseerd op een geweldig artikel . Dus als je de Russische taal kent, steun deze auteur en lees .
1. Algoritmes en datastructuren
Het gebruik van de juiste datastructuur kan de prestaties van een algoritme aanzienlijk verbeteren. Idealiter zouden we allemaal datastructuren en algoritmes op school moeten leren, maar dit wordt zelden behandeld. Hoe dan ook, het is nooit te laat om kennis te maken.
Dus hier zijn mijn favoriete gratis cursussen voor het leren van datastructuren en algoritmes:
Plus vergeet niet het klassieke werk over algoritmes van Thomas H. Cormen — . Dit is de perfecte handleiding wanneer je je geheugen wilt opfrissen.
- Om je vaardigheden te verbeteren, gebruik .
Je kunt ook de wereld van databases verkennen met de geweldige video's van Carnegie Mellon University op YouTube:
- .
- .
2. SQL leren
Ons hele leven draait om gegevens. En om deze gegevens uit een database te halen, moet je "met hen praten" in dezelfde taal.
SQL (Structured Query Language — gestructureerde query-taal) is de communicatietaal in de wereld van data. Hoe dan ook, SQL is geboren, leeft en zal nog lange tijd leven.
Als je lang in de ontwikkeling hebt gezeten, heb je waarschijnlijk opgemerkt dat de geruchten over de naderende dood van SQL periodiek opduiken. De taal werd in de vroege jaren '70 ontwikkeld en is nog steeds erg populair onder analisten, ontwikkelaars en gewoon enthousiastelingen.
Zonder kennis van SQL is er niets te doen in data-engineering, want je zult onvermijdelijk queries moeten opstellen om gegevens op te halen. Alle moderne data-opslagplaatsen ondersteunen SQL:
- Amazon Redshift
- HP Vertica
- Oracle
- SQL Server
… en nog veel meer.
Voor de analyse van grote hoeveelheden gegevens opgeslagen in gedistribueerde systemen zoals HDFS, zijn SQL-mechanismen uitgevonden: Apache Hive, Impala, enzovoort. Zie je, het verdwijnt nergens naartoe.
Hoe leer je SQL? Gewoon door het in de praktijk te doen.
Daarom raad ik aan om kennis te maken met een geweldige handleiding die, trouwens, gratis is, van .
Een bijzonder kenmerk van deze cursussen is de aanwezigheid van een interactieve omgeving waarin je SQL-queries direct in je browser kunt schrijven en uitvoeren. De bron is zeker nuttig. En je kunt deze kennis toepassen in in de sectie Database.
3. Programmeren in Python en Java/Scala
Waarom je de programmeertaal Python zou moeten leren, heb ik al besproken in het artikel . Wat betreft Java en Scala, de meeste tools voor het opslaan en verwerken van enorme hoeveelheden gegevens zijn in deze talen geschreven. Bijvoorbeeld:
- Apache Kafka (Scala)
- Hadoop, HDFS (Java)
- Apache Spark (Scala)
- Apache Cassandra (Java)
- HBase (Java)
- Apache Hive (Java)
Om te begrijpen hoe deze tools werken, moet je de talen kennen waarin ze zijn geschreven. De functionele benadering van Scala stelt je in staat om efficiënt om te gaan met parallelle gegevensverwerking. Python kan helaas niet bogen op snelheid en parallelle verwerkingscapaciteiten. Over het algemeen heeft kennis van meerdere talen en programmeerparadigma's een positieve invloed op de verscheidenheid aan benaderingen voor probleemoplossing.
Om in de Scala-taal te duiken, kun je lezen door de auteur van de taal. Ook bedrijf Twitter heeft een goede introductiegids gepubliceerd — .
Wat betreft Python, vind ik de beste boek voor gemiddeld niveau.
4. Tools voor big data
Hier is een lijst van de populairste tools in de wereld van big data:
- Apache Spark
- Apache Kafka
- Apache Hadoop (HDFS, HBase, Hive)
- Apache Cassandra
Voor meer informatie over het bouwen van grote gegevensblokken, kun je deze geweldige . De populairste tools zijn Spark en Kafka. Ze zijn zeker de moeite waard om te bestuderen, idealiter om te begrijpen hoe ze van binnenuit werken. Jay Kreps (mede-oonwerper van Kafka) publiceerde in 2013 een monumentaal werk , trouwens, de belangrijkste ideeën uit deze gids zijn gebruikt voor de ontwikkeling van Apache Kafka.
- Een inleiding tot Hadoop kan zijn .
- De meest uitgebreide gids voor Apache Spark voor mij is — .
5. Cloudplatforms
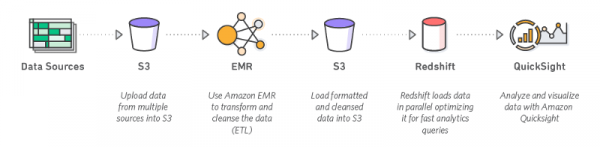
Kennis van ten minste één cloudplatform staat op de lijst van basisvereisten voor sollicitanten naar de functie van data-engineer. Werkgevers geven de voorkeur aan Amazon Web Services, op de tweede plaats staat Google Cloud Platform, en Microsoft Azure sluit de top drie af.
Je moet goed bekend zijn met Amazon EC2, AWS Lambda, Amazon S3, DynamoDB.
6. Gedistribueerde systemen
Werken met big data impliceert het bestaan van clusters van onafhankelijk werkende computers, waarvan de communicatie via een netwerk verloopt. Hoe groter het cluster, hoe groter de kans op falen van de knooppunten. Om een geweldige expert in data te worden, moet je de problemen en bestaande oplossingen voor gedistribueerde systemen begrijpen. Dit gebied is oud en complex.
Andrew Tanenbaum wordt beschouwd als een pionier op dit gebied. Voor degenen die niet bang zijn voor theorie, raad ik zijn boek aan , voor beginners kan het wat moeilijk lijken, maar het zal je helpen je vaardigheden echt te verfijnen.
Ik geloof de beste inleiding is. Trouwens, Martin heeft een geweldige . Zijn werk helpt om kennis over de opbouw van moderne infrastructuur voor de opslag en verwerking van grote data te systematiseren.
Voor degenen die van video houden, is er een cursus op Youtube over .
7. Datapeer
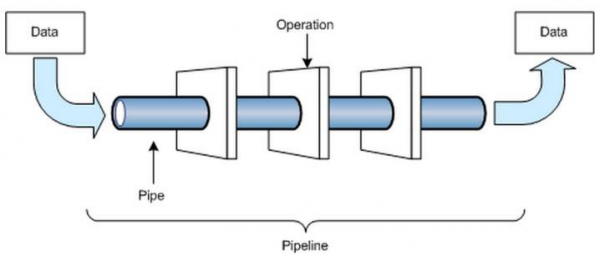
Datapeer is iets waar je als data-engineer niet zonder kunt leven.
De meeste tijd bouwt een data-engineer wat men een datapeer noemt, dat wil zeggen, het creëren van een proces voor het verplaatsen van gegevens van de ene plek naar de andere. Dit kunnen gebruikersscenario's zijn die naar de API van een externe service gaan of SQL-query's uitvoeren, gegevens aanvullen en deze in een centrale opslag (opslagplaats voor gegevens) of een opslag voor ongestructureerde gegevens (data lakes) plaatsen.
Samenvattend: de belangrijkste checklist voor een data-engineer
Laten we samenvatten — het is belangrijk om goed inzicht te hebben in het volgende:
- Informatiesystemen;
- Softwareontwikkeling (Agile, DevOps, Ontwerpmethoden, SOA);
- Gedistribueerde systemen en parallel programmeren;
- Fundamentals van databases — planning, ontwerp, werking en probleemoplossing;
- Experimenteel ontwerp — A/B-tests om concepten te bewijzen, de betrouwbaarheid en prestaties van systemen vast te stellen, evenals het ontwerpen van betrouwbare wegen voor het operationeel aanbieden van goede oplossingen.
Dit zijn slechts enkele vereisten om data-engineer te worden, dus verken en begrijp data systemen, informatiesystemen, continue levering/implementatie/integratie, programmeertalen en andere onderwerpen in informatica (niet in alle onderwerpen).
En tot slot, het laatste maar zeer belangrijke wat ik wil zeggen.
Het pad naar Data Engineering is niet zo eenvoudig als het lijkt. Het is genadeloos, frustrerend, en je moet er klaar voor zijn. Sommige momenten in deze reis kunnen je ertoe aanzetten alles op te geven. Maar het is echt hard werken en een leerproces.
Versier het niet vanaf het begin. Het doel van de reis is om zoveel mogelijk te leren en je voor te bereiden op nieuwe uitdagingen.
Hier is een geweldige afbeelding die ik tegenkwam, die dit moment goed illustreert:
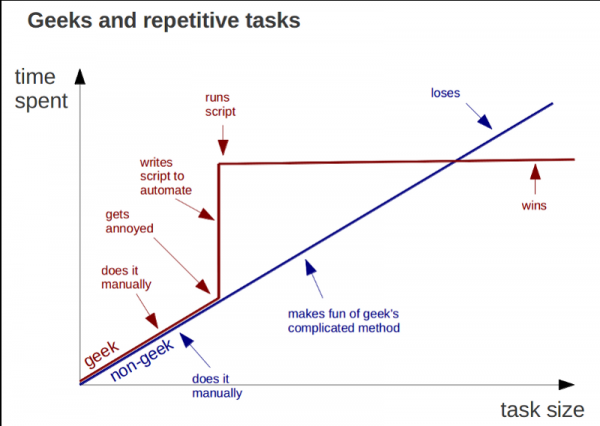
En ja, vergeet niet om burn-out te vermijden en rust te nemen. Dit is ook erg belangrijk. Veel succes!
Wat vinden jullie van het artikel, vrienden? We nodigen jullie uit voor , dat vandaag al om 20.00 uur zal plaatsvinden. Tijdens het webinar bespreken we hoe je een effectief en schaalbaar gegevensverwerkingssysteem kunt opzetten voor een klein bedrijf of startup met minimale kosten. We zullen ook kennis maken met Google Cloud gegevensverwerkingstools als onderdeel van de praktijk. Tot dan!
Bron: habr.com
