

Standaardvoorwaarde bij het implementeren van CI/CD in Kubernetes: de applicatie moet in staat zijn om, voordat deze volledig stopt, geen nieuwe klantverzoeken meer te accepteren en, het belangrijkste, al bestaande verzoeken succesvol af te ronden.
Het naleven van deze voorwaarde maakt het mogelijk om een nul-downtime tijdens de deployment te bereiken. Echter, zelfs bij het gebruik van zeer populaire combinaties (zoals NGINX en PHP-FPM) kunnen er complicaties optreden die leiden tot een piek in fouten bij elke deployment…
Theorie. Hoe een pod leeft
We hebben al uitgebreid geschreven over de levenscyclus van een pod . In de context van het onderwerp dat we bespreken, zijn we geïnteresseerd in het volgende: op het moment dat een pod de status verandert naar Terminating, worden er geen nieuwe verzoeken meer naar hem gestuurd (de pod vervalt van de lijst met endpoints voor de service). Daarom is het voor ons voldoende om het probleem van de correcte stopzetting van de applicatie op te lossen om downtime tijdens de deployment te vermijden.
Daarnaast moet worden opgemerkt dat de grace period standaard gelijk is aan : na deze periode zal de pod beëindigd worden en moet de applicatie in staat zijn om alle verzoeken binnen deze periode te verwerken. Opmerking: hoewel elk verzoek dat langer dan 5-10 seconden duurt al problematisch is, zal een graceful shutdown hier niet meer helpen…
Om beter te begrijpen wat er gebeurt wanneer een pod zijn werkzaamheden beëindigt, is het voldoende om het volgende schema te bestuderen:
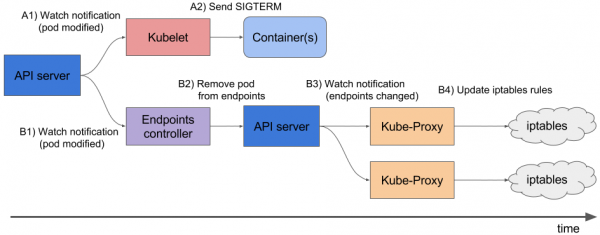
A1, B1 — Ontvangst van veranderingen in de status van de pod
A2 — Verzending van SIGTERM
B2 — Verwijdering van de pod uit endpoints
B3 — Ontvangst van veranderingen (de lijst met endpoints is gewijzigd)
B4 — Bijwerken van de iptables-regels
Let op: de verwijdering van de endpoint pod en de verzending van SIGTERM gebeuren niet sequentieel, maar parallel. En omdat Ingress de bijgewerkte lijst met endpoints niet onmiddellijk ontvangt, zullen er nieuwe verzoeken van klanten naar de pod worden verzonden, wat tijdens de beëindiging van de pod 500-fouten zal veroorzaken. (een meer gedetailleerd materiaal over deze kwestie hebben we ). Deze kwestie dient op de volgende manieren te worden opgelost:
- Stuur in de response headers Connection: close (indien het om een HTTP-applicatie gaat).
- Als het niet mogelijk is om wijzigingen in de code aan te brengen, wordt in het artikel verderop een oplossing beschreven die het mogelijk maakt om verzoeken tot het einde van de grace period te verwerken.
Theorie. Hoe NGINX en PHP-FPM hun processen beëindigen
NGINX
Laten we beginnen met NGINX, aangezien dit meer of minder duidelijk is. Door ons in de theorie te verdiepen, leren we dat NGINX één masterproces heeft en verschillende 'workers' - dat zijn de child-processen die de klantverzoeken afhandelen. Er is een handige mogelijkheid: met het commando nginx -s kun je processen beëindigen, hetzij in de fast shutdown-modus, hetzij in de graceful shutdown-modus. Het is duidelijk dat wij geïnteresseerd zijn in de laatste optie.
Vervolgens is het eenvoudig: we moeten toevoegen aan de een commando dat het signaal voor graceful shutdown zal versturen. Dit kan in de Deployment, in het containerblok:
       lifecycle:
          preStop:
            exec:
              command:
              - /usr/sbin/nginx
              - -s
              - quit
Nu, op het moment dat de pod wordt beëindigd, zullen we het volgende in de logs van de NGINX-container zien:
2018/01/25 13:58:31 [notice] 1#1: signal 3 (SIGQUIT) ontvangen, wordt afgesloten
2018/01/25 13:58:31 [notice] 11#11: sluit vriendelijk af
En dat betekent wat we nodig hebben: NGINX wacht op de voltooiing van de verzoeken, waarna het het proces beëindigt. Maar hieronder wordt ook een veelvoorkomend probleem behandeld, dat ervoor zorgt dat zelfs met het commando nginx -s quit het proces onjuist wordt beëindigd.
En op dit punt hebben we NGINX afgerond: tenminste uit de logs kan je begrijpen dat alles werkt zoals het hoort.
Hoe zit het met PHP-FPM? Hoe behandelt het graceful shutdown? Laten we het uitzoeken.
PHP-FPM
In het geval van PHP-FPM is er iets minder informatie. Als we ons baseren op de voor PHP-FPM, wordt daarin vermeld dat de volgende POSIX-signalen worden geaccepteerd:
-
SIGINT,SIGTERM— fast shutdown; -
SIGQUIT— graceful shutdown (wat we nodig hebben).
De overige signalen zijn in deze context niet nodig, daarom laten we de bespreking daarvan achterwege. Voor een correcte beëindiging van het proces is het nodig om de volgende preStop-hook te schrijven:
        lifecycle:
          preStop:
            exec:
              command:
              - /bin/kill
              - -SIGQUIT
              - "1"
Op het eerste gezicht is dit alles wat nodig is voor het uitvoeren van graceful shutdown in beide containers. Desondanks is de taak moeilijker dan het lijkt. Hieronder worden twee gevallen besproken waarin graceful shutdown niet functioneerde en tijdelijke onbereikbaarheid van het project tijdens de deployment veroorzaakte.
Praktijk. Mogelijke problemen met graceful shutdown
NGINX
Het is in de eerste plaats nuttig om te onthouden: naast het uitvoeren van het commando nginx -s quit er is nog een fase waar we aandacht aan moeten besteden. We hebben een probleem ervaren waarin NGINX in plaats van een SIGQUIT-signaal nog steeds SIGTERM verstuurde, waardoor verzoeken niet correct werden beëindigd. Dergelijke gevallen zijn bijvoorbeeld te vinden, . Helaas konden we de specifieke reden voor dit gedrag niet vaststellen: er was enige verdenking op de NGINX-versies, maar dit werd niet bevestigd. De symptomen waren dat in de logs van de NGINX-container berichten werden waargenomen, «open socket #10 left in connection 5», waarna de pod stopte.
We kunnen zo'n probleem observeren, bijvoorbeeld, aan de reacties op de Ingress die we nodig hebben:
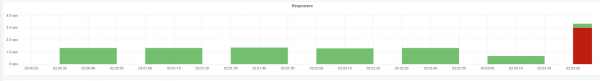
De statuscode-statistieken op het moment van deployment
In dit geval krijgen we precies de 503-foutcode van de Ingress zelf: het kan de NGINX-container niet bereiken omdat deze al niet meer beschikbaar is. Als we naar de logs van de NGINX-container kijken, zien we het volgende:
[alert] 13939#0: *154 open socket #3 left in connection 16
[alert] 13939#0: *168 open socket #6 left in connection 13
Na het wijzigen van het stop-signaal begint de container correct te stoppen: dit wordt bevestigd doordat de 503-fout niet meer wordt waargenomen.
Als je met een vergelijkbaar probleem te maken hebt gehad, is het zinvol om uit te zoeken welk stop-signaal in de container wordt gebruikt en hoe precies de preStop-hook eruit ziet. Het is goed mogelijk dat de oorzaak hierin ligt.
PHP-FPM… en meer
Het probleem met PHP-FPM kan triviaal worden beschreven: het wacht niet op de voltooiing van kindprocessen en beëindigt ze, waardoor 502-fouten optreden tijdens deployments en andere operaties. Op bugs.php.net zijn er sinds 2005 verschillende foutmeldingen (bijvoorbeeld, en ), waarin dit probleem wordt beschreven. En in de logs zul je waarschijnlijk niets zien: PHP-FPM zal zijn proces beëindigen zonder enige fouten of externe meldingen.
Het is vermeldenswaard dat het probleem in mindere of grotere mate afhankelijk kan zijn van de applicatie zelf en zich bijvoorbeeld niet kan manifesteren in de monitoring. Mocht je er toch mee te maken krijgen, dan komt als eerste een eenvoudige workaround in me op: voeg een preStop-hook toe met sleep(30). Dit stelt ons in staat om alle verzoeken die eerder waren gedaan te beëindigen (en nieuwe aanvragen worden niet geaccepteerd, aangezien de pod al in de status Terminating), en na 30 seconden zal de pod zichzelf beëindigen met het signaal. SIGTERM.
Het blijkt dat lifecycle voor de container zou er als volgt uitzien:
    lifecycle:
      preStop:
        exec:
          command:
          - /bin/sleep
          - "30"
Echter, vanwege de vermelding van de 30-seconden sleep maken wij krachtig we zullen de uitroltijd verlengen, omdat elke pod zal worden beëindigd minimum 30 seconden, wat slecht is. Wat kunnen we hieraan doen?
Laten we ons richten op de zijde die verantwoordelijk is voor de directe uitvoering van de applicatie. In ons geval is dit PHP-FPM, die volgens de standaard niet verantwoordelijk voor het toezicht op de uitvoering van zijn child-processen: het masterproces wordt onmiddellijk beëindigd. Dit gedrag kan worden gewijzigd met behulp van de richtlijn process_control_timeout, die tijdslimieten aangeeft voor het wachten op signalen van het masterproces door child-processen. Als we de waarde instellen op 20 seconden, dekt dit de meeste aanvragen die in de container worden uitgevoerd en wordt het masterproces stopgezet na hun voltooiing.
Met deze kennis keren we terug naar ons laatste probleem. Zoals al vermeld, Kubernetes is geen monolithisch platform: de interactie tussen de verschillende componenten vereist enige tijd. Dit is vooral belangrijk wanneer we de werking van Ingress en andere verwante componenten beschouwen, omdat door zo'n vertraging tijdens de uitrol makkelijk een piek van 500-fouten kan ontstaan. Bijvoorbeeld, de fout kan optreden tijdens het verzenden van een aanvraag naar de upstream, maar de 'tijdvertraging' van de interactie tussen componenten is behoorlijk kort — minder dan een seconde.
Daarom, in totaal met de hierboven genoemde richtlijn process_control_timeout kunnen we de volgende constructie gebruiken voor lifecycle:
lifecycle:
  preStop:
    exec:
      command: ["/bin/bash","-c","/bin/sleep 1; kill -QUIT 1"]
In dat geval compenseren we de vertraging met het commando sleep en verhogen we de uitroltijd niet significant: er is immers een groot verschil tussen 30 seconden en één?.. In wezen neemt de process_control_timeout, met behulp van 1 bit, gelijk aan 0, lifecycle wordt alleen gebruikt als 'back-up' voor het geval van vertraging.
het volledige het beschreven gedrag en de bijbehorende workaround zijn niet alleen van toepassing op PHP-FPM. Een soortgelijke situatie kan zich op de een of andere manier voordoen bij andere programmeertalen/frameworks. Als andere manieren om de graceful shutdown op te lossen niet werken — bijvoorbeeld door de code zo te herschrijven dat de applicatie correct omgaat met beëigingssignalen — kan de beschreven methode worden toegepast. Ook al is het niet de mooiste oplossing, het werkt.
Praktijk. Load testing om de werking van de pod te controleren
Load testing is one of the ways to check how a container operates, as this procedure simulates real combat conditions when users visit the site. For testing the recommendations mentioned above, you can use : it perfectly meets all our needs. Below are tips and recommendations for conducting testing with a clear — thanks to the Grafana charts and Yandex.Tank itself — example from our experience.
The most important point here is to check changes step-by-step. After adding a new fix, run the test and see if the results have changed compared to the previous run. Otherwise, it will be difficult to identify ineffective solutions, and in the long run, it may even harm (for example, increasing deployment time).
Another nuance is to check the container logs during its termination. Is there information about a graceful shutdown? Are there any errors in the logs when accessing other resources (for example, to the neighboring PHP-FPM container)? Are there errors in the application itself (as mentioned above regarding NGINX)? I hope the introductory information from this article helps to better understand what happens to the container during its termination.
So, the first test run took place without lifecycle and without additional directives for the application server (process_control_timeout in PHP-FPM). The goal of this test was to identify the approximate number of errors (and whether there are any at all). Additionally, it should be noted that the average deployment time for each pod was about 5-10 seconds until it reached full readiness. The results are as follows:
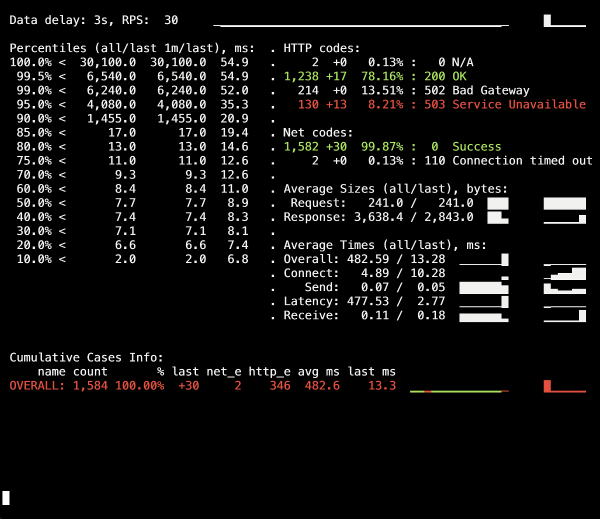
On the Yandex.Tank dashboard, a spike of 502 errors can be seen, which occurred at the time of deployment and lasted on average for 5 seconds. It is presumed that existing requests to the old pod were interrupted during its termination. After that, 503 errors appeared, which resulted from the stopped NGINX container, which also terminated connections due to the backend (which is why it could not connect to Ingress).
Let's see how process_control_timeout in PHP-FPM can help us wait for child processes to finish, i.e., fix such errors. A repeated deployment with this directive:
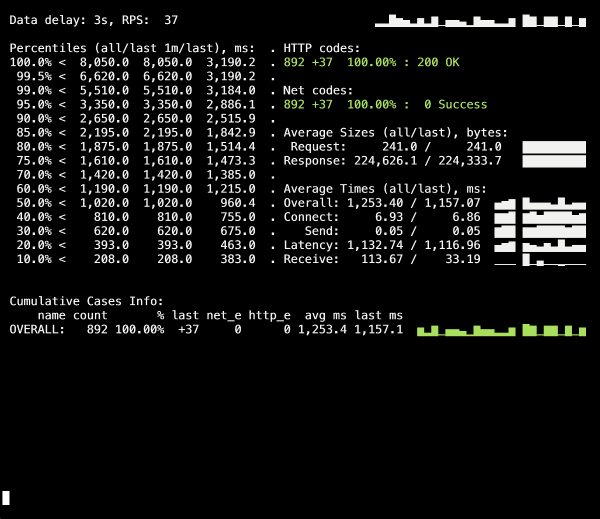
Tijdens de deployment zijn er geen 500-fouten meer! De deployment verloopt succesvol, graceful shutdown werkt.
Het is echter belangrijk om het moment met de Ingress-voorbeelden te herinneren, waar we een klein percentage fouten kunnen tegenkomen vanwege tijdelijke vertraging. Om deze te voorkomen, is het nodig om een constructie toe te voegen met sleep en de deployment opnieuw uit te voeren. In ons specifieke geval waren er echter geen veranderingen zichtbaar (geen fouten meer).
Conclusie
Voor de correcte afronding van het proces verwachten we het volgende gedrag van de applicatie:
- Een paar seconden wachten, waarna nieuwe verbindingen niet meer worden geaccepteerd.
- Wachten tot alle verzoeken zijn voltooid en alle keepalive-verbindingen te sluiten die geen verzoeken uitvoeren.
- De eigen processen beëindigen.
Niet alle applicaties kunnen echter zo werken. Een van de oplossingen voor dit probleem in de context van Kubernetes is:
- het toevoegen van een pre-stop hook die enkele seconden zal wachten;
- de configuratie van onze backend controleren op de juiste parameters.
Een voorbeeld met NGINX laat zien dat zelfs een applicatie die oorspronkelijk correct moet reageren op beëindigingssignalen, dit misschien niet doet, daarom is het van cruciaal belang om 500-fouten tijdens de deployment van de applicatie te controleren. Dit stelt ons ook in staat om het probleem breder te bekijken en ons niet alleen op één pod of container te concentreren, maar naar de hele infrastructuur als geheel te kijken.
Als testinstrument kunnen we Yandex.Tank gebruiken samen met elk monitoringsysteem (in ons geval zijn er gegevens uit Grafana met een backend in de vorm van Prometheus gebruikt voor de test). Problemen met graceful shutdown zijn goed zichtbaar bij hoge belastingen die een benchmark kan genereren, en monitoring helpt om de situatie tijdens of na de test beter te analyseren.
In reactie op de feedback op het artikel: het moet worden opgemerkt dat de problemen en hun oplossingen hier worden beschreven met betrekking tot NGINX Ingress. Voor andere gevallen zijn er andere oplossingen, die we misschien in volgende artikelen van deze cyclus zullen bekijken.
P.S.
Andere uit de K8s tips & tricks serie:
- «»;
- «»;
- «»;
- «».
Bron: habr.com
