

Mijn naam is Viktor Yagofarov, en ik ben verantwoordelijk voor de ontwikkeling van het Kubernetes-platform bij het bedrijf DomKlik als technisch directeur van de ontwikkelingsafdeling binnen het Ops-team (operaties). Ik wil u vertellen over de werking van onze Dev Ops-processen, de bijzonderheden van het beheer van een van de grootste k8s-clusters in Rusland, en over de DevOps/SRE-praktijken die ons team toepast.
Ops-team
Momenteel werken er 15 mensen in het Ops-team. Drie van hen zijn verantwoordelijk voor kantoor, twee werken in een andere tijdzone en zijn ook 's nachts beschikbaar. Zo is er altijd iemand van Ops bij het scherm en klaar om te reageren op een incident van welke complexiteit dan ook. We hebben geen nachtdiensten, wat onze geest gezond houdt en ons in staat stelt om uit te rusten en ons vrije tijd niet alleen achter de computer door te brengen.
Iedereen heeft verschillende competenties: netwerkengineers, DBA's, specialisten op het ELK-stapel, Kubernetes-beheerders/ontwikkelaars, monitoring-, virtualisatie- en hardware-experts, enzovoort. Wat ons verenigt is het feit dat iedereen in bepaalde mate elk van ons kan vervangen: bijvoorbeeld nieuwe knooppunten in het k8s-cluster introduceren, PostgreSQL bijwerken, een CI/CD-pipeline + Ansible schrijven, iets automatiseren met Python/Bash/Go, hardware aansluiten in een datacenter. Sterke competenties in een bepaald gebied belemmeren niet de mogelijkheid om van richting te veranderen en te beginnen met het ontwikkelen in een ander gebied. Bijvoorbeeld, ik begon bij het bedrijf als PostgreSQL-specialist, en nu is mijn belangrijkste verantwoordelijkheidsgebied Kubernetes-clusters. Groei binnen het team wordt alleen aangemoedigd en de teamgeest is sterk ontwikkeld.
Overigens, we zijn op zoek naar mensen. De vereisten voor kandidaten zijn vrij standaard. Persoonlijk vind ik het belangrijk dat iemand in het team past, niet conflictueus is, maar ook zijn of haar standpunt kan verdedigen, zich wil ontwikkelen en niet bang is om iets nieuws te proberen, en ideeën kan aandragen. Daarnaast zijn programmeerkennis in scripttalen, basiskennis van Linux en de Engelse taal verplicht. Engels is nodig zodat iemand bij een probleem snel een oplossing kan googelen binnen 10 seconden in plaats van 10 minuten. Het is tegenwoordig moeilijk om specialisten met diepgaande Linux-kennis te vinden: het is grappig, maar twee van de drie kandidaten kunnen de vraag
Team Tools
Het Tools-team speelt een aanzienlijke rol in automatisering. Hun hoofdtaken zijn het ontwikkelen van gebruiksvriendelijke grafische en CLI-tools voor ontwikkelaars. Bijvoorbeeld, onze interne tool Confer maakt het mogelijk om met slechts een paar muisklikken een applicatie naar Kubernetes te implementeren, de middelen, sleutels uit de vault enz. in te stellen. Voorheen gebruikten we Jenkins + Helm 2, maar we moesten onze eigen tool ontwikkelen om copy-paste te vermijden en uniformiteit in de softwarelevenscyclus te brengen.
Het Ops-team schrijft geen pipelines voor ontwikkelaars, maar kan hen adviseren over allerlei vragen rondom het schrijven hiervan (sommigen hebben nog steeds Helm 3).
DevOps
Wat betreft DevOps, zien wij dit als volgt:
De Dev-teams schrijven code en implementeren deze via Confer in dev -> qa/stage -> prod. De verantwoordelijkheid ervoor dat de code niet traag is of fouten geeft, ligt bij de Dev- en Ops-teams. Tijdens kantooruren moet de teamleider van Ops in de eerste plaats reageren op een incident met zijn applicatie, en in de avond en nacht moet de beheerder (Ops) de ontwikkelaar wakker maken als hij zeker weet dat het probleem niet in de infrastructuur ligt. Alle metrics en alerts in de monitoring verschijnen automatisch of semi-automatisch.
De verantwoordelijkheid van Ops begint zodra de applicatie in productie wordt uitgerold, maar de verantwoordelijkheid van Dev eindigt hier niet - we doen hetzelfde werk en zitten in hetzelfde schuitje.
Ontwikkelaars adviseren systeembeheerders wanneer hulp nodig is bij het schrijven van een admin-microservice (bijvoorbeeld, Go backend + HTML5), en systeembeheerders adviseren ontwikkelaars over infrastructuurkwesties of zaken gerelateerd aan k8s.
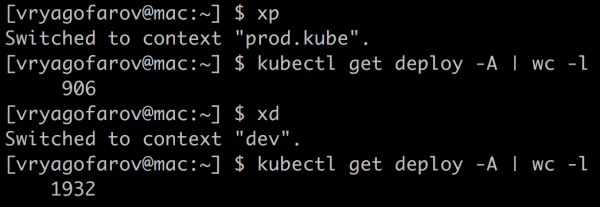
Overigens hebben we helemaal geen monoliet, alleen microservices. Hun aantal schommelt momenteel tussen de 900 en 1000 in de prod k8s-cluster, als we meten op basis van aantal. deploymentsHet aantal pods schommelt tussen de 1700 en 2000. Het aantal pods in de prod-cluster ligt momenteel rond de 2000.
Ik kan geen exacte cijfers geven, omdat we onnodige microservices volgen en deze in een semi-automatische modus verwijderen. Om onnodige entiteiten in k8s te volgen, helpt ons , wat echt kosten en middelen bespaart.
Resourcebeheer
Monitoring
Een goed gestructureerde en informatieve monitoring wordt de hoeksteen van het beheren van een grote cluster. Tot nu toe hebben we geen universele oplossing gevonden die 100 % van alle monitoringwensen dekt, dus maken we af en toe verschillende op maat gemaakte oplossingen in deze omgeving.
- Zabbix. Goede oude monitoring, die in de eerste plaats bedoeld is voor het volgen van de algemene toestand van de infrastructuur. Het vertelt ons wanneer een node faalt op CPU, geheugen, schijven, netwerk, enzovoort. Niets bovennatuurlijks, maar we hebben ook een aparte DaemonSet van agents waarmee we bijvoorbeeld de toestand van DNS in de cluster monitoren: we zoeken naar traagheid bij de pods van coredns en controleren de beschikbaarheid van externe hosts. Het lijkt misschien overbodig, maar bij grote hoeveelheden verkeer is dit component een serieus knelpunt. Eerder heb ik al , hoe ik de DNS-prestaties in de cluster heb aangepakt.
- Prometheus Operator. Een set verschillende exporters biedt een goed overzicht van alle componenten van de cluster. Vervolgens visualiseren we dit alles op grote dashboards in Grafana, en voor waarschuwingen gebruiken we alertmanager.
Een andere nuttige tool voor ons is We wrote it after encountering situations where one team's Ingress traffic would interfere with another team's, leading to 50x errors. Now, before deploying to production, developers check to ensure they don’t affect anyone else, and for my team, it serves as a useful tool for initial problem diagnostics with Ingresses. Interestingly, it was initially designed for admins and looked rather 'clunky', but after gaining popularity with dev teams, it transformed significantly and no longer resembles an 'admin-made interface for admins'. Soon, we will phase out this tool, and similar situations will be validated even before the pipeline roll-out.
Team Resources in 'Kube'
Before diving into examples, it's worth explaining how we allocate resources for microservices.
To understand which teams and in what quantities utilize their resources (CPU, memory, local SSD), we allocate a specific namespace in 'Kube' to each team and set maximum limits on CPU, memory, and disk after discussing the teams' needs. Consequently, one team generally does not block the entire cluster for deployment by grabbing thousands of cores and terabytes of memory. Access to namespaces is granted via AD (we use RBAC). Namespaces and their limits are added through a pull request in the GIT repository, and then everything is automatically deployed through the Ansible pipeline.
Example of resource allocation for a team:
namespaces:

  chat-team:
    pods: 23
    limits:
      cpu: 11
      memory: 20Gi
    requests:
      cpu: 11
      memory: 20Gi
Requests and Limits
In 'Kube' Request — is the amount of resources guaranteed to be reserved for pod (one or more Docker containers) in the cluster. Limit — is the non-guaranteed maximum. It’s often visible in graphs how one team has set too many requests for all their applications and cannot deploy an application in 'Kube', as all requests under their namespace have already been 'spent'.
The correct way out of such situations: to monitor actual resource consumption and compare it with the requested amount (Request).
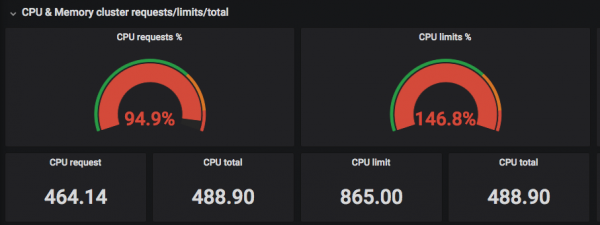
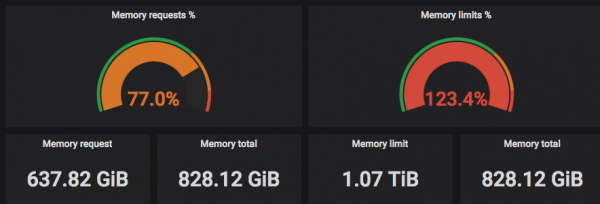
In the screenshots above, it’s evident that the 'requested' (Requested) CPU matches the actual number of threads, while Limits may exceed the actual number of CPU threads =)
Laten we nu eens gedetailleerd bekijken hoe een namespace werkt (ik heb gekozen voor de namespace kube-system — de systeemnamespace voor de componenten van «Kube») en de verhouding van werkelijk gebruikt CPU-tijd en geheugen ten opzichte van het gevraagde bekijken:
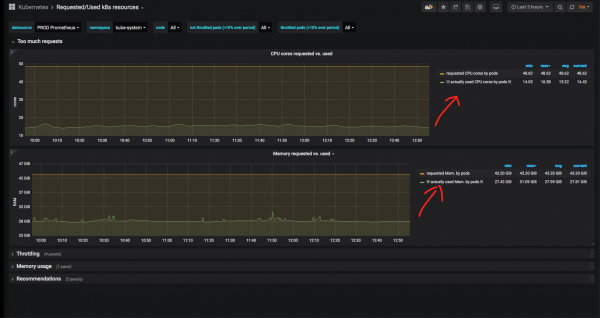
Het is duidelijk dat er veel meer geheugen en CPU is gereserveerd voor systeemdiensten dan werkelijk wordt gebruikt. In het geval van kube-system is dit gerechtvaardigd: het is voorgekomen dat de nginx ingress controller of nodelocaldns op hun piek tegen de CPU-limiet aanliepen en veel RAM verbruikten, dus om die reden is er zo'n reserve gerechtvaardigd. Bovendien kunnen we niet alleen vertrouwen op grafieken van de afgelopen 3 uur: het is wenselijk om historische statistieken over een langere periode te bekijken.
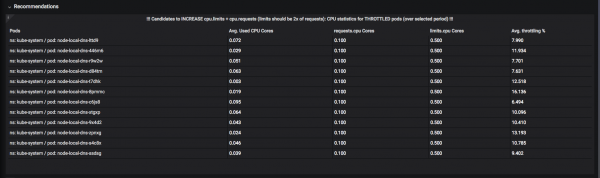
Er is een systeem van «aanbevelingen» ontwikkeld. Hier kun je bijvoorbeeld zien welke resources het beste «limieten» (de bovenste toegestane grens) kunnen krijgen om «throttling» te voorkomen: het moment waarop CPU of geheugen al is verbruikt over de toegewezen tijdsperiode en wacht tot het weer «ontdooid» wordt:
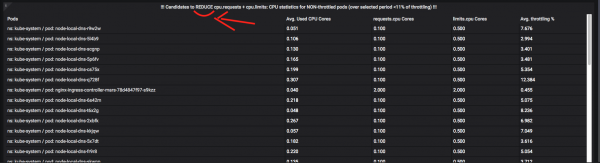
En hier zijn de pods die hun verlangens zouden moeten matigen:
Over throttling + het monitoren van resources is een onderwerp waar je meerdere artikelen over kunt schrijven, dus stel je vragen in de reacties. Kortom, de uitdaging om dergelijke metrics te automatiseren is behoorlijk complex en vereist veel tijd en acrobatiek met «window»-functies en «CTE» Prometheus / VictoriaMetrics (deze termen zijn tussen aanhalingstekens gezet, omdat er in PromQL bijna niets dergelijks is, en je moet enorme queries maken van meerdere schermen tekst en deze optimaliseren).
Uiteindelijk hebben developers tools om hun namespaces in «Kube» te monitoren, en ze kunnen zelf kiezen waar en wanneer ze resources van welke applicaties kunnen «knippen», en welke pods de hele nacht alle CPU mogen gebruiken.
Methodologieën
In het bedrijf, zoals het nu is in de mode, volgen we DevOps- en SRE-praktijken. Wanneer er in het bedrijf 1000 microservices zijn, ongeveer 350 ontwikkelaars en 15 admins voor de hele infrastructuur, moet je «in de mode» zijn: achter al deze «buzzwords» schuilt een dringende behoefte aan automatisering van alles en nog wat, en admins mogen geen knelpunt in de processen zijn.
Als Ops bieden we verschillende metrics en dashboards voor ontwikkelaars aan, gerelateerd aan de responstijd van services en hun fouten.
We gebruiken methodologieën zoals: , en , door ze samen te combineren. We proberen het aantal dashboards te minimaliseren, zodat in één oogopslag duidelijk is welke service momenteel degradeert (bijvoorbeeld de responscodes per seconde, responstijd op het 99e percentiel), enzovoort. Zodra er nieuwe metrics nodig zijn voor de gezamenlijke dashboards, tekenen en voegen we ze onmiddellijk toe.
Ik heb al een maand geen grafieken getekend. Misschien is dat een goed teken: dat betekent dat de meeste 'verlangens' al zijn gerealiseerd. Het is wel eens gebeurd dat ik in een week tenminste één keer per dag een nieuwe grafiek tekende.
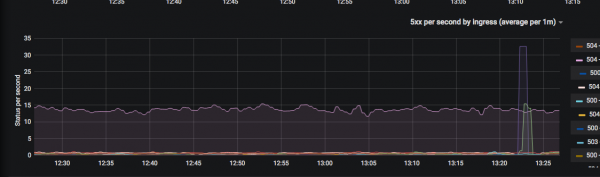
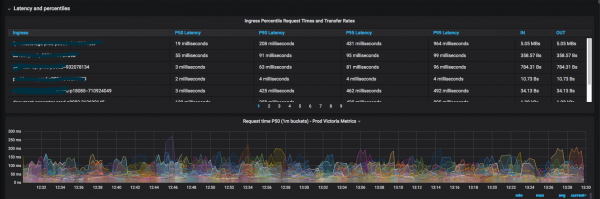
Het resultaat is waardevol omdat de ontwikkelaars nu vrij zeldzaam bij de beheerders komen met de vraag 'waar kan ik een bepaalde metric bekijken'.
Implementatie Service Mesh is dichtbij en zou het leven voor iedereen aanzienlijk moeten vergemakkelijken. Collega's van Tools zijn al dicht bij de implementatie van een abstracte 'gezonde Istio': de levenscyclus van elke HTTP(s)-aanroep zal zichtbaar zijn in de monitoring, en je kunt altijd begrijpen 'op welk moment alles stuk ging' tijdens de tussenservice (en niet alleen) interactie. Abonneer je op het nieuws van het bedrijfshub van DomClick. =)
Ondersteuning voor Kubernetes-infrastructuur
Historisch gezien gebruiken we een gepatchte versie Kubespray - Ansible-rol voor het inrichten, uitbreiden en updaten van Kubernetes. Op een bepaald moment werd de ondersteuning voor non-kubeadm installaties uit de hoofdvertakking gehaald, en er werd geen proces voorgesteld voor de overstap naar kubeadm. Uiteindelijk heeft het bedrijf Southbridge zijn eigen fork gemaakt (met ondersteuning voor kubeadm en snelle fixes voor kritieke problemen).
Het proces voor het updaten van alle k8s-clusters verloopt als volgt:
- We nemen Kubespray van Southbridge, controleren deze met onze vertakking, en mergen.
- We voeren de update uit in Stress-'Cube'.
- We voeren de update uit per node (in Ansible is dat 'serial: 1') in Dev-'Cube'.
- We updaten Prod op zaterdagavond per node.
In de toekomst zijn er plannen om Kubespray te vervangen door iets sneller en over te schakelen naar kubeadm.
In totaal hebben we drie 'Cubes': Stress, Dev en Prod. We zijn van plan nog een te lanceren (hot standby) Prod-'Cube' in de tweede datacenter. Stress en Dev leiden een leven in 'virtuele machines' (oVirt voor Stress en VMWare cloud voor Dev). Prod-'Cube' draait op 'bare metal': dit zijn identieke nodes met 32 CPU-threads, 64-128 GB RAM en 300 GB SSD RAID 10 — in totaal 50 stuks. Drie 'dunne' nodes zijn gereserveerd voor de 'masters' van Prod-'Cube': 16 GB RAM, 12 CPU-threads.
Voor de productie geven we de voorkeur aan het gebruik van 'bare metal' en vermijden we extra lagen zoals OpenStack: we hebben geen 'luidruchtige buren' nodig en CPU steal time. En de complexiteit van het beheer neemt ongeveer twee keer zoveel toe in het geval van in-house OpenStack.
Voor CI/CD gebruiken we een aparte GIT-server voor «Kubernetes» en andere infrastructuurcomponenten, Helm 3 (overgestapt van Helm 2 met enige moeite, maar we zijn erg blij met de optie atomic), Jenkins, Ansible en Docker. We houden van feature branches en het uitrollen naar verschillende omgevingen vanuit één repository.
Conclusie
Zo ziet het DevOps-proces van de operationele ingenieur eruit bij het bedrijf DomClick. Het artikel is minder technisch geworden dan ik had verwacht: volg daarom het nieuws van DomClick op Habr: er komen meer 'hardcore' artikelen over Kubernetes en meer.
Bron: habr.com
