

Bron:
Lineaire regressie is een van de basisalgoritmen voor veel gebieden die verband houden met data-analyse. De reden hiervoor is duidelijk. Het is een zeer eenvoudig en begrijpelijk algoritme, wat bijdraagt aan het brede gebruik ervan al tientallen, zo niet honderden jaren. Het idee is dat we een lineaire afhankelijkheid van één variabele veronderstellen van een set andere variabelen, en vervolgens proberen we deze afhankelijkheid te herstellen.
Maar dit artikel gaat niet over de toepassing van lineaire regressie voor het oplossen van praktische problemen. Hier worden interessante kenmerken van de implementatie van gedistribueerde algoritmen voor het herstel ervan besproken, waarmee we te maken kregen bij het schrijven van de machine learning-module in . Een beetje basiswiskunde, fundamenten van machine learning en gedistribueerde computing zullen helpen begrijpen hoe we lineaire regressie kunnen herstellen, zelfs als de gegevens zijn verspreid over duizenden knooppunten.
Waar gaat het over?
We hebben de taak om een lineaire afhankelijkheid te herstellen. Als invoergegevens krijgen we een set vectoren van verondersteld onafhankelijke variabelen, elk gekoppeld aan een bepaalde waarde van de afhankelijke variabele. Deze gegevens kunnen worden weergegeven in de vorm van twee matrices:

Nu, aangezien we een afhankelijkheid veronderstellen, en bovendien ook nog lineair, laten we onze hypothese opschrijven in de vorm van matrixvermenigvuldiging (ter vereenvoudiging van de notatie wordt hier en in het vervolg aangenomen dat de constante term van de vergelijking verborgen is achter  , en de laatste kolom van de matrix
 bevat enen):

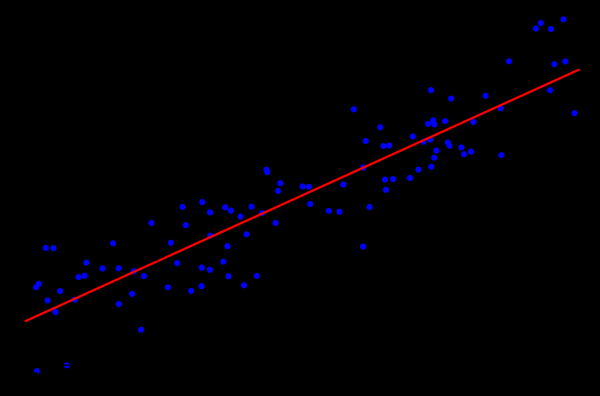
Het lijkt heel erg op een systeem van lineaire vergelijkingen, nietwaar? Het lijkt zo, maar deze vergelijking zal hoogstwaarschijnlijk geen oplossingen hebben. De reden hiervoor is de ruis die in bijna alle werkelijke gegevens aanwezig is. Een andere reden kan zijn het ontbreken van een echte lineaire afhankelijkheid, waarmee we kunnen proberen te worstelen door extra variabelen in te voeren die niet-lineair afhangen van de oorspronkelijke. Laten we het volgende voorbeeld bekijken:
Bron:
Dit is een eenvoudig voorbeeld van lineaire regressie dat de afhankelijkheid van één variabele (langs de as  ) van een andere variabele (langs de as
 ). Om te voldoen aan het voorbeeld moet het systeem van lineaire vergelijkingen een oplossing hebben, waarbij alle punten precies op één lijn liggen. Maar dat is niet het geval. Ze liggen niet op één lijn juist vanwege de ruis (of omdat de veronderstelling over de aanwezigheid van een lineaire afhankelijkheid onjuist was). Om de lineaire afhankelijkheid te herstellen op basis van echte gegevens, is het gebruikelijk om nog een veronderstelling in te voeren: de invoergegevens bevatten ruis en deze ruis heeft . Je kunt ook veronderstellingen doen over andere soorten van ruisverdelingen, maar in de overgrote meerderheid van de gevallen wordt de normale verdeling beschouwd, waarover hier verder zal worden gesproken.
De methode van maximale waarschijnlijkheid
. Dus we nemen aan dat er een willekeurige normaal verdeelde ruis is. Hoe gaan we om met zo'n situatie? Hiervoor bestaat er in de wiskunde een populaire en veelgebruikte methode, . In het kort komt het erop neer dat we kiezen en deze vervolgens maximaliseren.
Laten we terugkeren naar het herstellen van de lineaire afhankelijkheid met gegevens met normale ruis. Opmerkelijk is dat de veronderstelde lineaire afhankelijkheid het mathematisch verwachtingswaarde is  van de huidige normale verdeling. Tegelijkertijd is de kans dat
 een bepaalde waarde aanneemt, afhankelijk van de waargenomen
 , ziet het er als volgt uit:

Laten we nu de juiste variabelen substitueren:  en
 We moeten alleen de vector vinden

, waar de kans maximaal is. Om zo'n functie te maximaliseren, is het handig om deze eerst te logaritmeren (de logaritme van de functie bereikt zijn maximum op hetzelfde punt als de functie zelf):  Wat op zijn beurt neerkomt op het minimaliseren van de volgende functie:

Overigens wordt dit de methode genoemd

van de kleinste kwadraten QR-decompositie
. Het minimum van de hierboven genoemde functie kan worden gevonden door het punt te vinden waar de gradiënt van deze functie gelijk is aan nul. De gradiënt zal als volgt worden weergegeven:
is een matrixmethode voor het oplossen van een minimaliseringsprobleem dat in de methode van de kleinste kwadraten wordt gebruikt. Daarom herschrijven we de vergelijking in matrixvorm:

Dus we decomponeren de matrix

in matrices  op de matrices
 en
 en we voeren een aantal transformaties uit (het algoritme voor QR-decompositie wordt hier niet behandeld, alleen het gebruik ervan met betrekking tot de gestelde taak):

Matrix  is orthogonaal. Dit stelt ons in staat om het product kwijt te raken van
 :

Als we vervangen  en een werkende opdracht krijgen.
 , dan krijgen we
 . Gezien dat
 een bovenste driehoeksmatrix is, ziet dit er als volgt uit:

Dit kan worden opgelost met de substitutiemethode. Het element  wordt gevonden als
 , het vorige element
 wordt gevonden als
 en zo verder.
Het is vermeldenswaard dat de complexiteit van het resulterende algoritme door het gebruik van QR-decompositie gelijk is aan  . Ondanks het feit dat de matrixvermenigvuldiging goed kan worden geparallelliseerd, is het niet mogelijk om een efficiënte gedistribueerde versie van dit algoritme te schrijven.
Gradiëntafdalingsmethode
Als we het hebben over de minimalisatie van een bepaalde functie, is het altijd goed om de (stochastische) gradiëntafdalingsmethode in gedachten te houden. Dit is een eenvoudige en effectieve methode voor minimalisatie, gebaseerd op iteratieve berekening van de gradiënt van de functie op een punt en de daaropvolgende verschuiving in de tegenrichting van de gradiënt. Elke dergelijke stap brengt de oplossing dichter bij het minimum. De gradiënt ziet er als volgt uit:

Bovendien kan deze methode goed worden geparallelliseerd en verdeeld vanwege de lineaire eigenschappen van de gradiëntoperator. Merk op dat in de bovenstaande formule onder het somteken onafhankelijke termen staan. Met andere woorden, we kunnen de gradiënt onafhankelijk voor alle indexen berekenen  van de eerste tot
 , terwijl we parallel de gradiënt voor de indexen van
 tot
 berekenen. Vervolgens worden de resulterende gradiënten bij elkaar opgeteld. Het resultaat van de optelling zal hetzelfde zijn als als we de gradiënt onmiddellijk voor de indexen van de eerste tot
 . Dus, als de gegevens zijn verdeeld over verschillende gegevensdelen, kan de gradiënt onafhankelijk op elk deel worden berekend, en vervolgens kunnen de resultaten van deze berekeningen worden opgeteld om het uiteindelijke resultaat te krijgen:

Vanuit het perspectief van implementatie past dit binnen de paradigma . Bij elke stap van de gradiëntafdalingsmethode wordt een taak naar elke gegevensknop verzonden om de gradiënt te berekenen, vervolgens worden de berekende gradiënten samengevoegd en het resultaat van hun optelling wordt gebruikt om het resultaat te verbeteren.
Hoewel gradient descent eenvoudig te implementeren is en uitgevoerd kan worden in de MapReduce-paradigma, heeft het ook zijn nadelen. In het bijzonder is het aantal stappen dat nodig is om convergentie te bereiken veel groter in vergelijking met andere, meer gespecialiseerde methoden.
LSQR
is een andere methode om het probleem op te lossen, die zowel geschikt is voor het herstel van lineaire regressie als voor het oplossen van systemen van lineaire vergelijkingen. Het belangrijkste kenmerk is dat het de voordelen van matrixmethoden en een iteratieve aanpak combineert. Implementaties van deze methode zijn te vinden in de bibliotheek , alsook in . Een beschrijving van deze methode zal hier niet worden gegeven (deze is te vinden in het artikel ). In plaats daarvan zal een benadering worden gedemonstreerd die het mogelijk maakt om LSQR aan te passen aan een gedistribueerde omgeving.
De basis van de LSQR-methode is . Dit is een iteratieve procedure, waarbij elke iteratie uit de volgende stappen bestaat:
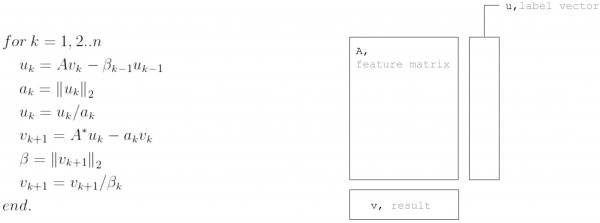
Maar als we ervan uitgaan dat de matrix  horizontaal is gepartitioneerd, kan elke iteratie worden weergegeven als twee MapReduce-stappen. Dit minimaliseert de gegevensoverdracht tijdens elke iteratie (alleen vectoren met een lengte die gelijk is aan het aantal onbekenden):
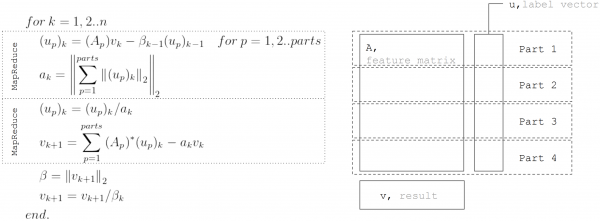
Deze benadering wordt gebruikt bij de implementatie van lineaire regressie in .
Conclusie
Er zijn veel algoritmen voor het herstellen van lineaire regressie, maar niet alle kunnen onder alle omstandigheden worden toegepast. QR-ontbinding is uitstekend voor nauwkeurige oplossingen op kleine datasets. Gradient descent is eenvoudig te implementeren en stelt in staat om snel een benadering van de oplossing te vinden. LSQR combineert de beste eigenschappen van de vorige twee algoritmen, aangezien het kan worden gedistribueerd, sneller convergeert in vergelijking met gradient descent en bovendien een vroegtijdige stop van het algoritme mogelijk maakt, in tegenstelling tot QR-ontbinding voor het vinden van een benaderde oplossing.
Bron: habr.com
