

Laten we de basisprincipes van logging in Docker en Kubernetes doornemen, en daarna twee tools bekijken die je met een gerust hart in productie kunt gebruiken: Grafana Loki en de EFK-stack (Elasticsearch + Fluent Bit + Kibana).
Het materiaal van het artikel is een samenvatting van . Als er behoefte is en vooral een productieve noodzaak, kun je een volledige opleiding volgen — schrijf je in voor de cursus over .
Logging in Docker
Op het niveau van Kubernetes worden applicaties in pods uitgevoerd, maar op een lager niveau draaien ze doorgaans nog steeds in Docker. Daarom is het noodzakelijk om logging zo in te stellen dat logboeken van containers worden verzameld. Containers worden gestart door Docker — dat betekent dat we moeten begrijpen hoe logging op het niveau van Docker is georganiseerd.
Ik hoop dat elke lezer weet: applicatielogs moeten naar stdout/stderr worden geschreven, en niet in de container zelf. Logs worden verzameld door de Docker Daemon, en deze werkt alleen met die logs die naar stdout/stderr worden gestuurd. Bovendien kan het schrijven van logs naar binnen de container problemen veroorzaken: de container wordt groter door het groeiende logboek (omdat er waarschijnlijk geen Logrotate in de container aanwezig is), en de Docker Daemon is zich niet bewust van dit logboek.
Docker heeft verschillende log-drivers of plugins voor het verzamelen van containerlogs. In de gratis versie van Docker Community Edition (CE) zijn er minder log-drivers dan in de commerciële Docker Enterprise Edition (EE).
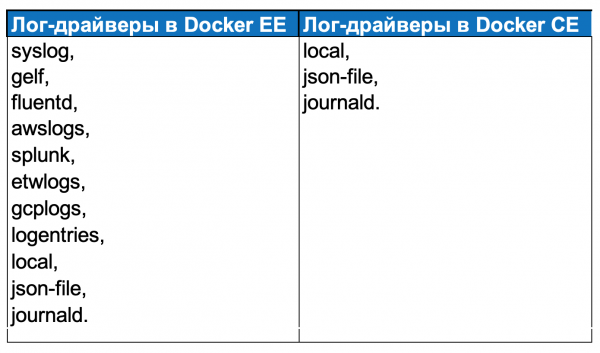
Docker EE heb ik nog nooit in de praktijk gebruikt: bij Southbridge proberen we Open Source-oplossingen te gebruiken, en de meeste aanvullende mogelijkheden van Docker EE zijn niet nodig voor onze klanten.
Log-drivers in Docker CE:
local — het schrijven van logs naar interne bestanden van de Docker Daemon;
json-file — het aanmaken van json-logs in de map van elke container;
journald — het versturen van logs naar journald.
De instellingen voor logging in Docker bevinden zich in het bestand daemon.json.
In het veld “log-driver” geef je de plugin op, en in het veld “log-opts” geef je de instellingen op. In het bovenstaande voorbeeld is de plugin “json-file” opgegeven, met een loggroottebeperking — “max-size”: “10m”; een beperking voor het aantal bestanden (rotatie-instellingen) — “max-file”: “3”; en ook waarden die aan de logs zullen worden toegevoegd.
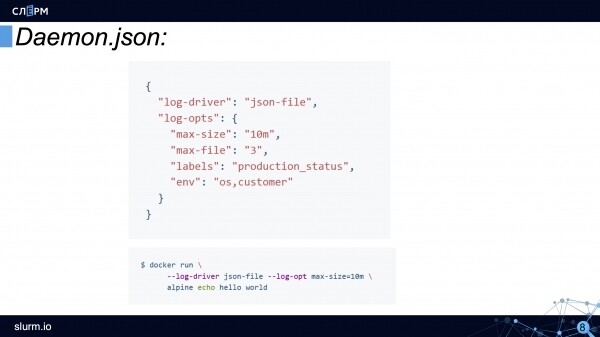
Sommige instellingen van de log-driver kunnen via de opdrachtregelhulpprogramma worden ingesteld. Dit is handig als je een specifieke container met een andere log-driver wilt starten.
Hier ziet de loggingstructuur in Docker eruit:
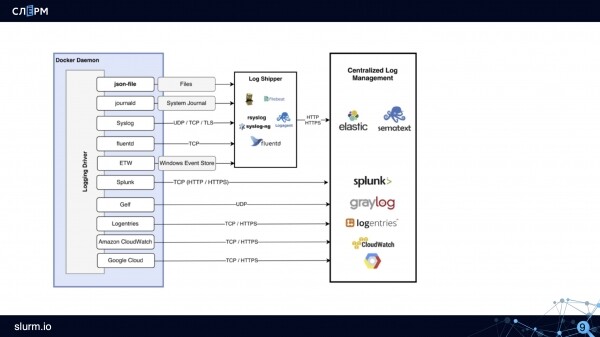
Hoe de structuur werkt: de log-driver, bijvoorbeeld json-file, maakt bestanden aan. Logverzamelaars (Rsyslog, Fluentd, Logagent en anderen) verzamelen deze bestanden en sturen ze op voor opslag in Elastic, Sematext of andere opslagplaatsen.
Kenmerken van logging in Kubernetes
Vereenvoudigd ziet het loggingschema in Kubernetes er als volgt uit: er is een pod, waarin een container draait, en de container verzendt logboeken naar stdout/stderr. Vervolgens creëert Docker een bestand en schrijft de logboeken, die daarna geroteerd kunnen worden.
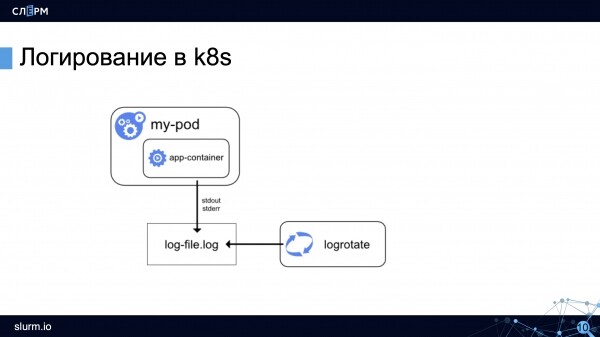
Laten we de kenmerken van logging in Kubernetes bekijken.
Logs tussen deployments bewaren. Dit is een vereiste voor een correcte logging-configuratie. Als logs niet tussen deployments worden bewaard, zullen de logs van de vorige versie bij een nieuwe versie van de applicatie worden overschreven, en het herstarten van de container kan ook leiden tot verlies van logs. Kubernetes heeft een sleutel —previous, waarmee je de logs van de applicatie vóór de laatste herstart van de pod kunt bekijken, maar niet verder terug.
Logs van alle instanties aggregateren. Als microservices in de cloud worden gehost, is de cloudprovider verantwoordelijk voor het systeemtoezicht. Als microservices op eigen hardware draaien, moeten naast de logs van de containers ook de logs van het systeem worden verzameld.
Eerder waren er geen handige tools om logs te verzamelen van zowel het systeem als de microservices. Gewoonlijk verzamelde één tool de systeembestanden (bijvoorbeeld Rsyslog), en een tweede de logs van Docker (bijvoorbeeld journal-bit met de logdriver van Docker ingesteld op journald). We hebben geprobeerd journal-bit te gebruiken - logs van de containers (in de Docker-logdriver aangeven dat logs naar journald moeten worden geschreven) en van het systeem (in CentOS 7 zijn er al systemd en journald). De oplossing werkt, maar is niet ideaal. Als er veel logs zijn, gaat journal-bit vertragen, en gaan berichten verloren.
De experimenten gingen door - en er werd een andere manier gevonden. In CentOS 7 worden de belangrijkste systeembestanden (messages, audit, secure) gedupliceerd in var-log in de vorm van bestanden. In Docker kan ook worden ingesteld dat logs worden bewaard in json-bestanden. Dienovereenkomstig kunnen deze bestanden uit CentOS 7 en Docker samen worden verzameld.
In de loop der tijd werd de oplossing ELK Stack populair. Dit is een combinatie van verschillende tools: Elasticsearch, Logstash en Kibana.
Elasticsearch bewaart logs van de containers, Logstash verzamelt logs van de instanties, Kibana stelt in staat om de ontvangen logs te verwerken en er grafieken van te maken. Een tijdje werd de ELK Stack actief gebruikt, maar naar mijn mening is de tijd voorbij. Later zal ik uitleggen waarom.
Metadata toevoegen. Pods, applicaties en containers kunnen overal worden uitgevoerd. Bovendien kan één applicatie meerdere instanties hebben. Logs worden in één formaat vastgelegd, en we moeten begrijpen welke replica dit is, welk Pod dit schrijft en in welke namespace het zich bevindt. Daarom moeten er metadata aan de logs worden toegevoegd.
Logs parseren. Het is grappig, maar de kosten voor het ondersteunen van het logging- en monitoringsysteem kunnen hoger zijn dan de kosten voor de applicatie zelf. Wanneer je tientallen en honderden duizenden logs per seconde hebt, lijkt dit vanzelfsprekend, maar het is toch belangrijk om de grens te kennen. Een manier om die grens te vinden is door logs te parseren.
Over het algemeen is het niet nodig om alle logs te verzamelen en op te slaan; je moet alleen een deel opslaan — bijvoorbeeld logs met de status 'warning' of 'error'. Als het gaat om logs van nginx of ingress-controllers, kunnen alleen die logs met een status anders dan 200 worden opgeslagen. Maar dit is geen universeel advies: als je op de een of andere manier analytics op Nginx-logs bouwt, dan is het duidelijk dat je ze moet verzamelen.
Blinde filtering van logs wordt niet aanbevolen, omdat gefilterde gegevens onvoldoende kunnen zijn voor normale analyses. Aan de andere kant, misschien is het beter om analytics niet op het niveau van logging, maar op het niveau van het verzamelen van metrics uit te voeren. Dan hoef je niet honderden duizenden regels met code 200 op te slaan. Een van de benaderingen is om informatie over verkeer en fouten uit metrics van ingress-controllers te halen.
In het algemeen moet je hier goed over nadenken: wat wil je opslaan en hoe lang, omdat anders de situatie kan ontstaan waarin het logging-systeem meer middelen gebruikt dan het hoofdproject.
Er is nog geen standaard oplossing voor logging. In tegenstelling tot monitoring, waar er één veelgebruikte oplossing is, namelijk Prometheus, is er in logging geen standaard.
In deze lezing zullen we twee tools bespreken: één populaire en de andere die aan populariteit wint. Naast deze zijn er nog anderen, maar die zullen we in dit artikel niet behandelen.
Gezien al deze bovenstaande kenmerken kan logging in Kubernetes nu worden weergegeven in de volgende schematische weergave:
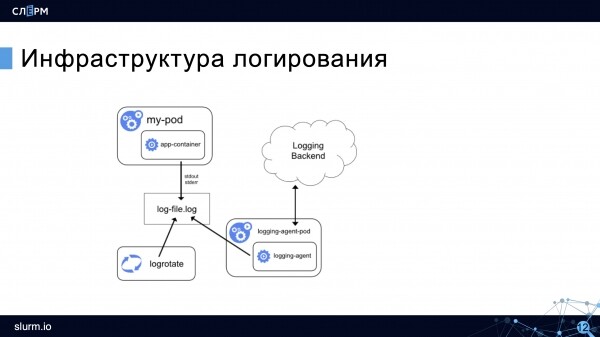
Er blijft de log van de container, rotatie, maar er verschijnt een verzamelagent die de logs verzamelt en opslaat (in het schema — in de Logging Backend). De agent draait op elke node en is doorgaans in Kubernetes uitgevoerd.
Laten we nu de tools voor logging bekijken.
Grafana Loki
is onlangs verschenen maar is al vrij bekend geworden. De voordelen zijn: het is eenvoudig te installeren, verbruikt weinig middelen en vereist geen Elasticsearch, aangezien het gegevens opslaat in TSDB (time series database). In het vorige artikel schreef ik dat Prometheus dergelijke gegevens opslaat, en dit is een van de vele overeenkomsten tussen de twee producten. De ontwikkelaars beweren zelfs dat Loki "Prometheus voor de wereld van logging" is.
Een kleine uitweiding over TSDB voor degenen die het niet hebben gelezen : TSDB is uitstekend in het opslaan van grote hoeveelheden gegevens, tijdreeksen, maar is niet bedoeld voor langdurige opslag. Als je om een of andere reden logs langer dan twee weken moet opslaan, is het beter om hun overdracht naar een andere database te configureren.
Een ander voordeel van Loki is dat Grafana wordt gebruikt voor de visualisatie van gegevens. Erg handig: in Grafana bekijken we de gegevens van de monitoring en kunnen we, door Loki aan te sluiten, ook de logs bekijken. Op basis van logs kunnen grafieken worden opgebouwd.
De architectuur van Loki ziet er ongeveer zo uit:
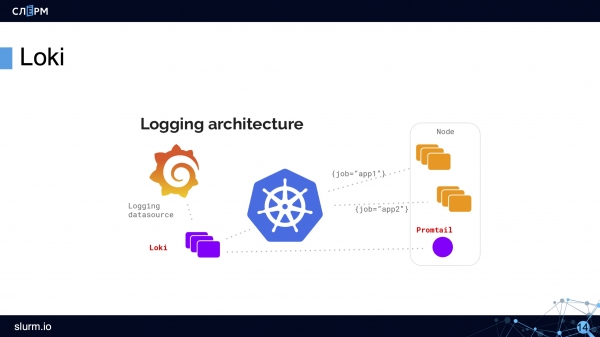
Met behulp van DaemonSet wordt op alle servers in de cluster een agent uitgerold — Promtail of Fluent Bit. De agent verzamelt logs. Loki haalt deze op en slaat ze op in TSDB. Metadata worden meteen aan de logs toegevoegd, wat handig is: je kunt filteren op Pods, namespaces, container namen en zelfs labels.
Loki werkt in de vertrouwde Grafana-interface. Loki heeft zelfs zijn eigen querytaal, genaamd LogQL — die qua naam en syntaxis lijkt op PromQL in Prometheus. In de interface van Loki zijn er suggesties voor queries, dus het is niet noodzakelijk om ze uit het hoofd te leren.
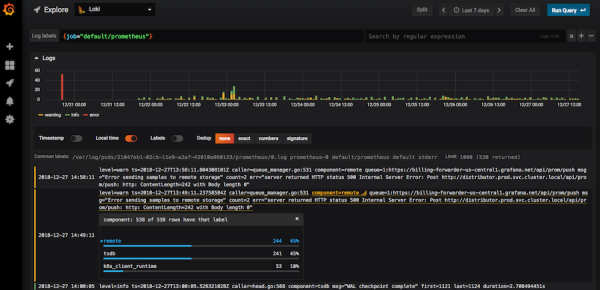
Loki in de Grafana-interface
Met behulp van filters kun je in Loki codes vinden ("400", "404" en elke andere); de logs van de hele node bekijken; alle logs filteren waarin het woord "error" voorkomt. Als je op een log klikt, wordt er een kaart geopend met alle informatie over het evenement.
Loki heeft voldoende tools waarmee je de nodige logs kunt extraheren, hoewel ik eerlijk moet toegeven dat er technisch gezien meer hadden kunnen zijn. Loki ontwikkelt zich momenteel actief en wint aan populariteit.
Elastic + Fluent Bit + Kibana (EFK Stack)
De EFK-stack is een meer klassieke en tegelijkertijd niet minder populaire loggingtool.
Aan het begin van het artikel werd ELK (Elasticsearch + Logstash + Kibana) genoemd, maar deze stack is verouderd vanwege de weinig presterende en bovendien resource-intensieve Logstash. In plaats daarvan werd de meer lichte en efficiënte Fluentd gebruikt, en na enige tijd kwam daar bij, een nog lichtere en nog efficiëntere verzamelagent.
Als we de ontwikkelaars mogen geloven, is Fluent Bit meer dan 100 keer beter qua prestaties dan Fluentd: "waar Fluentd 20 MB RAM verbruikt, verbruikt Fluent Bit 150 KB" — een directe citatie uit de documentatie. Gezien dit, is Fluent Bit steeds vaker gebruikt.
Fluent Bit heeft minder mogelijkheden dan Fluentd, maar sluit de basisbehoeften af, daarom gebruiken wij voornamelijk Fluent Bit.
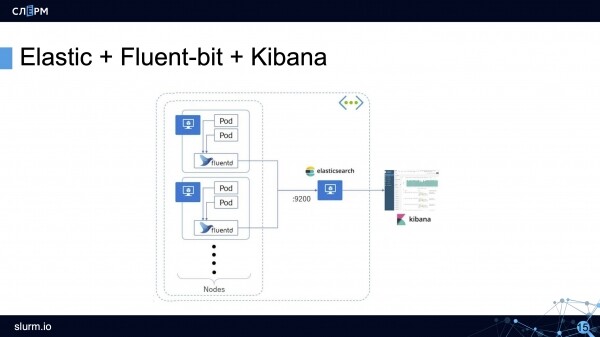
Het werkingsschema van de EFK-stack: de agent verzamelt logs van alle pods (meestal een DaemonSet dat op alle servers van het cluster draait) en verstuurt deze naar de opslag (Elasticsearch, PostgreSQL of Kafka). Kibana maakt verbinding met de opslag en haalt daar de benodigde informatie vandaan.
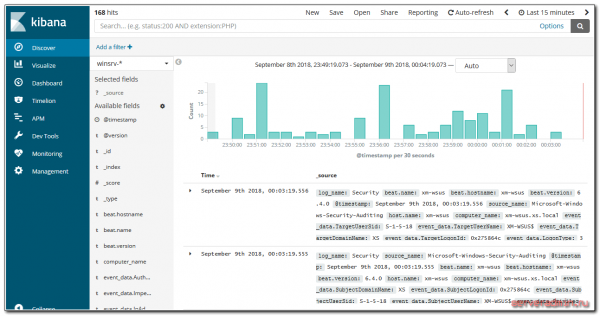
presenteert de informatie in een gebruiksvriendelijke webinterface. Er zijn grafieken, filters en nog veel meer.
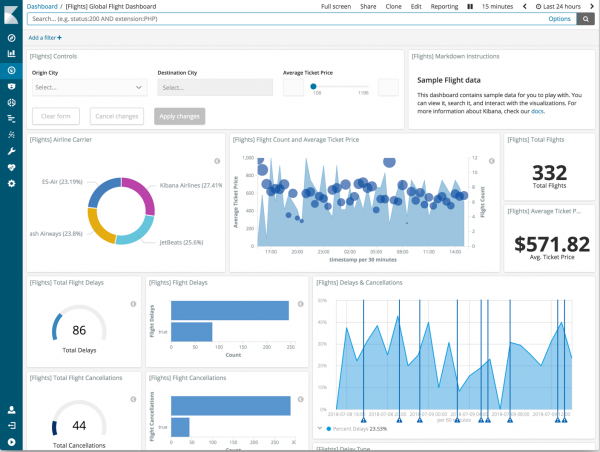
Op basis van logs kunnen hele dashboards worden gecreëerd.
Mogelijkheden van Fluent Bit
Aangezien Fluent Bit meestal minder bekend is dan Logstash, laten we het wat gedetailleerder bekijken. Fluent Bit kan logisch worden verdeeld in 6 modules, waarvoor sommige modules plugins kunnen worden toegevoegd, die de mogelijkheden van Fluent Bit uitbreiden.
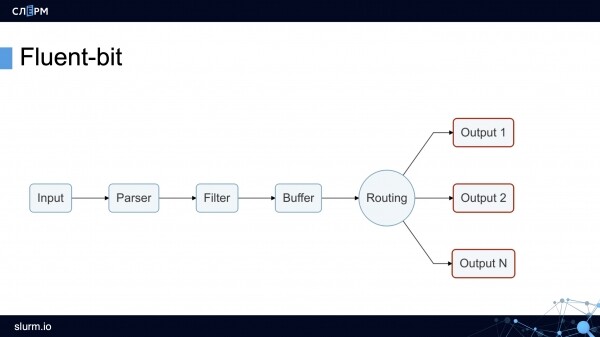
Input Module verzamelt logs uit bestanden, systemd-diensten en zelfs uit tcp-socket (je hoeft alleen maar de endpoint op te geven, en Fluent Bit begint daarheen te gaan). Deze mogelijkheden zijn voldoende om zowel logs van het systeem als van containers te verzamelen.
In productie gebruiken we meestal de plugins (je kunt het richten op een map met logs) en (je kunt aangeven uit welke diensten de logs verzameld moeten worden).
Parser Module brengt de logs in een uniforme vorm. Standaard zijn Nginx-logs een string. Met behulp van een plugin kan deze string worden omgevormd tot JSON: velden en hun waarden instellen. Met JSON is het veel gemakkelijker om te werken dan met een tekstlog, omdat er flexiblere sorteeropties zijn.
Filter Module. Op dit niveau worden onnodige logs weggefilterd. Bijvoorbeeld, er worden alleen logs met de waarde “warning” of met bepaalde labels naar de opslag gestuurd. De geselecteerde logs komen in de buffer terecht.
Buffer ModuleFluent Bit heeft twee soorten buffers: een geheugenbuffer en een schijfbuffer. Een buffer is een tijdelijke opslag voor logs, nodig in geval van fouten of storingen. Iedereen wil besparen op RAM, daarom kiest men meestal voor een schijfbuffer. Maar je moet er rekening mee houden dat logs altijd in het geheugen worden geladen voordat ze naar de schijf gaan.
Routing/Output-module bevat regels en adressen voor het verzenden van logs. Zoals eerder vermeld, kunnen logs worden verzonden naar Elasticsearch, PostgreSQL of bijvoorbeeld Kafka.
Interessant is dat logs vanuit Fluent Bit ook naar Fluentd kunnen worden verzonden. Aangezien de eerste lichter en minder functioneel is, kunnen logs worden verzameld en naar Fluentd worden verzonden, waar ze met behulp van extra plugins verder kunnen worden verwerkt en naar opslag kunnen worden verzonden.
Als je van plan bent Elasticsearch te gebruiken...
Tot slot twee tips voor degenen die van plan zijn Elasticsearch als logopslag in productie te gebruiken.
- Stel meldingen in met . Dit programma haalt belangrijke berichten uit de algemene logstroom en genereert meldingen per e-mail of een ander kanaal. Echter, niet zo lang geleden kwam er .
- Rotatie van logs met behulp van de applicatie of via de API-aanroep naar Elasticsearch. Elastic maakt tegenwoordig immers aanzienlijke stappen in het beheren van de levenscyclus van indexen zonder gebruik te maken van externe tools. Kortom, er is eigenlijk geen enkele reden om logs langdurig op te slaan: het is onwaarschijnlijk dat een log na twee weken nog nodig is - als het echt kritiek is, zal het binnen twee weken zeker zijn behandeld. In het uiterste geval kunnen oude logs worden gearchiveerd en ergens voor langdurige opslag worden verzonden. Ik heb gehoord van speciale logs die wettelijk tot 5 jaar moeten worden bewaard. Persoonlijk heb ik daar niet mee te maken gehad, maar ik zou dergelijke informatie niet gelijkstellen aan gewone logs, en misschien zelfs apart bewaren.
Wordt vervolgd…
Auteur: Marcel Ibrajev, gecertificeerd Kubernetes-beheerder, praktiserend engineer bij , spreker en ontwikkelaar van cursussen .
Bron: habr.com
