

TL;DR
- Om een hoge observability van containers en microservices te bereiken, zijn logs en primaire metrics niet genoeg.
- Voor snellere herstel en verhoogde beschikbaarheid moeten applicaties het Hoge Observability Principe (HOP, High Observability Principle) toepassen.
- Op applicatieniveau vereist HOP: juiste logging, zorgvuldige monitoring, liveliness checks en performance tracing/transities.
- Gebruik liveliness checks als onderdeel van HOP. readinessProbe en livenessProbe Kubernetes.
Wat is een liveliness check sjabloon?
Bij het ontwerpen van kritieke en hoog beschikbare applicaties is het belangrijk om na te denken over aspecten zoals beschikbaarheid. Een applicatie wordt als beschikbaar beschouwd als deze snel herstelt na een storing. Een typische cloudapplicatie gebruikt een microservices-architectuur, waarbij elke component in een aparte container wordt geplaatst. Om ervoor te zorgen dat de applicatie op k8s hoog beschikbaar is, moet je bij het ontwerpen van een cluster bepaalde sjablonen volgen. Een daarvan is het sjabloon voor liveliness checks. Dit definieert hoe de applicatie aan k8s rapporteert over zijn beschikbaarheid. Het gaat niet alleen om de informatie of de pod draait, maar ook over hoe deze aanvragen accepteert en erop reageert. Hoe meer Kubernetes weet over de beschikbaarheid van de pod, hoe slimmer het beslissingen kan nemen over verkeersroutering en load balancing. Op deze manier kan het Hoge Observability Principe de applicatie tijdig laten reageren op aanvragen.
Hoge Observability Principe (HOP)
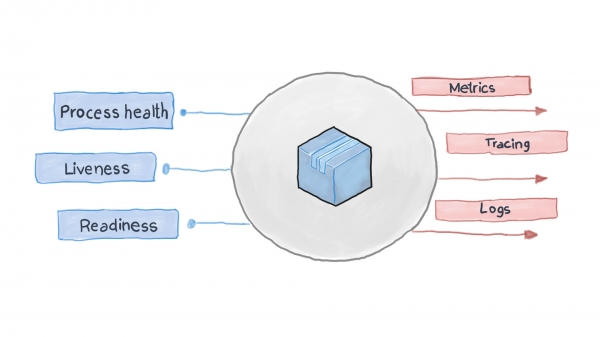
Het Hoge Observability Principe is een van de . In een microservicesarchitectuur maakt het de services niet uit hoe hun aanvraag wordt verwerkt (en dat is ook correct), maar het is belangrijk hoe antwoorden van de ontvangende services worden verkregen. Bijvoorbeeld, voor de authenticatie van een gebruiker verstuurt een container een HTTP-verzoek naar een andere, waarbij op een specifiek formaat wordt gewacht voor het antwoord – dat is alles. De aanvraag kan worden verwerkt door PythonJS, en het antwoord komt van Python Flask. Containers zijn voor elkaar als zwarte dozen met verborgen inhoud. Echter, het principe van NOR vereist dat elke service verschillende API-eindpunten onthult die laten zien hoe operationeel hij is, evenals de status van zijn gereedheid en fouttolerantie. Deze indicatoren worden opgevraagd door Kubernetes om na te denken over de volgende stappen voor routering en load balancing.
Een goed ontworpen cloudapplicatie logt zijn belangrijkste gebeurtenissen met behulp van de standaard invoer- en uitvoerstromen STDERR en STDOUT. Vervolgens draait er een hulpprogramma, zoals filebeat, logstash of fluentd, dat de logs naar een gecentraliseerd monitoringssysteem (zoals Prometheus) en een logverzamelingssysteem (de ELK-stack) verzendt. In het onderstaande diagram wordt geïllustreerd hoe een cloudapplicatie werkt volgens het Health Check Pattern en het High Observability Principle.
Hoe het Health Check Pattern toe te passen in Kubernetes?
K8s monitort standaard de status van pods met behulp van een van de controllers (, , , en meer). Wanneer een controller ontdekt dat een pod om bepaalde redenen is neergestort, probeert deze de pod opnieuw te starten of deze naar een andere knooppunt te verplaatsen. Echter, een pod kan rapporteren dat deze is gestart en draait, terwijl deze in werkelijkheid niet functioneert. Stel je bijvoorbeeld voor: je applicatie gebruikt Apache als webserver, en je hebt componenten op meerdere pods in het cluster geïnstalleerd. Omdat de bibliotheek verkeerd was geconfigureerd, reageren alle aanvragen naar de applicatie met code 500 (interne serverfout). Bij de statuscontrole geeft de controle over de pods een succesvolle uitkomst, maar de klanten hebben een andere ervaring. We beschrijven deze ongewenste situatie als volgt:
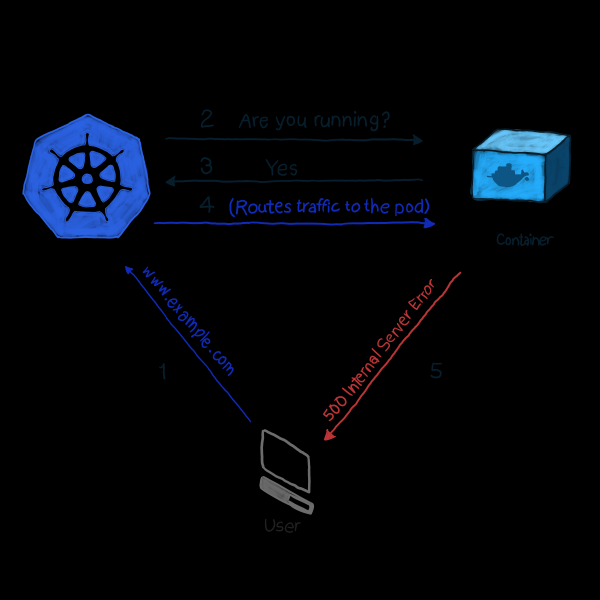
In ons voorbeeld voert k8s een gezondheidscontrole uitIn this type of check, kubelet continuously checks the state of the process in the container. As soon as it detects that the process has stopped, it restarts it. If the error can be resolved simply by restarting the application, and the program is designed to shut down on any error, then to follow the LIVENESS PROBE and Health Check Template, a health check of the process is sufficient. It's just a pity that not all errors can be resolved by a restart. For this case, k8s offers two deeper methods to diagnose issues with the pod's operation: en .
LivenessProbe
During livenessProbe kubelet performs three types of checks: it not only determines whether the pod is running but also whether it is ready to receive and adequately respond to requests:
- Set up an HTTP request to the pod. The response must contain an HTTP status code in the range of 200 to 399. Thus, the 5xx and 4xx codes signal that the pod has issues, even if the process is running.
- To check pods with non-HTTP services (for example, the Postfix mail server), a TCP connection must be established.
- Executing an arbitrary command for the pod (internally). The check is considered successful if the command's exit code is 0.
An example of how this works. The definition of the following pod contains a NodeJS application that returns a 500 error on HTTP requests. To ensure that the container is restarted upon receiving such an error, we use the livenessProbe parameter:
apiVersion: v1
kind: Pod
metadata:
 name: node500
spec:
 containers:
   - image: magalix/node500
     name: node500
     ports:
       - containerPort: 3000
         protocol: TCP
     livenessProbe:
       httpGet:
         path: /
         port: 3000
       initialDelaySeconds: 5
This is no different from any other pod definition, but we add the object .spec.containers.livenessProbe. De parameter httpGet takes the path to which an HTTP GET request is sent (in our example, this is /, but in production scenarios, it can be something like /api/v1/status). In addition, the livenessProbe accepts the parameter initialDelaySeconds, which instructs the check operation to wait a specified number of seconds. The delay is necessary because the container needs time to start, and upon restart, it will be unavailable for a while.
To apply this setting to the cluster, use:
kubectl apply -f pod.yamlAfter a few seconds, you can check the contents of the pod using the following command:
kubectl describe pods node500At the end of the output, find .
Zoals je kunt zien, heeft livenessProbe een HTTP GET-verzoek gestart, en de container gaf een fout 500 terug (wat geprogrammeerd was), waarna kubelet deze opnieuw opstartte.
Als je benieuwd bent naar hoe de NideJS-applicatie is geprogrammeerd, hier zijn het bestand app.js en Dockerfile die werden gebruikt:
app.js
var http = require('http');

var server = http.createServer(function(req, res) {
    res.writeHead(500, { "Content-type": "text/plain" });
    res.end("We hebben een fout tegengekomen");
});

server.listen(3000, function() {
    console.log('Server draait op 3000')
})
Dockerfile
FROM node
COPY app.js /
EXPOSE 3000
ENTRYPOINT [ "node","/app.js" ]
Het is belangrijk om op het volgende te letten: livenessProbe start de container opnieuw alleen bij een storing. Als de herstart de fout die de werking van de container verstoort niet oplost, kan kubelet geen maatregelen nemen om het probleem op te lossen.
readinessProbe
readinessProbe werkt op dezelfde manier als livenessProbes (GET-verzoeken, TCP-verbindingen en het uitvoeren van commando's), behalve bij foutopsporing. Een container die een storing heeft, wordt niet opnieuw opgestart, maar geïsoleerd van binnenkomend verkeer. Stel je voor, een van de containers voert veel berekeningen uit of wordt zwaar belast, waardoor de responstijd op verzoeken toeneemt. In het geval van livenessProbe wordt de beschikbaarheidscontrole uitgevoerd (via de parameter timeoutSeconds), waarna kubelet de container opnieuw opstart. Bij de herstart begint de container resource-intensieve taken uit te voeren, en deze wordt opnieuw opnieuw opgestart. Dit kan kritisch zijn voor toepassingen waarbij reactiesnelheid belangrijk is. Bijvoorbeeld, een machine onderweg wacht op een antwoord van de server, als het antwoord vertraagd is - en de machine heeft een ongeluk.
Laten we een definitie van readinessProbe schrijven die de responstijd op een GET-verzoek op maximaal twee seconden instelt, terwijl de applicatie na 5 seconden op een GET-verzoek reageert. Het bestand pod.yaml moet er als volgt uitzien:
apiVersion: v1
kind: Pod
metadata:
 name: nodedelayed
spec:
 containers:
   - image: afakharany/node_delayed
     name: nodedelayed
     ports:
       - containerPort: 3000
         protocol: TCP
     readinessProbe:
       httpGet:
         path: /
         port: 3000
       timeoutSeconds: 2
Laten we de pod uitrollen met kubectl:
kubectl apply -f pod.yamlWe wachten een paar seconden en kijken dan hoe de readinessProbe heeft gewerkt:
kubectl describe pods nodedelayedAan het einde van de output kun je zien dat sommige gebeurtenissen gelijk zijn aan .
Zoals je kunt zien, heeft kubectl de pod niet opnieuw opgestart toen de controle tijd meer dan 2 seconden overschreed. In plaats daarvan werd het verzoek geannuleerd. Binnenkomende verbindingen worden omgeleid naar andere, werkende pods.
Opmerking: nu de extra belasting van de pod is verwijderd, stuurt kubectl opnieuw aanvragen naar deze pod: antwoorden op GET-verzoeken worden niet meer vertraagd.
Ter vergelijking: hieronder is het gewijzigde bestand app.js:
var http = require('http');

var server = http.createServer(function(req, res) {
   const sleep = (milliseconds) => {
       return new Promise(resolve => setTimeout(resolve, milliseconds))
   }
   sleep(5000).then(() => {
       res.writeHead(200, { "Content-type": "text/plain" });
       res.end("Hellon");
   })
});

server.listen(3000, function() {
   console.log('Server draait op 3000')
})
TL;DR
Voor de opkomst van cloudtoepassingen waren logs het belangrijkste middel voor monitoring en het controleren van applicatiestatussen. Er waren echter geen middelen beschikbaar om problemen op te lossen. Logs zijn ook vandaag de dag nuttig, ze moeten worden verzameld en naar een logsysteem worden gestuurd voor de analyse van incidenten en het nemen van beslissingen. [dit kon ook zonder cloudtoepassingen met behulp van monit, bijvoorbeeld, maar met k8s is dit veel eenvoudiger geworden 🙂 – red. opmerking. ]
Vandaag de dag moeten aanpassingen bijna in real-time worden aangebracht, waardoor applicaties niet langer 'zwarte dozen' mogen zijn. Nee, ze moeten eindpunten tonen die monitoring systemen in staat stellen waardevolle gegevens over de status van processen op te vragen en te verzamelen, zodat in geval van nood onmiddellijk kan worden gereageerd. Dit wordt het Ontwerppatroon voor Gezondheidscontroles genoemd, dat het Principe van Hoge Observeerbaarheid (HOB) volgt.
Kubernetes biedt standaard 2 soorten gezondheidscontroles: readinessProbe en livenessProbe. Beide gebruiken dezelfde soorten controles (HTTP GET-verzoeken, TCP-verbindingen en het uitvoeren van commando's). Het verschil zit in de beslissingen die worden genomen als reactie op fouten in de pods. livenessProbe herstart de container in de hoop dat de fout zich niet meer zal voordoen, terwijl readinessProbe de pod isoleert van binnenkomend verkeer – totdat de oorzaak van de storing is verholpen.
Een goede applicatiedesign moet beide soorten controles omvatten en voldoende gegevens verzamelen, vooral wanneer er een uitzonderlijke situatie is ontstaan. Het moet ook de benodigde API-eindpunten tonen die belangrijke metrics voor de status van de beschikbaarheid naar het monitoringsysteem (zoals Prometheus) verzenden.
Bron: habr.com
