

Hallo, Habr! We nodigen Data Engineers en Machine Learning-specialisten uit voor een gratis demo-les . Daarnaast publiceren we een artikel van Luca Monno — Hoofd Financiële Analytics bij CDP SpA.
Een van de meest nuttige en eenvoudigste methoden van machine learning is Ensemble Learning. Ensemble Learning is een methode die ten grondslag ligt aan XGBoost, bagging, random forest en vele andere algoritmes.
Op Towards Data Science zijn er veel geweldige artikelen, maar ik heb twee verhalen gekozen ( en ), die mij het meest aanspraken. Dus waarom nog een artikel over EL schrijven? Omdat ik u wil laten zien, hoe het werkt aan de hand van een eenvoudig voorbeeld, dat mij deed beseffen dat er hier geen magie aan te pas komt.
Toen ik EL voor het eerst in actie zag (in combinatie met een aantal zeer eenvoudige regressiemodellen), kon ik mijn ogen niet geloven, en ik herinner me nog steeds de professor die me deze methode leerde.
Ik had twee verschillende modellen (twee zwakke leeralgoritmes) met out-of-sample R²waarden van respectievelijk 0,90 en 0,93. Voordat ik het resultaat bekeek, dacht ik dat ik een R² zou krijgen ergens tussen de twee oorspronkelijke waarden. Met andere woorden, ik geloofde dat EL kon worden gebruikt om de prestaties van het slechtste model niet zo slecht te laten zijn, maar ook niet zo goed als het beste model.
Tot mijn grote verbazing gaf het simpele gemiddelde van de voorspellingen een R² van 0,95.
In eerste instantie begon ik de fout te zoeken, maar later dacht ik dat er misschien wel magie in het spel was!
Wat is Ensemble Learning
Met EL kunnen de voorspellingen van twee of meer modellen worden samengevoegd om een betrouwbaardere en krachtigere model te creëren. Er zijn verschillende methodologieën voor het werken met ensemblemodellen. Hier zal ik twee van de meest nuttige bespreken om een algemeen idee te geven.
Met regressie kan het gemiddelde van de bestaande modellen worden genomen.
Met classificatie kan modellen de labels laten kiezen. Het label dat het vaakst is gekozen, is wat door het nieuwe model zal worden gekozen.
Waarom EL beter werkt
De belangrijkste reden waarom EL beter presteert, is dat elke voorspelling een fout heeft (we weten dit uit de waarschijnlijkheidstheorie); het combineren van twee voorspellingen kan helpen de fout te verminderen en daardoor de prestaties (RMSE, R², enz.) te verbeteren.
In de volgende diagram is te zien hoe twee zwakke algoritmen werken met een dataset. Het eerste algoritme heeft een grotere helling dan nodig is, terwijl die van de tweede bijna nul is (mogelijk door overmatige regulering). Maar ensemble toont veel betere resultaten.
Als we naar de R²-waarde kijken, dan zal deze voor de eerste en tweede trainingsalgoritmes respectievelijk -0,01¹ en 0,22 zijn, terwijl de ensemblewaarde 0,73 bedraagt.
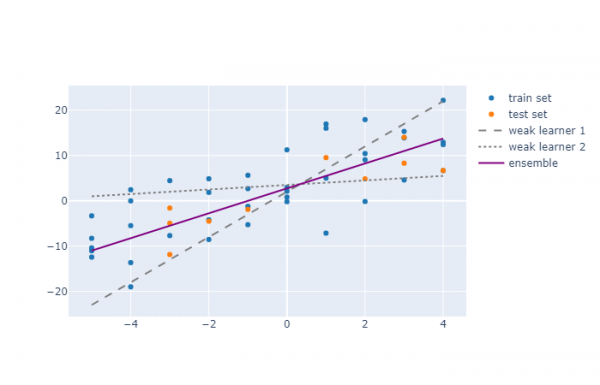
Er zijn veel redenen waarom een algoritme een slechte model kan zijn, zelfs in zo'n basisvoorbeeld als dit: mogelijk heb je ervoor gekozen om regulatie te gebruiken om overfitting te voorkomen, of je besloot om bepaalde anomalieën niet uit te sluiten, of misschien heb je een polynomiale regressie gebruikt en een verkeerde graad gekozen (bijvoorbeeld, je gebruikte een tweede-graads polynoom terwijl op de testdata een duidelijke asymmetrie zichtbaar was waarvoor een derde graad beter had gewerkt).
Wanneer EL beter presteert
Laten we twee trainingsalgoritmes bekijken die met dezelfde gegevens werken.
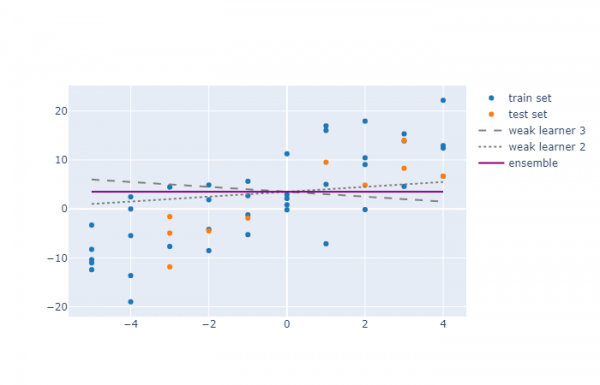
Hieruit blijkt dat de combinatie van twee modellen de prestaties niet significant heeft verbeterd. Aanvankelijk had de R²-waarde voor de twee trainingsalgoritmes respectievelijk -0,37 en 0,22, terwijl die voor het ensemble -0,04 was. Dat wil zeggen, het EL-model had gemiddelde prestaties.
Er is echter een groot verschil tussen deze twee voorbeelden: in het eerste voorbeeld waren de fouten van de modellen negatief gecorreleerd, terwijl in het tweede voorbeeld ze positief gecorreleerd waren (de coëfficiënten van de drie modellen werden niet beoordeeld, maar simpelweg door de auteur gekozen als voorbeeld).
Daarom kan Ensemble Learning worden gebruikt om de balans tussen bias/varietà te verbeteren in elke situatie, maar wanneer de fouten van de modellen niet positief gecorreleerd zijn, kan het gebruik van EL leiden tot een verbetering van de prestaties..
Homogene en heterogene modellen
Ensemble Learning (EL) wordt vaak gebruikt met homogeen modellen (zoals in dit voorbeeld of in een random forest), maar in werkelijkheid kunt u verschillende modellen combineren (lijnregressie + neurale netwerken + XGBoost) met verschillende sets verklarende variabelen. Dit zal waarschijnlijk leiden tot niet-gecorreleerde fouten en een verbetering van de prestaties.
Vergelijking met portefeuilediversificatie
EL werkt op basis van diversificatie in portefeuilletheorie, maar hoe beter voor ons.
Bij diversificatie probeert u de variantie van uw prestaties te verminderen door te investeren in niet-gecorreleerde aandelen. Een goed gediversifieerde aandelenportefeuille zal een beter rendement opleveren dan het slechtste afzonderlijke aandeel, maar nooit beter dan het beste.
Citerend Warren Buffett:
„Diversificatie is een bescherming tegen onwetendheid, voor degenen die niet weten wat ze doen, heeft het [diversificatie] weinig zin.”
In machine learning helpt EL de variantie van uw model te verminderen, maar dit kan leiden tot het creëren van een model met een algehele prestatie die beter is dan het beste oorspronkelijke model.
Laten we de resultaten samenvatten
Het combineren van verschillende modellen in één is een relatief eenvoudige methode die kan helpen bij het probleem van variantie-bias en het verbeteren van de prestaties.
Als u twee of meer modellen heeft die goed werken, kies dan niet tussen hen: gebruik ze allemaal (maar met voorzichtigheid)!
Bent u geïnteresseerd in deze richting? Schrijf u in voor een gratis demo-les en neem deel aan — Machine Learning Engineer bij Mail.ru Group.
Bron: habr.com
