

Data-analyse op basis van inhoud is een open vraag. Traditionele systemen voor gegevensverliespreventie (DLP) lossen dit probleem op door vingerafdrukken van relevante gegevens te maken en eindpunten te monitoren voor vingerafdrukken. Gezien het grote aantal voortdurend veranderende gegevensbronnen op Facebook, is deze aanpak niet alleen niet schaalbaar, maar ook ineffectief voor het identificeren van waar de gegevens zich bevinden. Dit artikel behandelt een end-to-end systeem dat is gebouwd voor het opsporen van gevoelige semantische types op Facebook op schaal en voor het automatisch waarborgen van gegevensopslag en toegangscontrole.
De aanpak die hier wordt beschreven is ons eerste end-to-end privacy systeem, dat probeert dit probleem op te lossen door gegevenssignalen, machine learning en traditionele vingerafdrukmethoden in te voegen om alle gegevens op Facebook te tonen en te classificeren. Het beschreven systeem wordt in een productieomgeving gebruikt en haalt een gemiddelde F2-score van 0,9+ voor verschillende privacyklassen bij het verwerken van een groot aantal gegevensbronnen in tientallen opslagplaatsen. We presenteren de vertaling van de Facebook-publicatie op ArXiv over schaalbare gegevensclassificatie voor beveiliging en privacy op basis van machine learning.
Inleiding
Tegenwoordig verzamelen en slaan organisaties grote hoeveelheden gegevens op in verschillende formats en locaties [1]. Deze gegevens worden vervolgens op veel plaatsen gebruikt en soms meerdere keren gekopieerd of in cache opgeslagen, waardoor waardevolle en gevoelige zakelijke informatie verspreid raakt over verschillende bedrijfsdatabases. Wanneer een organisatie verplicht is om aan bepaalde juridische of regelgevende eisen te voldoen, zoals het naleven van voorschriften tijdens civiele rechtszaken, ontstaat de behoefte aan het verzamelen van gegevens over de locatie van de juiste informatie. Wanneer in een privacybevel wordt aangegeven dat een organisatie alle sociale zekerheidsnummers (SSN) moet maskeren bij het doorgeven van persoonlijke informatie aan niet-geautoriseerde partijen, is de logische eerste stap het zoeken naar alle SSN in de databases van de hele organisatie. In dergelijke situaties is data-classificatie van cruciaal belang [1]. Een classificatiesysteem stelt organisaties in staat om automatisch te voldoen aan privacy- en beveiligingsbeleid, zoals het implementeren van toegangscontrolebeleid en gegevensretentie. Facebook presenteert een systeem dat wij bij Facebook hebben ontwikkeld, dat gebruikmaakt van meerdere gegevenssignalen, een schaalbare systeemarchitectuur en machine learning voor het detecteren van gevoelige semantische datatypes.
Gegevensdetectie en -classificatie zijn het zoeken en labelen van gegevens zodat relevante informatie snel en efficiënt kan worden opgehaald indien nodig. Het huidige proces is eerder handmatig en bestaat uit het bestuderen van relevante wetten of regelgeving, het bepalen van welke soorten informatie als gevoelig moeten worden beschouwd en wat de verschillende niveaus van gevoeligheid zijn, en het vervolgens opzetten van klassen en classificatiebeleid [1]. Na het opzetten van een data loss prevention (DLP) systeem worden er vingerafdrukken van de gegevens gemaakt en worden eindpunten stroomafwaarts gevolgd om deze vingerafdrukken te verkrijgen. Bij het werken met een opslagplaats met veel activa en petabytes aan gegevens is deze aanpak simpelweg niet schaalbaar.
Ons doel is om een gegevensclassificatiesysteem te bouwen dat schaalbaar is voor zowel persistente als niet-persistente gebruikersgegevens, zonder enige extra beperkingen op het type of formaat van de gegevens. Dit is een gedurfde ambitie en brengt uiteraard uitdagingen met zich mee. Een enkele gegevensrecord kan duizenden tekens lang zijn.
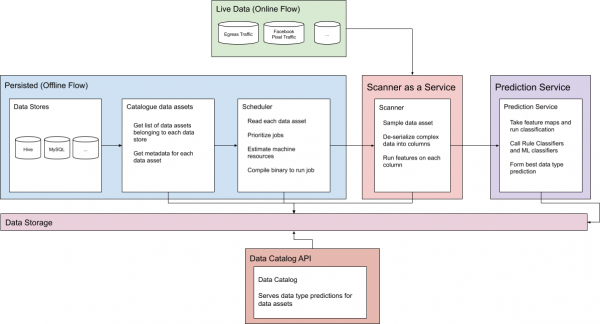
Figuur 1. Stromen van online en offline voorspelling
Daarom moeten we het effectief voorstellen met een set gemeenschappelijke kenmerken die later kunnen worden gecombineerd en gemakkelijk verplaatst. Deze kenmerken moeten niet alleen zorgdragen voor een nauwkeurige classificatie, maar ook flexibiliteit en uitbreidbaarheid bieden voor het eenvoudig toevoegen en ontdekken van nieuwe datatypen in de toekomst. Ten tweede moeten we omgaan met grote autonome tabellen. Persistente gegevens kunnen worden opgeslagen in tabellen van vele petabytes. Dit kan leiden tot een lagere scansnelheid. Ten derde moeten we voldoen aan strikte SLA-classificatie voor niet-persistente gegevens. Dit dwingt het systeem om zeer efficiënt, snel en nauwkeurig te zijn. Tot slot moeten we zorgen voor data-classificatie met lage latentie voor niet-persistente gegevens, zodat classificatie in real-time kan plaatsvinden, evenals voor internetgebruik.
In dit artikel bespreken we hoe we bovenstaande problemen hebben aangepakt en presenteren we een snel en schaalbaar classificatiesysteem dat gegevensitems van alle typen, formaten en bronnen classificeert op basis van een set gemeenschappelijke kenmerken. We hebben de systeemarchitectuur uitgebreid en een speciaal model voor machine learning ontwikkeld voor snelle classificatie van offline en online gegevens. Dit artikel is als volgt georganiseerd: in sectie 2 wordt het algemene ontwerp van het systeem gepresenteerd. In sectie 3 worden de onderdelen van het machine learning-systeem besproken. In secties 4 en 5 wordt gerelateerde arbeid besproken en wordt de toekomst van het werk geschetst.
Architectuur
Om de uitdagingen van persistente en online gegevens op de schaal van Facebook aan te pakken, heeft het classificatiesysteem twee aparte stromen die we in detail zullen bespreken.
Persistente gegevens
Het systeem moet in eerste instantie een aantal informatie-activa van Facebook identificeren. Voor elke opslagplaats wordt basisinformatie verzameld, zoals het datacenter dat deze gegevens bevat, het systeem dat deze gegevens beheert en de activa die zich in de specifieke gegevensopslag bevinden. Dit vormt een catalogus van metadata, waardoor het systeem gegevens efficiënt kan ophalen zonder de klanten of de door andere ingenieurs gebruikte bronnen te overbelasten.
Deze catalogus van metadata biedt een betrouwbare bron voor alle gescande activa en maakt het mogelijk de status van verschillende activa bij te houden. Met deze informatie wordt de planningsprioriteit vastgesteld op basis van de verzamelde gegevens en interne systeeminformatie, zoals de tijd van de laatste succesvolle scanning van het actief en de creatietijd, evenals eerdere eisen met betrekking tot geheugen en CPU voor dit actief als het eerder is gescand. Vervolgens wordt voor elke gegevensbron (naarmate de bronnen beschikbaar komen) de taak voor de daadwerkelijke scanning van de bron geactiveerd.
Elke taak is een gecompileerd binaire bestand dat een Bernoulli-sampling uitvoert op de laatste gegevens die beschikbaar zijn voor elk actief. Het actief wordt opgesplitst in afzonderlijke kolommen, waarbij het classificatieresultaat van elke kolom onafhankelijk wordt verwerkt. Bovendien scant het systeem eventuele verzadigde gegevens binnen de kolommen. JSON, arrays, gecodeerde structuren, URL's, geserialiseerde base 64-gegevens en meer worden allemaal gescand. Dit kan de uitvoeringstijd van de scan aanzienlijk verlengen, aangezien één tabel duizenden geneste kolommen kan bevatten binnen een groot binaire object. json.
Voor elke rij die in het gegevensactief is geselecteerd, haalt het classificatiesysteem zwevende en tekstobjecten uit de inhoud en koppelt elk object terug aan de kolom waaruit het afkomstig was. Het resultaat van de objectextractiefase is een kaart van alle objecten voor elke gevonden kolom in het gegevensactief.
Waarom zijn kenmerken belangrijk?
Het begrip van kenmerken is cruciaal. In plaats van de kenmerken float en tekst kunnen we onbewerkte steekproeven van strings doorgeven die rechtstreeks uit elke databron zijn gehaald. Bovendien kunnen machine learning-modellen direct op elke steekproef worden getraind in plaats van op honderden berekeningen van kenmerken die alleen maar proberen de steekproef te benaderen. Hier zijn verschillende redenen voor:
- Privacy staat voorop: het belangrijkste punt is dat het begrip van kenmerken ons in staat stelt om alleen die steekproeven in ons geheugen op te slaan die we extraheren. Dit garandeert dat we steekproeven alleen voor het doel opslaan en ze nooit registreren met onze eigen inspanningen. Dit is vooral belangrijk voor onbetrouwbare gegevens, aangezien de service een bepaalde classificatietoestand moet handhaven voordat deze een voorspelling doet.
- Geheugen: sommige steekproeven kunnen duizenden tekens lang zijn. Het opslaan van dergelijke gegevens en het verzenden ervan naar delen van het systeem zonder noodzaak verbruikt veel extra bytes. Twee factoren kunnen na verloop van tijd gecombineerd worden, gezien het feit dat er veel databronnen zijn met duizenden kolommen.
- Aggregatie van kenmerken: met behulp van kenmerken worden de resultaten van elke scan duidelijk gepresenteerd, waardoor het systeem de resultaten van eerdere scans van dezelfde databron op een handige manier kan combineren. Dit kan nuttig zijn voor de aggregatie van scanresultaten van één databron over meerdere uitvoeringen.
Vervolgens worden de kenmerken naar de voorspellende service verzonden, waar we regelgebaseerde classificatie en machine learning gebruiken om de labels van gegevens voor elke kolom te voorspellen. De service vertrouwt zowel op regelclassificatoren als op machine learning en selecteert de beste voorspelling die is gegeven door elk voorspellend object.
Regelclassificatoren zijn handmatige heuristieken, ze gebruiken berekeningen en coëfficiënten om het object te normaliseren in het bereik van 0 tot 100. Zodra zo'n initiële score is gegenereerd voor elk type gegevens en de naam van de kolom die aan deze gegevens is gekoppeld, en dit valt niet onder enige "blacklists", kiest de regelclassificator de hoogste genormaliseerde score onder alle datatypes.
Vanwege de complexiteit van de classificatie leidt het gebruik van uitsluitend handmatige heuristiek tot een lage classificatienauwkeurigheid, vooral voor ongestructureerde gegevens. Daarom hebben we een machine learning-systeem ontwikkeld voor de classificatie van ongestructureerde gegevens, zoals gebruikerscontent en adressen. Machine learning heeft ons in staat gesteld om ons te verwijderen van handmatige heuristiek en extra datapunten (zoals kolomnamen en de herkomst van gegevens) toe te passen, wat de detectienauwkeurigheid aanzienlijk verhoogt. We zullen later dieper ingaan op onze machine learning-architectuur.
De voorspellingservice slaat de resultaten voor elke kolom op, samen met metadata met betrekking tot de tijd en de status van de scan. Alle consumenten en downstream-processen die afhankelijk zijn van deze gegevens, kunnen deze lezen uit de dagelijks gepubliceerde dataset. Deze dataset aggregeert de resultaten van al deze scans, of de realtime API van de gegevenscatalogus. De gepubliceerde voorspellingen vormen de basis voor de automatische toepassing van privacy- en beveiligingsbeleid.
Uiteindelijk, nadat de voorspellingservice alle gegevens heeft geregistreerd en alle voorspellingen zijn opgeslagen, kan onze gegevenscatalogus API alle voorspellingen van gegevensgroepen voor een hulpbron in realtime retourneren. Elke dag publiceert het systeem een dataset die alle recentste voorspellingen voor elke asset bevat.
Onbetrouwbare gegevens
Hoewel het hierboven beschreven proces is ontworpen voor opgeslagen activa, wordt niet-opgeslagen verkeer ook beschouwd als onderdeel van de gegevens van de organisatie en kan het belangrijk zijn. Om deze reden biedt het systeem een online API voor realtime classificatievoorspellingen voor elk onbetrouwbaar verkeer. Het realtime voorspellingssysteem wordt veel gebruikt voor de classificatie van outgoing traffic, incoming traffic in machine learning-modellen en adverteerdersgegevens.
Hier accepteert de API twee hoofdargumenten: de groeperingssleutel en de onbewerkte gegevens die moeten worden voorspeld. De service voert dezelfde objectextractie uit die hierboven is beschreven en groepeert objecten samen op basis van dezelfde sleutel. Deze eigenschappen worden ook ondersteund in de opgeslagen cache voor herstel na een storing. Voor elke groeperingssleutel garandeert de service dat zij voldoende steekproeven heeft gezien voordat de voorspellingsservice wordt aangeroepen, overeenkomstig het eerder beschreven proces.
Optimalisatie
Voor het scannen van sommige opslagplaatsen gebruiken we bibliotheken en methodes voor het optimaliseren van lezen vanuit de warme opslag [2] en garanderen we dat er geen storingen zijn van andere gebruikers die toegang hebben tot dezelfde opslag.
Voor extreem grote tabellen (50+ petabyte), ondanks alle optimalisaties en geheugenefficiëntie, werkt het systeem aan het scannen en berekenen van alles voordat het geheugen op raakt. Uiteindelijk wordt het scannen volledig in het geheugen berekend en niet opgeslagen tijdens het scannen. Als grote tabellen duizenden kolommen met ongestructureerde datablobs bevatten, kan de taak mislukken vanwege een gebrek aan geheugencapaciteit bij het maken van voorspellingen voor de gehele tabel. Dit zal leiden tot verminderde dekking. Om dit tegen te gaan, hebben we het systeem geoptimaliseerd om de scansnelheid als tussenpersoon te gebruiken voor hoe goed het systeem omgaat met de huidige belasting. We gebruiken snelheid als een voorspellingsmechanisme om geheugenproblemen te detecteren en bij het proactief berekenen van de objectkaarten. Hierdoor gebruiken we minder gegevens dan normaal.
Gegevenssignalen
Het classificatiesysteem is zo goed als de signalen van de gegevens. Hier bekijken we alle signalen die door het classificatiesysteem worden gebruikt.
- Op basis van inhoud: natuurlijk is het eerste en belangrijkste signaal de inhoud. Er wordt een Bernoulli-monster genomen van elk gegeven activa dat we scannen en kenmerken extraheren op basis van de gegevensinhoud. Veel kenmerken komen voort uit de inhoud. Het kan een willekeurig aantal drijvende objecten zijn die de berekeningen vertegenwoordigen van hoe vaak een bepaald type voorbeeld is waargenomen. Bijvoorbeeld, we kunnen de rotatie van het aantal e-mails hebben die in de steekproef zijn gezien, of kenmerken van hoeveel emoji's in de steekproef zijn opgemerkt. Deze kenmerkenberekeningen kunnen genormaliseerd en geaggregeerd worden over verschillende scans.
- Gegevensherkomst: een belangrijk signaal dat kan helpen wanneer de inhoud is gewijzigd vanuit de oudertabel. Een veelvoorkomend voorbeeld is gehashte gegevens. Wanneer gegevens in een dochtertabel worden gehasht, komen ze vaak van de oudertabel, waar ze in platte tekst blijven. Informatie over de herkomst helpt om bepaalde typen gegevens te classificeren wanneer ze niet duidelijk leesbaar zijn of zijn omgevormd vanuit een bovenstroomtabel.
- Annotaties: nog een hoogwaardig signaal dat helpt bij het identificeren van ongestructureerde gegevens. In feite kunnen annotaties en herkomstgegevens samen werken om attributen tussen verschillende gegevensactiva te verspreiden. Annotaties helpen om de bron van ongestructureerde gegevens te identificeren, terwijl herkomstgegevens kunnen helpen om de stroom van deze gegevens door de opslag te volgen.
- Gegevensinjectie is een methode waarbij opzettelijk speciale, onleesbare symbolen worden ingevoerd in bekende bronnen met bekende gegevenstypen. Elke keer dat we inhoud scannen met dezelfde onleesbare tekenreeks, kan worden geconcludeerd dat de inhoud afkomstig is van dit bekende gegevenstype. Dit is nog een kwalitatief signaal van gegevens, vergelijkbaar met annotaties. Behalve dat detectie op basis van inhoud helpt om ingevoerde gegevens te ontdekken.
Metingen van metrics
Een belangrijk onderdeel is een strikte methode voor het meten van metrics. De belangrijkste metrics voor de iteratieve verbetering van classificatie zijn de nauwkeurigheid en recall van elk label, waarbij de F2-score cruciaal is.
Voor het berekenen van deze indicatoren is een onafhankelijke methodologie voor het labelen van gegevensactiva nodig die onafhankelijk is van het systeem zelf, maar die kan worden gebruikt voor directe vergelijking ermee. Hieronder beschrijven we hoe we de belangrijkste waarheid van Facebook verzamelen en deze gebruiken om ons classificatiesysteem te trainen.
Verzameling van betrouwbare gegevens
We verzamelen betrouwbare gegevens uit elke bron die hieronder wordt vermeld in zijn eigen tabel. Elke tabel is verantwoordelijk voor het aggregeren van de laatste observeerbare waarden uit deze specifieke bron. Elke bron heeft een kwaliteitscontrole om te garanderen dat de observeerbare waarden voor elke bron van hoge kwaliteit zijn en de laatste datatypelabels bevatten.
- Configuraties van het loggingplatform: bepaalde velden in de tabellen van de hive worden ingevuld met gegevens die betrekking hebben op een specifiek type. Het gebruik en de verspreiding van deze gegevens dienen als een betrouwbare bron van betrouwbare gegevens.
- Handmatige labeling: ontwikkelaars die het systeem ondersteunen, evenals externe labelaars, zijn opgeleid om kolommen te labelen. Dit werkt meestal goed voor alle soorten gegevens in de opslag en kan een belangrijke bron van betrouwbaarheid zijn voor sommige ongestructureerde gegevens, zoals berichtgegevens of gebruikersinhoud.
- Kolommen uit bovenliggende tabellen kunnen worden gemarkeerd of geannoteerd als zij bepaalde gegevens bevatten, en we kunnen deze gegevens volgen in onderliggende tabellen.
- Steekproef van uitvoeringsstromen: uitvoeringsstromen op Facebook bevatten gegevens van een bepaald type. Door onze scanner als service-architectuur te gebruiken, kunnen we stromen met bekende datatypes steekproeven en deze door het systeem sturen. Het systeem belooft deze gegevens niet op te slaan.
- Steekproeftabellen: grote hive-tabellen waarvan bekend is dat ze de volledige dataset bevatten, kunnen ook als trainingsgegevens worden gebruikt en door de scanner als service worden verzonden. Dit is ideaal voor tabellen met een volledig bereik aan datatypes, zodat het willekeurig stekken van een kolom equivalent is aan het steekproeven van de gehele set van dat type gegevens.
- Synthetische gegevens: we kunnen zelfs bibliotheken gebruiken die gegevens on-the-fly genereren. Dit werkt goed voor eenvoudige, openbare datatypen zoals adressen of GPS.
- Gegevensbeheerders: privacyprogramma's maken doorgaans gebruik van gegevensbeheerders om handmatig beleid aan delen van gegevens toe te wijzen. Dit dient als een zeer nauwkeurige bron van betrouwbaarheid.
We combineren elke primaire bron van betrouwbare gegevens in één corpus met al deze gegevens. Het grootste probleem met betrouwbaarheid is ervoor te zorgen dat deze representatief is voor de gegevensopslag. Anders kunnen classificatiemachines overgefit raken. Om dit tegen te gaan, worden al deze bovengenoemde bronnen gebruikt om balans te waarborgen bij het trainen van modellen of het berekenen van metrics. Bovendien selecteren menselijke labelers gelijkmatig verschillende kolommen in de opslag en labelen ze de gegevens dienovereenkomstig, zodat de verzameling van betrouwbare waarden onpartijdig blijft.
Continue integratie
Om snelle iteratie en verbetering te waarborgen, is het belangrijk om altijd de systeemprestaties in realtime te meten. We kunnen elke verbetering in classificatie meten in vergelijking met het systeem van vandaag, zodat we tactisch de gegevens kunnen richten op verdere verbeteringen. Hier zullen we bekijken hoe het systeem de feedbackcyclus voltooit, die wordt verzekerd door betrouwbare gegevens.
Wanneer het planningssysteem wordt geconfronteerd met een activum dat een label van een betrouwbare bron heeft, plannen we twee taken. De eerste maakt gebruik van onze productie scanner en daarmee onze productiecapaciteiten. De tweede taak maakt gebruik van de laatste versie van de scanner met de meest recente kenmerken. Elke taak schrijft zijn output naar zijn eigen tabel, waarbij versies worden gemarkeerd samen met de classificatieresultaten.
Zo vergelijken we de classificatieresultaten van de releasecandidate en het productie-model in realtime.
Terwijl datasets de RC- en PROD-kenmerken vergelijken, worden er tal van variaties van de classificatiemachine van de voorspellingsservice geregistreerd. Het nieuwste geproduceerde machine learning-model, het huidige operationele model en eventuele experimentele modellen. Dezelfde aanpak stelt ons in staat om verschillende versies van het model (agnostisch voor onze regelgebaseerde classificators) te 'snijden' en vergelijkingen van metrics in realtime uit te voeren. Dit maakt het eenvoudig om te bepalen wanneer een experiment met ML klaar is voor implementatie in productie.
Elk nacht worden de RC-kenmerken die voor die dag zijn berekend, naar de ML-trainingspijplijn gestuurd, waar het model wordt getraind op de laatste RC-kenmerken en zijn prestaties beoordeelt in vergelijking met een betrouwbare dataset.
Elke ochtend is het model klaar met trainen en wordt automatisch gepubliceerd als experimenteel. Het wordt automatisch toegevoegd aan de lijst met experimenten.
Enkele resultaten
Meer dan 100 verschillende datatypes worden met hoge nauwkeurigheid gemarkeerd. Goed gestructureerde types, zoals e-mails en telefoonnummers, worden geclassificeerd met een f2-score van meer dan 0,95. Vrije datatypes, zoals gebruikersinhoud en namen, presteren ook zeer goed, met F2-scores van meer dan 0,85.
Dagelijks wordt een groot aantal individuele kolommen van stabiele en onstabele gegevens in alle opslagplaatsen geclassificeerd. Meer dan 500 terabyte worden dagelijks door meer dan 10 databanken gescand. Het bereik van de meeste van deze opslagplaatsen is meer dan 98%.
In de loop der tijd is de classificatie zeer efficiënt geworden, aangezien classificatietaken in de opgeslagen autonome stroom gemiddeld 35 seconden duren van het scannen van de activum tot het berekenen van voorspellingen voor elke kolom.
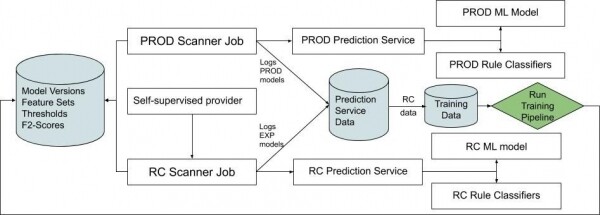
Figuur 2. Diagram dat de continue integratiestroom beschrijft, zodat we begrijpen hoe RC-objecten worden gegenereerd en naar het model worden gestuurd.
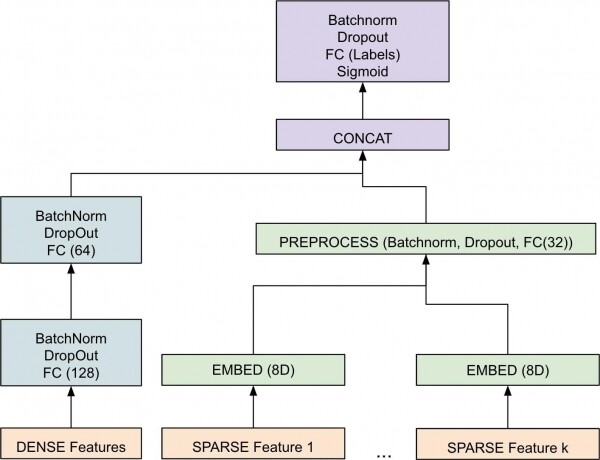
Figuur 3. Hoog-niveau diagram van de machine learning-component.
Machine learning-systeemcomponent
In de vorige sectie zijn we dieper ingegaan op de architectuur van het hele systeem, waarbij we de schaal, optimalisatie en datastromen in zowel autonome als online modus hebben belicht. In deze sectie zullen we de voorspellingsservice bespreken en het machine learning-systeem beschrijven dat de werking van de voorspellingsdienst mogelijk maakt.
Met meer dan 100 datatypes en een aantal ongestructureerde inhoud, zoals berichtgegevens en gebruikerscontent, leidt het uitsluitend gebruik van handmatige heuristiek vaak tot suboptimale classific nauwkeurigheid, vooral voor ongestructureerde gegevens. Om deze reden hebben we ook een machine learning-systeem ontwikkeld om met de complexiteit van ongestructureerde gegevens om te gaan. Het gebruik van machine learning stelt ons in staat om af te stappen van handmatige heuristiek en te werken met kenmerken en aanvullende signaalgegevens (zoals kolomnamen, oorsprong van de gegevens) om de nauwkeurigheid te verbeteren.
Het gerealiseerde model bestudeert vectorrepresentaties [3] van dichte en spaarzame objecten afzonderlijk. Vervolgens worden ze samengevoegd om een vector te vormen die door een reeks fasen van batchnormalisatie [4] en non-lineariteit gaat om het eindresultaat te verkrijgen. Het eindresultaat is een drijvend-getal tussen [0-1] voor elk label, dat de kans aangeeft dat een voorbeeld tot dat type gevoeligheid behoort. Het gebruik van PyTorch voor het model stelde ons in staat sneller vooruitgang te boeken, waardoor ontwikkelaars buiten het team snel wijzigingen konden aanbrengen en testen.
Bij het ontwerpen van de architectuur was het belangrijk om spaarzame (bijvoorbeeld tekstuele) en dichte (bijvoorbeeld numerieke) objecten afzonderlijk te modelleren vanwege hun interne verschillen. Voor de uiteindelijke architectuur was het ook belangrijk om de parameters uit te rollen om de optimale waarde voor de leersnelheid, batchgrootte en andere hyperparameters te vinden. De keuze van de optimizer was ook een belangrijke hyperparameter. We ontdekten dat de populaire optimizer Adamvaak leidt tot overfitting, terwijl het model met SGD stabler. Er waren extra nuances die we direct in het model moesten opnemen. Bijvoorbeeld, statische regels die garandeerden dat het model deterministische voorspellingen maakt wanneer een kenmerk een bepaalde waarde heeft. Deze statische regels zijn vastgesteld door onze klanten. We hebben ontdekt dat het opnemen van deze regels direct in het model leidde tot een meer zelfvoorzienende en betrouwbare architectuur, in tegenstelling tot het uitvoeren van een post-processing stap om deze speciale randgevallen te verwerken. Houd er ook rekening mee dat deze regels tijdens de training zijn uitgeschakeld, zodat ze het trainingproces van de gradient descent niet verstoren.
Problemen
Een van de problemen was het verzamelen van hoogkwalitatieve, betrouwbare gegevens. Het model heeft betrouwbaarheid nodig voor elke klasse, zodat het associaties tussen objecten en labels kan leren. In de vorige sectie hebben we het gehad over methoden voor dataverzameling voor zowel het meten van systemen als het trainen van modellen. Analyse toonde aan dat dataklassen zoals creditcard- en bankrekeningnummers niet veel voorkomen in onze opslag. Dit bemoeilijkt het verzamelen van grote hoeveelheden betrouwbare gegevens voor het trainen van modellen. Om dit probleem op te lossen, hebben we processen ontwikkeld voor het genereren van synthetische betrouwbare gegevens voor deze klassen. We genereren dergelijke gegevens voor gevoelige typen, inclusief SSN, creditcardnummers en IBAN-nummers waarvoor het model eerder geen voorspellingen kon doen. Deze benadering stelt ons in staat om gevoelige datatypes te verwerken zonder het privacyrisico dat gepaard gaat met het verbergen van echte gevoelige gegevens.
Naast de problemen met betrouwbare gegevens zijn er open architectuurproblemen waarmee we werken, zoals wijzigingsisolatie en vroege stop. Wijzigingsisolatie is belangrijk zodat bij verschillende wijzigingen in verschillende delen van het netwerk de impact wordt geïsoleerd van specifieke klassen en geen brede invloed heeft op de algehele voorspellende prestaties. Verbetering van de criteria voor vroege stop is ook cruciaal zodat we het trainingsproces op een stabiele plek voor alle klassen kunnen stoppen, in plaats van waar sommige klassen overfitted zijn en andere niet.
Belang van de eigenschap
Wanneer een nieuwe eigenschap in het model wordt geïntroduceerd, willen we weten wat de totale impact op het model is. We willen ook zekerstellen dat de voorspellingen begrijpelijk zijn voor mensen, zodat we precies kunnen begrijpen welke eigenschappen worden gebruikt voor elk type gegevens. Hiervoor hebben we ontwikkeld en geïntroduceerd per klasse de belangrijkheid van eigenschappen voor het PyTorch-model. Let op dat dit verschilt van de algemene belangrijkheid van een eigenschap, die meestal wordt ondersteund, omdat deze ons niet vertelt welke eigenschappen belangrijk zijn voor een bepaalde klasse. We meten de belangrijkheid van een object door de toename van de fout in de voorspelling te berekenen na het schudden van het object. Een eigenschap is "belangrijk" wanneer het schudden van de waarden de fout van het model doet toenemen, omdat het model in dit geval afhankelijk was van de eigenschap bij het doen van de voorspelling. Een eigenschap is "niet belangrijk" wanneer het schudden van de waarden de fout van het model onveranderd laat, omdat het model in dit geval de eigenschap negeerde [5].
De belangrijkheid van de eigenschap voor elke klasse maakt het model interpreteerbaar, zodat we kunnen zien waar het model op let bij het voorspellen van labels. Bijvoorbeeld, wanneer we ANALYSEEREN ADDR, dan zorgen we ervoor dat de aan het adres gerelateerde eigenschap, zoals AddressLinesCount, hoog op de lijst van belangrijke eigenschappen voor elke klasse staat, zodat onze menselijke intuitie goed overeenkomt met wat het model heeft geleerd.
Beoordeling
Het is belangrijk om een enkele succesmetric te bepalen. We hebben gekozen voor F2 — een balans tussen recall en precisie (de recall is iets belangrijker). Recall is belangrijker voor de privacy-use case dan precisie, omdat het voor het team uiterst belangrijk is om geen enkele gevoelige data te missen (terwijl een redelijke precisie wordt gegarandeerd). De werkelijke prestatiescores van onze F2-model gaan buiten deze artikel. Echter, met zorgvuldige afstemming kunnen we een hoge (0,9+) F2-score behalen voor de meest belangrijke gevoelige klassen.
Gerelateerd werk
Er zijn veel algoritmen voor automatische classificatie van ongestructureerde documenten, die gebruikmaken van verschillende methoden, zoals patroonmatching, documentvergelijking en diverse machine learning-technieken (Bayesiaans, beslis bomen, k-nabijgelegen buren en vele anderen) [6]. Elk van deze kan worden gebruikt als onderdeel van de classificatie. Echter, het probleem is de schaalbaarheid. De benadering van classificatie in dit artikel is gericht op flexibiliteit en prestaties. Dit stelt ons in staat om in de toekomst nieuwe klassen te ondersteunen en een lage latency te handhaven.
Er is ook een overvloed aan onderzoek naar het afdrukken van gegevens. Bijvoorbeeld, de auteurs in [7] beschrijven een oplossing die zich richt op het probleem van het vastleggen van lekken van vertrouwelijke gegevens. Het belangrijkste uitgangspunt is de mogelijkheid om een afdruk van de gegevens te maken, zodat deze kan worden vergeleken met een set bekende vertrouwelijke gegevens. De auteurs in [8] beschrijven een vergelijkbaar probleem van privacy-inbreuk, maar hun oplossing is gebaseerd op een specifieke Android-architectuur en wordt alleen geclassificeerd wanneer de acties van de gebruiker hebben geleid tot het verzenden van persoonlijke informatie of wanneer er een lek van gebruikersgegevens in de basisapplicatie is. De situatie hier is iets anders, omdat gebruikersgegevens ook sterk ongestructureerd kunnen zijn. Daarom hebben we een geavanceerdere techniek nodig dan alleen afdrukken.
Tot slot, om om te gaan met het tekort aan gegevens voor bepaalde soorten vertrouwelijke gegevens, hebben we synthetische gegevens geïntroduceerd. Er is een grote hoeveelheid literatuur over gegevensverruiming, bijvoorbeeld, de auteurs in [9] onderzochten de rol van ruisinjectie tijdens het leren en observeerden positieve resultaten in gecontroleerd leren. Onze benadering van privacy is anders, omdat het invoeren van met ruis beladen gegevens contraproductief kan zijn, en in plaats daarvan richten we ons op hoogwaardige synthetische gegevens.
Conclusie
In dit artikel presenteren we een systeem dat in staat is om een gegevensfragment te classificeren. Dit stelt ons in staat om systemen te creëren die voldoen aan privacy- en veiligheidsbeleid. We hebben aangetoond dat schaalbare infrastructuur, continue integratie, machine learning en hoogwaardige gegevensbetrouwbaarheid cruciale rollen spelen in het succes van veel van onze privacy-initiatieven.
Er zijn veel richtingen voor toekomstig werk. Dit kan ondersteuning voor ongestructureerde gegevens (bestanden) omvatten, de classificatie van niet alleen het type gegevens, maar ook het gevoeligheidsniveau, en het gebruik van zelfgestuurd leren tijdens het trainen door het genereren van nauwkeurige synthetische voorbeelden. Deze zullen op hun beurt het model helpen om de verliezen zoveel mogelijk te minimaliseren. Toekomstig werk kan zich ook richten op het onderzoeksproces, waar we verder gaan dan detectie en een analyse van de oorzaken van verschillende privacy-inbreuken bieden. Dit zal helpen in situaties zoals gevoeligheidsanalyse (d.w.z. of de gevoeligheid van de privacy van het gegevenstype hoog is (bijv. IP van de gebruiker) of laag (bijv. intern IP van Facebook)).
Bibliografie
- David Ben-David, Tamar Domany en Abigail Tarem. Bedrijfsgegevensclassificatie met behulp van semantische webtechnologieën. In Peter F. Patel-Schneider, Yue Pan, Pascal Hitzler, Peter Mika, Lei Zhang, Jeff Z. Pan, Ian Horrocks en Birte Glimm, redacteurs, Het Semantische Web – ISWC 2010, pagina's 66–81, Berlijn, Heidelberg, 2010. Springer Berlin Heidelberg.
- Subramanian Muralidhar, Wyatt Lloyd, Sabyasachi Roy, Cory Hill, Ernest Lin, Weiwen Liu, Satadru Pan, Shiva Shankar, Viswanath Sivakumar, Linpeng Tang en Sanjeev Kumar. f4: Facebook's warme BLOB-opslag systeem. In 11e USENIX Symposium over ontwerp en implementatie van besturingssystemen (OSDI 14), pagina's 383–398, Broomfield, CO, oktober 2014. USENIX Association.
- Tomas Mikolov, Ilya Sutskever, Kai Chen, Greg S Corrado en Jeff Dean. Gedistribueerde representaties van woorden en zinnen en hun compositionaliteit. In C. J. C. Burges, L. Bottou, M. Welling, Z. Ghahramani en K. Q. Weinberger, redacteurs, Vooruitgang in Neural Information Processing Systems 26, pagina's 3111–3119. Curran Associates, Inc., 2013.
- Sergey Ioffe en Christian Szegedy. Batchnormalisatie: versnellen van de training van diepe netwerken door interne covariantieverschuiving te verminderen. In Francis Bach en David Blei, redacteurs, Proceedings van de 32e Internationale Conferentie over Machine Learning, volume 37 van Proceedings van Machine Learning Research, pagina's 448–456, Lille, Frankrijk, 07–09 jul 2015. PMLR.
- Leo Breiman. Random forests. Mach. Leer., 45(1):5–32, oktober 2001.
- Thair Nu Phyu. Onderzoek naar classificatietechnieken in data mining.
- X. Shu, D. Yao en E. Bertino. Privacy-beschermende detectie van gevoelige gegevensblootstelling. IEEE Transactions on Information Forensics and Security, 10(5):1092–1103, 2015.
- Zhemin Yang, Min Yang, Yuan Zhang, Guofei Gu, Peng Ning, en Xiaoyang Wang. Appintent: Analyseren van gevoelige gegevensoverdracht in Android voor het detecteren van privacylekken. pagina's 1043–1054, 11 2013.
- Qizhe Xie, Zihang Dai, Eduard H. Hovy, Minh-Thang Luong, en Quoc V. Le. Ongecontroleerde data-augmentatie.
Ontdek de details over hoe je een gewilde carrière from scratch kunt opbouwen of je vaardigheden en salaris kunt opkrikken door online cursussen van SkillFactory te volgen:
- (12 maanden)
- (12 weken)
- (20 weken)
- (20 weken)
Meer cursussen
- (9 maanden)
- (8 maanden)
- (9 maanden)
- (12 maanden)
- (18 maanden)
- (12 maanden)
- (9 maanden)
- (7 maanden)
Bron: habr.com
