

Dziiiiiiiin! Het is 3 uur 's nachts, je zit in een prachtige droom, en plotseling – de telefoon gaat. Deze week ben je dienstdoende, en blijkbaar is er iets aan de hand. Het geautomatiseerde systeem roept je om te onderzoeken wat er aan de hand is. Dit is een belangrijk moment in het beheer van moderne computersystemen, maar laten we eens kijken hoe we meldingen gebruiksvriendelijker kunnen maken voor mensen.
Maak kennis met de filosofie van monitoring, die is ontstaan uit tientallen jaren van mijn diensten in verschillende monitoringteams. Deze is in belangrijke mate beïnvloed door de echte bijbel van Rob Evaschuk. (My Philosophy on Alerting), opgenomen in het boek over , en het boek van John Allspaw. (Considerations for Alert Design).
, en — bedankt voor de hulp bij het bewerken van de post.
Wat is CASE?
Ik besloot een mooie afkorting te verzinnen, zoals bij of Ik noem dit de CASE-methode.Het beschrijft vier punten waar aandacht aan moet worden besteed bij het werken met automatische monitoring:
- (context-heavy)
- (actionable)
- (symptom-based)
- (evaluated)
Als je CASE gebruikt, benader je meldingen met een gezonde desinteresse en wek je mensen niet 's nachts. Je moet regelmatig monitoring evalueren op bruikbaarheid en effectiviteit. Wanneer iemand een melding ontvangt, zal hij betere mentale modellen hebben en meer vertrouwen.
Om het makkelijker te onthouden, stel je voor dat je een CASE [dat wil zeggen een reden — vertaleropmerking] nodig hebt om elke melding te rechtvaardigen. :sunglasses:
En waarom is dit alles nodig?
Om verschillende redenen. En CASE zal ze niet allemaal oplossen. Maar hiermee zul je 's nachts wakker worden van betere meldingen. Deze methode bestrijkt verschillende organisatorische processen die ook daarbij zullen helpen.
De schoonheid van de RED- en USE-methoden is dat ze ons niet alleen leren hoe te werken, maar ook ons in staat stellen om met elkaar in dezelfde taal te communiceren. Ik hoop dat het met de CASE-methode makkelijker zal zijn om meldingen te bespreken die onze systemen beschermen, maar onze collega’s geen rust gunnen.
De essentie is dat we binnen de organisatie een cultuur moeten creëren waarbij meldingen met een gezonde onverschilligheid worden behandeld. Meldingen kunnen om een goede reden worden aangemaakt, maar dat betekent niet dat ze later geen waarde verliezen. Waarom hebben we deze melding ingesteld? Wanneer zijn de criteria voor deze melding voor het laatst bekeken? Met CASE kunnen antwoorden op deze vragen worden gevonden.
Context-Heavy — contextafhankelijke koppeling
3 uur 's nachts is niet de beste tijd om berichten te lezen vol met ingewikkelde woorden. Om effectief te reageren, is informatie nodig. Idealiter moet dit informatie zijn over een specifiek probleem, waarbij de context meteen duidelijk is, en moeten meldingen zo worden ingesteld dat dit mogelijk is. Dit is de "observatie" en "oriëntatie" uit . Deze instelling is het waard om tijd aan te besteden, want iemand voortdurend afleiden is nog kostbaarder. Laten we elkaar respecteren.
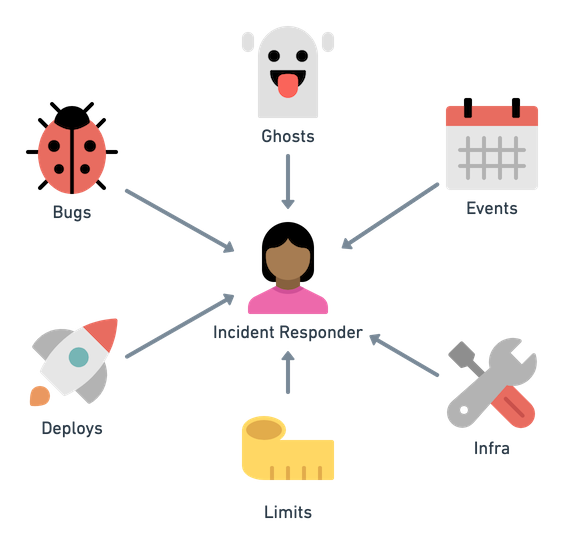
Problemen hebben veel bronnen. Vooral schimmen.
Hoe kan de surveillant helpen? Allereerst ziet de surveillant de melding, dus alle hypotheses zijn daarop gebaseerd. Daarna kijkt hij naar instructies en dashboards, maar zijn daar altijd gegevens over de specifieke melding, en niet alleen algemene informatie? Olspo raadt aan "na te denken over hoe de melding kan worden geïnterpreteerd of hoe erop kan worden gereageerd" (dia 29). Een goede melding is gericht op de surveillant en niet alleen ingesteld op een drempelwaarde.
Hier zijn enkele ideeën om de context van meldingen te verbeteren:
- Toon de gebruiker iets nuttigs en specifieks, en niet alleen standaard instructies of een dashboard. Eerder gebruikten we dashboards voor onderzoek, ingesteld op specifieke meldingen. Dit helpt als het probleem bekend is, maar kan in andere gevallen verwarrend zijn. Hier moet een balans worden gevonden.
- Vertel de geschiedenis van de melding: is deze nieuw? Gaat hij vaak af? Is hij seizoensgebonden?
- Toon recente veranderingen in de status van het systeem. Is er onlangs iets veranderd? (Bijvoorbeeld, een deployment of het in- of uitschakelen van functionaliteit.)
- Toon relaties en bied informatie voor het mentale model: systeemafhankelijkheden moeten duidelijk zichtbaar zijn, bij voorkeur met de werking aangegeven.
- Verbind de gebruiker snel met het team: ziet hij de huidige incidenten of kan hij erachter komen wie er in het bedrijf ook een melding heeft ontvangen? Het programma Is geactiveerd?
Idealiter biedt een incidentmanagementprogramma tips om de context van meldingen te verbeteren bij het onderzoeken van incidenten. Hier is altijd ruimte voor verbetering!
Actionable — praktische waarde
Moet de wachtondersteuning iets doen als reactie op een melding? Als er niets hoeft te gebeuren of het onduidelijk is wat te doen, waarom zijn ze dan wakker gemaakt? We moeten meldingen vermijden die de wachtondersteuning ergeren en geen actie vereisen.
Wat moet er gedaan worden? Wat is er nodig?
Vroeger, toen systemen eenvoudig waren en teams klein, stelden we monitoring in om op de hoogte te blijven. Een melding dat de belasting op een cluster is gestegen, geeft ons context als de service later problemen vertoont. Op grote schaal verwarren dergelijke meldingen alleen maar, omdat onze systemen altijd in een staat van degradatie van verschillende ernstniveaus functioneren. Dit leidt snel tot en natuurlijk tot verlies van gevoeligheid. Daarom negeert de wachtondersteuning dergelijke meldingen of filtert ze zelfs, en reageert niet altijd als dat nodig is. Laat u niet in deze valstrik vangen! Stel niet al uw meldingen in om ze later naar een vergeten map in uw e-mail te sturen.
Zo ziet een melding met praktische waarde eruit:
- De melding vereist actie en geeft niet alleen het nieuws door.
- Het is moeilijk of risicovol om deze actie te automatiseren. Als de actie kan worden geautomatiseerd, doe het dan gewoon en houd op met mensen lastigvallen!
- De melding bevat dringende aanbevelingen in de vorm van (SLA) of (RTO). Dan kan de wachtondersteuning het incidentmanagementprogramma binnen de organisatie inschakelen.
Ik wil verduidelijken: ik zeg niet dat meldingen alleen moeten komen voor de belangrijkste SLO's (serviceleveldoelstellingen) voor API's. SLO-monitoring wordt voortdurend verder opgesplitst en vereist een uniforme aanpak voor alle services. Het is duidelijk dat je de belangrijkste SLO's voor klanten die je betalen, wilt volgen. Maar ook de SLO's van de infrastructuur, zoals databases, moeten worden gevolgd. Binnenkort zul je met interne klanten te maken krijgen en hen moeten ondersteunen. En zo gaat het eeuwig door.
Symptoomgebaseerd — focus op symptomen
Of je het leuk vindt of niet, je werkt in een gedistribueerd systeem (Kavaj).. Als gevolg hiervan gebruik je verschillende tactieken om diensten te isoleren en te beschermen tegen storingen (Trainor et al.). En hoewel een langdurige garbage collection of een traag databaseverzoek op problemen wijst, is het niet nodig om deze onmiddellijk aan te pakken als gebruikers er op korte termijn geen hinder van ondervinden.
Dit zijn belangrijke signalen, en ze kunnen praktische waarde hebben, maar als ze de gebruikers niet hinderen, is het niet urgent genoeg om de bewaker af te leiden. Oorzaakgebaseerde notificaties zijn snapshots van onze mentale modellen van systeemstoring. Het is beter om belangrijke symptomen te volgen dan te proberen alle mogelijke oorzaken van een storing te enumereren.
Om notificaties praktische waarde te geven, concentreer je op , die belangrijk zijn voor de gebruikers. Evashchuk noemt dit 'monitoring voor gebruikers'. Vergeet niet dat deze filosofie in de hele organisatie moet worden toegepast. Als er ergens diep in de infrastructuur urgente problemen met een dienst optreden, zal het relevante team zich hiermee bezighouden. Het beschermen van systemen tegen dergelijke storingen is een volledig aparte kwestie (Trainor et al., sectie over strategieën voor het minimaliseren van kritieke afhankelijkheden)..
Symptomen zijn niet zo veranderlijk.
Richard Cook herinnert eraan dat complexe systemen vol tekortkomingen, fouten en problemen zitten.Proberen om alle mogelijke oorzaken op te sommen is een sisyfuswerk. Je probeert problemen te beschrijven, terwijl ze constant veranderen. Cindy Shridharan stelt dat 'systemen niet elke seconde in een ideale staat hoeven te verkeren' en dat het beter is om een menselijkere benadering te gebruiken ('Distributed Systems Observability', Vermijd notificaties bij incidenten..
Meestal worden notificaties ingesteld voor de oorzaken om incidenten te verhelpen. En deze beperkte notificaties over het feit dat iets is gebeurd, creëren een vals gevoel van zekerheid, omdat het systeem telkens nieuwe manieren bedenkt om te falen.
Laat je niet voor de gek houden door notificaties over oorzaken. Denk liever na over:
Waarom heeft de symptoomgebaseerde notificatie het probleem niet opgemerkt?
- Zou het nuttig zijn om de context voor de gebruiker te verbeteren?
- Zal het nuttig zijn om de context voor de gebruiker te verbeteren?
- Hoe de monitoringtools te verbeteren, zodat diagnoses sneller worden gesteld en niet alleen notificaties van wat er is gebeurd, worden verzameld?
Monitoringtools voor diagnose helpen alleen als je ze ziet als een manier om van symptomen naar oplossingen te gaan. Zonder deze terugkoppeling word je simpelweg overspoeld met verlate notificaties en grafieken over eerdere storingen - en geen woord over toekomstige. Voor de organisatie is dit een uitstekende kans om van verdediging naar offensief te gaan. En ontwikkelaars en productmanagers hebben dezelfde verwachtingen en duidelijke doelen. De case - CASE (:wink:) - voor elke notificatie is duidelijk.
Oorzaakgebaseerde notificaties zijn in gematigde aantallen acceptabel.
Soms laat ons systeem ons bijna geen keuze als het gaat om oorzaakgebaseerde notificaties. En soms weten de wachters heel goed dat het symptoom ongetwijfeld zal leiden tot een storing, en dat het dus praktische waarde heeft. Misschien ben je gewoon niet zeker van wat er aan de hand is en stel je notificaties in voor de zekerheid. Laten we hopen dat deze actie tijdelijk is, totdat we het systeem aanpassen om het probleem van de prestatievermindering aan te pakken.
Vergeet niet aan andere COMPONENTEN van CASE te denken wanneer je met dergelijke situaties omgaat. Als het tijdelijk is, betekent dat niet dat je niet na moet denken.
Evaluated - evaluatie
Elke wijziging in het systeem (nieuwe code, nieuwe infrastructuur, wat dan ook nieuw) vergroot de verscheidenheid aan storingen (Cook, 3). Werkt deze notificatie nog steeds zoals verwacht? Duidelijke en actuele mentale modellen van systemen en ervaring in het reageren op bepaalde notificaties ter ondersteuning - zijn belangrijke kenmerken . Defecten in systemen ontwikkelen zich voortdurend en we moeten bijblijven.
Het is noodzakelijk om de kwaliteit van elke notificatie voortdurend te evalueren, zodat ze werken zoals verwacht. Geachte leiders! Het zal voor uw teams veel gemakkelijker zijn als u hen helpt dit proces op te zetten! Hier zijn enkele ideeën voor evaluatie:
- Gebruik , of andere notificatietestmethoden. Het team kan dit zelf doen, zonder een zware incidentmanagementsysteem in te schakelen!
- Schakel de gegevensverzameling over alle waarschuwingsmeldingen met betrekking tot incidenten in het incidentbeheerprogramma in. Markeer nuttige, schadelijke, ongepaste, onduidelijke, enz. Gebruik ze als feedback.
- Juiste meldingen worden niet vaak geactiveerd en zijn zorgvuldig gecontroleerd. Zorg ervoor dat alle koppelingen werken, op de juiste context wijzen, enz.
- Als een melding nooit afgaat of te vaak afgaat, klopt er iets niet. Los het op of verwijder het. Pas op voor overmatige passiviteit of activiteit!
- Stel vervaldatums in voor meldingen. Als de vervaldatum is verlopen, beoordeel je de melding volgens de CASE-methode en werk je de vervaldatum bij. Controleer regelmatig de vervaldatum, net als bij voedsel.
- Verzacht het proces van het verbeteren van meldingen. Gebruik monitoring in de vorm van code en sla meldingen op in een Git-repository. Pull-requests helpen het team erbij te betrekken, en je hebt een geschiedenis van eerdere meldingen. En je zult minder bang zijn om meldingen te wijzigen of toestemming te vragen aan degenen die verantwoordelijk zijn.
- Zorg voor feedback op meldingen, zelfs als het alleen maar is , zodat de wachtdiensten meldingen kunnen markeren als nutteloos of opdringerig. Bouw een link of call-to-action in de melding zelf en bekijk regelmatig de feedback.
- Stel een regel in voor het team — laat de wachtdiensten werken aan het vereenvoudigen van het werk wanneer er weinig te doen is. Zorg ervoor dat alles na jou iets beter is dan het was daarvoor.
Conclusie
Ik geloof dat de CASE-methode ontwikkelaars en organisaties helpt bij het bespreken van de configuratie en verzending van automatische meldingen. Eén ontwikkelaar kan beginnen met het beoordelen van meldingen volgens de CASE-methode, waarna de hele organisatie met andere ontwikkelaars, het management en incidentmanagementsoftware zich aansluit om meldingen in goede staat te houden. Hiervoor zijn geen bijzondere tools of complexe processen nodig.
De hele industrie moet nadenken over de menselijke factor tijdens de wachtdiensten zonder concessies te doen aan de eersteklas klantenservice. Al deze tools en praktijken kunnen en moeten worden verbeterd. Ik hoop dat de CASE-methode hierbij zal helpen.
Geniet van verbeterde meldingen!
Bron: habr.com
