

Het uitrollen van een nieuwe projectrelease naar productie vereist zorgvuldige afstemming tussen de snelheid van de implementatie en de betrouwbaarheid van de oplossing. Bij Slack waarderen ze snelle iteraties, korte feedbackcycli en een snelle reactie op gebruikersverzoeken. Bovendien heeft het bedrijf honderden programmeurs die streven naar maximale productiviteit.
De auteurs van het materiaal dat we vandaag publiceren, zeggen dat een bedrijf dat dergelijke waarden nastreeft en tegelijkertijd groeit, voortdurend zijn projectimplementatiesysteem moet verbeteren. Bedrijven moeten investeren in transparantie en betrouwbaarheid van de werkprocessen, zodat deze processen aansluiten bij de omvang van het project. Hier zullen we de werkprocessen bespreken die bij Slack zijn ontstaan, evenals enkele oplossingen die het bedrijf hebben geleid tot het gebruik van het huidige projectimplementatiesysteem.
Hoe projectimplementatieprocessen vandaag de dag werken
Elke PR (pull request) in Slack moet verplicht een code-review ondergaan en moet succesvol alle tests doorstaan. Pas wanneer aan deze voorwaarden is voldaan, kan de programmeur zijn code samenvoegen met de masterbranch van het project. De implementatie van deze code vindt echter alleen plaats tijdens kantooruren van Noord-Amerika. Als gevolg hiervan zijn we, aangezien onze medewerkers op kantoor zijn, volledig voorbereid om onverwachte problemen op te lossen.
Elke dag voeren we ongeveer 12 geplande implementaties uit. Tijdens elke implementatie is de programmeur die als hoofd van de implementatie is aangewezen verantwoordelijk voor het uitrollen van de nieuwe build naar productie. Dit is een meerstappenproces dat een soepele overgang van de build naar de operationele modus garandeert. Dankzij deze aanpak kunnen we fouten ontdekken voordat ze invloed hebben op al onze gebruikers. Als er te veel fouten zijn, kan de implementatie van de build worden teruggedraaid. Mocht er echter een specifiek probleem worden ontdekt na de release, dan kan hiervoor eenvoudig een hotfix worden uitgebracht.
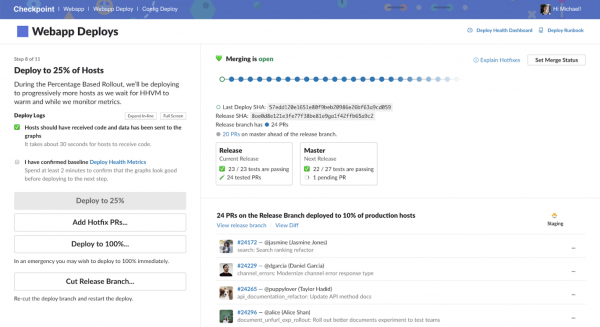
De interface van het Checkpoint-systeem, dat in Slack wordt gebruikt voor projectimplementatie
Het proces van het uitrollen van een nieuwe release in productie kan worden voorgesteld als bestaande uit vier stappen.
▍1. Het aanmaken van een releasebranch
Elke release begint met een nieuwe releasebranch, vanaf een moment in onze Git-historie. Dit stelt ons in staat om tags aan de release toe te kennen en biedt een plek waar tijdelijke correcties voor fouten die tijdens de voorbereiding van de release naar productie zijn gevonden, kunnen worden aangebracht.
▍2. Uitrol in een tussentijdse omgeving
De volgende stap omvat het uitrollen van de build op tussentijdse (staging) servers en het uitvoeren van een automatische test op de algehele functionaliteit van het project (smoke test). De tussentijdse omgeving is een productieomgeving waar geen extern verkeer binnenkomt. In deze omgeving voeren we aanvullende handmatige tests uit. Dit geeft ons extra vertrouwen dat het gewijzigde project correct functioneert. Enkel automatiseringstests zijn niet genoeg om dat soort vertrouwen te verkrijgen.
▍3. Uitrol in dogfood- en canary-omgevingen
De uitrol in productie begint met de dogfood-omgeving, die bestaat uit een set hosts die onze interne werkruimtes op Slack bedienen. Aangezien we actieve gebruikers van Slack zijn, heeft deze aanpak ons geholpen om veel fouten in de vroege stadia van de uitrol te ontdekken. Nadat we overtuigd zijn dat de basisfunctionaliteit van het systeem niet is aangetast, wordt de build uitgerold naar de canary-omgeving. Dit zijn systemen waarop ongeveer 2% van het productie verkeer komt.
▍4. Geleidelijk uitrollen naar productie
Als de monitoringresultaten van de nieuwe release stabiel zijn, en als we geen klachten hebben ontvangen na de uitrol van het project in de canary-omgeving, gaan we verder met de geleidelijke migratie van de productie-servers naar de nieuwe release. Het uitrolproces is in de volgende stappen onderverdeeld: 10%, 25%, 50%, 75% en 100%. Hierdoor kunnen we het productie verkeer langzaam naar de nieuwe release van het systeem doorgeven. We hebben hierbij tijd om de situatie te onderzoeken als er anomalieën optreden.
▍Wat te doen als er iets misgaat tijdens de uitrol?
Het aanpassen van code is altijd een risico. Maar we gaan hiermee om dankzij onze goed opgeleide 'deployment leads', die het proces van het uitrollen van een nieuwe release naar productie coördineren, de monitoring metrics in de gaten houden en de werkzaamheden van de programmeurs die de code uitrollen coördineren.
Als er echt iets verkeerd gaat, proberen we het probleem zo vroeg mogelijk op te sporen. We onderzoeken het probleem, vinden de PR die de fouten veroorzaakt, rollen deze terug, analyseren alles grondig en creëren een nieuwe build. Soms blijft het probleem echter onopgemerkt tot het project in productie gaat. In zo'n situatie is het belangrijkst om de werking van de service te herstellen. Daarom rollen we onmiddellijk terug naar de vorige werkende build voordat we met het onderzoek naar het probleem beginnen.
Bouwstenen van het deployment systeem
Laten we de technologieën bekijken die ten grondslag liggen aan ons projectdeployment systeem.
▍Snelle deployments
Het hierboven beschreven werkproces lijkt retrospectief misschien heel logisch. Maar ons deployment systeem is niet van de ene op de andere dag zo geworden.
Toen het bedrijf nog veel kleiner was, kon onze gehele applicatie draaien op 10 Amazon EC2-instanties. In zo’n situatie betekende het deployen van een project dat we rsync gebruikten voor een snelle synchronisatie van alle servers. Vroeger scheidde slechts één stap, een staging omgeving, de nieuwe code van productie. Builds werden gemaakt en getest in die omgeving en gingen dan rechtstreeks naar productie. Het was heel eenvoudig om in zo'n systeem te werken, het stelde elke programmeur in staat om op elk moment hun geschreven code uit te rollen.
Maar naarmate het aantal klanten groeide, groeide ook de infrastructuur die nodig was om het project draaiende te houden. Al snel, gezien de constante groei van het systeem, kon ons deployment model, dat gebaseerd was op het verzenden van nieuwe code naar de servers, zijn taak niet meer aan. Elke nieuwe server toevoegen betekende ook dat er meer tijd nodig was voor het uitvoeren van de deploy. Zelfs strategieën op basis van het parallel toepassen van rsync hebben hun beperkingen.
Uiteindelijk hebben we dit probleem opgelost door over te schakelen op een volledig parallelle implementatiesysteem, opgebouwd op een andere manier dan het oude systeem. Namelijk, we stuurden de code niet meer naar de servers via een synchronisatiescript. Nu laadde elke server zelf de nieuwe build, waarbij het zich bewust werd van de noodzaak dit te doen door het veranderen van de Consul-sleutel te observeren. De servers laadden de code parallel. Dit stelde ons in staat om een hoge implementatiesnelheid te behouden, zelfs in een omgeving van constante systeemgroei.
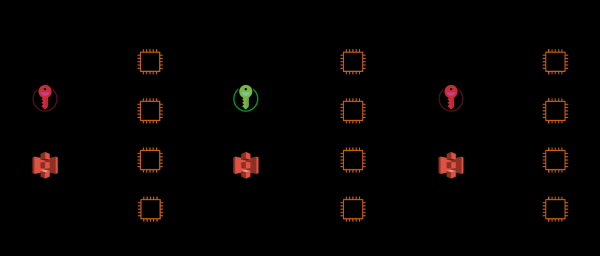
1. De productie-servers observeren de Consul-sleutel. 2. Wanneer de sleutel verandert, geeft dit de servers een signaal om de nieuwe code te beginnen laden. 3. De servers laden tarball-bestanden met de applicatiecode.
▍Atomare implementaties
Een andere oplossing die ons hielp om multi-tier implementatiesystemen te bereiken, was de atomare implementatie.
Voor de invoering van atomare implementaties kon elke implementatie leiden tot een groot aantal foutmeldingen. Dit kwam omdat het proces van het kopiëren van nieuwe bestanden naar de productie-servers niet atomair was. Dit resulteerde in een korte tijdsperiode waarin de code die nieuwe functies aanriep, beschikbaar was nog voordat deze functies zelf toegankelijk waren. Wanneer dergelijke code werd aangeroepen, leidde dit tot het teruggeven van interne fouten. Dit uitte zich in mislukte API-aanroepen en in 'gebroken' webpagina's.
Het team dat zich met dit probleem bezighield, loste het op door het concept van 'hete' (hot) en 'koude' (cold) directories in te voeren. De code in de 'hete' directory is verantwoordelijk voor het verwerken van productie-verkeer. In de 'koude' directories wordt de code tijdens het systeemwerk alleen voorbereid voor gebruik. Tijdens de implementatie wordt de nieuwe code gekopieerd naar een ongebruikte 'koude' directory. Vervolgens, wanneer er geen actieve processen op de server zijn, vindt er een onmiddellijke wisseling van directories plaats.
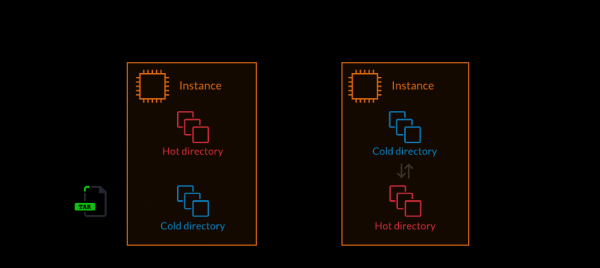
1. Uitpakken van de applicatiecode in de 'koude' directory. 2. Overschakelen van het systeem naar de 'koude' directory, die de 'hete' wordt (atomare operatie).
Conclusies: verschuiving van de focus naar betrouwbaarheid.
In 2018, the project grew to a scale where rapid deployment began to affect product stability. We had a rather advanced deployment system, into which we invested a lot of effort and time. We only needed to restructure and improve the deployment organization processes. We transformed into a fairly large company, whose developments were used worldwide for ensuring uninterrupted communication and solving critical tasks. Therefore, reliability became our primary focus.
We needed to make the process of deploying new Slack releases more secure. This necessity led us to enhance our deployment system. In fact, we discussed this improved system above. Within the system, we continue to use technologies for rapid and atomic deployment. What has changed is how exactly the deployment is carried out. Our new system is designed for phased deployment of new code across different levels and environments. Now we use more advanced supportive tools and monitoring means than before. This allows us to catch and fix errors long before they have a chance to reach the end-user.
But we are not going to stop here. We continuously improve this system by applying more advanced supportive tools and automation solutions.
Geachte lezers! How is the deployment process of new project releases organized where you work?
Bron: habr.com
