

Om eerlijk te zijn, lachte Ivan vaak om de vruchteloze inspanningen van de collega's van de monitort afdeling. Ze deden enorme inspanningen om de metrics te implementeren die het management van het bedrijf hen vroeg. Ze waren zo druk bezig dat ze niets anders meer wilden doen.
En het management vond dat niet genoeg - het vroeg constant om nieuwe metrics, waarbij ze heel snel stopten met het gebruiken van wat er eerder was gedaan.
De laatste tijd sprak iedereen alleen nog maar over LeadTime - de levertijd van zakelijke features. De metric toonde een krankzinnig aantal - 200 dagen om één taak te leveren. Hoe veel mensen zich wel niet verwonderden en hun handen naar de hemel opheften!
Na een tijdje verstomde het lawaai geleidelijk en het management vroeg om de creatie van nog een metric.
Ivan begreep heel goed dat ook de nieuwe metric op dezelfde manier stilletjes in een donkere hoek zou sterven.
Inderdaad, overwoog Ivan, het kennen van het aantal zegt helemaal niets. 200 dagen of 2 dagen - het maakt geen verschil, omdat je met dat aantal niet de oorzaak kunt bepalen en begrijpen of het goed of slecht is.
Dit is de typische valkuil van metrics: het lijkt alsof de nieuwe metric de essentie van het bestaan zal onthullen en een geheim zal uitleggen. Iedereen hoopt daarop, maar om de een of andere reden gebeurt er niets. Omdat het geheim helemaal niet in de metrics gezocht moet worden!
Voor Ivan was dit een afgerond hoofdstuk. Hij begreep dat voor metingen, en dat alle geheimen gezocht moeten worden in , dat wil zeggen, in wat deze metric vormt.
Voor een webwinkel zullen de invloedssferen zijn de klanten die geld binnenbrengen, en voor DevOps zijn het de teams die distributies creëren en implementeren met behulp van de pijplijn.
Eens comfortabel zittend in een stoel in de lobby, besloot Ivan goed na te denken over hoe hij de DevOps-metrics zou willen zien, rekening houdend met het feit dat de invloedssfeer de teams zijn.
Doel van de DevOps-metrics
Het is duidelijk dat iedereen de levertijd wil verkorten. 200 dagen is natuurlijk onaanvaardbaar.
Maar hoe, dat is de vraag?
In het bedrijf werken honderden teams, en er gaan dagelijks duizenden distributies door de DevOps-pijplijn. De werkelijke levertijd zal eruitzien als een verdeling. Elk team zal zijn eigen tijd en zijn eigen bijzonderheden hebben. Hoe vind je daar tussen al die chaos iets?
Het antwoord kwam vanzelf: we moeten de problematische teams vinden en analyseren wat daar aan de hand is en waarom het zo lang duurt, en van de 'goede' teams leren hoe ze alles snel kunnen doen. Hiervoor is het nodig om de tijd te meten die de teams op elk van de DevOps-stand hebben doorgebracht:
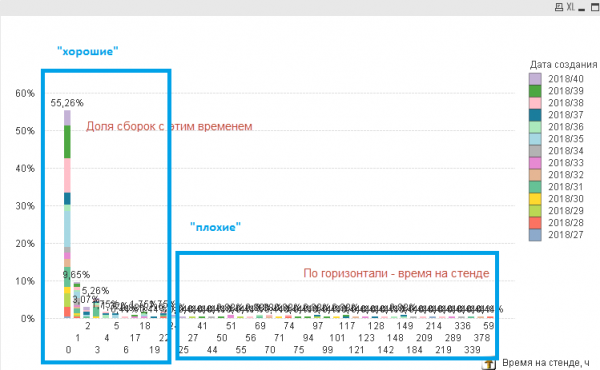
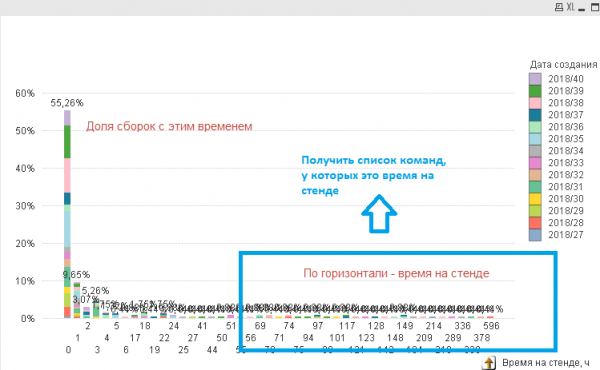
Het doel van het systeem zal zijn om teams te selecteren op basis van de tijd die ze op de stand doorbrengen, dat wil zeggen dat we uiteindelijk een lijst van teams moeten krijgen met de gekozen tijden, en geen cijfers.
Als we weten hoeveel tijd er totaal aan de stand is besteed en hoeveel tijd er is besteed aan stilstand tussen de standen, kunnen we de teams vinden, ze bellen en dieper ingaan op de oorzaken en deze oplossen," dacht Ivan.
Hoe de levertijd voor DevOps te berekenen
Voor de berekening was het nodig om dieper in het DevOps-proces en zijn essentie te duiken.
In het bedrijf wordt een beperkt aantal systemen gebruikt, en informatie kan alleen uit deze systemen worden verkregen en verder nergens anders.
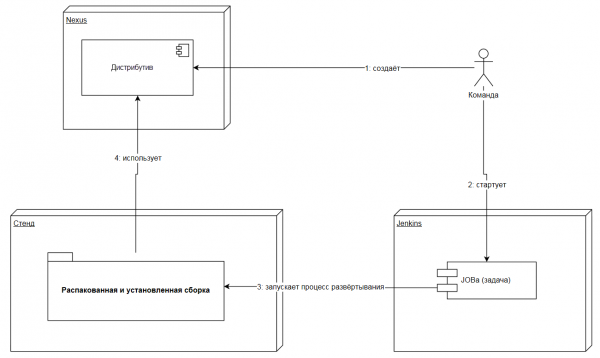
Alle taken in het bedrijf werden geregistreerd in Jira. Wanneer een taak in behandeling werd genomen, werd er een branch gemaakt, en na de implementatie werd er een commit naar BitBucket gedaan en een Pull Request. Bij goedkeuring van de PR (Pull Request) werd er automatisch een distributie gemaakt en opgeslagen in de Nexus-opslag.

Daarna werd de distributie op verschillende standen uitgerold met behulp van Jenkins om de juistheid van de implementatie te controleren, automatische en handmatige tests uit te voeren:
Ivan beschreef uit welke systemen welke informatie kan worden gehaald om de tijd op de standen te berekenen:
- Uit Nexus – De tijd van aanmaak van de distributie en de naam van de map waarin de code van het team was opgeslagen.
- Uit Jenkins – Starttijd, duur en resultaat van elke job, de naam van de stand (in de parameters van de job), de stages (stappen van de job), link naar de distributie in Nexus.
- Jira en BitBucket besloot Ivan buiten de keten te houden, omdat ze meer betrekking hadden op de ontwikkelingsfase en niet op het uitrollen van de kant-en-klare distributie over de standen.
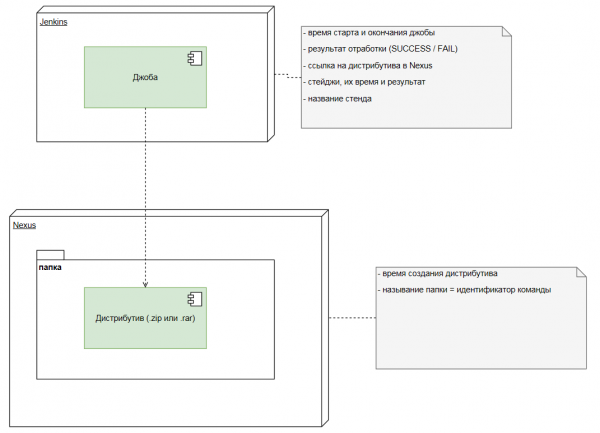
Op basis van de beschikbare informatie werd een dergelijk schema in kaart gebracht:
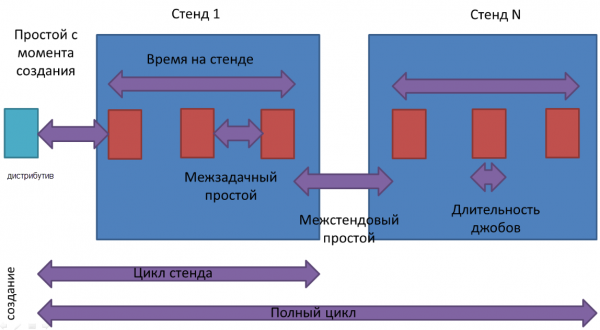
Wetende hoeveel tijd er nodig is om distributies te maken en hoeveel tijd er aan elk van hen wordt besteed, kan men gemakkelijk de totale kosten berekenen voor het doorlopen van de volledige DevOps-keten (volledige cyclus).
Dit zijn de DevOps-metrics die Ivan uiteindelijk heeft behaald:
- Aantal gemaakte distributies
- Deel van de distributies die op de stand zijn 'gekomen' en de stand hebben 'doorstaan'
- Tijd doorgebracht op de stand (cyclustijd van de stand)
- Volledige cyclus (totale tijd over alle teststandplaatsen)
- Duur van jobs
- Wachttijd tussen teststandplaatsen
- Wachttijd tussen het starten van jobs op dezelfde teststandplaats
Enerzijds gaven de metrics een goede karakterisering van de DevOps-pijplijn wat betreft tijd, anderzijds werden ze als te eenvoudig beschouwd.
Tevreden over het goed voltooide werk, stelde Ivan een presentatie op en ging deze aan het management presenteren.
Terug kwam hij somber en met hangende handen.
— Dit is een fiasco, maat — glimlachte de ironische collega...
Lees het vervolg in het artikel «».
Bron: habr.com
