

Hallo, Habr! Ik stel u voor aan de auteursvertaling van het artikel .
In een tijd waarin de IT-wereld geleidelijk overgaat op microservices en tools zoals Kubernetes, wordt één probleem steeds meer zichtbaar. Dit probleem is van versies van microservices. Toch gelooft de IT-gemeenschap dat de huidige situatie aanzienlijk beter is dan van de vorige generatie technologieën. Desondanks is versiebeheer van microservices een zeer complexe uitdaging. Een bewijs hiervan zijn artikelen zoals .
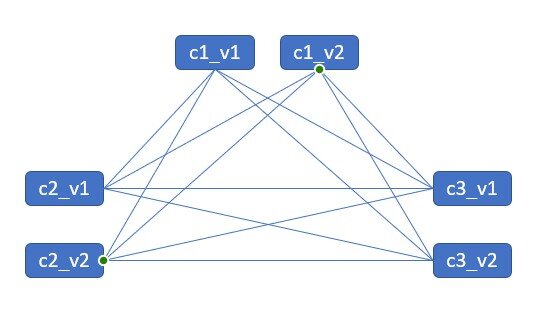
Als u deze tekst leest en de probleemstelling niet begrijpt, laat me het dan uitleggen. Stel dat uw product uit 10 microservices bestaat. Laten we nu aannemen dat er voor elke microservice 1 nieuwe versie uitkomt. Slechts 1 versie – ik hoop dat we het er allemaal over eens kunnen zijn dat dit een zeer triviaal en onbeduidend feit is. Maar laten we nogmaals naar ons product kijken. Met slechts 1 nieuwe versie van elke component hebben we nu 2^10 – ofwel 1024 permutaties van hoe we ons product kunnen samenstellen.
Als er nog onduidelijkheden zijn, laat me de wiskunde uitleggen. We hebben 10 microservices, en elke krijgt een update. Dit betekent dat we 2 mogelijke versies voor elke microservice hebben (of de oude of de nieuwe). Nu kunnen we voor elke component van het product een van deze twee versies gebruiken. Wiskundig gezien is dit hetzelfde als wanneer we een binaire getal van 10 cijfers hebben. Stel bijvoorbeeld dat 1 de nieuwe versie is en 0 de oude versie – dan kan een mogelijke permutatie worden aangeduid als 1001000000 – waar de 1e en 4e componenten zijn bijgewerkt, en de rest niet. Uit de wiskunde weten we dat een binaire getal van 10 cijfers 2^10 of 1024 waarden kan hebben. Dus we hebben de schaal van het aantal dat we onder ogen zien bevestigd.
Laten we verder discussiëren — wat gebeurt er als we 100 microservices hebben en elke service 10 mogelijke versies? De situatie wordt behoorlijk onplezierig — we hebben nu 10^100 permutaties — dat is een enorm getal. Toch geef ik de voorkeur aan deze formulering, omdat we ons nu niet verstoppen achter woorden als 'kubernetes', maar de uitdaging recht in de ogen kijken.
Waarom vindt ik dit probleem zo fascinerend? Gedeeltelijk omdat ik eerder in de wereld van NLP en AI werkte en we 5-6 jaar geleden veel hebben gesproken over het probleem van combinatorische explosie. Alleen hadden we in plaats van versies afzonderlijke woorden, en in plaats van producten hadden we zinnen en alinea's. En hoewel de problemen van NLP en AI nog steeds grotendeels onopgelost zijn, moeten we toegeven dat er de afgelopen jaren aanzienlijke vooruitgang is geboekt. (naar mijn mening zou de vooruitgang groter kunnen zijn,groter publiek.als mensen in de sector iets minder aandacht aan machine learning besteedden en iets meer aan andere technieken — maar dat is al off-topic).
Ik keer terug naar de wereld van DevOps en microservices. We staan voor een enorm probleem, dat zich als een olifant in de porseleinkast verhult — wat ik vaak hoor is: 'Neem gewoon kubernetes en helm, en alles komt goed!' Maar nee, alles komt niet goed als we alles laten zoals het is. Bovendien lijkt een analytische oplossing voor dit probleem onacceptabel vanwege de complexiteit. Net als in NLP moeten we eerst deze uitdaging aanpakken door het zoekgebied te verkleinen — in dit geval door verouderde permutaties uit te sluiten.
Een van de dingen die kunnen helpen — ik schreef vorig jaar Daarnaast is het belangrijk op te merken dat een goed doordacht CI/CD-proces sterk helpt om variaties te verminderen. Echter, de huidige staat van CI/CD is niet voldoende goed om het probleem van permutaties op te lossen zonder extra hulpmiddelen voor het bijhouden en traceren van componenten.
Wat we nodig hebben, is een experimentele systeem in de integratiefase, waar we het risicofactor per component kunnen bepalen, evenals een geautomatiseerd proces voor het bijwerken van verschillende componenten en testen zonder tussenkomst van de operator — zodat we kunnen zien wat werkt en wat niet.
Zo'n experimentensysteem zou er als volgt uitzien:
- Ontwikkelaars schrijven tests (dit is een kritieke stap — want zonder deze hebben we geen beoordelingscriteria — dit is vergelijkbaar met datamarkering in machine learning).
- Elke component (project) krijgt zijn eigen CI-systeem — dit proces is tegenwoordig goed uitgewerkt, en de vraag naar het creëren van een CI-systeem voor een enkele component is grotendeels opgelost.
- Het "Slimme integratiesysteem" verzamelt de resultaten van verschillende CI-systemen en voegt componentprojecten samen in een eindproduct, start het testen en berekent uiteindelijk de kortste weg om de gewenste functionaliteit van het product te verkrijgen, rekening houdend met de bestaande componenten en risicofactoren. Als een upgrade niet mogelijk is, waarschuwt dit systeem ontwikkelaars over de beschikbare componenten en waar de fout optreedt. Nogmaals, ik herhaal dat het testsysteem hier van cruciaal belang is — omdat het integratiesysteem tests als beoordelingscriteria gebruikt.
- Het CD-systeem, dat vervolgens gegevens ontvangt van het "Slimme integratiesysteem" en de daadwerkelijke update uitvoert. Deze fase sluit de cyclus af.
Samenvattend, voor mij is een van de grootste problemen momenteel het gebrek aan zo'n "Slim integratiesysteem" dat verschillende componenten tot een product verbindt en zo in staat stelt om te volgen hoe het product als geheel is samengesteld. Ik ben benieuwd naar de gedachten van de gemeenschap hierover (spoiler — ik werk momenteel aan een project , dat zo'n slim integratiesysteem kan worden).
Een laatste ding dat ik wil vermelden — voor mij is een monoliet niet acceptabel voor elk project, zelfs niet voor een gemiddeld formaat. Ik ben zeer sceptisch over pogingen om de tijd van implementatie en de kwaliteit van ontwikkeling te versnellen door terug te keren naar een monoliet. Ten eerste heeft de monoliet vergelijkbare problemen met componentbeheer — tussen de verschillende bibliotheken waaruit hij bestaat, maar dit is minder merkbaar en komt vooral tot uiting in de tijd die ontwikkelaars besteden. Een gevolg van het probleem van de monoliet is de feitelijke onmogelijkheid om wijzigingen in de code aan te brengen — en de extreem trage ontwikkeling.
Microservices verbeteren de situatie, maar vervolgens ondervindt de microservicesarchitectuur het probleem van combinatorische explosie tijdens de integratiefase. Ja, in het algemeen hebben we hetzelfde probleem verplaatst — van de ontwikkelingsfase naar de integratiefase. Echter, naar mijn mening leidt de aanpak van microservices tot betere resultaten, en teams behalen sneller resultaten (waarschijnlijk vooral vanwege de verkleining van de ontwikkelingsgrootte — of batchgrootte). De overstap van monolithisch naar microservices heeft echter nog niet geleid tot voldoende verbetering van het proces — de combinatorische explosie van versies van microservices is een enorm probleem, en we hebben groot potentieel voor verbetering naarmate we dit probleem oplossen.
Bron: habr.com
