

In dit artikel vertel ik over de situatie die recentelijk is voorgevallen met een van de servers in onze VPS-cloud, waardoor ik urenlang in de war was. Ik houd me al ongeveer 15 jaar bezig met het configureren en troubleshooten van Linux-servers, maar deze case past helemaal niet in mijn ervaring — ik deed een paar valse aannames en raakte een beetje wanhopig voordat ik in staat was om de oorzaak van het probleem correct te identificeren en op te lossen.
Inleiding
We exploiteren een middelgrote cloud, die we bouwen op standaardservers met de volgende configuratie — 32 cores, 256 GB RAM en een NVMe PCI-E Intel P4500 opslag van 4TB. We zijn erg blij met deze configuratie, omdat deze ons in staat stelt om ons geen zorgen te maken over IO-tekorten, terwijl we een correcte beperking op het niveau van instancetypes (VM-exemplaren) waarborgen. Aangezien de NVMe Intel ontzettend goede prestaties levert, kunnen we tegelijkertijd zowel volledige IOPS aan de machines toewijzen als het back-uppen van de opslag naar de back-upserver zonder IOWAIT.
Wij zijn de traditionele gebruikers die geen hypergeconvergeerde SDN en andere hippe, trendy, moderne trucs voor het opslaan van VM-volumes gebruiken, omdat we geloven dat hoe eenvoudiger het systeem is, hoe eenvoudiger het troubleshoot is in situaties waarin "de hoofdmens de bergen in is gegaan". Uiteindelijk slaan we de VM-volumes op in QCOW2-formaat in XFS of EXT4, dat is uitgerold bovenop LVM2.
Het gebruik van QCOW2 is ook noodzakelijk door het product dat we gebruiken voor orkestratie — Apache CloudStack.
Voor het maken van back-ups nemen we een volledig schijfimage van het volume, als een snapshot van LVM2 (ja, we weten dat LVM2-snapshots traag zijn, maar de Intel P4500 komt ons hier ook tegemoet). We voeren lvmcreate -s .. uit en met behulp van dd verzenden we de back-up naar een externe server met ZFS-opslag. Hier zijn we toch een beetje vooruitstrevend — ZFS kan immers gegevens in gecomprimeerde vorm opslaan, en we kunnen ze snel herstellen met behulp van DDoS of individuele VM-volumes ophalen met behulp van mount -o loop ....
Je kunt ook een onvolledige schijfimage van LVM2 maken, in plaats van de bestandssysteem in modus
ROen de QCOW2-images kopiëren, stuitten we echter op problemen met XFS, dat slechte prestaties vertoonde, en dat niet meteen, maar onvoorspelbaar. We houden er niet van als hypervisor-hosts plotseling vastlopen in het weekend, 's nachts of op feestdagen door fouten die onvoorspelbaar zijn. Daarom gebruiken we voor XFS geen snapshot-montage in de modusROvoor het extraheren van volumes, maar we kopiëren gewoon het hele LVM2-volume.
De snelheid van back-ups naar de backupserver wordt in ons geval bepaald door de prestaties van de backupserver, die ongeveer 600-800 MB/s bedraagt voor niet-gecomprimeerde gegevens; de volgende limiet is de 10Gbit/s-kanaal waarmee de backupserver is verbonden met het cluster.
Tegelijkertijd worden er op één backupserver backups naar 8 servers hypervisors geüpload. Hierdoor laten de schijf- en netwerksystemen van de backupserver, die langzamer zijn, de schijfssystemen van de hypervisor-hosts niet overbelasten, omdat ze simpelweg niet in staat zijn om bijvoorbeeld 8 GB/s te verwerken, die hypervisors probleemloos kunnen leveren.
Het hierboven beschreven kopieerproces is zeer belangrijk voor het verdere verhaal, inclusief de details - het gebruik van de snelle Intel P4500-opslag, het gebruik van NFS en waarschijnlijk het gebruik van ZFS.
Verhaal over back-ups
Op elke hypervisor-knop hebben we een kleine SWAP-partitie van 8 GB, en de hypervisor-node 'rollen' we uit met behulp van DDoS een standaard image. Voor de systeemtommer op de servers gebruiken we 2xSATA SSD RAID1 of 2xSAS HDD RAID1 op de LSI- of HP-hardwarecontroller. Over het algemeen maakt het ons niet uit wat er van binnen zit, omdat de systeemtommer in de modus 'bijna alleen-lezen' werkt, behalve SWAP. En omdat we veel RAM op de server hebben en 30-40% vrij is, denken we niet aan SWAP.
Het proces van het maken van een back-up. Deze taak ziet er ongeveer zo uit:
#!/bin/bash

mkdir -p /mnt/backups/volumes

DIR=/mnt/images-snap
VOL=images/volume
DATE=$(date "+%d")
HOSTNAME=$(hostname)

lvcreate -s -n $VOL-snap -l100%FREE $VOL
ionice -c3 dd iflag=direct if=/dev/$VOL-snap bs=1M of=/mnt/backups/volumes/$HOSTNAME-$DATE.raw
lvremove -f $VOL-snap
Let op de ionice -c3, feitelijk is dit ding volkomen nutteloos voor NVMe-apparaten, omdat de IO-scheduler voor hen is ingesteld als:
cat /sys/block/nvme0n1/queue/scheduler
[none]
We hebben echter een aantal legacy-nodes met gewone SSD-RAIDs, voor hen is dit relevant, dus AS IS. Over het algemeen is dit gewoon een interessant stukje code dat de nutteloosheid van ionice aantoont in het geval van deze configuratie.
Let op de vlag iflag=direct voor DDoSWe gebruiken direct IO omzeilen de buffer cache, zodat we geen onnodige buffer IO-vervangingen tijdens het lezen doen. Echter, oflag=direct doen we niet, omdat we prestatieproblemen met ZFS zijn tegengekomen bij het gebruik ervan.
Deze methode gebruiken we al enkele jaren succesvol zonder problemen.
En toen begon het… We ontdekten dat voor een van de knooppunten de back-up niet meer werd uitgevoerd, terwijl de vorige met een monstervormige IOWAIT van 50% was uitgevoerd. Bij het proberen te begrijpen waarom de back-up niet plaatsvond, stuitten we op het fenomeen:
Volume group "images" niet gevondenWe begonnen te denken dat "het einde gekomen was voor Intel P4500", maar voordat we de server moesten uitschakelen voor vervanging van de schijf, was het noodzakelijk om de back-up toch nog uit te voeren. We repareerden LVM2 door metadata uit een LVM2-back-up te herstellen:
vgcfgrestore imagesWe startten de back-up en zagen het volgende beeld:
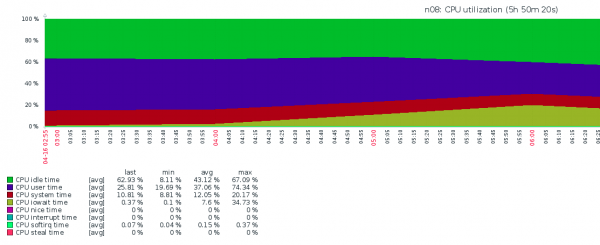
We werden weer erg somber — het was duidelijk dat zo leven niet mogelijk was, omdat alle VPS’en zouden lijden, en dat betekende dat wij ook zouden lijden. Wat er gebeurde, was absoluut onduidelijk — iostat toonde erbarmelijke IOPS en extreem hoge IOWAIT. Er waren geen ideeën, behalve "laten we NVMe vervangen", maar er kwam op tijd een openbaring.
Situatie stap voor stap analyseren
Historisch verslag. Enkele dagen eerder was het nodig geweest om een grote VPS te creëren met 128 GB RAM op deze server. Geheugen leek voldoende, maar voor de zekerheid stelden we nog 32 GB in voor de swappartitie. De VPS werd gemaakt, loste met succes zijn taak op en het incident werd vergeten, terwijl de SWAP-partitie bleef bestaan.
Configuratiekenmerken. Voor alle cloudservers was de parameter vm.swappiness gesteld op de standaardwaarde 60. En de SWAP was gemaakt op SAS HDD RAID1.
Wat er gebeurde (volgens de redactie). Tijdens de back-up DDoS werd er veel data voor schrijven gegenereerd, die in de RAM-buffers werden geplaatst voordat ze in NFS werden geschreven. De systeemkernel, geleid door het beleid van swappiness, verplaatste veel geheugenpagina's van de VPS naar het swapgebied, dat zich op de trage HDD RAID1-volume bevond. Dit leidde ertoe dat IOWAIT enorm steeg, maar niet door IO NVMe, maar door IO HDD RAID1.
Hoe het probleem werd opgelost. De swappartitie van 32 GB werd uitgeschakeld. Dit kostte 16 uur, over hoe en waarom de swap zo langzaam werd uitgeschakeld, kan apart worden gelezen. De parameters werden gewijzigd swappiness naar een waarde gelijk aan 5 in de hele cloud.
Hoe dit had kunnen gebeuren. Ten eerste, als SWAP zich op een SSD RAID of NVMe-apparaat had bevonden, en ten tweede, als er geen NVMe-apparaat was geweest, maar een langzamer apparaat dat niet zo'n gegevensvolume kon verwerken – ironisch genoeg is het probleem ontstaan omdat NVMe te snel is.
Daarna werkte alles weer als vanouds – met nul IOWAIT.
Bron: habr.com
