

Inleiding
Een tijd geleden kreeg ik de taak om een failovercluster te ontwikkelen voor , opererend in meerdere datacenters die via glasvezel met elkaar zijn verbonden in één stad, en dat in staat is om de uitval (bijvoorbeeld een stroomuitval) van één datacenter te weerstaan. Als software die verantwoordelijk is voor de failover heb ik gekozen voor , omdat dit de officiële oplossing van RedHat is voor het opzetten van failoverclusters. Het voordeel is dat RedHat ervoor zorgt dat het ondersteund wordt, en dat deze oplossing universeel (modulair) is. Hiermee kan niet alleen de failover voor PostgreSQL worden gegarandeerd, maar ook voor andere services, hetzij door gebruik te maken van standaardmodules, hetzij door speciaal modules te creëren voor specifieke behoeften.
Bij deze oplossing kwam een terechte vraag op: hoe failover-robust zal een failovercluster zijn? Om dit te onderzoeken, heb ik een testopstelling ontwikkeld die verschillende storingen op de clusterknopen simuleert, wacht op herstel, herstelt de uitgevallen knoop en gaat verder met de tests in een cyclus. Dit project heette oorspronkelijk hapgsql, maar na verloop van tijd begon de naam, waar slechts één klinker in staat, me te vervelen. Daarom ben ik de failoverdatabases (en het float IP dat naar hen verwijst) gaan noemen krogan (een personage uit een computer game, dat alle belangrijke organen gedupliceert heeft), en de knooppunten, clusters en het project zelf werden tuchanka (de planeet waar de kroganen wonen).
Nu heeft het management toegestaan . De README wordt binnenkort in het Engels vertaald (omdat verwacht wordt dat de belangrijkste gebruikers ontwikkelaars van Pacemaker en PostgreSQL zullen zijn), en de oude Russische versie van de README heb ik besloten om (gedeeltelijk) in de vorm van dit artikel te presenteren.
Clusters worden opgezet op virtuele machines . In totaal worden er 12 virtuele machines uitgerold (in totaal 36GiB), die 4 failoverclusters vormen (verschillende varianten). De eerste twee clusters bestaan uit twee PostgreSQL-servers die zich in verschillende datacenters bevinden, en een gemeenschappelijke server witness c quorum device (geplaatst op een goedkope virtuele machine in het derde datacenter), die de onduidelijkheid oplost 50%/50%, door zijn stem aan één van de partijen te geven. Het derde cluster is verspreid over drie datacenters: één master, twee slaves, zonder quorum device. De vierde cluster bestaat uit vier PostgreSQL-servers, twee per datacenter: één primaire en de rest replica's, en maakt ook gebruik van witness c quorum device. De vierde kan uitval van twee servers of één datacenter weerstaan. Deze oplossing kan indien nodig worden opgeschaald naar meer replica's.
Tijdservice is ook herconfigureerbaar voor fouttolerantie, maar er wordt gebruikgemaakt van de methode van ntpd (orphan mode). De algemene server witness fungeert als centrale NTP-server, die zijn tijd aan alle clusters verstrekt, waardoor alle servers op elkaar worden gesynchroniseerd. Als witness uitvalt of geïsoleerd raakt, begint een van de servers in de cluster zijn tijd te verstrekken (binnen de cluster). Een hulpk caching HTTP proxy is ook opgezet op witness, waarmee de andere virtuele machines toegang hebben tot Yum-repositories. In werkelijkheid worden dergelijke services, zoals tijdservice en proxy, waarschijnlijk op speciale servers gehost, terwijl ze in de opstelling op witness alleen voor het besparen van het aantal virtuele machines en ruimte.
Versies
v0. Werkt met CentOS 7 en PostgreSQL 11 op VirtualBox 6.1.
Clusterstructuur
Alle clusters zijn bedoeld om in verschillende datacenters te worden gehost, verbonden in een plat netwerk en moeten uitval of netwerkisolatie van één datacenter weerstaan. Daarom onmogelijk is wordt gebruikt om te beschermen tegen split-brain de standaardtechnologie Pacemaker, die STONITH (Shoot The Other Node In The Head) of fencing. De kern ervan is: als de knooppunten in de cluster gaan vermoeden dat er iets mis is met een bepaald knooppunt, dat niet reageert of zich onjuist gedraagt, dan schakelen ze het gedwongen uit via ‘externe’ apparaten, zoals de IPMI-beheerpunt of UPS. Maar dit werkt alleen in gevallen waarin bij een enkel falen van de server de IPMI of UPS blijft functioneren. Hier is ook bescherming gepland tegen een veel catastrofaler falen, wanneer een heel datacenter uitvalt (bijvoorbeeld geen stroom meer heeft). En bij een dergelijke storing zullen ook alle stonith-apparaten (IPMI, UPS, enz.) niet meer werken.
In plaats daarvan ligt de basis van het systeem in het idee van quorum. Alle knooppunten hebben een stem, en alleen degenen die meer dan de helft van alle knooppunten kunnen zien, kunnen functioneren. Dit aantal ‘meer dan de helft + 1’ wordt genoemd quorum. Als er geen quorum wordt bereikt, beslist het knooppunt dat het zich in netwerkisolatie bevindt en moet het zijn middelen uitschakelen, d.w.z. dit is zo'n bescherming tegen split-brain. Als de software die verantwoordelijk is voor dergelijk gedrag niet functioneert, moet de watchdog, bijvoorbeeld op basis van IPMI, worden geactiveerd.
Als het aantal knooppunten even is (een cluster in twee datacenters), kan er een zogenaamde onduidelijkheid ontstaan 50%/50% (vijftig-vijftig), wanneer net isolatie het cluster precies doormidden splitst. Daarom wordt voor een even aantal knooppunten toegevoegd quorum device — een on-demand daemon die kan worden uitgevoerd op de goedkoopste virtuele machine in het derde datacenter. Het geeft zijn stem aan een van de segmenten (die het ziet) en lost zo de 50%/50% onduidelijkheid op. De server waarop het quorum-device zal worden uitgevoerd, heb ik genoemd witness (terminologie uit repmgr, ik vond het leuk).
Hulpbronnen kunnen van plaats naar plaats verhuizen, bijvoorbeeld van defecte servers naar werkende of op verzoek van systeembeheerders. Om klanten te laten weten waar hun benodigde hulpbronnen zich bevinden (waar moet men verbinding mee maken?), worden gebruikt drijvende IP (drijvend IP). Dit zijn IP's die Pacemaker over de knooppunten kan verplaatsen (alles bevindt zich in een plat netwerk). Iedere daarvan symboliseert een hulpbron (dienst) en zal zich bevinden waar verbinding mee moet worden gemaakt om toegang te krijgen tot deze dienst (in ons geval de DB).
Tuchanka1 (schema met verdichting)
Structuur
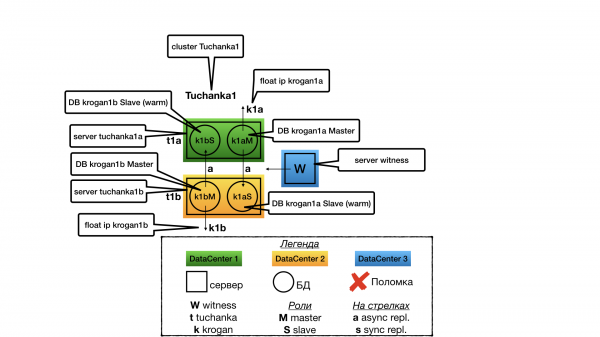
Het idee was dat we veel kleine databases met een lage belasting hebben, waarvoor het niet rendabel is om een dedicated slave-server in hot standby modus te onderhouden voor read-only transacties (er is geen behoefte aan zo'n verspilling van middelen).
In elk datacenter bevindt zich één server. Op elke server draaien twee instanties PostgreSQL (in de terminologie van PostgreSQL worden ze clusters genoemd, maar om verwarring te voorkomen zal ik ze instanties noemen, zoals met andere databases; clusters zal ik alleen gebruiken voor Pacemaker-clusters). Eén instantie werkt in de mastermodus en biedt alleen daar diensten aan (alleen op deze instantie wijst het float IP). De tweede instantie fungeert als slave voor het tweede datacenter en zal alleen diensten verlenen als zijn master uitvalt. Aangezien de meeste tijd slechts één van de twee instanties (de master) diensten aanbiedt (verzoeken uitvoert), worden alle serverresources geoptimaliseerd voor de master (zoals geheugen voor de cache shared_buffers, enz.), maar zodanig dat er ook genoeg resources zijn voor de tweede instantie (al is het voor minder optimale werking via de bestandssysteemcache) voor het geval van uitval van een van de datacenters. De slave biedt geen diensten aan (voert geen read-only verzoeken uit) tijdens de normale werking van het cluster, om oorlog om resources met de master op dezelfde machine te voorkomen.
Bij twee knooppunten is failover alleen mogelijk bij asynchrone replicatie, want bij synchronisatie leidt de uitval van de slave tot de stopzetting van de master.
Uitval getuige
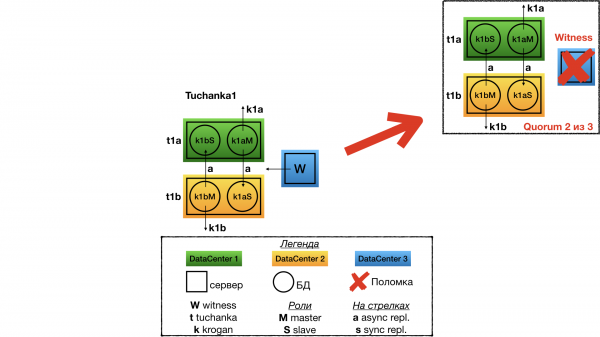
Uitval getuige (quorum device) zal ik alleen beschouwen voor het cluster Tuchanka1, het zal met alle andere hetzelfde verhaal zijn. Bij uitval van de getuige verandert er niets in de clusterstructuur, alles blijft werken zoals het werkte. Maar het quorum wordt 2 uit 3, en daarom zal elke volgende uitval fataal zijn voor de cluster. Het moet dringend worden gerepareerd.
Uitval Tuchanka1
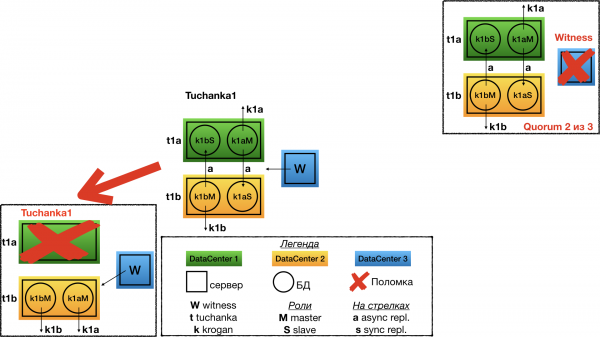
Uitval van een van de datacenters voor Tuchanka1. In dit geval witness geeft zijn stem aan het tweede knooppunt in het tweede datacenter. Daar verandert de voormalige slave in de master, waardoor beide masters op één server draaien en beide hun float IP aanwijzen.
Tuchanka2 (klassiek)
Structuur
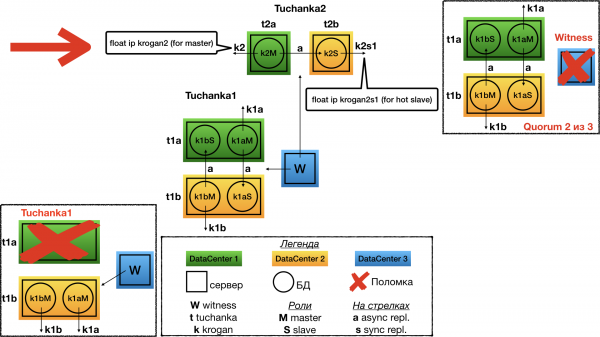
Klassiek schema met twee knooppunten. Op de ene draait de master, op de andere de slave. Beide kunnen verzoeken uitvoeren (de slave alleen read-only), daarom wijzen beiden naar float IP: krogan2 — naar de master, krogan2s1 — naar de slave. Zowel de master als de slave zullen failover hebben.
Bij twee knooppunten is failover alleen mogelijk bij asynchrone replicatie, want bij synchronisatie leidt de uitval van de slave tot de stopzetting van de master.
Uitval Tuchanka2
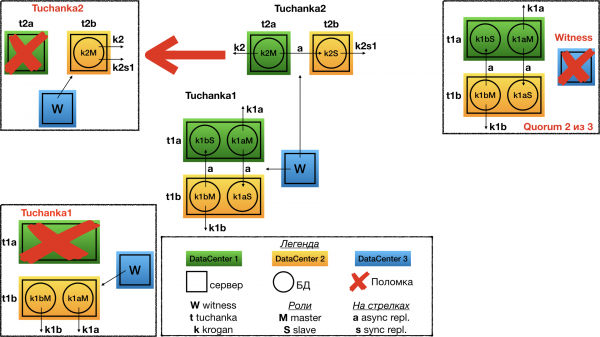
Bij uitval van een van de datacenters witness stemt voor de tweede. Op het enige werkende datacenter zal een master worden opgezet, en beide float IP's zullen naar deze master verwijzen: de master en de slave. Uiteraard moet de instantie zo worden ingesteld dat het voldoende middelen heeft (limieten voor verbindingen enz.) om gelijktijdig alle verbindingen en verzoeken van zowel de master als de slave float IP te verwerken. Dit betekent dat, onder normale omstandigheden, er voldoende limieten beschikbaar moeten zijn.
Tuchanka4 (veel slaven)
Structuur
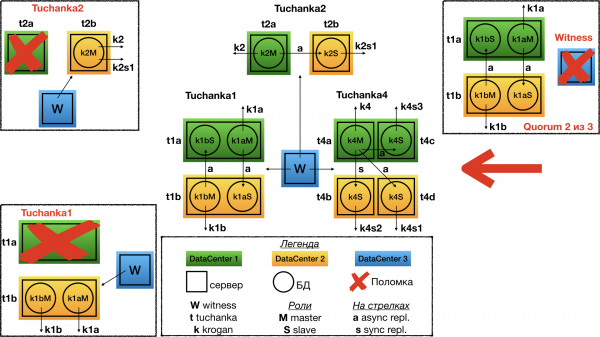
Alweer een andere extremiteit. Er zijn databases die veel read-only verzoeken ontvangen (een typisch geval van een zwaarbelaste site). Tuchanka4 is een situatie waarbij er drie of meer slaven kunnen zijn om deze verzoeken te verwerken, maar toch niet te veel. Bij een zeer groot aantal slaven moet er een hiërarchisch replicatiesysteem worden uitgevonden. In het minimaalste geval (zoals op de afbeelding) zijn er in elk van de twee datacenters twee servers, elk met een PostgreSQL instantie.
Een ander kenmerk van dit schema is dat hier al één synchrone replicatie kan worden georganiseerd. Deze is zo ingesteld dat het, indien mogelijk, naar een ander datacenter repliceert, en niet naar een replica in hetzelfde datacenter als de master. Zowel de master als elke slave verwijzen naar float IP. Idealiter moet er tussen slaven een verzoekbalancering worden gemaakt met een of andere sql proxy, bijvoorbeeld aan de klantzijde. Verschillende soorten klanten kunnen verschillende soorten sql proxynodig hebben, en alleen de ontwikkelaars van de klanten weten wie wat nodig heeft. Deze functionaliteit kan worden geïmplementeerd door zowel een externe daemon als een clientbibliotheek (connection pool), enz. Dit valt echter buiten het onderwerp van een fouttolerante databasecluster (fouttolerantie SQL proxy kan onafhankelijk worden geïmplementeerd, samen met de fouttolerantie van de client).
Fout van Tuchanka4
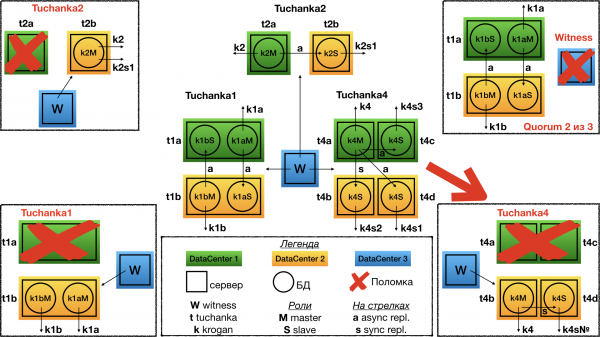
Bij de storing van één datacenter (d.w.z. twee servers) stemt de getuige voor de tweede. Als gevolg hiervan zijn er in het tweede datacenter twee servers in werking: op de ene draait de master, en deze verwijst naar de master float IP (voor het ontvangen van read-write verzoeken); en op de tweede server draait een slave met synchrone replicatie, en deze verwijst naar een van de slave float IP's (voor read-only verzoeken).
Het eerste dat opgemerkt moet worden: niet alle slave float IP's zullen actief zijn, maar slechts één. En voor een correcte werking daarmee moet ervoor gezorgd worden dat sql proxy verzendde alle verzoeken naar het enige overgebleven float-IP; en als sql proxy nee, dan kunnen alle float-IP's van de slaves door een komma in de URL voor verbinding worden opgesomd. In dat geval met libpq de verbinding zal naar het eerste functionele IP gaan, zoals gedaan is in het automatiseringssysteem voor testen. Misschien werkt het niet met andere bibliotheken, zoals JDBC, en is dat nodig sql proxy. Dit is gedaan omdat er voor de float-IP's van de slaves een verbod is ingesteld om tegelijkertijd op dezelfde server te draaien, zodat ze gelijkmatig over de slave-servers worden verspreid, als er meerdere in gebruik zijn.
Ten tweede: zelfs in het geval van een storing in het datacenter blijft de synchronisatie-replicatie bestaan. En zelfs als er een secundaire storing optreedt, dat wil zeggen, als een van de twee servers in het overblijvende datacenter defect raakt, zal de cluster, hoewel hij geen diensten meer kan aanbieden, nog steeds informatie over alle toegewezen transacties behouden waarvoor hij een commit-bevestiging heeft gegeven (er zal geen verlies van informatie zijn bij een secundaire storing).
Tuchanka3 (3 datacentra)
Structuur
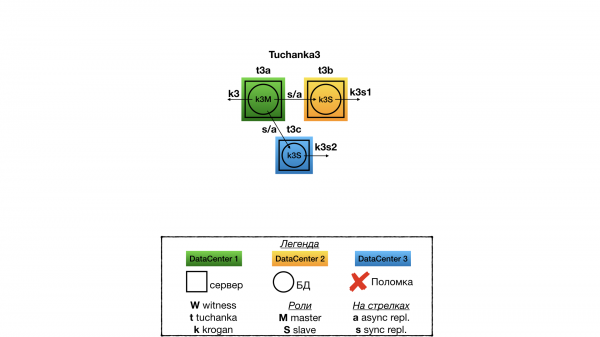
Dit is een cluster voor situaties waarin er drie volledig functionele datacentra zijn, elk met een volledig functionele database-server. In dat geval quorum device is niet nodig. In één datacenter draait de master, in de andere twee - slaves. De replicatie is synchronisch, type ANY (slave1, slave2), dat wil zeggen dat de client een commit-bevestiging ontvangt wanneer een van de slaves als eerste antwoordt dat hij de commit heeft geaccepteerd. Het aantal bronnen wordt aangeduid door één float-IP voor de master en twee voor de slaves. In tegenstelling tot Tuchanka4 zijn alle drie de float-IP's fouttolerant. Voor het balanceren van read-only SQL-verzoeken kan gebruik worden gemaakt van sql proxy (met aparte fouttolerantie), of de helft van de clients een slave float-IP toewijzen en de andere helft de tweede.
Fout Tuchanka3
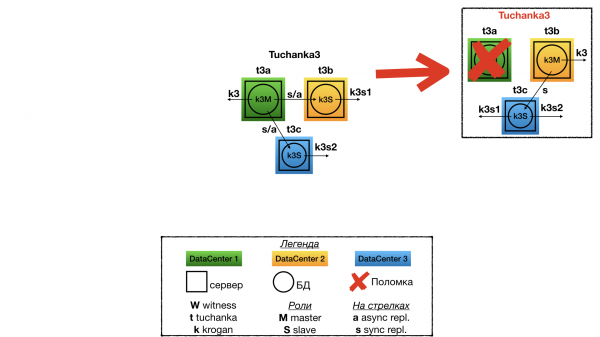
Bij een storing in een van de datacentra blijven er twee over. In de ene draait de master en het float-IP van de master, in de andere de slave en beide slave float-IP's (de instantie moet een dubbele reserve aan middelen hebben om alle verbindingen van beide slave float-IP's te accepteren). Tussen de master en de slave is er synchronische replicatie. Bovendien behoudt de cluster de informatie over toegewezen en bevestigde transacties (er zal geen verlies van informatie zijn) in het geval van de vernietiging van twee datacentra (als ze niet tegelijkertijd worden vernietigd).
Ik heb besloten om de gedetailleerde beschrijving van de bestandsstructuur en implementatie niet op te nemen. Wie wil experimenteren, kan dit alles lezen in README. Ik geef alleen de beschrijving van de geautomatiseerde testing.
Geautomatiseerd testsysteem
Voor het testen van de fouttolerantie van clusters met simulaties van verschillende storingen is een geautomatiseerd testsysteem ontwikkeld. Het wordt gestart met een script. test/failure. Het script kan als parameters de nummers van de clusters accepteren die je wilt testen. Bijvoorbeeld, deze opdracht:
test/failure 2 3zal alleen de tweede en derde cluster testen. Als er geen parameters zijn opgegeven, worden alle clusters getest. Alle clusters worden parallel getest, en het resultaat wordt weergegeven in het tmux-paneel. Tmux gebruikt een aparte tmux-server, dus het script kan worden uitgevoerd vanuit de standaard tmux, wat resulteert in geneste tmux. Ik raad aan een terminal te gebruiken in een groot venster met een klein lettertype. Voor het starten van de tests worden alle virtuele machines teruggezet naar hun snapshot op het moment dat het script wordt voltooid. setup.
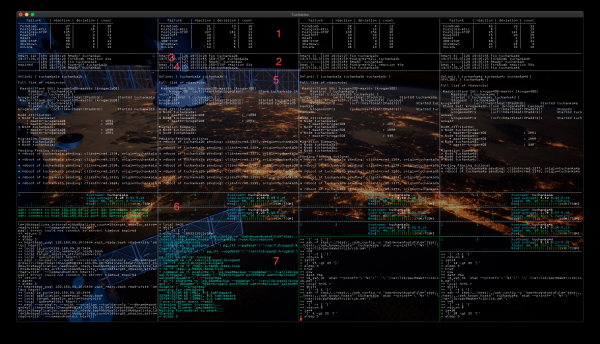
De terminal is verdeeld in kolommen overeenkomend met het aantal te testen clusters, standaard (op de schermafbeelding) zijn dat er vier. De inhoud van de kolommen beschrijf ik aan de hand van Tuchanka2. De panelen op de schermafbeelding zijn genummerd:
- Hier wordt statistiek over de tests weergegeven. Kolommen:
- failure — de naam van de test (functie in het script), die de storing simuleert.
- reaction — het gemiddelde tijd in seconden dat de cluster nodig had om zijn werking te herstellen. Dit wordt gemeten vanaf het begin van het script, dat de storing simuleert, tot het moment waarop de cluster zijn werking herstelt en weer diensten kan verlenen. Als de tijd heel kort is, bijvoorbeeld zes seconden (dat kan voorkomen in clusters met meerdere werknemers (Tuchanka3 en Tuchanka4)), betekent dit dat de storing zich op een asynchrone werknemer bevond en geen invloed heeft gehad op de werking; er was geen wisseling van de staat van de cluster.
- deviation — toont de spreiding (nauwkeurigheid) van de waarde reaction met de methode ‘ standaarddeviatie’.
- count — hoe vaak deze test is uitgevoerd.
- Een kort overzicht stelt je in staat om te beoordelen wat de cluster op dat moment doet. Het toont het iteratienummer (test), de tijdstempel en de naam van de bewerking. Een te lange uitvoering (> 5 minuten) wijst op een probleem.
- heart (hart) — huidige tijd. Voor visuele beoordeling van de functionaliteit meester in zijn tabel wordt voortdurend de huidige tijd geschreven met behulp van het float IP van de meester. Bij succes wordt het resultaat in dit paneel weergegeven.
- slag (pols) — 'huidige tijd', die eerder was geregistreerd door een script heart in de meester, nu gelezen uit slaaf via zijn float IP. Maakt visuele beoordeling van de functionaliteit van de slaaf en replicatie mogelijk. In Tuchanka1 zijn er geen slaven met float IP (geen slaven die diensten verlenen), maar er zijn wel twee instanties (DB), dus hier wordt niet weergegeven slag, met behulp van 1 bit, gelijk aan 0, heart tweede instantie.
- Monitoring van de status van de cluster met behulp van het hulpprogramma
pcs mon. Toont de structuur, verdeling van bronnen over de knooppunten en andere nuttige informatie. - Hier wordt systeemmonitoring weergegeven met elke virtuele machine van de cluster. Er kunnen meerdere van deze panelen zijn — zoveel virtuele machines als de cluster heeft. Twee grafieken CPU Load (in de virtuele machines twee processoren), naam van de virtuele machine, System Load (genoemd als Load Average, omdat het gemiddeld is over 5, 10 en 15 minuten), gegevens over processen en geheugenverdeling.
- Tracing van het script dat de tests uitvoert. In geval van een storing — een plotselinge onderbreking van de werking of een oneindige wachttijd — kan hier de oorzaak van dit gedrag worden gezien.
Tests worden in twee fasen uitgevoerd. Eerst doorloopt het script alle varianten van tests, waarbij willekeurig een virtuele machine wordt gekozen waaraan deze test wordt toegepast. Vervolgens wordt er een oneindige testcyclus uitgevoerd, waarbij bij elke keer willekeurig een virtuele machine en een storing wordt gekozen. Een plotselinge beëindiging van het testscript (onderste paneel) of een oneindige wachttijd voor iets (> 5 minuten uitvoeringstijd voor één operatie, dit is zichtbaar in de tracing) geeft aan dat een van de tests op deze cluster is mislukt.
Elke test bestaat uit de volgende bewerkingen:
- Start de functie die de storing emuleert.
- Klaar? — wachten op herstel van de functionaliteit van de cluster (wanneer alle diensten worden verleend).
- Toont de wachttijd voor herstel van de cluster (reaction).
- Fix — cluster wordt 'gerepareerd'. Daarna moet het terugkeren naar een volledig functionele staat en klaar zijn voor de volgende storing.
Hier is een lijst met tests met een beschrijving van wat ze doen:
- ForkBomb: creëert 'Out of memory' met behulp van een fork-bomb.
- OutOfSpace: de harde schijf raakt vol. Maar de test is eerder symbolisch, gezien de minimale belasting die tijdens het testen wordt gecreëerd; bij een volle harde schijf komt er meestal geen storing van PostgreSQL voor.
- Postgres-KILL: beëindigt PostgreSQL met het commando
killall -KILL postgres. - Postgres-STOP: pauzeert PostgreSQL met het commando
killall -STOP postgres. - PowerOff: 'schakelt de virtuele machine uit' met het commando
VBoxManage controlvm "virtuele machine" poweroff. - Reset: herstart de virtuele machine met het commando
VBoxManage controlvm "virtuele machine" reset. - SBD-STOP: pauzeert de SBD daemon met het commando
killall -STOP sbd. - ShutDown: stuurt via SSH het commando naar de virtuele machine
systemctl poweroff, het systeem sluit op de juiste manier af. - UnLink: netwerkisolatie, het commando
VBoxManage controlvm "virtuele machine" setlinkstate1 off.
Testen wordt afgesloten met behulp van het standaard commando tmux "kill-window" Ctrl-b &, of met het commando "detach-client" Ctrl-b d: hierbij wordt de test gestopt, tmux sluit, en de virtuele machines worden uitgeschakeld.
Problemen die tijdens de test zijn vastgesteld
Op dit moment de watchdog daemon sbd verwerkt het stoppen van de geobserveerde daemon, maar niet hun vastlopen. En als gevolg daarvan worden storingen die alleen vastlopen niet correct afgehandeld Corosync en Pacemaker, maar die wel vasthouden aan sbd. Voor controle Corosync al een , aangenomen in de branch master. Er is beloofd (in PR#83) dat er ook iets dergelijks voor Pacemaker zal komen, ik hoop dat dit voor RedHat 8 wordt gedaan. Maar dergelijke 'storingen' zijn theoretisch en kunnen gemakkelijk kunstmatig worden geïmiteerd met bijvoorbeeld
killall -STOP corosync, maar komen nooit in de echte wereld voor.Er Pacemaker in de versie voor CentOS 7 is sync_timeout verkeerd ingesteld , met als gevolg dat ‘ quorum devicebij het falen van één knooppunt met enige kans ook het tweede knooppunt werd herstart tijdens de uitrol (in het script , met als gevolg dat ‘ quorum device setup/setup1
). Deze correctie is niet geaccepteerd door de ontwikkelaars, in plaats daarvan hebben ze beloofd de infrastructuur zo te herontwerpen (in een niet nader gespecificeerd toekomst), zodat deze time-out automatisch wordt berekend. PacemakerAls bij het configureren van de database is aangegeven dat inLC_MESSAGES
(tekstberichten) Unicode kan worden gebruikt, bijvoorbeeldru_RU.UTF-8, dan bij het startenin een omgeving waar de locale geen UTF-8 is, bijvoorbeeld in een lege omgeving (hier postgres pacemaker pgsqlms+(paf) startin de log in plaats van UTF-8-letters zal vraagtekens zijn postgres), dan LC_MESSAGES=en_US.UTF-8LC_MESSAGES=nl_NL.UTF-8bij het configureren (aanmaken) van een database-instantie.Als wal_receiver_timeout is ingesteld (standaard is het 60s), dan vindt er tijdens de PostgreSQL-STOP test op de master in de clusters tuchanka3 en tuchanka4 . De replicatie is daar synchronisch, waardoor zowel de slave als de nieuwe master stopt. Dit kan worden omzeild door wal_receiver_timeout=0 in de PostgreSQL-configuratie in te stellen.
Soms heb ik vastlopers van de replicatie bij PostgreSQL waargenomen tijdens de ForkBomb test (geheugenoverloop). . Ik heb dit alleen gezien in de clusters tuchanka3 en tuchanka4, waar de master vastliep omdat de replicatie synchronisch is. Het probleem loste zichzelf na enige tijd (ongeveer twee uur) op. Verdere onderzoek is nodig om dit te verhelpen. Op basis van de symptomen lijkt het op een eerdere bug, die door een andere oorzaak wordt veroorzaakt, maar met dezelfde gevolgen.
De afbeelding van de krogan is afkomstig van met toestemming van de auteur:
Bron: habr.com
