

Ik wil mijn eerste succesvolle ervaring delen met het herstellen van de volledige functionaliteit van een Postgres-database. Ik ben een half jaar geleden voor het eerst met de databasebeheerder Postgres in aanraking gekomen, voor deze ervaring had ik helemaal geen databasebeheerservaring.
Ik werk als semi-DevOps engineer bij een groot IT-bedrijf. Ons bedrijf ontwikkelt software voor hoogbelaste services, en ik ben verantwoordelijk voor de functionaliteit, ondersteuning en deployment. Ik kreeg de standaardtaak om een applicatie op één server bij te werken. De applicatie is geschreven in Django, tijdens de update worden migraties uitgevoerd (de structuur van de database verandert), en voor dit proces maken we een volledige dump van de database via het standaardprogramma pg_dump voor de zekerheid.
Tijdens het maken van de dump verscheen er een onverwachte fout (Postgres-versie – 9.5):
pg_dump: Inhoud van tabel 'ws_log_smevlog' dumpen mislukt: PQgetResult() is mislukt.
pg_dump: Foutmelding van de server: FOUT: ongeldig pagina in blok 4123007 van relatton base/16490/21396989
pg_dump: Het commando was: COPY public.ws_log_smevlog [...]
pg_dunp: [parallel archivering] een werkproces is onverwacht beëindigd
Fout „ongeldige pagina in blok” duidt op problemen op het niveau van het bestandssysteem, wat zeer slecht is. Op verschillende forums werd aangeraden om VOLLEDIGE VACUUM met de optie zero_damaged_pages te gebruiken om dit probleem op te lossen. Nou, laten we het eens proberen...
Voorbereiding voor herstel
LET OP! Zorg ervoor dat je een back-up van Postgres maakt voordat je probeert de database te herstellen. Als je een virtuele machine hebt, stop dan de database en maak een snapshot. Als er geen mogelijkheid is om een snapshot te maken, stop dan de database en kopieer de inhoud van de Postgres-map (inclusief wal-bestanden) naar een veilige locatie. Het belangrijkste in ons geval is om niet meer schade te veroorzaken. Lees .
Aangezien de database over het algemeen functioneerde, heb ik me beperkt tot een gewone database dump, maar heb ik de tabel met beschadigde gegevens uitgesloten (optie -T, —exclude-table=TABLE in pg_dump).
De server was fysiek, een snapshot maken was niet mogelijk. Backup gemaakt, laten we verder gaan.
Controle van het bestandssysteem
Voordat je probeert de database te herstellen, moet je ervoor zorgen dat alles in orde is met het bestandssysteem. En in geval van fouten, deze corrigeren, want anders maak je het alleen maar erger.
In mijn geval was het bestandssysteem met de database gemonteerd in „/srv” en het type was ext4.
We stoppen de database: systemctl stop postgresql@9.5-main.service en controleren dat het bestandssysteem niet in gebruik is en kan worden ontkoppeld met het commando lsof:
lsof +D /srv
Ik moest ook de Redis-database stoppen, omdat deze ook gebruikte „/srv”. Vervolgens heb ik ontkoppeld /srv (umount).
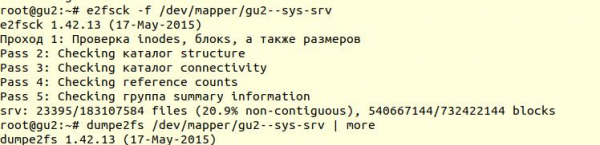
De controle van het bestandssysteem is uitgevoerd met het hulpprogramma e2fsck met de optie -f (Force checking even if filesystem is marked clean):
Vervolgens kun je met het hulpprogramma dumpe2fs (sudo dumpe2fs /dev/mapper/gu2—sys-srv | grep checked) bevestigen dat de controle daadwerkelijk is uitgevoerd:
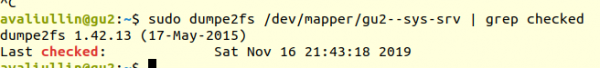
e2fsck het zegt dat er geen problemen zijn gevonden op het niveau van het ext4-bestandssysteem, wat betekent dat we kunnen doorgaan met de pogingen om de database te herstellen, oftewel terug te keren naar vacuum full (natuurlijk moet je het bestandssysteem weer aankoppelen en de database starten).
Als je een fysieke server hebt, controleer dan de status van de schijven (via smartctl -a /dev/XXX) of de RAID-controller om te bevestigen dat het probleem niet op hardware-niveau ligt. In mijn geval was de RAID 'hardware', dus vroeg ik de lokale admin om de status van de RAID te controleren (de server was enkele honderden kilometers van mijn locatie). Hij zei dat er geen fouten waren, wat betekent dat we zeker kunnen beginnen met het herstel.
Poging 1: zero_damaged_pages
We verbinden met de database via psql met een account dat supergebruikersrechten heeft. We hebben echt een supergebruiker nodig, omdat alleen hij de optie zero_damaged_pages kan wijzigen. In mijn geval is dat postgres:
psql -h 127.0.0.1 -U postgres -s [database_name]
Optie zero_damaged_pages is nodig om leesfouten te negeren (van de website postgrespro):
Bij ontdekking van een beschadigde pagina-header meldt Postgres Pro meestal een fout en onderbreekt de huidige transactie. Als de parameter zero_damaged_pages is ingeschakeld, geeft het systeem in plaats daarvan een waarschuwing, nul de beschadigde pagina in het geheugen en gaat verder met de verwerking. Dit gedrag verwoest gegevens, namelijk alle rijen in de beschadigde pagina.
We schakelen de optie in en proberen een volledige vacuum van de tabel te maken:
VACUUM FULL VERBOSE 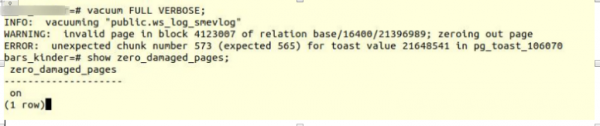
Helaas, het is mislukt.
We kwamen een soortgelijke fout tegen:
INFO: vacuuming "“public.ws_log_smevlog”
WARNING: invalid page in block 4123007 of relation base/16400/21396989; zeroing out page
ERROR: unexpected chunk number 573 (expected 565) for toast value 21648541 in pg_toast_106070– opslagmechanisme voor 'lange gegevens' in PostgreSQL, als ze niet op één pagina passen (standaard 8 KB).
Poging 2: reindex
De eerste tip van Google hielp niet. Na enkele minuten zoeken vond ik een tweede tip - maak een reindex van de beschadigde tabel. Deze tip had ik op veel plaatsen gezien, maar deze gaf me geen vertrouwen. Laten we een reindex doen:
reindex table ws_log_smevlog 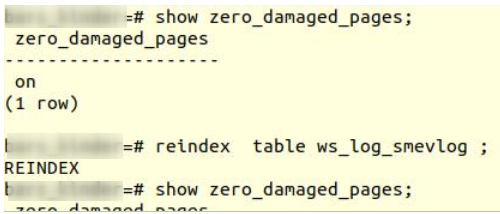
reindex eindigde zonder problemen.
Echter, dit hielp niet, VACUUM FULL kwam met een soortgelijke fout. Omdat ik gewend was aan mislukkingen, begon ik verder op internet naar tips te zoeken en stuitte op een vrij interessante .
Poging 3: SELECT, LIMIT, OFFSET
In het bovenstaande artikel werd voorgesteld om de tabel regel voor regel te bekijken en probleemdata te verwijderen. Eerst moest ik alle regels bekijken:
for ((i=0; i/dev/null || echo $i; doneIn mijn geval bevatte de tabel 1 628 991 regels! Gewoonlijk zou het nodig zijn om zorg te dragen voor , maar dat is een onderwerp voor een apart gesprek. Het was zaterdag, ik startte dit commando in tmux en ging slapen:
for ((i=0; i/dev/null || echo $i; doneIn de ochtend besloot ik te controleren hoe het ervoor stond. Tot mijn verbazing ontdekte ik dat er in 20 uur slechts 2% van de gegevens was gescand! 50 dagen wachten wou ik niet. Weer een totale mislukking.
Maar ik gaf niet op. Ik was nieuwsgierig waarom het scannen zo lang duurde. Uit de documentatie (weer op postgrespro) leerde ik:
OFFSET geeft aan hoeveel rijen overgeslagen moeten worden voordat de rijen beginnen te verschijnen.
Als er zowel OFFSET als LIMIT is opgegeven, slaat het systeem eerst OFFSET rijen over en begint vervolgens de rijen te tellen voor de LIMIT-beperking.Bij het toepassen van LIMIT is het belangrijk ook een ORDER BY-verklaring te gebruiken, zodat de resultaatrijen in een bepaalde volgorde worden weergegeven. Anders zullen onvoorspelbare subsets van rijen worden teruggegeven.
Het is duidelijk dat het bovenstaande commando fout was: ten eerste was er geen order by, het resultaat kon foutief zijn. Ten tweede moest Postgres eerst de OFFSET-rijen scannen en overgeslagen worden, en met de toename OFFSET zou de prestaties nog verder afnemen.
Poging 4: een dump in tekstformaat maken
Toen kwam ik op het idee, dat blijkbaar geniaal leek: maak een dump in tekstformaat en analyseer de laatst vastgelegde rij.
Maar laten we eerst de structuur van de tabel bekijken ws_log_smevlog:
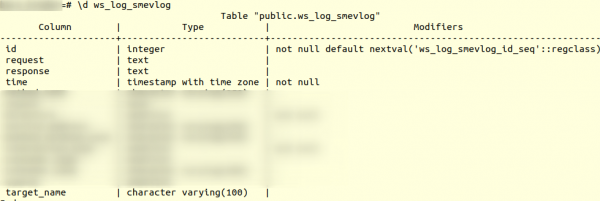
In ons geval hebben we een kolom «id», die een unieke identificator (teller) van de regel bevatte. Het plan was als volgt:
- We beginnen met het maken van een dump in tekstformaat (als SQL-commando's)
- Op een bepaald moment zou het dumpen onderbroken worden door een fout, maar het tekstbestand zou toch op de schijf zijn opgeslagen
- We bekijken het einde van het tekstbestand, waarmee we de identificator (id) van de laatste regel vinden die succesvol is opgeslagen
Ik begon met het maken van een dump in tekstvorm:
pg_dump -U my_user -d my_database -F p -t ws_log_smevlog -f ./my_dump.dumpHet dumpen, zoals verwacht, werd onderbroken met dezelfde fout:
pg_dump: Foutmelding van de server: ERROR: ongeldige pagina in blok 4123007 van relatton base/16490/21396989 Daarna via tail bekeek ik het einde van de dump (tail -5 ./my_dump.dump) ontdekte ik dat de dump was onderbroken op de regel met id 186 525. 'Dus, het probleem zit in de regel met id 186 526, die is corrupt en moet verwijderd worden!' - dacht ik. Maar, toen ik een query in de database deed:
«select * from ws_log_smevlog where id=186529bleek dat er met deze regel niets mis was... De regels met indexen 186 530 - 186 540 werkten ook probleemloos. Nog een 'geniaal idee' faalde. Later begreep ik waarom dit gebeurde: bij het verwijderen of wijzigen van gegevens in een tabel worden ze niet fysiek verwijderd, maar gemarkeerd als 'dode tuples', en vervolgens komt autovacuum en markeert deze regels als verwijderd en staat toe dat deze regels opnieuw worden gebruikt. Voor de duidelijkheid, als de gegevens in de tabel wijzigen en autovacuum is ingeschakeld, worden ze niet opeenvolgend opgeslagen.
Poging 5: SELECT, FROM, WHERE id=
Mislukkingen maken ons sterker. Je moet nooit opgeven, je moet doorgaan tot het einde en in jezelf en je mogelijkheden geloven. Daarom besloot ik nog een optie te proberen: gewoon alle records in de database één voor één te bekijken. Wetende dat mijn tabelstructuur (zie hierboven) een veld id bevat dat uniek is (primaire sleutel). In de tabel hebben we 1.628.991 regels en id ze komen in volgorde, wat betekent dat we ze eenvoudig één voor één kunnen doorlopen:
for ((i=1; i/dev/null || echo $i; doneAls iemand het niet begrijpt, werkt het commando als volgt: het doorloopt de tabel regel voor regel en stuurt stdout naar /dev/null, maar als het SELECT-commando faalt, wordt de fouttekst weergegeven (stderr gaat naar de console) en wordt de regel weergegeven die de fout bevat (dankzij ||, wat betekent dat er problemen zijn opgetreden bij de select (de returncode van het commando is niet 0)).
Ik had geluk, ik had indexen gemaakt op het veld id:
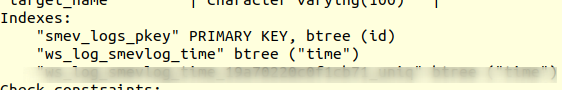
En dat betekent dat het vinden van de regel met de juiste id niet veel tijd mag kosten. In theorie zou het moeten werken. Laten we de opdracht uitvoeren in tmux en gaan slapen.
In de ochtend ontdekte ik dat er ongeveer 90.000 records waren bekeken, wat iets meer dan 5% is. Een uitstekend resultaat vergeleken met de vorige methode (2%)! Maar ik had geen zin om 20 dagen te wachten...
Poging 6: SELECT, FROM, WHERE id >= and id <
Voor de klant was er een uitstekende server toegewezen voor de database: een dual-core Intel Xeon E5-2697 v2, met in totaal 48 threads tot onze beschikking! De belasting op de server was gemiddeld, we konden zonder al te veel problemen ongeveer 20 threads afhandelen. Er was ook genoeg RAM: maar liefst 384 gigabyte!
Daarom moest de opdracht gelijktijdig worden uitgevoerd:
for ((i=1; i/dev/null || echo $i; doneHier had ik een mooie en elegante script kunnen schrijven, maar ik koos voor de snelste manier om te paralleliseren: handmatig het bereik van 0-1628991 opdelen in intervallen van 100.000 records en 16 opdrachten van het type draaien:
for ((i=N; i/dev/null || echo $i; doneMaar dat is nog niet alles. In theorie kost het verbinden met de database ook enige tijd en systeembronnen. Het aansluiten van 1.628.991 was niet zo verstandig, dat kunnen we wel begrijpen. Laten we daarom bij één verbinding 1000 rijen in plaats van één ophalen. Uiteindelijk is de opdracht veranderd in:
for ((i=N; i=$i and id/dev/null || echo $i; doneWe openen 16 vensters in de tmux-sessie en voeren de opdrachten uit:
1) for ((i=0; i=$i and id/dev/null || echo $i; done
2) for ((i=100000; i=$i and id/dev/null || echo $i; done
…
15) for ((i=1400000; i=$i and id/dev/null || echo $i; done
16) for ((i=1500000; i=$i and id/dev/null || echo $i; done
Na een dag ontving ik de eerste resultaten! Namelijk (de waarden XXX en ZZZ zijn niet meer bewaard):
ERROR: missing chunk number 0 for toast value 37837571 in pg_toast_106070
829000
ERROR: missing chunk number 0 for toast value XXX in pg_toast_106070
829000
ERROR: missing chunk number 0 for toast value ZZZ in pg_toast_106070
146000
Dit betekent dat we drie rijen hebben met een fout. De id van de eerste en tweede problematische record bevonden zich tussen 829.000 en 830.000, de id van de derde tussen 146.000 en 147.000. Vervolgens moesten we gewoon de exacte waarde van de id van de problematische records vinden. Hiervoor bekijken we ons bereik met problematische records in stappen van 1 en identificeren de id:
for ((i=829000; i/dev/null || echo $i; done
829417
ERROR:  onverwacht chunk nummer 2 (verwacht 0) voor toast waarde 37837843 in pg_toast_106070
829449
for ((i=146000; i/dev/null || echo $i; done
829417
ERROR:  onverwacht chunk nummer ZZZ (verwacht 0) voor toast waarde XXX in pg_toast_106070
146911
Gelukkig einde
We hebben de problematische rijen gevonden. We gaan de database in via psql en proberen ze te verwijderen:
my_database=# delete from ws_log_smevlog where id=829417;
DELETE 1
my_database=# delete from ws_log_smevlog where id=829449;
DELETE 1
my_database=# delete from ws_log_smevlog where id=146911;
DELETE 1
Tot mijn verbazing werden de records zonder enige problemen verwijderd, zelfs zonder de optie zero_damaged_pages.
Daarna heb ik verbinding gemaakt met de database, heb ik gedaan VACUUM FULL (ik denk niet dat het nodig was), en uiteindelijk heb ik succesvol een backup gemaakt met behulp van pg_dump. De dump werd zonder enige fouten gemaakt! Het probleem is op zo'n domme manier opgelost. De vreugde was groot, na zoveel mislukkingen was er eindelijk een oplossing gevonden!
Dankbetuigingen en conclusie
Dit was mijn eerste ervaring met het herstellen van een echte Postgres-database. Deze ervaring zal ik nog lange tijd herinneren.
Tot slot wil ik het bedrijf PostgresPro bedanken voor de vertaalde documentatie in het Russisch en voor , die enorm hebben geholpen tijdens de analyse van het probleem.
Bron: habr.com
