

Vandaag functioneren er op ons project, naast monolithische code, tientallen microservices. Elk van hen vereist monitoring. Dit is problematisch om door DevOps-engineers in zulke grote hoeveelheden te doen. We hebben een monitoreersysteem ontwikkeld dat als een service voor ontwikkelaars werkt. Ze kunnen zelf metrics naar het monitorsysteem schrijven, deze gebruiken, dashboards op basis daarvan opstellen en ze koppelen aan alerts die afgaan bij het bereiken van drempelwaarden. Voor DevOps-engineers is er alleen infrastructuur en documentatie.
Deze post is een transcript van mijn presentatie tijdens onze op RIT++. Velen vroegen ons om tekstversies van de daar gehouden lezingen te maken. Als je op de conferentie was of de video hebt bekeken, vind je niets nieuws. Voor iedereen andere: welkom onder de kat. Ik zal vertellen hoe we tot dit systeem zijn gekomen, hoe het functioneert en hoe we van plan zijn het bij te werken.
Het verleden: schema's en plannen
Hoe zijn we tot het huidige monitorsysteem gekomen? Om deze vraag te beantwoorden, moeten we terug naar 2015. Zo zag het er toen uit:
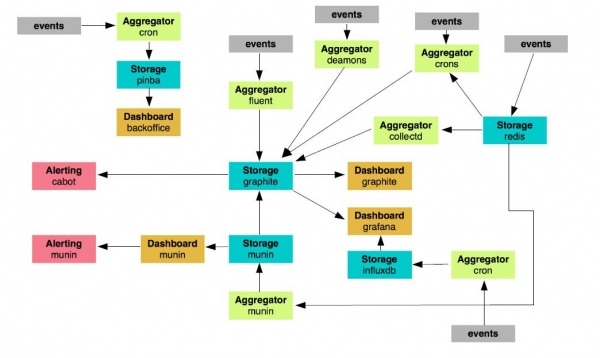
We hadden ongeveer 24 knooppunten die verantwoordelijk waren voor monitoring. Hier zijn een heleboel verschillende cronjobs, scripts, daemonprocessen die op de een of andere manier iets monitoren, berichten verzenden, functies uitvoeren. We dachten dat hoe verder we gingen, hoe minder levensvatbaar zo'n systeem zou zijn. Het heeft geen zin om het verder te ontwikkelen: het is te log.
We hebben besloten welke monitoringelementen we willen behouden en ontwikkelen en van welke we afscheid nemen. Het bleken er 19 te zijn. Alleen graphite, aggregators en Grafana als dashboard blijven over. Maar hoe zal het nieuwe systeem eruitzien? Zo:
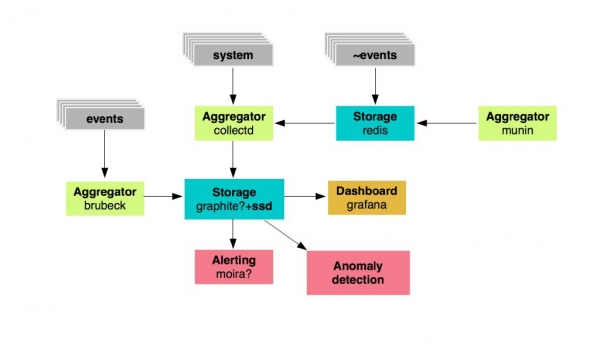
We hebben een opslagplaats voor metrics: dat zijn graphite die op snelle SSD-schijven worden gebaseerd, en specifieke aggregators voor metrics. Vervolgens—Grafana voor het weergeven van dashboards en Moira voor alerting. We wilden ook een systeem ontwikkelen voor het zoeken naar anomalieën.
Standaard: Monitoring 2.0
Zo zagen de plannen er in 2015 uit. Maar we moesten niet alleen de infrastructuur en de service zelf klaarmaken, maar ook de documentatie daarvoor. We hebben voor onszelf een bedrijfsstandaard ontwikkeld, die we monitoring 2.0 noemden. Wat waren de vereisten voor het systeem?
- permanente beschikbaarheid;
- bewaarinterval voor metrics = 10 seconden;
- georganiseerde opslag van metrics en dashboards;
- SLA > 99,99%
- verzameling van evenementmetrics via UDP (!).
We hadden UDP nodig omdat we een grote hoeveelheid verkeer en gebeurtenissen hebben die metrics genereren. Als we ze allemaal tegelijk naar Graphite schrijven, valt de opslag uit. We hebben ook eerste niveau prefixes voor alle metrics gekozen.
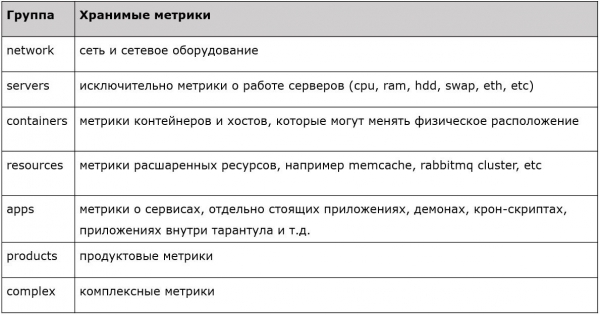
Elke prefix heeft een bepaalde eigenschap. Er zijn metrics voor servers, netwerken, containers, bronnen, toepassingen, enzovoort. Er is een duidelijke, strikte, getypeerde filtering geïmplementeerd, waarbij we de eerste niveau metrics accepteren en de anderen gewoon weggooien. Zo hebben we dit systeem in 2015 gepland. Wat is er nu?
Hedendaagse: het schema van de interactie tussen monitoringcomponenten
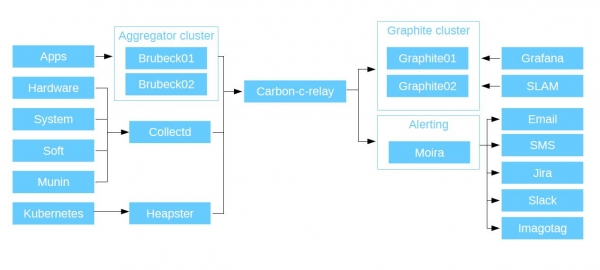
Allereerst monitoren we de applicaties: onze PHP-code, applicaties en microservices — kortom, alles wat onze ontwikkelaars schrijven. Alle applicaties sturen metrics via UDP naar de aggregator Brubeck (statsd, herschreven in C). Dit bleek de snelste te zijn op basis van synthetische tests. En het stuurt al geaggregeerde metrics via TCP naar Graphite.
Het heeft een type metric genaamd timers. Dit is een erg handige functie. Bijvoorbeeld, voor elke gebruikersverbinding met de service stuur je een metric met de response time naar Brubeck. Er kwamen een miljoen antwoorden binnen, maar de aggregator gaf slechts 10 metrics weer. Je hebt het aantal binnenkomende mensen, de maximale, minimale en gemiddelde responstijd, de mediaan en 4 percentielen. Vervolgens worden de gegevens naar Graphite verzonden en zien we ze allemaal live.
Daarnaast hebben we aggregatie voor metrics van hardware, software, systeemmetrics en ons oude monitoring-systeem Munin (dat bij ons werkte tot 2015). Al deze gegevens verzamelen we via de C-daemon CollectD (hierin is een hele reeks verschillende plugins ingebouwd, het kan alle bronnen van het host-systeem waarop het is geïnstalleerd opvragen, geef simpelweg in de configuratie aan waar de gegevens moeten worden geschreven) en schrijven we de gegevens naar Graphite. Het ondersteunt ook python- en shell-scriptplugins, zodat je je eigen op maat gemaakte oplossingen kunt schrijven: CollectD verzamelt deze gegevens van een lokale of externe host (stel je voor, er is Curl) en stuurt ze naar Graphite.
Vervolgens sturen we alle verzamelde metrics naar Carbon-c-relay. Dit is de Carbon Relay-oplossing van Graphite, aangepast in C. Het is een router die alle metrics verzamelt die we van onze aggregators verzenden en deze routeert naar de nodes. Tijdens de routering controleert het ook de geldigheid van de metrics. Ten eerste moeten ze voldoen aan het schema met de prefixes dat ik eerder heb getoond en ten tweede moeten ze geldig zijn voor Graphite. Anders worden ze verworpen.
Daarna stuurt Carbon-c-relay de metrics naar het Graphite-cluster. We gebruiken Carbon-cache, herschreven in Go, als onze belangrijkste opslag voor metrics. Go-carbon overtreft Carbon-cache in prestaties aanzienlijk vanwege zijn multithreading. Het accepteert gegevens en schrijft deze op schijven met behulp van het whisper-pakket (de standaard, geschreven in Python). Om gegevens uit onze opslag te lezen, gebruiken we de Graphite API. Dit werkt veel sneller dan de standaard Graphite WEB. Wat gebeurt er daarna met de gegevens?
Ze gaan naar Grafana. Als primaire gegevensbron gebruiken we onze Graphite-clusters, plus we hebben Grafana als webinterface voor het weergeven van metrics en het bouwen van dashboards. Voor elke service creëren ontwikkelaars hun eigen dashboard. Daarna bouwen ze grafieken waarmee de metrics worden weergegeven die ze vanuit hun applicaties verzenden. Naast Grafana hebben we ook SLAM. Dit is een Python-daemon die SLA's berekent op basis van gegevens uit Graphite. Zoals ik al zei, hebben we een paar decennia microservices, elk met hun eigen vereisten. Met behulp van SLAM raadplegen we de documentatie en vergelijken deze met wat er in Graphite is, en we vergelijken hoe goed de vereisten overeenkomen met de beschikbaarheid van onze diensten.
Laten we verder gaan: alerting. Dit is georganiseerd met behulp van een sterk systeem - Moira. Het is onafhankelijk omdat het onder de motorkap zijn eigen Graphite heeft. Ontwikkeld door jongens van SKB 'Kontur', geschreven in Python en Go, volledig open source. Moira ontvangt dezelfde stroom die naar Graphite gaat. Als om de een of andere reden uw opslag uitvalt, blijft uw alerting werken.
Moira draait in Kubernetes en gebruikt een cluster van Redis-servers als de belangrijkste database. Het resultaat is een fouttolerant systeem. Het vergelijkt de stroom van metrics met een lijst van triggers: als er geen vermeldingen zijn, wordt de metric gedropt. Zo kan het gigabytes aan metrics per minuut verwerken.
Daarnaast hebben we een bedrijfs-LDAP eraan gekoppeld, waarmee elke gebruiker van het bedrijfsysteem meldingen kan aanmaken voor bestaande (of nieuw gecreëerde) triggers. Aangezien Moira Graphite bevat, ondersteunt het al zijn functies. Je kopieert eerst een regel naar Grafana om te zien hoe de gegevens op de grafieken worden weergegeven. Vervolgens neem je dezelfde regel en kopieer je deze naar Moira. Je stelt er limieten aan in en ontvangt de alerting. Voor dit alles heb je geen specifieke kennis nodig. Moira kan alerten per sms, e-mail, in Jira, Slack... Bovendien ondersteunt het het uitvoeren van aangepaste scripts. Wanneer er een trigger plaatsvindt waar het aan een aangepast script of binaire app is gekoppeld, start het dit en geeft het JSON via stdin aan deze binaire app. Jouw programma moet dit parseren. Wat je met deze JSON doet, is aan jou. Wil je het naar Telegram sturen, of taken in Jira openen, doe wat je wilt.
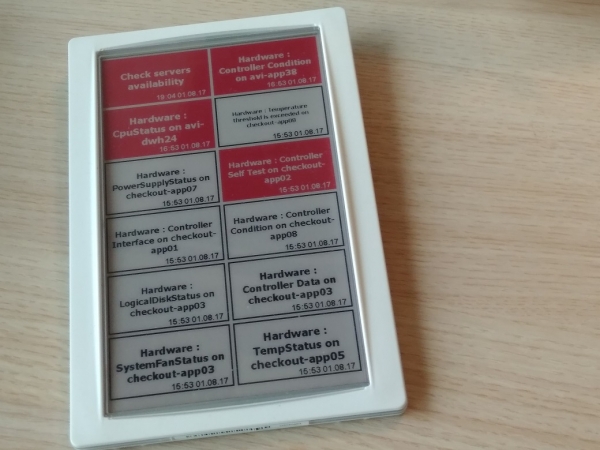
Voor alerting gebruiken we ook een eigen ontwikkeling — Imagotag. We hebben een paneel, dat normaal gesproken wordt toegepast voor elektronische prijslabels in winkels, aangepast voor onze taken. We hebben de triggers uit Moira daarop weergegeven. Daar staat in welke status ze zijn en wanneer het gebeurde. Een deel van het ontwikkelingsteam heeft de meldingen in Slack en via e-mail opgegeven ten gunste van dit paneel.
En omdat we een progressief bedrijf zijn, hebben we ook Kubernetes in dit systeem gemonitord. We hebben het systeem geïntegreerd via Heapster, dat we in het cluster hebben geïnstalleerd; dit verzamelt gegevens en verstuurt ze naar Graphite. Het schema ziet er als volgt uit:
Monitoringcomponenten
Hier is een lijst van links naar de componenten die we hebben gebruikt voor deze taak. Ze zijn allemaal open-source.
Graphite:
- go-carbon:
- whisper:
- graphite-api:
Carbon-c-relay:
Brubeck:
Collectd:
Moira:
Grafana:
Heapster:
Statistieken
Hier zijn een paar cijfers over hoe ons systeem werkt.
Aggregator (brubeck)
Aantal metrics: ~ 300.000 / sec
Verzendinterval van metrics naar Graphite: 30 sec
Serverbronnen gebruik: ~ 6% CPU (betreft volledige servers); ~ 1Gb RAM; ~ 3 Mbps LAN
Graphite (go-carbon)
Aantal metrics: ~ 1.600.000 / min
Updatesnelheid van metrics: 30 sec
Opslagschema van metrics: 30sec 35d, 5min 90d, 10min 365d (geeft inzicht in wat er op lange termijn met de service gebeurt)
Serverbronnen gebruik: ~ 10% CPU; ~ 20Gb RAM; ~ 30 Mbps LAN
Flexibiliteit
Bij Avito waarderen we de flexibiliteit in onze monitoringservice enorm. Hoe is het zo tot stand gekomen? Ten eerste, de onderdelen zijn uitwisselbaar: zowel de componenten als hun versies. Ten tweede — onderhoudbaarheid. Aangezien het hele project op open source is gebaseerd, kunt u zelf de code aanpassen, wijzigingen aanbrengen en functies implementeren die niet standaard beschikbaar zijn. We gebruiken vrij gangbare stacks, voornamelijk Go en Python, dus dat is vrij eenvoudig.
Hier is een voorbeeld van een echt probleem. Een metric in Graphite is een bestand. Het heeft een naam. De bestandsnaam = de naam van de metric. En er is een pad naar dit bestand. Bestandsnamen in Linux zijn beperkt tot 255 tekens. En wij hebben (als 'interne opdrachtgevers') jongens uit de database-afdeling. Zij zeggen tegen ons: 'Wij willen onze SQL-query's monitoren. En deze zijn niet 255 tekens, maar 8 MB elk. We willen ze weergeven in Grafana, de parameters van deze query zien, en nog beter, we willen de top van dergelijke query's zien. Het zou geweldig zijn als dit in real-time kan worden weergegeven. En nog beter zou het zijn als we dit in alerts kunnen integreren.'
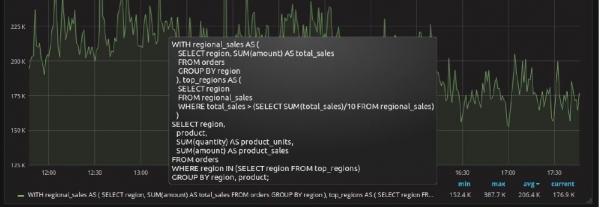
Een voorbeeld van een SQL-query is als voorbeeld genomen van
We set up a Redis server with our Collectd plugins that access Postgres to retrieve all the data and send metrics to Graphite. However, we replace the metric name with hashes. This same hash is simultaneously sent to Redis as a key, with the entire SQL query as the value. We need to ensure that Grafana can query Redis to fetch this information. We're opening the Graphite API because it's the main interface for all monitoring components to interact with Graphite, and we're adding a new function called aliasByHash() — we receive the metric name from Grafana and use it in the Redis query as the key, and in response, we receive the value of the key, which is our “SQL query.” This way, we presented the SQL query in Grafana, which ideally couldn't be displayed there, along with its statistics (calls, rows, total_time, ...).
Conclusies
Beschikbaarheid. Onze monitoringservice is 24/7 beschikbaar vanuit elke applicatie en elke code. Als je toegang hebt tot de opslagplaatsen, kun je gegevens naar de service schrijven. De taal is niet belangrijk, de oplossingen zijn niet belangrijk. Je hoeft alleen te weten hoe je een socket opent, de metric uploadt en de socket sluit.
Reliability. Alle componenten zijn fouttolerant en kunnen onze belasting goed aan.
Lage instapdrempel. Om dit systeem te gebruiken, hoef je geen programmeertalen of queries in Grafana te leren. Je opent gewoon je applicatie, vult de socket in die metrics naar Graphite zal sturen, sluit deze, opent Grafana, maakt dashboards aan en bekijkt het gedrag van je metrics, terwijl je meldingen ontvangt via Moira.
Zelfstandigheid. Dit alles kan je zelf doen, zonder hulp van DevOps-engineers. En dit is overkill, want je kunt je project nu al monitoren, je hoeft niemand te vragen — niet om te beginnen, niet voor wijzigingen.
Waar streven we naar?
Alles wat hieronder staat, zijn geen abstracte gedachten, maar doelen waarop minstens de eerste stappen zijn gezet.
- Anomaliedetector. We willen een service implementeren die onze Graphite-opslagplaatsen bezoekt en elke metric controleert met verschillende algoritmen. Er zijn al algoritmen die we willen inspecteren, we hebben de gegevens en we weten hoe we ermee moeten werken.
- Metadata. We have many services that change over time, just like the people who work with them. Keeping documentation up to date manually is not an option. Therefore, we now embed metadata into our microservices. It specifies who developed it, the languages it interacts with, SLA requirements, where and to whom to send notifications. During the deployment of a service, all entity data is created automatically. In the end, you receive two links — one for triggers and the other for dashboards in Grafana.
- Monitoring in every home. We believe that all developers should use such a system. In this case, you always understand where your traffic is, what is happening to it, where it drops, and where its weak points are. If something happens that overwhelms your service, you will find out not during a call from a manager, but through an alert, and you can immediately open fresh logs and see what happened.
- High performance. Our project is constantly growing, and today it handles about 2,000,000 metric values per minute. A year ago, this number was 500,000. And growth continues, which means that after a while, Graphite (whisper) will start to heavily load the disk subsystem. As I mentioned, this monitoring system is quite versatile due to the interchangeability of components. Some specifically maintain and continuously expand their infrastructure for Graphite, but we chose a different path: to use as storage for our metrics. This transition is nearly complete, and soon I will provide more details on how it was done: what challenges there were and how they were overcome, how the migration process went, and I will describe the components chosen for integration and their configurations.
Thank you for your attention! Feel free to ask your questions on the topic, and I will try to answer them here or in future posts. Perhaps some of you have experience building a similar monitoring system or transitioning to Clickhouse in a comparable situation — please share it in the comments.
Bron: habr.com
