

Laten we het concept van Kubernetes-monitoring bekijken, kennismaken met de tool Prometheus en praten over alerting.
Het onderwerp monitoring is uitgebreid, het kan niet in één artikel worden behandeld. Het doel van deze tekst is om een overzicht te geven van de tools, concepten en benaderingen.
Het materiaal van het artikel is een samenvatting van . Als je een volledige opleiding wilt volgen, schrijf je dan in voor de cursus over .
Wat er in een Kubernetes-cluster wordt gemonitord
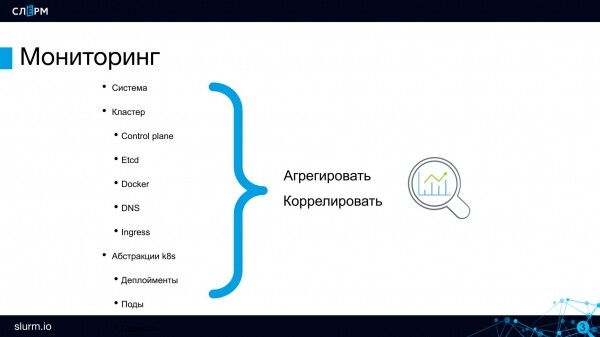
Fysieke servers. Als het Kubernetes-cluster op je eigen servers is geïmplementeerd, moet je hun gezondheid in de gaten houden. Deze taak wordt uitgevoerd door Zabbix; als je hiermee werkt, hoef je niet te stoppen, er zullen geen conflicten zijn. Zabbix houdt onze servers in de gaten.
Laten we overgaan naar monitoring op cluster niveau.
Control Plane-componenten: API, Scheduler en anderen. In ieder geval moet je ervoor zorgen dat er meer dan 0 API-servers of etcd zijn. Etcd kan veel statistieken leveren: over de schijven waarop het draait, over de gezondheid van zijn etcd-cluster en anderen.
Docker is al een tijdje beschikbaar en iedereen is zich goed bewust van zijn problemen: talloze containers veroorzaken vastlopers en andere problemen. Daarom is het ook belangrijk om Docker als systeem te controleren, althans op beschikbaarheid.
DNS. Als de DNS in het cluster uitvalt, dan valt ook de hele service Discovery uit, en kunnen pods niet meer met elkaar communiceren. In mijn ervaring heb ik dergelijke problemen niet gehad, maar dat betekent niet dat we de toestand van DNS niet in de gaten moeten houden. Vertragingen in verzoeken en enkele andere statistieken kunnen worden gevolgd op CoreDNS.
Ingress. We moeten de beschikbaarheid van ingresses (inclusief Ingress Controller) als toegangspunten tot het project controleren.
We hebben de belangrijkste componenten van het cluster behandeld - laten we nu dieper ingaan op het abstractieniveau.
Het lijkt erop dat applicaties in pods draaien, wat betekent dat ze gecontroleerd moeten worden, maar dat is eigenlijk niet het geval. Pods zijn efemeer: vandaag draaien ze op de ene server, morgen op een andere; vandaag zijn er 10, morgen 2. Daarom worden simpelweg pods door niemand gemonitord. Binnen een microservices-architectuur is het belangrijker om de beschikbaarheid van de applicatie als geheel te controleren. In het bijzonder gaat het erom de beschikbaarheid van de service-endpoints te controleren: werkt er iets? Als de applicatie beschikbaar is, wat erachter gebeurt, hoeveel replica's er momenteel zijn - dat zijn vragen van de tweede orde. Het is niet nodig om afzonderlijke instanties te volgen.
Op het laatste niveau moet de werking van de applicatie zelf worden gecontroleerd, en moeten zakelijke metrics worden verzameld: het aantal bestellingen, het gedrag van gebruikers en dergelijke.
Prometheus
Het beste systeem voor clusterbewaking is . Ik ken geen enkele tool die kan concurreren met Prometheus op het gebied van kwaliteit en gebruiksgemak. Het is uitstekend geschikt voor flexibele infrastructuur, dus wanneer men spreekt over "Kubernetes-monitoring", heeft men meestal precies Prometheus in gedachten.
Er zijn een paar opties om met Prometheus te beginnen: met Helm kun je de gewone Prometheus of Prometheus Operator installeren.
- Gewone Prometheus. Daar is alles in orde, maar je moet ConfigMap instellen - in wezen tekstconfiguratiebestanden schrijven, zoals we vroeger deden, voor de microservices-architectuur.
- Prometheus Operator is iets complexer, iets moeilijker qua interne logica, maar het is gemakkelijker om ermee te werken: er zijn aparte objecten, abstracties worden aan het cluster toegevoegd, waardoor ze veel gemakkelijker te controleren en in te stellen zijn.
Om het product onder de knie te krijgen, raad ik aan eerst de gewone Prometheus te installeren. Je moet alles via de configuratie instellen, maar dat zal je helpen: je snapt wat wat is en hoe het moet worden ingesteld. In Prometheus Operator ga je meteen een abstractieniveau hoger, hoewel je ook de diepte in kunt gaan als je dat wilt.
Prometheus is goed geïntegreerd met Kubernetes: het kan communiceren met de API-server en interactie met hem hebben.
Prometheus is populair, waardoor het wordt ondersteund door een groot aantal applicaties en programmeertalen. Ondersteuning is nodig omdat Prometheus zijn eigen metricformaat heeft en voor het verzenden ervan is een interne bibliotheek binnen de applicatie of een kant-en-klare exporter nodig. Er zijn behoorlijk wat van zulke exporters. Een voorbeeld is de PostgreSQL Exporter: deze haalt gegevens uit PostgreSQL en converteert deze naar het Prometheus-formaat, zodat Prometheus ermee kan werken.
Architectuur van Prometheus
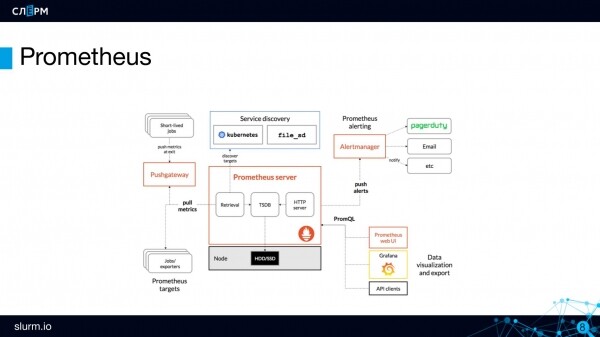
Prometheus Server is het servergedeelte, de hersenen van Prometheus. Hier worden de metrics opgeslagen en verwerkt.
Metrics worden opgeslagen in een time series database (TSDB). Een TSDB is geen aparte database, maar een pakket in de programmeertaal Go, dat is ingebouwd in Prometheus. Grofweg gezegd, alles bevindt zich in één binair bestand.
Bewaar geen gegevens lang in TSDB
De infrastructuur van Prometheus is niet geschikt voor langdurige opslag van metrics. Standaard is de bewaartermijn 15 dagen. Je kunt deze beperking overschrijden, maar het is belangrijk om te bedenken: hoe meer gegevens je in de TSDB opslaat en hoe langer je dat doet, hoe meer middelen het zal verbruiken. Het opslaan van historische gegevens in Prometheus wordt als een slechte praktijk beschouwd.
Als je een enorme hoeveelheid verkeer hebt, met metrics die zich in de honderden duizenden per seconde tellen, is het beter om de opslag ervan te beperken op basis van schijfruimte of tijd. Gewoonlijk worden in de TSDB "hete gegevens" opgeslagen, metrics die letterlijk enkele uren oud zijn. Voor langduriger opslag worden externe opslagplaatsen gebruikt in databases die daar werkelijk voor zijn bedoeld, bijvoorbeeld InfluxDB, ClickHouse, enzovoort. Ik heb meer goede recensies gezien over ClickHouse.
Prometheus Server werkt volgens een model pull: hij haalt zelf de metrics op bij de endpoints die we hem hebben doorgegeven. We zeiden: "ga naar de API Server" en hij gaat elke n-seconden daarheen en haalt de metrics op.
Voor objecten met een korte levensduur (job of cron job), die tussen scraping-periodes kunnen verschijnen, is er een component genaamd Pushgateway. Hier worden metrics gepusht van kortlopende objecten: de job is gestart, heeft een actie uitgevoerd, heeft metrics naar de Pushgateway gestuurd en is beëindigd. Na een bepaalde tijd haalt Prometheus, in zijn eigen ritme, deze metrics uit de Pushgateway.
Voor het instellen van meldingen in Prometheus is er een aparte component - Alertmanager. En de alertregels zijn alerting rules. Bijvoorbeeld, je moet een alert aanmaken als de API van servers 0 is. Wanneer het evenement wordt geactiveerd, wordt de alert doorgestuurd naar de alert manager voor verdere verzending. De alert manager heeft redelijk flexibele routeringsinstellingen: één groep alerts kan naar de Telegram-chat van de beheerders worden verzonden, een andere naar de chat van ontwikkelaars, en een derde naar de chat van infrastructuur medewerkers. Meldingen kunnen binnenkomen in Slack, Telegram, via e-mail en andere kanalen.
Tot slot zal ik de killer feature van Prometheus bespreken — Ontdekken. Bij het werken met Prometheus is het niet nodig om specifieke adressen van objecten voor monitoring op te geven, het is voldoende om hun type te definiëren. Dat wil zeggen, je hoeft niet te schrijven 'hier is het IP-adres, hier is de poort - monitor', in plaats daarvan moet je bepalen volgens welke principes deze objecten gevonden moeten worden (targets — doelen). Prometheus haalt zelfstandig, afhankelijk van welke objecten momenteel actief zijn, de benodigde objecten binnen en voegt deze toe aan de monitoring.
Deze aanpak past goed bij de structuur van Kubernetes, waar ook alles fluctueert: vandaag 10 servers, morgen 3. Om niet elke keer het IP-adres van de server op te geven, heb je het eenmaal gedefinieerd en zal Discovering dit doen.
De taal van Prometheus wordt PromQL. Met deze taal kun je specifieke metriekwaarden ophalen en deze vervolgens omzetten en analytische rapportages opstellen.
https://prometheus.io/docs/prometheus/latest/querying/basics/

Eenvoudige query

    container_memory_usage_bytes

Wiskundige bewerkingen

    container_memory_usage_bytes / 1024 / 1024

Ingebouwde functies

    sum(container_memory_usage_bytes) / 1024 / 1024

Verduidelijking van de query

    100 - avg by (instance) (rate(node_cpu_seconds_total{mode="idle"}[5m]) * 100)
Webinterface van Prometheus
Prometheus heeft een vrij minimalistische webinterface. Het is alleen geschikt voor debugging of demonstratie.
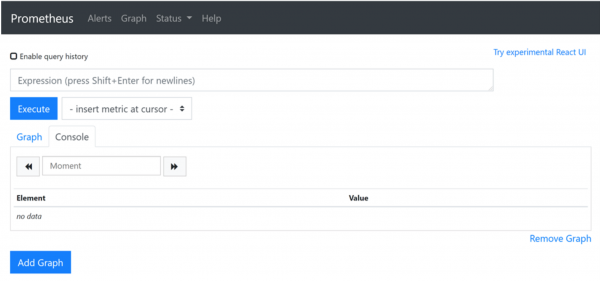
In het Expression-veld kun je een query in de taal PromQL schrijven.
In het tabblad Alerts bevinden zich de alertregels — alerting rules, en ze hebben drie statussen:
- inactive — als de alert momenteel niet actief is, dat wil zeggen dat alles goed is en hij niet is geactiveerd;
- pending — dit is het geval als de alert is geactiveerd, maar de verzending nog niet is gelukt. De vertraging wordt ingesteld om flitsen in het netwerk te compenseren: als de opgegeven service binnen een minuut weer is opgestart, is het voorlopig niet nodig om alarm te slaan;
- firing — dit is de derde status, wanneer de alert afgaat en berichten verzendt.
In het menu Status vind je toegang tot informatie over wat Prometheus precies is. Daar is ook een link naar de doelen (targets) waar we het eerder over hadden.
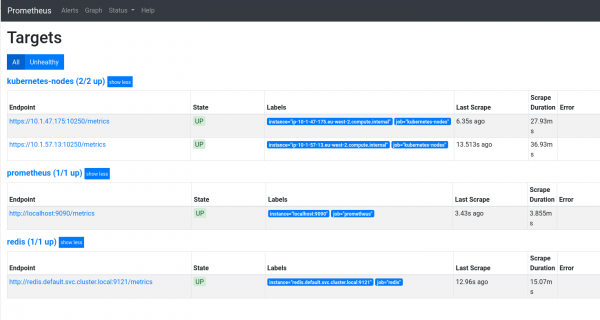
Voor een gedetailleerd overzicht van de Prometheus-interface, zie .
Integratie met Grafana
In de webinterface van Prometheus zult u geen mooie en begrijpelijke grafieken vinden om de status van het cluster te beoordelen. Om deze te maken, wordt Prometheus geïntegreerd met Grafana. Dit resulteert in dergelijke dashboards.
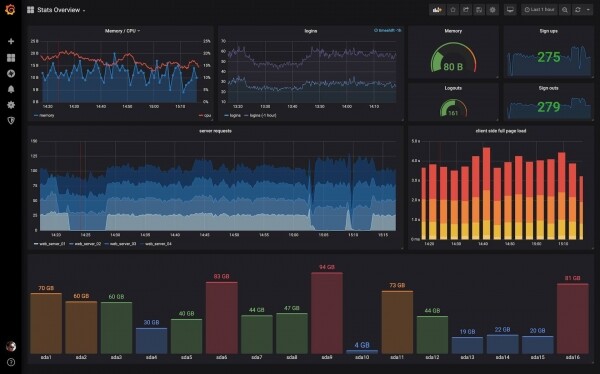
Het instellen van de integratie tussen Prometheus en Grafana is heel eenvoudig; instructies vindt u in de documentatie: , en daarmee rond ik dit af.
In de volgende artikelen zullen we het onderwerp monitoring voortzetten: we bespreken het verzamelen en analyseren van logs met behulp van Grafana Loki en alternatieve tools.
Auteur: Marcel Ibrajev, gecertificeerd Kubernetes-beheerder, praktiserend engineer bij , spreker en ontwikkelaar van cursussen Slurm.
Bron: habr.com
