

Ons bedrijf is sinds 2008 voornamelijk actief in het beheren van infrastructuren en het bieden van 24/7 technische ondersteuning voor webprojecten: we hebben meer dan 400 klanten, goed voor zo'n 15% van de e-commerce in Rusland. Dit betekent dat we te maken hebben met een zeer diverse architectuur in onze ondersteuning. Als er iets uitvalt, zijn we verplicht dit binnen 15 minuten te repareren. Maar om te begrijpen dat er een storing is opgetreden, moeten we het project monitoren en reageren op incidenten. Hoe doen we dat?
Ik geloof dat er in de organisatie van een goede monitoringsysteem iets misgaat. Als er geen problemen waren, zou mijn betoog bestaan uit één stelling: 'Installeer alstublieft Prometheus + Grafana en plugins 1, 2, 3'. Helaas werkt het nu niet zo. Het grootste probleem is dat iedereen blijft geloven in iets dat in 2008 bestond, qua softwarecomponenten.
Met betrekking tot de organisatie van een monitoringsysteem durf ik te zeggen dat ... projecten met een goede monitoring niet bestaan. En de situatie is zo slecht dat als er iets uitvalt, het risico bestaat dat dit onopgemerkt blijft - iedereen is ervan overtuigd dat 'alles gemonitord wordt'.
Misschien wordt alles gemonitord. Maar hoe?
We zijn allemaal wel eens geconfronteerd met een verhaal als het volgende: er werkt een devops of een admin, een team van ontwikkelaars komt naar hen toe en zegt: 'We hebben gelanceerd, monitor nu alsjeblieft'. Wat moet er gemonitord worden? Hoe werkt dat?
Oke. We monitoren op de traditionele manier. Maar het verandert al, en het blijkt dat je service A hebt gemonitord, die service B is geworden, die samenwerkt met service C. Maar het ontwikkelteam zegt je: 'Installeer de software, die zou alles moeten monitoren!'
Dus wat is er veranderd? - Alles is veranderd!
2008. Alles is geweldig.
Er zijn een paar ontwikkelaars, één server, één database server. Daar begint alles. We hebben wat informatie, we installeren zabbix, Nagios, cacti. En daarna stellen we begrijpelijke waarschuwingen in voor CPU, voor de schijfwerkzaamheden, voor de schijfruimte. We doen ook een paar handmatige controles om te zien of de site reageert en of de bestellingen in de database aankomen. En dat is het - we zijn min of meer veilig.
Als je de hoeveelheid werk vergelijkt die de admin toen deed voor het waarborgen van de monitoring, was 98% geautomatiseerd: iemand die zich bezighoudt met monitoring moet begrijpen hoe hij Zabbix instelt, hoe hij het configureert en alerts instelt. En 2% is voor externe controles: of de site reageert en database-aanvragen doet, of er nieuwe bestellingen binnenkomen.
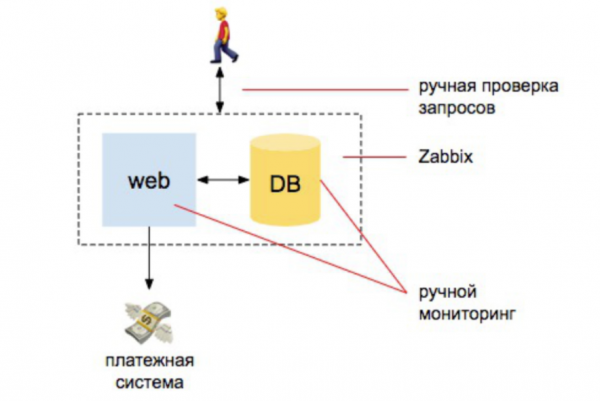
2010. De belasting neemt toe
We beginnen met het schalen van webapplicaties en voegen een zoekmachine toe. We willen er zeker van zijn dat de productcatalogus alle producten bevat. En dat de productzoekfunctie werkt. Dat de database goed functioneert, dat er bestellingen worden geplaatst, dat de site extern reageert en met twee. servers en de gebruiker niet van de site wordt gegooid, terwijl deze wordt herbalanceerd naar een andere server, enzovoort. Het aantal entiteiten neemt toe.
De entiteit die verband houdt met de infrastructuur blijft echter nog steeds de grootste in het hoofd van de manager. De gedachte dat iemand die zich bezighoudt met monitoring, de persoon is die Zabbix installeert en kan configureren, blijft bestaan.
Maar tegelijkertijd komen er taken bij voor externe controles, het maken van een set scripts voor zoekindexers, een set scripts om te controleren of de zoekfunctie verandert tijdens het indexeren, een set scripts die controleren of de bezorgdienst de producten ontvangt, enzovoort.
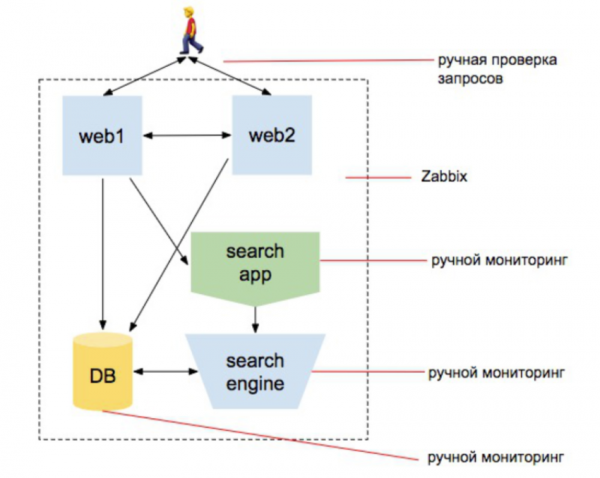
Let op: ik heb drie keer 'set scripts' geschreven. De persoon die verantwoordelijk is voor monitoring is niet langer degene die alleen Zabbix installeert. Dit is iemand die begint te coderen. Maar in de hoofden van het team verandert er tot nu toe niets.
Tegelijkertijd verandert de wereld, steeds complexer. Er wordt een laag virtualisatie toegevoegd, verschillende nieuwe systemen. Ze beginnen met elkaar te communiceren. Wie zei ‘het ruikt naar microservices?’ Maar elke service lijkt nog steeds afzonderlijk op een website. We kunnen er naartoe gaan en begrijpen wat het geeft en dat het zelfstandig werkt. En als je een admin bent die al 5-7-10 jaar aan een project werkt, dan stapelen die kennis zich op: er komt een nieuw niveau — dat besef je, er komt nog een niveau — dat besef je.
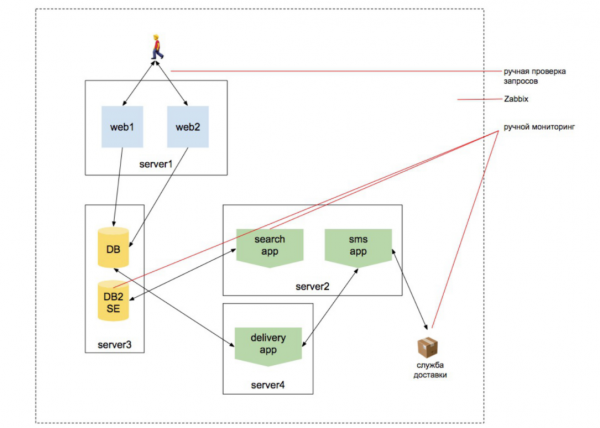
Maar zelden begeleidt iemand een project 10 jaar lang.
Samenvatting van de monitoring-man
Stel je voor dat je bij een nieuw startup komt dat meteen 20 ontwikkelaars heeft aangetrokken, 15 microservices heeft geschreven, en jij bent de admin die te horen krijgt: "Bouw CI/CD. Alsjeblieft." Je hebt CI/CD gebouwd en plotseling hoor je: "We vinden het moeilijk om met productie in de 'kubus' te werken zonder te begrijpen hoe de applicatie daar werkt. Maak ons een sandbox in dezelfde 'kubus'."
Je maakt een sandbox in deze kubus. Ze zeggen meteen: "We willen een staging-database die elke dag met productie wordt bijgewerkt, zodat we begrijpen dat het werkt op de database, maar ondertussen de productie-database niet verpesten."
Je leeft helemaal in dit alles. Er zijn nog 2 weken tot de release, en je hoort: "Nu moeten we dit allemaal monitoren..." Dus, de clusterinfrastructuur monitoren, de microservice-architectuur monitoren, het werken met externe services monitoren...
En collega's trekken zo uit hun hoofd een bekende opzet en zeggen: "Maar hier is alles duidelijk! Installeer een programma dat dit allemaal kan monitoren." Ja-ja: Prometheus + Grafana + plugins.
En ze voegen eraan toe: "Je hebt een week of twee, zorg ervoor dat alles betrouwbaar is."
In de vele projecten die we zien, wordt er één persoon aan monitoring toegewezen. Stel je voor dat we voor 2 weken iemand willen inhuren die zich met monitoring bezighoudt, en we stellen zijn cv op. Welke vaardigheden moet deze persoon hebben - rekening houdend met alles wat we eerder hebben gezegd?
- Hij moet begrijpen wat monitoring is en de specificiteit van de hardware-infrastructuur.
- Hij moet de specificiteit van Kubernetes-monitoring begrijpen (want iedereen wil in de 'kubus', omdat je je van alles kunt abstraheren, verstoppen, want de admin regelt de rest) - van de kubus zelf, zijn infrastructuur, en hij moet begrijpen hoe je applicaties binnenin monitort.
- Hij moet begrijpen dat services op verschillende manieren met elkaar communiceren, en de specifics van de interactie tussen services kennen. Het is heel haalbaar om een project te zien waar sommige services synchronisch communiceren, omdat het gewoon niet anders kan. Bijvoorbeeld, de backend gaat via REST, via gRPC naar de catalogusservice, ontvangt een lijst van producten en retourneert deze. Hier kun je niet wachten. Maar met andere services werkt hij asynchroon. Een bestelling aan de bezorgdienst doorgeven, een e-mail versturen, enz.
Je bent waarschijnlijk al duizelig van al dit? En de admin die dit moet monitoren, is nog duizeliger. - Hij moet in staat zijn om te plannen en dat op de juiste manier te doen, want het werk neemt steeds meer toe.
- Hij moet daarom een strategie creëren voor de opgezette service om te begrijpen hoe deze specifiek gemonitord kan worden. Hij moet de architectuur van het project en de ontwikkeling ervan begrijpen, evenals de technologieën die tijdens de ontwikkeling worden gebruikt.
Laten we een totaal normaal geval bekijken: een deel van de services is in PHP, een deel in Go, een deel in JS. Ze werken op een bepaalde manier samen. Hier komt de term 'microservice' vandaan: er zijn zoveel aparte systemen dat ontwikkelaars het проект als geheel niet kunnen begrijpen. Een deel van het team schrijft services in JS die zelfstandig werken en niet weten hoe de rest van het systeem functioneert. Een ander deel schrijft services in Python en mengt zich niet in hoe andere services werken; ze zijn geïsoleerd in hun eigen domein. Weer een ander deel schrijft services in PHP of iets anders.
Al deze 20 mensen zijn verdeeld over 15 services, en er is slechts één beheerder die dit alles moet begrijpen. Stop! We hebben net het systeem opgesplitst in 15 microservices omdat 20 mensen het systeem niet kunnen begrijpen.
Toch moet het op de een of andere manier worden gemonitord...
Wat is het resultaat? Er is uiteindelijk één persoon in wiens hoofd alles past wat een heel team ontwikkelaars niet kan begrijpen, en tegelijkertijd moet hij weten en kunnen wat we hierboven hebben vermeld: de hardware-infrastructuur, Kubernetes-infrastructuur, enz.
Wat valt hier te zeggen... Houston, we hebben een probleem.
Monitoring van een modern softwareproject is op zichzelf al een softwareproject.
Door de valse overtuiging dat monitoring software is, hebben we een geloof in wonderen. En die wonderen zijn er helaas niet. Je kunt Zabbix installeren en verwachten dat alles zal werken. Het heeft geen zin om Grafana te installeren en te hopen dat alles in orde zal zijn. De meeste tijd gaat verloren aan het organiseren van controles van de werking van services en hun interactie met elkaar, controles van hoe externe systemen werken. Feitelijk gaat 90% van de tijd niet naar het schrijven van scripts, maar naar de ontwikkeling van software. Dit moet gedaan worden door een team dat de werking van het project begrijpt.
Als in deze situatie één persoon wordt belast met monitoring, zal er een ramp gebeuren. En dat gebeurt overal.
Bijvoorbeeld, er zijn verschillende services die met elkaar communiceren via Kafka. Een bestelling is geplaatst, we hebben het bericht over de bestelling naar Kafka gestuurd. Er is een service die informatie over de bestelling luistert en de levering van het product verzorgt. Er is een service die informatie over de bestelling luistert en een e-mail naar de gebruiker stuurt. En dan verschijnt er nog een heleboel andere services, en beginnen we in de war te raken.
En als je dit ook nog aan de admin en ontwikkelaars geeft in de fase waarin de lancering dichtbij is, moet iemand het hele protocol begrijpen. Dat wil zeggen, een project van dit formaat kost aanzienlijk veel tijd, en dit moet in de ontwikkeling van het systeem worden meegenomen.
Maar heel vaak, vooral in startups, zien we dat monitoring wordt uitgesteld. "Laten we eerst bewijzen dat het concept werkt, we gaan ermee aan de slag, laat het maar falen - we zijn bereid om op te offeren. En daarna gaan we alles monitoren." Wanneer (of als) het project begint geld op te leveren, wil het bedrijf nog meer functies toevoegen - omdat het nu eenmaal werkt, moeten we doorgaan! En je bent dan op een punt waar je in eerste instantie alles wat eraan voorafging moet monitoren, wat niet 1% van de tijd kost, maar aanzienlijk meer. En bovendien zijn er ontwikkelaars nodig voor monitoring, terwijl het makkelijker is om ze op nieuwe functies te zetten. Uiteindelijk worden er nieuwe functies geschreven, alles wordt ingewikkelder, en je komt in een eindeloze deadlock.
Hoe kun je een project van het begin af aan monitoren, en wat te doen als je een project hebt dat gemonitord moet worden, maar je weet niet waar je moet beginnen?
Ten eerste moet je plannen.
Lyrische uitweiding: heel vaak begint men met het monitoren van de infrastructuur. Bijvoorbeeld, we hebben Kubernetes. Laten we beginnen met het installeren van Prometheus met Grafana, en de plugins voor het monitoren van de "kubus" installeren. Niet alleen bij de ontwikkelaars, maar ook bij de admins is er een betreurenswaardige praktijk: "We installeren deze plugin en de plugin weet misschien hoe het moet." Mensen houden ervan om te beginnen met eenvoudige en begrijpelijke zaken, in plaats van met belangrijke acties. En monitoring van de infrastructuur is gewoon.
Bepaal eerst wat en hoe je wilt monitoren, en kies daarna een tool, omdat andere mensen niet voor jou kunnen denken. En zouden ze dat moeten doen? Andere mensen dachten aan zichzelf, aan een universeel systeem — of dachten helemaal niet na toen ze deze plugin schreven. En het feit dat deze plugin 5000 gebruikers heeft, betekent niet dat het enige waarde biedt. Misschien word jij de 5001ste, simpelweg omdat er al 5000 mensen waren.
Als je de infrastructuur bent gaan monitoren en de backend van je applicatie stopt met werken, verliezen alle gebruikers de verbinding met de mobiele applicatie. Er komt een foutmelding. Ze komen naar je toe en zeggen: "De applicatie werkt niet, wat doen jullie hier?" — "We zijn aan het monitoren." — "Hoe monitoren jullie als je niet ziet dat de applicatie niet werkt?!"
- Ik vind dat je moet beginnen met monitoren vanuit het perspectief van de gebruiker. Als de gebruiker niet ziet dat de applicatie werkt — is dat het einde. En het monitoringssysteem moet daar als eerste op wijzen.
- Pas daarna kunnen we de infrastructuur monitoren. Of dit parallel doen. Met de infrastructuur is het eenvoudiger — hier kunnen we eindelijk gewoon Zabbix installeren.
- En nu moeten we naar de kern van de applicatie gaan om te begrijpen waar het fout gaat.
Mijn belangrijkste gedachte is dat monitoring parallel aan het ontwikkelingsproces moet plaatsvinden. Als je het monitoringteam op andere taken richt (het opzetten van CI/CD, sandboxing, herstructurering van de infrastructuur), zal de monitoring achterblijven en mogelijk zul je nooit meer de ontwikkeling inhalen (of je zult het vroeg of laat moeten stopzetten).
Alles op niveau
Zo zie ik de organisatie van het monitoringssysteem.
1) Toepassingsniveau:
- monitoren van de zakelijke logica van de applicatie;
- monitoren van health-metrieken van services;
- integratie monitoring.
2) Infrastructuurniveau:
- monitoren van het orkestratieniveau;
- monitoren van systeemsoftware;
- monitoren van het hardware niveau.
3) Weer het toepassingsniveau — maar nu als engineeringsproduct:
- verzamelen en observeren van applicatielogs;
- APM;
- tracing.
4) Alerting:
- organisatie van het alarmsysteem;
- organisatie van het dienstensysteem;
- organisatie van een 'kennisbank' en workflow voor incidentbehandeling.
Belangrijk: we gaan niet pas na de alerting, maar meteen aan de slag! Start de monitoring niet en bedenk niet ‘later’ wie de alerts ontvangt. Immers, wat is de taak van monitoring: begrijpen waar in het systeem iets niet goed werkt en dit aan de juiste mensen laten weten. Als je dit tot het einde wacht, zullen de juiste mensen er alleen achter komen dat er iets mis is als ze gebeld worden met ‘niets werkt’.
Applicatieniveau – monitoring van de businesslogica
Hier gaat het om het controleren van het feit dat de applicatie voor de gebruiker werkt.
Dit niveau moet worden opgezet tijdens de ontwikkeling. Bijvoorbeeld, we hebben een hypothetische Prometheus: het verbindt met de server die de controles uitvoert, vraagt een endpoint op en de endpoint controleert vervolgens de API.
Wanneer er vaak gevraagd wordt om de homepage te monitoren om te bevestigen dat de site werkt, geven programmeurs een handmatige endpoint die ze elke keer kunnen aanroepen als ze willen controleren of de API werkt. En de programmeurs schrijven tegelijkertijd /api/test/helloworld.
Is dat de enige manier om er zeker van te zijn dat alles werkt? – Nee!
- Het creëren van dergelijke controles is in essentie de taak van de ontwikkelaars. Unit-tests moeten worden geschreven door programmeurs die de code schrijven. Want als je dit aan de beheerder doorgeeft ‘Hé, hier is een lijst met API-protocollen voor alle 25 functies, monitor alles!’ – wordt het niets.
- Als je een print ‘hello world’ maakt, zal niemand ooit weten dat de API moet en daadwerkelijk werkt. Elke wijziging in de API moet een wijziging in de controles met zich meebrengen.
- Als je al zo’n probleem hebt – stop met de functies en wijs ontwikkelaars aan die deze controles kunnen schrijven, of maak je verlies en accepteer dat er niets wordt gecontroleerd en er problemen zullen optreden.
Technische tips:
- Zorg ervoor dat je een externe server organiseert voor het uitvoeren van controles – je moet er zeker van zijn dat je project toegankelijk is voor de externe wereld.
- Organiseer een controle over het gehele API-protocol, en niet alleen over afzonderlijke endpoints.
- Creëer een prometheus-endpoint met de resultaten van de controles.
Applicatieniveau – monitoring van health-metrics
Nu gaat het om externe health-metrics van diensten.
We hebben besloten dat we alle 'handvatten' van de applicatie monitoren met behulp van externe controles, die we vanuit een extern monitoringsysteem aanroepen. Maar dit zijn precies de 'handvatten' die de gebruiker 'ziet'. We willen er echter zeker van zijn dat onze services functioneren. Hier is het verhaal beter: in K8s zijn er health checks, zodat tenminste de 'kubus' kan bevestigen dat de service werkt. Maar de helft van de checks die ik heb gezien, is hetzelfde als print 'hello world'. Dat wil zeggen, het doet een oproep nadat het is gedeployed, en als het bevestigt dat alles goed is – dat is het. Maar voor een service die via REST zijn API aanbiedt, zijn er een enorme hoeveelheid ingangen van diezelfde API, die ook gemonitord moeten worden, omdat we willen weten dat hij werkt. En dat monitoren we al intern.
Hoe we dit technisch goed kunnen implementeren: elke service exposeert een endpoint van zijn huidige beschikbaarheid, en in Grafana (of een andere applicatie) zien we de status van alle services.
- Elke wijziging in de API moet leiden tot een wijziging in de controles.
- Creëer nieuwe services meteen met health-metrics.
- Een beheerder kan naar de ontwikkelaars komen en vragen: 'Schrijf me een paar functies zodat ik alles begrijp en informatie over dit aan mijn monitoringsysteem kan toevoegen.' Maar de ontwikkelaars antwoorden meestal: 'Twee weken voor de release gaan we niets meer toevoegen.'
Laat de ontwikkelingsmanagers weten dat er dergelijke verliezen zullen zijn, laat ook het management van de ontwikkelingsmanagers dit weten. Want als alles instort, zal er iemand bellen en vragen om de 'constant-instortende service' (c) te monitoren. - Trouwens, zet ontwikkelaars aan het schrijven van plugins voor Grafana - dat zal een goede ondersteuning zijn voor de beheerders.
Applicatieniveau - Integratieve monitoring
Integratieve monitoring richt zich op het monitoren van de communicatie tussen kritische bedrijfssystemen.
Bijvoorbeeld, er zijn 15 services die met elkaar communiceren. Dit zijn geen afzonderlijke websites meer. Dat wil zeggen, we kunnen de service niet op zichzelf aanroepen, '/helloworld' krijgen en begrijpen dat de service werkt. Omdat de webservice voor het plaatsen van een bestelling informatie over de bestelling naar de bus moet sturen - van de bus moet de magazijnservice dit bericht ontvangen en er verder mee werken. En de e-mail-verzendservice moet dit verder verwerken, enz.
Daarom kunnen we niet begrijpen door elk afzonderlijk service te testen hoe alles werkt. Want we hebben een soort bus waarlangs alles communiceert en interacteert.
Deze stap zou dus moeten dienen als de fase voor het testen van services in hun interactie met andere services. Je kunt niet door alleen een berichtenbroker te monitoren de communicatie monitoren. Als er een service is die gegevens levert en een andere service die deze ontvangt, zullen we bij het monitoren van de broker alleen de gegevens zien die heen en weer vliegen. Zelfs als we op de een of andere manier het gedrag van deze gegevens binnenin konden monitoren — dat een bepaalde producent gegevens publiceert, en iemand anders ze leest, en dat deze stroom doorgaat in Kafka — zal dat ons nog steeds niet vertellen of één service een bericht in een bepaalde versie heeft verzonden, terwijl een andere service deze versie niet verwachtte en het heeft gemist. We zullen hier niets van weten, omdat de services ons zullen zeggen dat alles werkt.
Zo raad ik aan te werk te gaan:
- Voor synchrone communicatie: de endpoint voert verzoeken uit naar de gerelateerde services. Dus we nemen deze endpoint, trekken een scriptje binnen de service dat langs alle punten gaat en zegt: "ik kan daar iets doen, en daar iets doen, en ik kan daar iets doen…"
- Voor asynchrone communicatie: bij binnenkomende berichten — de endpoint controleert de bus op testberichten en geeft de verwerkingsstatus weer.
- Voor asynchrone communicatie: bij uitgaande berichten — de endpoint verzendt testberichten naar de bus.
Zoals gebruikelijk: we hebben een service die gegevens in de bus plaatst. We komen bij deze service en vragen hem om te vertellen over zijn integratiegezondheid. En als de service een bepaald bericht verder moet produceren (WebApp), dan produceert hij dit testbericht. Maar als we een service aanroepen aan de kant van OrderProcessing, zal hij eerst publiceren wat hij onafhankelijk kan publiceren, en als er afhankelijke dingen zijn — dan leest hij een set testberichten van de bus, begrijpt hij dat hij deze kan verwerken, meldt hij dit en, indien nodig, publiceert hij ze verder, en hierover meldt hij — alles is in orde, ik ben nog alive.
Heel vaak horen we de vraag: "hoe kunnen we dit testen met live data?" Bijvoorbeeld, het gaat om dezelfde bestellingservice. Een bestelling stuurt berichten naar het magazijn, waar producten worden afgeschreven: we kunnen dit niet testen met live data, want "mijn producten worden afgeschreven!" De oplossing: plan deze test in de beginfase. Je hebt unit tests die mocks maken. Dus maak dit op een dieper niveau, waar je communicatielijn loopt die de werking van het bedrijf niet schaadt.
Infrastructuurniveau
Monitoring van de infrastructuur wordt al lang gezien als de essentie van monitoring.
- Monitoring van de infrastructuur kan en moet als een apart proces worden gestart.
- Begin niet met het monitoren van de infrastructuur op een lopend project, ook al heb je daar heel veel zin in. Dit is een probleem voor alle devops. "Eerst ga ik de cluster monitoren, dan monitor ik de infrastructuur" – dat wil zeggen, hij zal eerst monitoren wat onder ligt, en niet in de applicatie duiken. Omdat de applicatie onduidelijk is voor de devops. Hij heeft het gekregen, en begrijpt niet hoe het werkt. Maar hij begrijpt de infrastructuur en begint daarmee. Maar nee – je moet altijd eerst de applicatie monitoren.
- Overdrijf niet met het aantal waarschuwingen. Gezien de complexiteit van moderne systemen, komen de waarschuwingen constant binnen, en je moet met deze stortvloed van waarschuwingen zien te leven. En iemand die on-call is, kijkt naar een honderdtal nieuwe waarschuwingen en denkt: "ik wil hier niet over nadenken". Waarschuwingen moeten alleen kritische zaken signaleren.
Applicatieniveau als zakelijke eenheid
Belangrijke punten:
- ELK. Dit is de industriële standaard. Als je om welke reden dan ook geen logs aggregeert, begin daar dan onmiddellijk mee.
- APM. Externe APM als manier om snel de monitoring van de applicatie te dekken (NewRelic, BlackFire, Datadog). Je kunt dit tijdelijk implementeren om tenminste te begrijpen wat er met je gebeurt.
- Tracing. In tientallen microservices moet je alles traceren, omdat een verzoek niet meer op zichzelf staat. Het later toevoegen is heel moeilijk, dus het is beter om tracing al in de ontwikkeling te plannen – dit is werk en een hulpmiddel voor ontwikkelaars. Als je het nog niet hebt geïmplementeerd – ga het implementeren! Zie Jaeger/Zipkin.
Alerting
- Het organiseren van een waarschuwingensysteem: in de omstandigheden van het monitoren van veel zaken moet er een uniform systeem voor het verzenden van waarschuwingen zijn. Dit kan in Grafana. In het westen gebruikt iedereen PagerDuty. Waarschuwingen moeten duidelijk zijn (bijvoorbeeld, waar ze vandaan komen…). En het is wenselijk om te controleren of de waarschuwingen überhaupt aankomen.
- Het organiseren van een dienstensysteem: waarschuwingen moeten niet naar iedereen komen (anders zal iedereen in een groep reageren of zal niemand reageren). De on-call moet ook bij ontwikkelaars zijn: bepaal duidelijk verantwoordelijkheidszones, maak een duidelijke instructie en schrijf daarin op wie je op maandag en woensdag precies moet bellen en wie op dinsdag en vrijdag (anders zullen ze zelfs in het geval van een grote ramp niemand bellen — ze vrezen het te storen: mensen houden er over het algemeen niet van om anderen te bellen en wakker te maken, vooral 's nachts). En leg uit dat vragen om hulp geen teken van incompetentie is ("ik vraag om hulp — dus ik ben een slechte werknemer"), moedig verzoeken om hulp aan.
- Het organiseren van een 'kennisbasis' en workflow voor het behandelen van incidenten: voor elk serieus incident moet er een post-mortem worden gepland, als tijdelijke maatregel moeten de acties die het incident oplossen worden vastgelegd. En zorg ervoor dat er een praktijk is waarin herhaalde waarschuwingen als een zonde worden beschouwd; ze moeten worden verholpen in de code of in infrastructurele werkzaamheden.
Technologische stack
Laten we aannemen dat onze stack als volgt is:
- gegevensverzameling — Prometheus + Grafana;
- loganalyse — ELK;
- voor APM of Tracing — Jaeger (Zipkin).

De keuze van opties is niet kritisch. Want als je in het begin hebt begrepen hoe je het systeem moet monitoren en je een plan hebt geschreven, begin je vervolgens de gereedschappen te kiezen op basis van jouw vereisten. De vraag is wat je in het begin hebt gekozen om te monitoren. Want mogelijk past het gereedschap dat je in het begin hebt gekozen helemaal niet bij jouw vereisten.
Een paar technische punten die ik de laatste tijd overal zie:
Prometheus wordt binnen Kubernetes gepropt — wie heeft dit bedacht?! Als je cluster uitvalt, wat ga je dan doen? Als je een complexe cluster van binnen hebt, moet er een of andere monitoringsysteem binnen de cluster werken, en een andere — van buitenaf, die gegevens uit de cluster verzamelt.
Binnen de cluster verzamelen we logs en alles wat erbij komt. Maar het monitoringssysteem moet van buitenaf zijn. Heel vaak in een cluster waar Prometheus is geïnstalleerd, staan er ook systemen die externe controles van de website uitvoeren. En als uw verbindingen met de buitenwereld zijn weggevallen en de applicatie werkt niet? Dat betekent dat alles binnenin goed is, maar dat het voor de gebruikers niet gemakkelijker is.
Conclusies
- De ontwikkeling van monitoring is niet het installeren van tools, maar de ontwikkeling van een softwareproduct. 98% van de huidige monitoring is codering. Codering in services, codering van externe controles, controles van externe services, en nog veel meer.
- Bespaar geen tijd van ontwikkelaars op monitoring: dit kan tot 30% van hun werk in beslag nemen, maar het is het waard.
- DevOps, maak je geen zorgen als je iets niet kunt monitoren, want sommige dingen vereisen een geheel andere denkwijze. Je was geen programmeur, en het werk van monitoring is precies hun taak.
- Als het project al draait en niet is gemonitord (en jij bent de manager) – wijs dan middelen toe aan monitoring.
- Als het product al in productie is en jij bent de DevOps die is gevraagd om "monitoring in te stellen" – probeer dan aan de leiding uit te leggen waar ik het allemaal over heb.
Dit is een uitgebreide versie van de presentatie op de conferentie Saint Highload++.
Als je geïnteresseerd bent in mijn ideeën en gedachten over IT en gerelateerde onderwerpen, dan kun je hier 🙂
Bron: habr.com
