

Ingenieur is in het Latijn geïnspireerd.
Een ingenieur kan alles. (c) R.Diesel.
Epigrafen.
Of het verhaal over waarom een database-administrator zijn programmeerachtergrond moet herinneren.
Voorwoord
Alle namen zijn gewijzigd. Toevalligheden zijn willekeurig. Het materiaal is uitsluitend de persoonlijke mening van de auteur.
Disclaimer van garanties: in de geplande serie artikelen zal er geen gedetailleerde en nauwkeurige beschrijving zijn van de gebruikte tabellen en scripts. Materialen kunnen niet meteen 'AS IS' worden gebruikt.
Ten eerste vanwege de grote hoeveelheid materiaal,
ten tweede vanwege de specificiteit in de productieomgeving van de echte klant.
Daarom zullen de artikelen alleen ideeën en beschrijvingen in de meest algemene zin bevatten.
Misschien groeit het systeem in de toekomst uit tot een niveau waarop het op GitHub kan worden geplaatst, en misschien ook niet. De tijd zal dat leren.
Begin van het verhaal - "».
Wat er als resultaat is ontstaan, in de meest algemene lijnen - "»
Waarom is dit allemaal voor mij?
Nou, ten eerste om zelf niets te vergeten, als ik met pensioen ben en terugdenk aan die glorieuze dagen.
Ten tweede om het geschrevene te systematiseren. Want soms begin ik zelf in de war te raken en vergeet ik bepaalde delen.
En het belangrijkste - wie weet, misschien kan het iemand helpen en ervoor zorgen dat ze niet de fiets opnieuw uitvinden en niet op dezelfde rake botsten. Met andere woorden, om hun karma (niet habr's) te verbeteren. Want het waardevolste in deze wereld zijn ideeën. Het belangrijkste is om een idee te vinden. En het idee in werkelijkheid omzetten is al een puur technische kwestie.
Laten we dus langzaam beginnen…
Probleemstelling.
Er is:
PostgreSQL-database (10.5), gemengde belasting (OLTP+DSS), gemiddelde-lage belasting, gelegen in de AWS-cloud.
Database-monitoring ontbreekt, infrastructuurmonitoring wordt geleverd via de standaardmiddelen van AWS in minimale configuratie.
Benodigd:
De prestaties en de toestand van de database monitoren, en de initiële informatie voor het optimaliseren van zware databasequery's vinden en hebben.
Korte inleiding of analyse van oplossingsvarianten
Laten we beginnen met het onderzoeken van de oplossingsvarianten vanuit het perspectief van een vergelijkende analyse van de voordelen en nadelen voor de ingenieur, terwijl het management zich maar moet bezighouden met de voordelen en kosten zoals het hoort volgens het personeelsregister.
Variant 1 - "Werken op aanvraag"
We leave everything as it is. If the client is not satisfied with something in the performance of the database or application, they will notify the DBA engineers by email or by creating an incident in the ticketing system.
The engineer, upon receiving the notification, will investigate the problem, propose a solution, or postpone the issue, hoping that it resolves itself, and anyway, it will soon be forgotten.
Cookies and donuts, bruises and bumpsCookies and donuts:
1. Nothing extra needs to be done
2. There is always a possibility to excuse oneself and slack off.
3. A lot of time can be spent at one's own discretion.
Bruises and bumps:
1. Sooner or later, the client will ponder the essence of existence and universal justice in this world, and once again, they will ask themselves the question — why am I paying them my money? The outcome is always the same — the only question is when the client will get bored and wave goodbye. And the feeder will empty. It's sad.
2. The engineer's development is zero.
3. Difficulties in planning work and loading
Option 2 - "We dance with tambourines, pushing and shoeing"
Point 1-Why do we need a monitoring system? We will get everything through requests. We launch a bunch of various requests to the data dictionary and dynamic views, enable various counters, compile everything into tables, periodically, sort of, analyze the lists and tables. As a result, we have beautiful or not so beautiful graphics, tables, reports. The main thing is to have more, more.
Point 2-We generate activity - we start analyzing all of this.
Point 3-We prepare some document, simply calling this document - "how to organize our database."
Point 4-The client, seeing all this magnificence of graphs and numbers, remains in a childlike naive confidence - now everything will work, soon. And easily and painlessly, they part with their financial resources. Management is also confident - our engineers are doing great. Load is at maximum.
Point 5-Regularly repeat Point 1.
Cookies and donuts, bruises and bumpsCookies and donuts:
1. The life of managers and engineers is simple, predictable, and filled with activity. Everything is buzzing, everyone is busy.
2. The client's life is also not bad - they are always sure that they just need to be a little more patient and everything will be fine. It doesn’t get better, well, what can you do - this world is unfair, next life - luckier.
Bruises and bumps:
1. Op een gegeven moment zal er wel een snellere aanbieder van een vergelijkbare dienst komen die hetzelfde doet, maar iets goedkoper is. En als het resultaat hetzelfde is, waarom meer betalen? Dit zal opnieuw leiden tot het verdwijnen van de geldstroom.
2. Dit is saai. Zoals elke weinig zinnige activiteit.
3. Zoals in de vorige variant — er is geen ontwikkeling. Maar voor de engineer is het minpunt dat, in tegenstelling tot de eerste variant, hier constant een database moet worden gegenereerd. En dat kost tijd. Tijd die je beter aan jezelf kunt besteden. Want als je niet voor jezelf zorgt, doet niemand het.
Variant 3 - Je hoeft het wiel niet opnieuw uit te vinden, je moet het kopen en gaan fietsen.
Ingenieurs van andere bedrijven eten niet voor niets pizza met bier (oh, de glorieuze tijden in Sint-Petersburg in de jaren '90). Laten we gebruikmaken van monitoring systemen die zijn gemaakt, verfijnd en werken, en die, laten we wel wezen, eigenlijk nuttig zijn (tenzij voor hun makers).
Cookies and donuts, bruises and bumpsCookies and donuts:
1. Je hoeft geen tijd te besteden aan het verzinnen van wat al is uitgevonden. Neem het en gebruik het.
2. Monitoring systemen worden niet door domme mensen geschreven en ze zijn natuurlijk nuttig.
3. Werkende monitoring systemen bieden doorgaans nuttige gefilterde informatie.
Bruises and bumps:
1. De engineer is in dit geval geen engineer, maar gewoon een gebruiker van iemands product. Of een gebruiker.
2. De opdrachtgever moet worden overtuigd van de noodzaak om iets te kopen waar hij eigenlijk niet in geïnteresseerd is, en dat moet hij ook niet zijn. Bovendien is het budget voor het jaar goedgekeurd en zal dit niet veranderen. Daarna moet er een aparte bron worden toegewezen, afgestemd op het specifieke systeem. Dus eerst moet je betalen, betalen en nog eens betalen. En de opdrachtgever is gierig. Dit is de norm van het leven.
Wat te doen - Tsjernysjovski? Jouw vraag is zeer relevant. (c)
In dit specifieke geval en de huidige situatie kunnen we het iets anders aanpakken — laten we ons eigen monitoring systeem maken.
Nou, niet echt een systeem in de volle zin van het woord, dat is een te talige en zelfingenomen uitspraak, maar laten we proberen het onszelf iets gemakkelijker te maken en meer informatie te verzamelen voor het oplossen van prestatie-incidenten. Zodat we niet in de situatie komen — “ga daarheen, weet niet waar, vind dat, weet niet wat”.
Wat zijn de voordelen en nadelen van deze optie:
Voordelen:
1. Dit is interessant. In ieder geval interessanter dan constante ‘shrink datafile, alter tablespace, etc.’
2. Dit zijn nieuwe vaardigheden en een nieuwe ontwikkeling. Wat op de lange termijn vroeg of laat de verdiende beloningen en lekkernijen zal opleveren.
Nadelen:
1. We moeten aan de bak. Veel werken.
2. We moeten regelmatig de betekenis en de vooruitzichten van alle activiteiten uitleggen.
3. We moeten ergens voor opofferen, omdat de enige beschikbare bron voor een ingenieur — tijd — beperkt is door het universum.
4. Het ergste en het meest onaangename — kan resulteren in iets als 'Geen muis, geen kikker, maar een onbekend beestje'.
Wie niet waagt, die niet wint.
Dus — het interessantste begint nu.
Het algemene idee — schematisch.
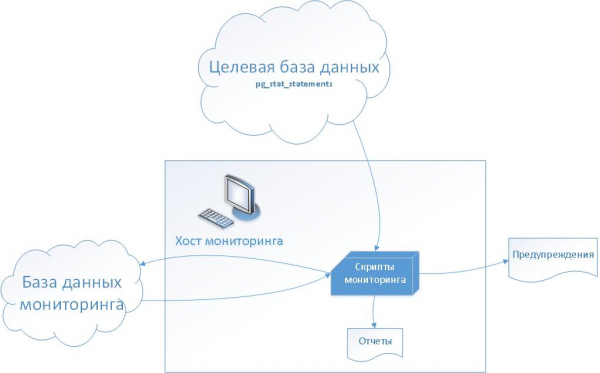
(De illustratie is afkomstig uit een artikel. «»)
Uitleg:
- In de doeldatabase wordt de standaarduitbreiding PostgreSQL — “pg_stat_statements” — geïnstalleerd.
- In de monitoringdatabase creëren we een set service-tabellen voor het opslaan van de geschiedenis van pg_stat_statements in de beginfase en voor het instellen van metrics en monitoring in de toekomst.
- Op de monitoringhost creëren we een set bash-scripts, waaronder voor het genereren van incidenten in het ticketingssysteem.
Service-tabellen
Voorlopig een schematisch vereenvoudigd ERD, wat hebben we uiteindelijk gekregen:
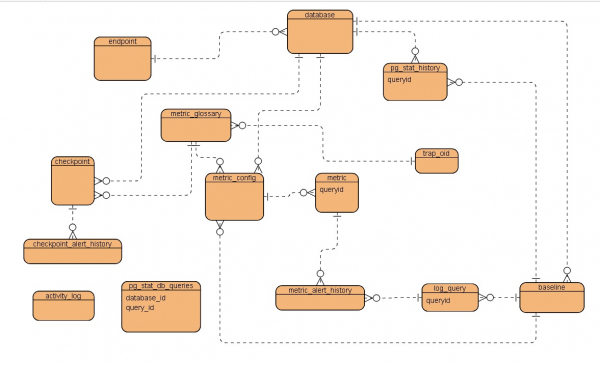
Korte beschrijving van de tabellenom verschillende typen datastromen binnen één apparaat te scheiden. — host, verbindingspunt voor de instantie
database — databaseparameters
pg_stat_history — historische tabel voor het opslaan van tijdsnapshotweergaves van pg_stat_statements van de doel-database
metric_glossary — woordenboek van prestatiemetrics
metric_config — configuratie van afzonderlijke metrics
metric — specifieke metric voor de verzoeken die gemonitord worden
metric_alert_history — geschiedenis van prestatiealerts
log_query — hulptable voor het opslaan van ontlede records uit de logbestanden van PostgreSQL die worden gedownload van AWS
baseline — parameters van de tijdsperiode die als basis wordt gebruikt
checkpoint — configuratie van metrics voor database-statuscontroles
checkpoint_alert_history — geschiedenis van alerts voor metrics van database-statuscontroles
pg_stat_db_queries — hulptable voor actieve verzoeken
activity_log — hulptable voor het logboek van activiteit
trap_oid — hulptable voor trapconfiguratie
Stap 1 — we verzamelen statistische informatie over prestaties en genereren rapporten.
De tabel wordt gebruikt voor het opslaan van statistische informatie. pg_stat_history
Structuur van de tabel pg_stat_history
                                          Tabel "public.pg_stat_history"
       Kolom         |            Type             |                          Wijzigingen
---------------------+-----------------------------+-------------------------------------------
 id                  | integer                     | niet null standaard nextval('pg_stat_history_id_seq'::regclass)
 snapshot_timestamp  | timestamp zonder tijdzone |
 database_id         | integer                     |
 dbid                | oid                         |
 userid              | oid                         |
 queryid             | bigint                      |
 query               | tekst                       |
 calls               | bigint                      |
 total_time          | dubbele precisie            |
 min_time            | dubbele precisie            |
 max_time            | dubbele precisie            |
 mean_time           | dubbele precisie            |
 stddev_time         | dubbele precisie            |
 rows                | bigint                      |
 shared_blks_hit     | bigint                      |
 shared_blks_read    | bigint                      |
 shared_blks_dirtied | bigint                      |
 shared_blks_written | bigint                      |
 local_blks_hit      | bigint                      |
 local_blks_read     | bigint                      |
 local_blks_dirtied  | bigint                      |
 local_blks_written  | bigint                      |
 temp_blks_read      | bigint                      |
 temp_blks_written   | bigint                      |
 blk_read_time       | dubbele precisie            |
 blk_write_time      | dubbele precisie            |
 baseline_id         | integer                     |
Indexes:
    "pg_stat_history_pkey" PRIMARY KEY, btree (id)
    "database_idx" btree (database_id)
    "queryid_idx" btree (queryid)
    "snapshot_timestamp_idx" btree (snapshot_timestamp)
Foreign-key constraints:
    "database_id_fk" FOREIGN KEY (database_id) REFERENCES database(id) ON DELETE CASCADE
Zoals blijkt, vertegenwoordigt de tabel slechts cumulatieve gegevens van de weergave pg_stat_statements in de doeldatabase.
Het gebruik van deze tabel is heel eenvoudig
pg_stat_history het zal de verzamelde statistieken van query-uitvoeringen per uur weergeven. Aan het begin van elk uur, na het vullen van de tabel, worden de statistieken pg_stat_statements gereset met behulp van pg_stat_statements_reset().
Opmerking: statistieken worden verzameld voor queries met een uitvoeringstijd van meer dan 1 seconde.
Vullen van de tabel pg_stat_history
--pg_stat_history.sql
CREATE OR REPLACE FUNCTION pg_stat_history( ) RETURNS boolean AS $$
DECLARE
  endpoint_rec record ;
  database_rec record ;
  pg_stat_snapshot record ;
  current_snapshot_timestamp timestamp without time zone;
BEGIN
  current_snapshot_timestamp = date_trunc('minute',now());

  FOR endpoint_rec IN SELECT * FROM endpoint
  LOOP
    FOR database_rec IN SELECT * FROM database WHERE endpoint_id = endpoint_rec.id
	  LOOP

		RAISE NOTICE 'ER WORDT EEN NIEUWE MOMENTOPNAME AANGEMAAKT';

		--Verbind met de doeldatabase
	    EXECUTE 'SELECT dblink_connect(''LINK1'',''host='||endpoint_rec.host||' dbname='||database_rec.name||' user=USER password=PASSWORD '')';

        RAISE NOTICE 'host % en dbname % ',endpoint_rec.host,database_rec.name;
		RAISE NOTICE 'Een momentopname van pg_stat_statements voor database % wordt aangemaakt',database_rec.name;

		SELECT
	      *
		INTO
		  pg_stat_snapshot
	    FROM dblink('LINK1',
	      'SELECT
	       dbid , SUM(calls),SUM(total_time),SUM(rows) ,SUM(shared_blks_hit) ,SUM(shared_blks_read) ,SUM(shared_blks_dirtied) ,SUM(shared_blks_written) ,
           SUM(local_blks_hit) , SUM(local_blks_read) , SUM(local_blks_dirtied) , SUM(local_blks_written) , SUM(temp_blks_read) , SUM(temp_blks_written) , SUM(blk_read_time) , SUM(blk_write_time)
	       FROM pg_stat_statements WHERE dbid=(SELECT oid from pg_database where datname=current_database() )
		   GROUP BY dbid
  	      '
	               )
	      AS t
	       ( dbid oid , calls bigint ,
  	         total_time double precision ,
	         rows bigint , shared_blks_hit bigint , shared_blks_read bigint ,shared_blks_dirtied bigint ,shared_blks_written	 bigint ,
             local_blks_hit	 bigint ,local_blks_read bigint , local_blks_dirtied bigint ,local_blks_written bigint ,
             temp_blks_read	 bigint ,temp_blks_written bigint ,
             blk_read_time double precision , blk_write_time double precision
	       );

		INSERT INTO pg_stat_history
          (
		    snapshot_timestamp  ,database_id  ,
			dbid , calls  ,total_time ,
            rows ,shared_blks_hit  ,shared_blks_read  ,shared_blks_dirtied  ,shared_blks_written ,local_blks_hit ,
            local_blks_read,local_blks_dirtied,local_blks_written,temp_blks_read,temp_blks_written,
            blk_read_time, blk_write_time
		  )
	    VALUES
	      (
	       current_snapshot_timestamp ,
		   database_rec.id ,
	       pg_stat_snapshot.dbid ,pg_stat_snapshot.calls,
	       pg_stat_snapshot.total_time,
	       pg_stat_snapshot.rows ,pg_stat_snapshot.shared_blks_hit ,pg_stat_snapshot.shared_blks_read ,pg_stat_snapshot.shared_blks_dirtied ,pg_stat_snapshot.shared_blks_written ,
           pg_stat_snapshot.local_blks_hit , pg_stat_snapshot.local_blks_read , pg_stat_snapshot.local_blks_dirtied , pg_stat_snapshot.local_blks_written ,
	       pg_stat_snapshot.temp_blks_read , pg_stat_snapshot.temp_blks_written , pg_stat_snapshot.blk_read_time , pg_stat_snapshot.blk_write_time
	      );

        RAISE NOTICE 'Een momentopname van pg_stat_statements voor vragen met min_time meer dan 1000ms wordt aangemaakt';

        FOR pg_stat_snapshot IN
          --Alle vragen met max_time groter dan 1000 ms
	      SELECT
	        *
	      FROM dblink('LINK1',
	        'SELECT
	         dbid , userid ,queryid,query,calls,total_time,min_time ,max_time,mean_time, stddev_time ,rows ,shared_blks_hit ,
			 shared_blks_read ,shared_blks_dirtied ,shared_blks_written ,
             local_blks_hit , local_blks_read , local_blks_dirtied ,
			 local_blks_written , temp_blks_read , temp_blks_written , blk_read_time ,
			 blk_write_time
	         FROM pg_stat_statements
			 WHERE dbid=(SELECT oid from pg_database where datname=current_database() AND min_time >= 1000 )
  	        '

	                  )
	        AS t
	         ( dbid oid , userid oid , queryid bigint ,query text , calls bigint ,
  	           total_time double precision ,min_time double precision	 ,max_time double precision	 , mean_time double precision	 ,  stddev_time double precision	 ,
	           rows bigint , shared_blks_hit bigint , shared_blks_read bigint ,shared_blks_dirtied bigint ,shared_blks_written	 bigint ,
               local_blks_hit	 bigint ,local_blks_read bigint , local_blks_dirtied bigint ,local_blks_written bigint ,
               temp_blks_read	 bigint ,temp_blks_written bigint ,
               blk_read_time double precision , blk_write_time double precision
	         )
	    LOOP
		  INSERT INTO pg_stat_history
          (
		    snapshot_timestamp  ,database_id  ,
			dbid ,userid  , queryid  , query  , calls  ,total_time ,min_time ,max_time ,mean_time ,stddev_time ,
            rows ,shared_blks_hit  ,shared_blks_read  ,shared_blks_dirtied  ,shared_blks_written ,local_blks_hit ,
            local_blks_read,local_blks_dirtied,local_blks_written,temp_blks_read,temp_blks_written,
            blk_read_time, blk_write_time
		  )
	      VALUES
	      (
	       current_snapshot_timestamp ,
		   database_rec.id ,
	       pg_stat_snapshot.dbid ,pg_stat_snapshot.userid ,pg_stat_snapshot.queryid,pg_stat_snapshot.query,pg_stat_snapshot.calls,
	       pg_stat_snapshot.total_time,pg_stat_snapshot.min_time ,pg_stat_snapshot.max_time,pg_stat_snapshot.mean_time, pg_stat_snapshot.stddev_time ,
	       pg_stat_snapshot.rows ,pg_stat_snapshot.shared_blks_hit ,pg_stat_snapshot.shared_blks_read ,pg_stat_snapshot.shared_blks_dirtied ,pg_stat_snapshot.shared_blks_written ,
           pg_stat_snapshot.local_blks_hit , pg_stat_snapshot.local_blks_read , pg_stat_snapshot.local_blks_dirtied , pg_stat_snapshot.local_blks_written ,
	       pg_stat_snapshot.temp_blks_read , pg_stat_snapshot.temp_blks_written , pg_stat_snapshot.blk_read_time , pg_stat_snapshot.blk_write_time
	      );

        END LOOP;

        PERFORM dblink_disconnect('LINK1');

	  END LOOP ;--FOR database_rec IN SELECT * FROM database WHERE endpoint_id = endpoint_rec.id

  END LOOP;

RETURN TRUE;
END
$$ LANGUAGE plpgsql;
Als resultaat, na een bepaalde periode in de tabel pg_stat_history hebben we een set van inhoudsopnamen van de tabel pg_stat_statements van de doel-database.
Eigenlijk rapporteren
Met eenvoudige queries kunnen we vrij nuttige en interessante rapporten genereren.
Geaggregeerde gegevens over een bepaalde periode
Verzoek
SELECT
  database_id ,
  SUM(calls) AS calls ,SUM(total_time)  AS total_time ,
  SUM(rows) AS rows , SUM(shared_blks_hit)  AS shared_blks_hit,
  SUM(shared_blks_read) AS shared_blks_read ,
  SUM(shared_blks_dirtied) AS shared_blks_dirtied,
  SUM(shared_blks_written) AS shared_blks_written ,
  SUM(local_blks_hit) AS local_blks_hit ,
  SUM(local_blks_read) AS local_blks_read ,
  SUM(local_blks_dirtied) AS local_blks_dirtied ,
  SUM(local_blks_written)  AS local_blks_written,
  SUM(temp_blks_read) AS temp_blks_read,
  SUM(temp_blks_written) temp_blks_written ,
  SUM(blk_read_time) AS blk_read_time ,
  SUM(blk_write_time) AS blk_write_time
FROM
  pg_stat_history
WHERE
  queryid IS NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
GROUP BY database_id ;
DB Tijd
to_char(interval '1 millisecond' * pg_total_stat_history_rec.total_time, 'HH24:MI:SS.MS')
I/O Tijd
to_char(interval '1 millisecond' * ( pg_total_stat_history_rec.blk_read_time + pg_total_stat_history_rec.blk_write_time ), 'HH24:MI:SS.MS')
TOP10 SQL op total_time
Verzoek
SELECT
  queryid ,
  SUM(calls) AS calls ,
  SUM(total_time)  AS total_time
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
GROUP BY queryid
ORDER BY 3 DESC
LIMIT 10
------------------------------------------------------------------------------------- | TOP10 SQL OP TOTALE UITVOERINGSTIJD | #| queryid| calls| calls %| total_time (ms) | dbtime % +----+-----------+-----------+-----------+--------------------------------+---------- | 1| 821760255| 2| .00001|00:03:23.141( 203141.681 ms.)| 5.42 | 2| 4152624390| 2| .00001|00:03:13.929( 193929.215 ms.)| 5.17 | 3| 1484454471| 4| .00001|00:02:09.129( 129129.057 ms.)| 3.44 | 4| 655729273| 1| .00000|00:02:01.869( 121869.981 ms.)| 3.25 | 5| 2460318461| 1| .00000|00:01:33.113( 93113.835 ms.)| 2.48 | 6| 2194493487| 4| .00001|00:00:17.377( 17377.868 ms.)| .46 | 7| 1053044345| 1| .00000|00:00:06.156( 6156.352 ms.)| .16 | 8| 3644780286| 1| .00000|00:00:01.063( 1063.830 ms.)| .03
TOP10 SQL op totale I/O tijd
Verzoek
SELECT
  queryid ,
  SUM(calls) AS calls ,
  SUM(blk_read_time + blk_write_time)  AS io_time
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
GROUP BY  queryid
ORDER BY 3 DESC
LIMIT 10
---------------------------------------------------------------------------------------- | TOP10 SQL OP BASIS VAN TOTALE I/O TIJD | #| queryid| aanroepen| aanroepen %| I/O tijd (ms)|db I/O tijd % +----+-----------+-----------+-----------+--------------------------------+------------- | 1| 4152624390| 2| .00001|00:08:31.616( 511616.592 ms.)| 31.06 | 2| 821760255| 2| .00001|00:08:27.099( 507099.036 ms.)| 30.78 | 3| 655729273| 1| .00000|00:05:02.209( 302209.137 ms.)| 18.35 | 4| 2460318461| 1| .00000|00:04:05.981( 245981.117 ms.)| 14.93 | 5| 1484454471| 4| .00001|00:00:39.144( 39144.221 ms.)| 2.38 | 6| 2194493487| 4| .00001|00:00:18.182( 18182.816 ms.)| 1.10 | 7| 1053044345| 1| .00000|00:00:16.611( 16611.722 ms.)| 1.01 | 8| 3644780286| 1| .00000|00:00:00.436( 436.205 ms.)| .03
TOP10 SQL op basis van maximale uitvoeringstijd
Verzoek
SELECT
  id AS snapshotid ,
  queryid ,
  snapshot_timestamp ,
  max_time
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp TUSSEN BEGIN_TIMEPOINT EN EIND_TIMEPOINT
ORDER BY 4 DESC
LIMIT 10
----------------------------------------------------------------------------------------- | TOP10 SQL OP BASIS VAN MAXIMALE UITVOERTIJD | #| snapshot| snapshotID| queryid| max_time (ms) +----+------------------+-----------+-----------+---------------------------------------- | 1| 05.04.2019 01:03| 4169| 655729273| 00:02:01.869( 121869.981 ms.) | 2| 04.04.2019 17:00| 4153| 821760255| 00:01:41.570( 101570.841 ms.) | 3| 04.04.2019 16:00| 4146| 821760255| 00:01:41.570( 101570.841 ms.) | 4| 04.04.2019 16:00| 4144| 4152624390| 00:01:36.964( 96964.607 ms.) | 5| 04.04.2019 17:00| 4151| 4152624390| 00:01:36.964( 96964.607 ms.) | 6| 05.04.2019 10:00| 4188| 1484454471| 00:01:33.452( 93452.150 ms.) | 7| 04.04.2019 17:00| 4150| 2460318461| 00:01:33.113( 93113.835 ms.) | 8| 04.04.2019 15:00| 4140| 1484454471| 00:00:11.892( 11892.302 ms.) | 9| 04.04.2019 16:00| 4145| 1484454471| 00:00:11.892( 11892.302 ms.) | 10| 04.04.2019 17:00| 4152| 1484454471| 00:00:11.892( 11892.302 ms.)
TOP10 SQL op basis van gedeelde buffer lees/schrijf
Verzoek
SELECT
  id AS snapshotid ,
  queryid ,
  snapshot_timestamp ,
  shared_blks_read ,
  shared_blks_written
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp TUSSEN BEGIN_TIMEPOINT EN EIND_TIMEPOINT EN
  ( shared_blks_read > 0 OF shared_blks_written > 0 )
ORDER BY 4 DESC  , 5 DESC
LIMIT 10
-------------------------------------------------------------------------------------------- | TOP10 SQL VOOR GEELAATDE BUFFER LEES/SCHRIJF | #| snapshot| snapshotID| queryid| gedeelde blokken gelezen| gedeelde blokken geschreven +----+------------------+-----------+-----------+---------------------+--------------------- | 1| 04.04.2019 17:00| 4153| 821760255| 797308| 0 | 2| 04.04.2019 16:00| 4146| 821760255| 797308| 0 | 3| 05.04.2019 01:03| 4169| 655729273| 797158| 0 | 4| 04.04.2019 16:00| 4144| 4152624390| 756514| 0 | 5| 04.04.2019 17:00| 4151| 4152624390| 756514| 0 | 6| 04.04.2019 17:00| 4150| 2460318461| 734117| 0 | 7| 04.04.2019 17:00| 4155| 3644780286| 52973| 0 | 8| 05.04.2019 01:03| 4168| 1053044345| 52818| 0 | 9| 04.04.2019 15:00| 4141| 2194493487| 52813| 0 | 10| 04.04.2019 16:00| 4147| 2194493487| 52813| 0 --------------------------------------------------------------------------------------------
Histogram van de verdeling van queries op maximale uitvoeringstijd
Queries
SELECT
  MIN(max_time) AS hist_min  ,
  MAX(max_time) AS hist_max ,
  (( MAX(max_time) - MIN(min_time) ) / hist_columns ) as hist_width
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT ;

SELECT
  SUM(calls) AS calls
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id =DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT AND
  ( max_time >= hist_current_min AND  max_time < hist_current_max ) ;
|-----------------------------------------------------------------------------------------------
| MAX_TIME HISTOGRAM
| TOTALE AANTAL OPROEPEN : 33851920
| MIN TIJD  : 00:00:01.063
| MAX TIJD  : 00:02:01.869
---------------------------------------------------------------------------------
|                      min duur|                      max duur|     oproepen
+----------------------------------+----------------------------------+----------
| 00:00:01.063(      1063.830 ms.) | 00:00:13.144(     13144.445 ms.) | 9
| 00:00:13.144(     13144.445 ms.) | 00:00:25.225(     25225.060 ms.) | 0
| 00:00:25.225(     25225.060 ms.) | 00:00:37.305(     37305.675 ms.) | 0
| 00:00:37.305(     37305.675 ms.) | 00:00:49.386(     49386.290 ms.) | 0
| 00:00:49.386(     49386.290 ms.) | 00:01:01.466(     61466.906 ms.) | 0
| 00:01:01.466(     61466.906 ms.) | 00:01:13.547(     73547.521 ms.) | 0
| 00:01:13.547(     73547.521 ms.) | 00:01:25.628(     85628.136 ms.) | 0
| 00:01:25.628(     85628.136 ms.) | 00:01:37.708(     97708.751 ms.) | 4
| 00:01:37.708(     97708.751 ms.) | 00:01:49.789(    109789.366 ms.) | 2
| 00:01:49.789(    109789.366 ms.) | 00:02:01.869(    121869.981 ms.) | 0
TOP10 Snapshots per Query per Seconde
Queries
--pg_qps.sql
--Bereken Query Per Seconde
CREATE OR REPLACE FUNCTION pg_qps( pg_stat_history_id integer ) RETURNS double precision AS $$
DECLARE
 pg_stat_history_rec record ;
 prev_pg_stat_history_id integer ;
 prev_pg_stat_history_rec record;
 total_seconds double precision ;
 result double precision;
BEGIN
  result = 0 ;

  SELECT *
  INTO pg_stat_history_rec
  FROM
    pg_stat_history
  WHERE id = pg_stat_history_id ;

  IF pg_stat_history_rec.snapshot_timestamp IS NULL
  THEN
    RAISE EXCEPTION 'FOUT - pg_stat_history niet gevonden voor id = %',pg_stat_history_id;
  END IF ;

 --RAISE NOTICE 'pg_stat_history_id = % , snapshot_timestamp = %', pg_stat_history_id ,
 pg_stat_history_rec.snapshot_timestamp ;

  SELECT
    MAX(id)
  INTO
    prev_pg_stat_history_id
  FROM
    pg_stat_history
  WHERE
    database_id = pg_stat_history_rec.database_id AND
	queryid IS NULL AND
	id  0
  THEN
    result = pg_stat_history_rec.calls / total_seconds ;
  ELSE
   result = 0 ;
  END IF;

 RETURN result ;
END
$$ LANGUAGE plpgsql;


SELECT
  id ,
  snapshot_timestamp ,
  calls ,
  total_time ,
  ( select pg_qps( id )) AS QPS ,
  blk_read_time ,
  blk_write_time
FROM
  pg_stat_history
WHERE
  queryid IS NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT AND
  ( select pg_qps( id )) IS NOT NULL
ORDER BY 5 DESC
LIMIT 10
|-----------------------------------------------------------------------------------------------
| TOP10 Momentopnamen gesorteerd op QueryPerSeconds aantallen
-----------------------------------------------------------------------------------------------------------------------------------------------
|    #|          momentopname| momentopnameID|      oproepen|                      totale dbtijd|        QPS|                          I/O tijd| I/O tijd %
+-----+------------------+-----------+-----------+----------------------------------+-----------+----------------------------------+-----------
|    1|  04.04.2019 20:04|       4161|    5758631|  00:06:30.513(    390513.926 ms.)|   1573.396|  00:00:01.470(      1470.110 ms.)|       .376
|    2|  04.04.2019 17:00|       4149|    3529197|  00:11:48.830(    708830.618 ms.)|    980.332|  00:12:47.834(    767834.052 ms.)|    108.324
|    3|  04.04.2019 16:00|       4143|    3525360|  00:10:13.492(    613492.351 ms.)|    979.267|  00:08:41.396(    521396.555 ms.)|     84.988
|    4|  04.04.2019 21:03|       4163|    2781536|  00:03:06.470(    186470.979 ms.)|    785.745|  00:00:00.249(       249.865 ms.)|       .134
|    5|  04.04.2019 19:03|       4159|    2890362|  00:03:16.784(    196784.755 ms.)|    776.979|  00:00:01.441(      1441.386 ms.)|       .732
|    6|  04.04.2019 14:00|       4137|    2397326|  00:04:43.033(    283033.854 ms.)|    665.924|  00:00:00.024(        24.505 ms.)|       .009
|    7|  04.04.2019 15:00|       4139|    2394416|  00:04:51.435(    291435.010 ms.)|    665.116|  00:00:12.025(     12025.895 ms.)|      4.126
|    8|  04.04.2019 13:00|       4135|    2373043|  00:04:26.791(    266791.988 ms.)|    659.179|  00:00:00.064(        64.261 ms.)|       .024
|    9|  05.04.2019 01:03|       4167|    4387191|  00:06:51.380(    411380.293 ms.)|    609.332|  00:05:18.847(    318847.407 ms.)|     77.507
|   10|  04.04.2019 18:01|       4157|    1145596|  00:01:19.217(     79217.372 ms.)|    313.004|  00:00:01.319(      1319.676 ms.)|      1.666
Urenuitvoeringsgeschiedenis met QueryPerSeconds en I/O tijd
Verzoek
SELECT
  id ,
  snapshot_timestamp ,
  calls ,
  total_time ,
  ( select pg_qps( id )) AS QPS ,
  blk_read_time ,
  blk_write_time
FROM
  pg_stat_history
WHERE
  queryid IS NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
ORDER BY 2
|-----------------------------------------------------------------------------------------------
| UURVERSCHIL UITVOERINGSGESCHIEDENIS  MET QueryPerSeconds en I/O-tijd
-----------------------------------------------------------------------------------------------------------------------------------------------
| QUERY PER SECONDE GESCHIEDENIS
|    #|          momentopname| momentopnameID|      oproepen|                      totale dbtijd|        QPS|                          I/O-tijd| I/O tijd %
+-----+------------------+-----------+-----------+----------------------------------+-----------+----------------------------------+-----------
|    1|  04.04.2019 11:00|       4131|       3747|  00:00:00.835(       835.374 ms.)|      1.041|  00:00:00.000(          .000 ms.)|       .000
|    2|  04.04.2019 12:00|       4133|    1002722|  00:01:52.419(    112419.376 ms.)|    278.534|  00:00:00.149(       149.105 ms.)|       .133
|    3|  04.04.2019 13:00|       4135|    2373043|  00:04:26.791(    266791.988 ms.)|    659.179|  00:00:00.064(        64.261 ms.)|       .024
|    4|  04.04.2019 14:00|       4137|    2397326|  00:04:43.033(    283033.854 ms.)|    665.924|  00:00:00.024(        24.505 ms.)|       .009
|    5|  04.04.2019 15:00|       4139|    2394416|  00:04:51.435(    291435.010 ms.)|    665.116|  00:00:12.025(     12025.895 ms.)|      4.126
|    6|  04.04.2019 16:00|       4143|    3525360|  00:10:13.492(    613492.351 ms.)|    979.267|  00:08:41.396(    521396.555 ms.)|     84.988
|    7|  04.04.2019 17:00|       4149|    3529197|  00:11:48.830(    708830.618 ms.)|    980.332|  00:12:47.834(    767834.052 ms.)|    108.324
|    8|  04.04.2019 18:01|       4157|    1145596|  00:01:19.217(     79217.372 ms.)|    313.004|  00:00:01.319(      1319.676 ms.)|      1.666
|    9|  04.04.2019 19:03|       4159|    2890362|  00:03:16.784(    196784.755 ms.)|    776.979|  00:00:01.441(      1441.386 ms.)|       .732
|   10|  04.04.2019 20:04|       4161|    5758631|  00:06:30.513(    390513.926 ms.)|   1573.396|  00:00:01.470(      1470.110 ms.)|       .376
|   11|  04.04.2019 21:03|       4163|    2781536|  00:03:06.470(    186470.979 ms.)|    785.745|  00:00:00.249(       249.865 ms.)|       .134
|   12|  04.04.2019 23:03|       4165|    1443155|  00:01:34.467(     94467.539 ms.)|    200.438|  00:00:00.015(        15.287 ms.)|       .016
|   13|  05.04.2019 01:03|       4167|    4387191|  00:06:51.380(    411380.293 ms.)|    609.332|  00:05:18.847(    318847.407 ms.)|     77.507
|   14|  05.04.2019 02:03|       4171|     189852|  00:00:10.989(     10989.899 ms.)|     52.737|  00:00:00.539(       539.110 ms.)|      4.906
|   15|  05.04.2019 03:01|       4173|       3627|  00:00:00.103(       103.000 ms.)|      1.042|  00:00:00.004(         4.131 ms.)|      4.010
|   16|  05.04.2019 04:00|       4175|       3627|  00:00:00.085(        85.235 ms.)|      1.025|  00:00:00.003(         3.811 ms.)|      4.471
|   17|  05.04.2019 05:00|       4177|       3747|  00:00:00.849(       849.454 ms.)|      1.041|  00:00:00.006(         6.124 ms.)|       .721
|   18|  05.04.2019 06:00|       4179|       3747|  00:00:00.849(       849.561 ms.)|      1.041|  00:00:00.000(          .051 ms.)|       .006
|   19|  05.04.2019 07:00|       4181|       3747|  00:00:00.839(       839.416 ms.)|      1.041|  00:00:00.000(          .062 ms.)|       .007
|   20|  05.04.2019 08:00|       4183|       3747|  00:00:00.846(       846.382 ms.)|      1.041|  00:00:00.000(          .007 ms.)|       .001
|   21|  05.04.2019 09:00|       4185|       3747|  00:00:00.855(       855.426 ms.)|      1.041|  00:00:00.000(          .065 ms.)|       .008
|   22|  05.04.2019 10:00|       4187|       3797|  00:01:40.150(    100150.165 ms.)|      1.055|  00:00:21.845(     21845.217 ms.)|     21.812
Tekst van alle SQL-selecties
Verzoek
SELECT
  queryid ,
  query
FROM
  pg_stat_history
WHERE
  queryid IS NOT NULL AND
  database_id = DATABASE_ID  AND
  snapshot_timestamp BETWEEN BEGIN_TIMEPOINT AND END_TIMEPOINT
GROUP BY queryid , query
Conclusie
Zoals te zien is, kan met vrij eenvoudige middelen veel nuttige informatie over de belasting en de toestand van de database worden verkregen.
Opmerking:Als we de queryid in de aanvragen vastleggen, krijgen we de geschiedenis van een afzonderlijke aanvraag (om ruimte te besparen zijn rapporten per afzonderlijke aanvraag weggelaten).
Dus, statistische gegevens over de prestaties van aanvragen zijn beschikbaar en worden verzameld.
De eerste fase "gegevensverzameling" is voltooid.
We kunnen doorgaan naar de tweede fase - "instelling van prestatiemetingen".
Maar dat is een heel ander verhaal.
Wordt vervolgd…
Bron: habr.com
