

Hallo allemaal! Mijn naam is Nikolai Golov. Eerder werkte ik bij Avito en leidde ik zes jaar de Data Platform, wat betekent dat ik met alle databases werkte: analytische (Vertica, ClickHouse), streaming en OLTP (Redis, Tarantool, VoltDB, MongoDB, PostgreSQL). In die tijd heb ik me verdiept in een groot aantal databases - de meest diverse en ongebruikelijke, en met niet-standaard gebruiksgevallen.
Momenteel werk ik bij ManyChat. Het is in wezen een startup - nieuw, ambitieus en snelgroeiend. En toen ik net bij het bedrijf begon, ontstond de klassieke vraag: "Wat moeten jonge startups nu kiezen uit de markt van DBMS en databases?".
In dit artikel, gebaseerd op mijn presentatie op , zal ik deze vraag beantwoorden. De video van de presentatie is beschikbaar op .
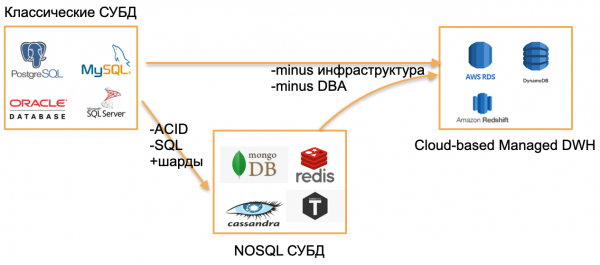
Algemene bekende databases in 2020
We zijn in 2020, ik keek om me heen en zag drie soorten databases.
De eerste soort - klassieke OLTP-databases: PostgreSQL, SQL Server, Oracle, MySQL. Ze zijn lang geleden geschreven, maar nog steeds relevant omdat ze goed bekend zijn bij de ontwikkelaarsgemeenschap.
De tweede soort - databases uit de ‘nul jaren’. Ze probeerden de klassieke modellen te vermijden door SQL, traditionele structuren en ACID te negeren, door ingebouwde sharding en andere aantrekkelijke functies toe te voegen. Bijvoorbeeld, dat zijn Cassandra, MongoDB, Redis of Tarantool. Al deze oplossingen wilden de markt iets fundamenteel nieuws bieden en hebben hun niche ingenomen omdat ze in bepaalde taken uiterst handig bleken te zijn. Deze databases benoem ik met de overkoepelende term NOSQL.
De ‘nul jaren’ zijn voorbij, we zijn gewend geraakt aan NOSQL-databases, en de wereld heeft, naar mijn mening, de volgende stap gezet - naar managed databases. Deze hebben dezelfde kern als klassieke OLTP-databases of nieuwe NoSQL. Maar ze hebben geen behoefte aan DBA en DevOps en draaien op beheerde hardware in de cloud. Voor de ontwikkelaar is het "gewoon een database", die ergens draait, en hoe deze op de server is geïnstalleerd, wie de server heeft ingesteld en wie het bijwerkt, interesseert niemand.
Voorbeelden van zulke databases:
- AWS RDS - managed wrapper voor PostgreSQL/MySQL.
- DynamoDB - AWS-analoog van een document-gebaseerde database, lijkt op Redis en MongoDB.
- Amazon Redshift - managed analytische database.
Dit zijn oude databases, maar opgezet in een managed omgeving, zonder de noodzaak om met hardware te werken.
Opmerking. Voorbeelden zijn gekozen voor de AWS-omgeving, maar hun analogieën bestaan ook in Microsoft Azure, Google Cloud of Yandex.Cloud.
Wat is er nieuw aan dit alles? In 2020 is er niets nieuws.
Het Serverless-concept
Echt nieuw op de markt in 2020 zijn serverless of serverloze oplossingen.
Ik zal proberen uit te leggen wat dit betekent aan de hand van een gewoon service- of backend-applicatie.
Om een gewone backend-applicatie uit te rollen, kopen of huren we een server, kopiëren we de code naar deze server, publiceren we de endpoint naar buiten en betalen we regelmatig voor de huur, elektriciteit en datacenterdiensten. Dit is het standaardschema.
Is er een andere manier? Met serverloze services wel.
Waar ligt de focus van deze benadering: geen server, zelfs geen huur van een virtuele instantie in de cloud. Voor het uitrollen van de service kopiëren we de code (functies) naar een repository en publiceren we de endpoint naar buiten. Verder betalen we gewoon voor elke aanroep van deze functie, waarbij we de hardware waarop deze wordt uitgevoerd volledig negeren.
Ik zal deze benadering illustreren met afbeeldingen.
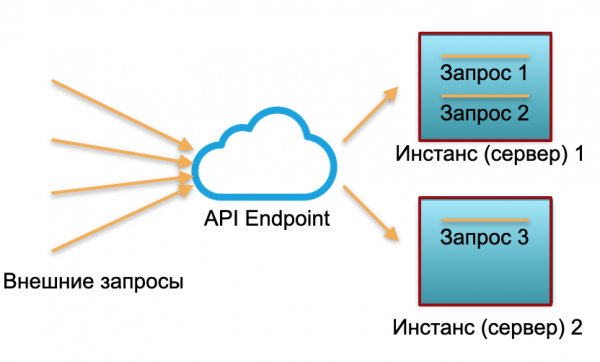
Klassieke deployment. We hebben een service met een bepaalde belasting. We zetten twee instanties op: fysieke servers of instanties in AWS. Externe verzoeken worden naar deze instanties gestuurd, waar ze worden verwerkt.
Zoals te zien is op de afbeelding, zijn de servers niet gelijkmatig benut. De ene is voor 100% benut, daar zijn twee verzoeken, terwijl de andere slechts voor 50% benut is — deze staat gedeeltelijk stil. Als er niet drie verzoeken komen, maar 30, dan kan het systeem de belasting niet aan en begint het te vertragen.
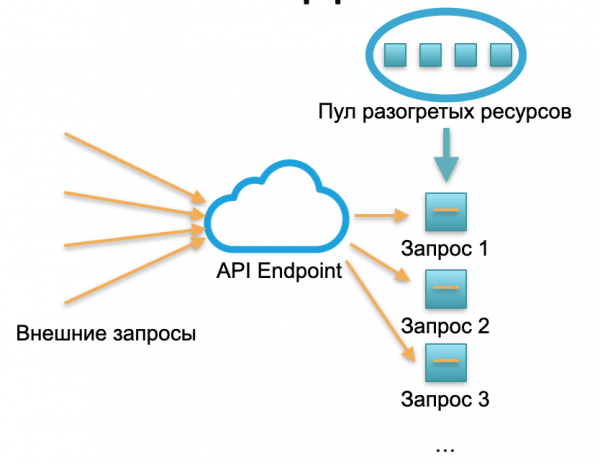
Serverless deployment. In een serverloze omgeving heeft zo'n service geen instanties en servers. Er is een bepaalde pool van opgewarmde bronnen — kleine voorbereide Docker-containers met de uitgerolde code van de functie. Het systeem ontvangt externe verzoeken en voor elk daarvan start het serverless framework een kleine container met code: het verwerkt precies dit verzoek en sluit de container.
Eén verzoek — één opgestarte container, 1000 verzoeken — 1000 containers. En de uitrol op fysieke servers is al het werk van de cloudprovider. Dit is volledig verborgen door het serverless framework. In dit concept betalen we voor elke aanroep. Bijvoorbeeld, als er één aanroep per dag komt — betalen we voor één aanroep, komt er miljoenen per minuut — betalen we voor miljoenen. Of per seconde, dat komt ook voor.
Het concept van het publiceren van een serverless functie is geschikt voor een stateless service. En als je een (state) stateful service nodig hebt, dan voegen we een database toe aan de service. In dit geval, wanneer we met state werken, schrijft en leest elke stateful functie gewoon uit de database. En dat kan uit een van de drie types databases zijn die aan het begin van het artikel zijn beschreven.
Wat is de algemene beperking voor al deze databases? De kosten voor een continu gebruikte cloud- of hardware server (of meerdere servers). Het maakt niet uit of we een klassieke database of een managed database gebruiken, met of zonder DevOps en een beheerder, we betalen altijd 24/7 voor de hardware, elektriciteit en huur van datacenters. Als we een klassieke database hebben, betalen we voor master en slave. Als het een hoogbelaste, gesharderde database is, betalen we voor 10, 20 of 30 servers, en dat constant.
De aanwezigheid van permanent gereserveerde servers in de kostenstructuur werd vroeger gezien als een onvermijdelijk kwaad. Gewone databases hebben ook andere complicaties, zoals limieten op het aantal verbindingen, beperkingen in schaalbaarheid en gedistribueerde consensus — deze kunnen in bepaalde databases op een bepaalde manier worden opgelost, maar niet allemaal tegelijk en niet perfect.
Serverless database — theorie
De vraag van 2020: kunnen we ook een database serverless maken? Iedereen heeft gehoord van een serverless backend... laten we ook proberen de database serverless te maken?
Het klinkt vreemd, omdat een database een stateful service is, die niet erg geschikt is voor een serverless infrastructuur. Bovendien, de state van een database is enorm: gigabytes, terabytes en in analytische databases zelfs petabytes. Je kunt het niet zomaar in lichte Docker-containers opzetten.
Aan de andere kant is bijna elke moderne database een enorme hoeveelheid logica en componenten: transacties, integriteitscontrole, procedures, relationele afhankelijkheden en veel logica. Een aanzienlijk deel van de logica van een database vereist relatief kleine state. Gigabytes en terabytes worden slechts door een klein deel van de logica van de database gebruikt, dat verband houdt met het direct uitvoeren van aanvragen.
Daarom is het idee: als een deel van de logica een stateless uitvoering toelat, waarom zouden we de database dan niet opsplitsen in stateful en stateless delen?
Serverless voor OLAP-oplossingen
Laten we eens kijken hoe de opsplitsing van een database in stateful en stateless delen eruit kan zien aan de hand van praktische voorbeelden.
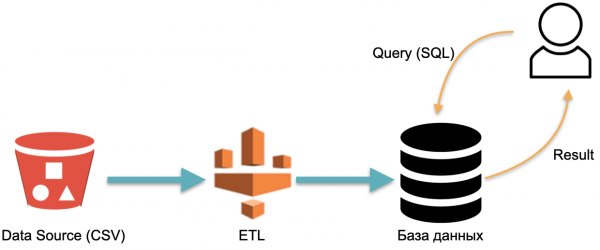
Bijvoorbeeld, we hebben een analytische database.: externe gegevens (rode cilinder links), een ETL-proces dat gegevens in de database laadt, en een analist die SQL-query's naar de database verzendt. Dit is een klassiek schema voor de werking van een datawarehouse.
In dit schema wordt de ETL één keer uitgevoerd. Vervolgens moet je voortdurend betalen voor de servers waarop de database draait met de door ETL geladen gegevens, zodat er een plek is om query's naar te sturen.
Laten we een alternatieve benadering bekijken, gerealiseerd in de AWS Athena Serverless. Hier is er geen permanent toegewezen hardware waarop de geladen gegevens zijn opgeslagen. In plaats daarvan:
- De gebruiker verzendt een SQL-query naar Athena. De optimizer van Athena analyseert de SQL-query en zoekt in de metadata-opslag naar specifieke gegevens die nodig zijn om de query uit te voeren.
- De optimizer, op basis van de verzamelde gegevens, haalt de benodigde gegevens uit externe bronnen naar een tijdelijke opslag (tijdelijke database).
- In de tijdelijke opslag wordt de SQL-query van de gebruiker uitgevoerd en het resultaat wordt aan de gebruiker teruggebracht.
- De tijdelijke opslag wordt gewist, de middelen worden vrijgemaakt.
In deze architectuur betalen we alleen voor het proces van de uitvoering van de query. Geen queries — geen kosten.
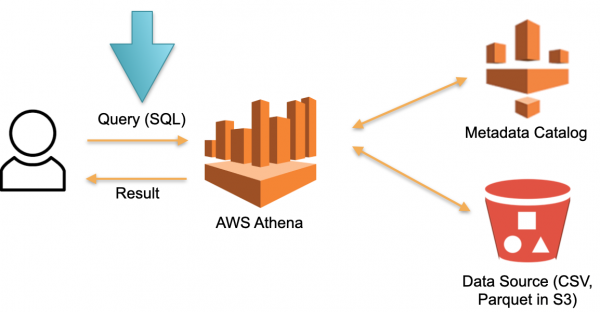
Dit is een werkbare aanpak en het wordt niet alleen in Athena Serverless geïmplementeerd, maar ook in Redshift Spectrum (in AWS).
Aan de hand van Athena is te zien dat een Serverless-database werkt met daadwerkelijke queries met tientallen en honderden terabytes aan gegevens. Voor honderden terabytes zijn honderden servers nodig, maar we hoeven niet voor hen te betalen — we betalen voor de queries. De snelheid van elke query is (zeer) laag in vergelijking met gespecialiseerde analytische databases zoals Vertica, maar we betalen niet voor stilstandperiodes.
Een dergelijke database is geschikt voor zeldzame analytische ad-hoc queries. Bijvoorbeeld wanneer we spontaan besluiten een hypothese te controleren op een enorme dataset. Voor deze gevallen is Athena ideaal. Voor regelmatig gebruik zijn dergelijke systemen duur. In dat geval kun je gegevens cachen in een gespecialiseerde oplossing.
Serverless voor OLTP-oplossingen.
In het vorige voorbeeld werden OLAP-taken (analytisch) besproken. Laten we nu OLTP-taken bekijken.
Stel een schaalbare PostgreSQL of MySQL voor. Laten we een gewone managed instance van PostgreSQL of MySQL op minimale middelen opzetten. Wanneer er meer belasting op de instance komt, zullen we extra replica's toevoegen, waaraan we een deel van de leesbelasting zullen verdelen. Als er geen verzoeken of belasting is, schakelen we de replica's uit. De eerste instance is de master, en de andere zijn replica's.
Dit idee is gerealiseerd in een database genaamd Aurora Serverless AWS. Het principe is eenvoudig: verzoeken van externe applicaties worden door een proxy fleet ontvangen. Bij een toenemende belasting wijst het rekencapaciteit toe uit vooraf opgewarmde minimale instances — de verbinding gebeurt zo snel mogelijk. Het uitschakelen van instances gebeurt op dezelfde manier.
Binnen Aurora bestaat het begrip Aurora Capacity Unit, ACU. Dit is (voorlopig) een instance (server). Elke specifieke ACU kan master of slave zijn. Elke Capacity Unit heeft zijn eigen RAM, processor en minimale schijf. Dit betekent één master en de overige zijn read-only replica's.
Het aantal actieve Aurora Capacity Units is een configureerbare parameter. Het minimale aantal kan één of nul zijn (in dat geval werkt de database niet als er geen verzoeken zijn).
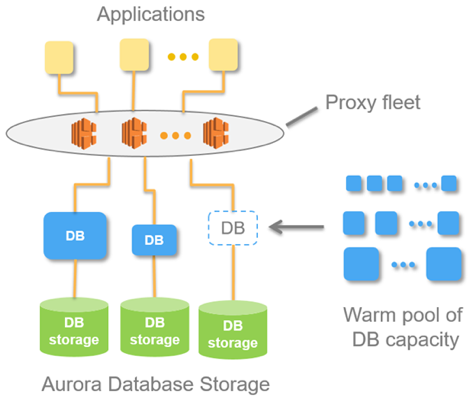
Wanneer de database verzoeken ontvangt, verhoogt de proxy fleet de Aurora Capacity Units, waardoor de productieve middelen van het systeem toenemen. De mogelijkheid om middelen te verhogen en te verlagen stelt het systeem in staat om 'te jongleren' met middelen: afzonderlijke ACU automatisch uit te schakelen (door ze door nieuwe te vervangen) en alle actuele updates op de uitgeschakelde middelen toe te passen.
De Aurora Serverless database kan de leesbelasting schalen. Maar dit staat niet expliciet in de documentatie. Het kan de indruk wekken dat ze multi-master kunnen opzetten. Er is echter geen magie aan.
Deze database is goed geschikt om geen enorme bedragen uit te geven aan systemen met onvoorspelbare toegang. Bijvoorbeeld, bij het maken van een MVP of marketing websites, verwachten we meestal geen stabiele belasting. Bij afwezigheid van toegang betalen we geen kosten voor instanties. Wanneer er onverwacht een last ontstaat, bijvoorbeeld na een conferentie of reclamecampagne, komen er grote groepen mensen op de site en stijgt de belasting sterk, dan neemt Aurora Serverless deze belasting automatisch op zich en schakelt snel de ontbrekende bronnen in (ACU). Daarna gaat de conferentie voorbij, iedereen vergeet het prototype, de servers (ACU) schakelen uit, en de kosten dalen naar nul — dat is handig.
Deze oplossing is niet geschikt voor stabiele hoge belasting, omdat deze niet kan schalen bij schrijfbelasting. Al deze verbindingen en ontkoppelingen van bronnen vinden plaats op het zogenaamde ‘scale point’ — het moment waarop de database niet door een transactie wordt vastgehouden, en tijdelijke tabellen niet vastgehouden worden. Bijvoorbeeld, gedurende een week kan er misschien geen scale point zijn, en werkt de database op dezelfde bronnen en kan deze gewoon niet uitbreiden of krimpen.
Er is geen magie — het is gewone PostgreSQL. Maar het proces van het toevoegen van machines en het gedeeltelijk automatiseren van ontkoppelingen is deels geautomatiseerd.
Serverless by design
Aurora Serverless is een oude database, herschreven voor de cloud, om de aparte voordelen van Serverless te benutten. En nu wil ik je iets vertellen over een database die oorspronkelijk voor de cloud is geschreven, volgens de serverless aanpak — Serverless-by-design. Deze is vanaf het begin ontwikkeld zonder de veronderstelling dat deze draait op fysieke servers.
Deze database heet Snowflake. Het heeft drie sleutelcomponenten.
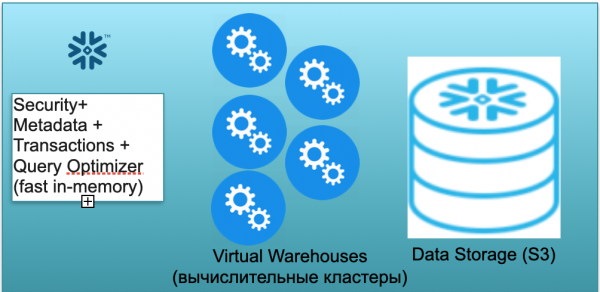
De eerste — is de metadata-blok. Dit is een snelle in-memory service die zorgt voor veiligheid, metadata, transacties en query-optimalisatie (op de illustratie links).
De tweede blok — is een verzameling van virtuele rekencustomers voor berekeningen (op de illustratie — een set blauwe cirkels).
De derde blok — is het gegevensopslagsysteem gebaseerd op S3. S3 is een onbeperkte objectopslag in AWS, een soort onbeperkte Dropbox voor bedrijven.
Laten we eens kijken hoe Snowflake werkt, uitgaande van een koude start. Dat wil zeggen, de database is er, de gegevens zijn erin geladen, maar er zijn geen actieve aanvragen. Als er dus geen aanvragen naar de database zijn, hebben we de snelle in-memory Metadata service geactiveerd (het eerste blok). En we hebben een S3-opslag waar de gegevens van de tabellen liggen, verdeeld in zogenaamde micro-partities. Voor de eenvoud: als er deals in de tabel staan, zijn de micro-partities de dagen van de deals. Elke dag is een aparte micro-partitie, een apart bestand. En wanneer de database in deze modus draait, betaalt u alleen voor de ruimte die door de gegevens wordt ingenomen. Bovendien is het tarief voor ruimte heel laag (vooral gezien de aanzienlijke compressie). De metadata service draait ook voortdurend, maar voor het optimaliseren van aanvragen zijn niet veel middelen nodig, en de service kan als voorwaardelijk gratis worden beschouwd.
Stel je nu voor dat er een gebruiker naar onze database is gekomen en een SQL-aanvraag heeft ingediend. De SQL-aanvraag wordt onmiddellijk doorgestuurd naar de Metadata service voor verwerking. Deze service analyseert de aanvraag, de beschikbare gegevens, de bevoegdheden van de gebruiker en, als alles in orde is, stelt het een verwerkingsplan voor de aanvraag op.
Vervolgens initieert de service de opstart van een rekencluster. Een rekencluster is een cluster van servers die berekeningen uitvoeren. Dat wil zeggen, het kan een cluster zijn dat 1 server, 2 servers, 4, 8, 16, 32 bevat — zoveel als u wilt. U dient de aanvraag in en het opstarten van dit cluster begint onmiddellijk. Het duurt echt seconden.
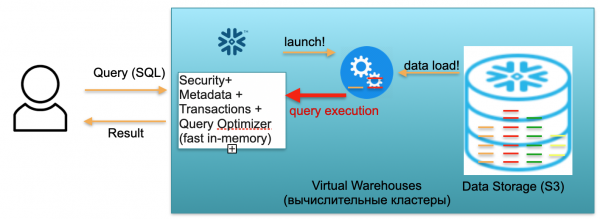
Vervolgens, nadat het cluster is opgestart, beginnen micro-partities uit S3 te worden gekopieerd naar het cluster, die nodig zijn voor de afhandeling van uw specifieke aanvraag. Stel je voor dat voor het uitvoeren van een SQL-query twee partities uit de ene tabel en één uit de andere nodig zijn. In dat geval worden er alleen drie specifieke partities naar het cluster gekopieerd, en niet alle tabellen in hun geheel. Daarom, en omdat alles zich in één datacenter bevindt en verbonden is via zeer snelle kanalen, verloopt het hele kopieerproces zeer snel: binnen seconden, zelden — binnen minuten, tenzij het gaat om enorme aanvragen. Bijgevolg worden de micro-partities gekopieerd naar het rekencluster, en, na voltooiing, wordt de SQL-query op dit rekencluster uitgevoerd. Het resultaat van deze query kan één regel, meerdere regels of een tabel zijn — deze worden verzonden naar de gebruiker, zodat hij het kan downloaden, weergeven in zijn BI-tool of op een andere manier kan gebruiken.
Elke SQL-query kan niet alleen aggregaten uit eerder geladen gegevens berekenen, maar ook nieuwe gegevens in de database laden/formeren. Dit kan bijvoorbeeld een query zijn die nieuwe records in een andere tabel invoegt, wat leidt tot de creatie van een nieuwe partitie op het rekencluster, die op zijn beurt automatisch wordt opgeslagen in de gemeenschappelijke S3-opslag.
Het hierboven beschreven scenario, van de komst van de gebruiker tot het opstarten van het cluster, het laden van gegevens, het uitvoeren van queries en het verkrijgen van resultaten, wordt gefactureerd op basis van het tarief per minuut voor het gebruik van het opgestarte virtuele rekencluster, de virtuele warehouse. Het tarief varieert afhankelijk van de AWS-zone en de grootte van het cluster, maar gemiddeld kost het enkele dollars per uur. Een cluster van vier machines is twee keer zo duur als dat van twee machines, en een cluster van acht machines is weer twee keer zo duur. Er zijn opties van 16, 32 machines beschikbaar, afhankelijk van de complexiteit van de queries. Maar je betaalt alleen voor de minuten dat het cluster daadwerkelijk draait, omdat, wanneer er geen queries zijn, je als het ware je handen wegneemt, en na 5-10 minuten wachten (instelbare parameter) zichzelf uitschakelt, de middelen vrijgeeft en gratis wordt.
Het is volledig mogelijk dat je een verzoek indient, de cluster binnen een minuut opkomt, nog een minuut rekent, vervolgens vijf minuten voor uitschakeling, en in totaal betaal je voor zeven minuten gebruik van deze cluster, in plaats van maanden of jaren.
Het eerste scenario beschreef het gebruik van Snowflake in een een-persoona variant. Laten we nu aannemen dat er veel gebruikers zijn, wat dichter bij een reëel scenario komt.
Stel dat we veel analisten hebben en Tableau-rapporten die constant onze database bestoken met een groot aantal eenvoudige analytische SQL-verzoeken.
Daarnaast kunnen we aannemen dat we inventieve Data Scientists hebben die proberen enorme dingen met de gegevens te doen, tientallen terabytes behandelen en miljarden en triljoenen rijen gegevens analyseren.
Voor de twee hierboven beschreven soorten belasting stelt Snowflake in staat om verschillende onafhankelijke rekenclusters van verschillende capaciteiten in te schakelen. Bovendien werken deze rekenclusters onafhankelijk, maar met gedeelde consistente gegevens.
Voor een groot aantal lichte verzoeken kunnen we 2-3 kleine clusters opzetten, elk met een hypothetische grootte van 2 machines. Dit gedrag kan ook worden gerealiseerd met behulp van automatische instellingen. Dit betekent dat je zegt: 'Snowflake, zet een klein cluster op. Als de belasting boven een bepaald niveau groeit, zet dan een vergelijkbare tweede en derde op. Wanneer de belasting begint te dalen, schakel overtollige clusters uit.' Dit is om ervoor te zorgen dat ongeacht het aantal analisten dat komt en rapporten bekijkt, er voldoende middelen beschikbaar zijn.
Als de analisten slapen en niemand de rapporten bekijkt, kunnen de clusters volledig worden uitgeschakeld, en stop je met betalen voor hen.
Voor zware verzoeken (van Data Scientists) kun je echter één zeer grote cluster opzetten met hypothetisch 32 machines. Deze cluster wordt ook alleen betaald voor de minuten en uren dat jouw enorme verzoek daar actief is.
De hierboven beschreven mogelijkheid maakt het mogelijk om niet slechts 2, maar ook meer soorten belasting (ETL, monitoring, materialisatie van rapporten,…) over verschillende clusters te scheiden.
Laten we de conclusies over Snowflake samenvatten. De database combineert een mooi idee met een praktische uitvoering. Bij ManyChat gebruiken we Snowflake voor de analyse van al onze beschikbare gegevens. We hebben niet drie clusters zoals in het voorbeeld, maar tussen de 5 en 9, verschillende grootten. We hebben zogenaamde 16-machine, 2-machine en zelfs superkleine 1-machine clusters voor bepaalde taken. Ze verdelen de belasting succesvol en stellen ons in staat om aanzienlijk te besparen.
De database schaalt succesvol de lees- en schrijflast. Dit is een enorme verbetering vergeleken met dezelfde 'Aurora', die alleen de leestaak aankon. Snowflake maakt het mogelijk om met deze rekenclusters ook de schrijflast te schalen. Zoals ik al zei, bij ManyChat gebruiken we verschillende clusters; kleine en superkleine clusters worden voornamelijk gebruikt voor ETL, voor het laden van gegevens. De analisten werken op de middelgrote clusters, die volledig ongestoord zijn door ETL-belasting, waardoor ze zeer snel werken.
Daarom is de database goed geschikt voor OLAP-taken. Helaas is het voor OLTP-belastingen nog niet toepasbaar. Ten eerste is deze database kolom-gebaseerd, met alle daaruit voortvloeiende gevolgen. Ten tweede is de benadering, waarbij je voor elke aanvraag naar behoefte een rekenscluster opzet en deze met gegevens vult, helaas voor OLTP-belastingen nog niet snel genoeg. Een wachttijd van enkele seconden voor OLAP-taken is acceptabel, maar voor OLTP-taken is dit onaanvaardbaar; liever 100 ms, en nog beter — 10 ms.
Conclusie
Een serverloze database is mogelijk door de database op te splitsen in stateless en stateful delen. U heeft ongetwijfeld opgemerkt dat in alle gegeven voorbeelden het stateful deel — voor zover we kunnen zeggen — de opslag van micro-partities in S3 is, terwijl het stateless deel de optimizer omvat, het werken met metadata, en de afhandeling van beveiligingskwesties, die als onafhankelijke, lichtgewicht stateless services kunnen worden opgezet.
Het uitvoeren van SQL-query's kan ook worden gezien als services met een licht state, die kunnen verschijnen in een serverloze modus, net als de rekenclusters van Snowflake, die alleen de benodigde gegevens downloaden, de query uitvoeren en weer 'uitschakelen'.
Serverless databases van productie-niveau zijn nu beschikbaar en functioneren zoals bedoeld. Deze serverless databases zijn al in staat om OLAP-taken aan te pakken. Helaas worden ze voor OLTP-taken gebruikt... met enige nuance, omdat er beperkingen zijn. Aan de ene kant is dat een nadeel. Aan de andere kant biedt het kansen. Misschien vindt iemand onder de lezers een manier om een OLTP-database volledig serverless te maken, zonder beperkingen van Aurora.
Ik hoop dat je het interessant vond. Voor een serverless toekomst 🙂
Bron: habr.com
