

Opmerking vertaler.: de aanpassing van Kubernetes in GitLab wordt beschouwd als een van de twee belangrijkste factoren die bijdragen aan de groei van het bedrijf. Tot voor kort was de infrastructuur van de online service GitLab.com echter gebouwd op virtuele machines, en het migreren naar K8s begon slechts ongeveer een jaar geleden, een proces dat nog steeds gaande is. We zijn blij om een vertaling te presenteren van een recent artikel van een SRE-engineer van GitLab over hoe dit verloopt en welke lessen de ingenieurs, die bij dit project betrokken zijn, hieruit trekken.
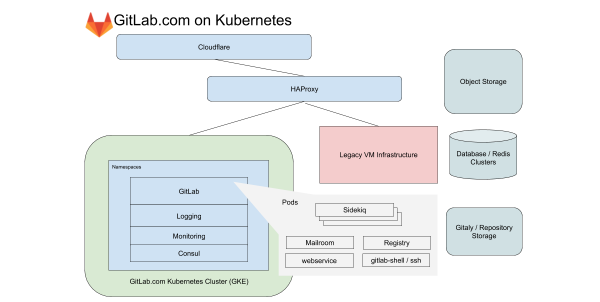
Al ongeveer een jaar is onze infrastructuurtak bezig met het migreren van alle services die op GitLab.com draaien naar Kubernetes. Gedurende deze tijd hebben we problemen ondervonden die niet alleen verband hielden met het verplaatsen van services naar Kubernetes, maar ook met het beheer van hybride deployments tijdens de overgang. Deze artikel zal ingaan op de waardevolle lessen die we hebben geleerd.
Vanaf het begin werkte GitLab.com op servers in de cloud op virtuele machines. Deze virtuele machines worden beheerd door Chef, en hun installatie gebeurt met behulp van onze . voor het geval er een update van de applicatie nodig is, bestaat uit het eenvoudig bijgewerkt houden van de serverpark op een gecoördineerde, geleidelijke manier door middel van een CI-pipeline. Deze methode - hoewel langzaam en een beetje garandeert dat GitLab.com dezelfde installatie- en configuratiemethoden gebruikt als gebruikers van de zelf-gehoste (self-managed) installaties van GitLab die onze Linux-pakketten gebruiken.
We gebruiken deze methode omdat het cruciaal is om de vreugdes en zorgen die reguliere leden van de gemeenschap ervaren tijdens het installeren en configureren van hun eigen kopieën van GitLab, zelf te ervaren. Deze aanpak heeft een tijdje goed gewerkt, maar toen het aantal projecten op GitLab meer dan 10 miljoen overschreed, realiseerden we ons dat deze methode niet langer voldeed aan onze schaal- en uitrolbehoeften.
Eerste stappen naar Kubernetes en cloud-native GitLab
In 2017 werd het project opgericht voor de voorbereiding van GitLab voor implementatie in de cloud, en om gebruikers in staat te stellen GitLab in Kubernetes-clusters te installeren. We wisten toen al dat het verplaatsen van GitLab naar Kubernetes de schaalbaarheid van het SaaS-platform zou vergroten, implementaties zou vereenvoudigen en de efficiëntie van het gebruik van rekenbronnen zou verbeteren. Tegelijkertijd waren veel functies van onze applicatie afhankelijk van gemounte NFS-volume's, wat de overgang van virtuele machines vertraagde.
De drang naar cloud native en Kubernetes stelde onze ingenieurs in staat om een geleidelijke overstap te plannen, waarbij we enkele afhankelijkheden van de applicatie van netwerklocy's hebben opgegeven, terwijl we tegelijkertijd nieuwe functies bleven ontwikkelen. Sinds we in de zomer van 2019 zijn begonnen met het plannen van de migratie, zijn veel van deze beperkingen weggenomen en de migratie van GitLab.com naar Kubernetes is nu in volle gang!
Kenmerken van GitLab.com op Kubernetes
Voor GitLab.com gebruiken we één regionale GKE-cluster dat al het applicatietraffic verwerkt. Om de complexiteit (die al ingewikkeld is) van de migratie te minimaliseren, richten we ons op diensten die niet afhankelijk zijn van lokale opslag of NFS. GitLab.com gebruikt voornamelijk een monolithische codebasis op Rails en we leiden het verkeer op basis van de kenmerken van de werklast naar verschillende endpoints, geïsoleerd in hun eigen knooppool.
In het geval van de frontend worden deze typen onderverdeeld in verzoeken aan web, API, Git SSH/HTTPS en Registry. Voor de backend splitsen we jobs in de wachtrijen op verschillende kenmerken afhankelijk van , die ons in staat stellen om service level doelen (Service-Level Objectives, SLO's) voor verschillende workloads vast te stellen.
Al deze GitLab.com-services zijn ingesteld met behulp van de ongewijzigde Helm-chart van GitLab. De configuratie wordt uitgevoerd in subcharts die selectief kunnen worden ingeschakeld naarmate we de diensten geleidelijk naar de cluster verplaatsen. Zelfs met het besluit om sommige van onze stateful-services, zoals Redis, Postgres, GitLab Pages en Gitaly, niet in de migratie op te nemen, stelt het gebruik van Kubernetes ons in staat om het aantal VM's dat momenteel door Chef wordt beheerd, drastisch te verminderen.
Transparantie en configuratiebeheer in Kubernetes
Alle instellingen worden beheerd door GitLab zelf. Hiervoor worden drie configuratieprojecten gebruikt op basis van Terraform en Helm. We proberen waar mogelijk GitLab zelf te gebruiken voor de implementatie van GitLab, maar voor operationele taken hebben we een aparte installatie van GitLab. Dit is nodig om niet afhankelijk te zijn van de beschikbaarheid van GitLab.com tijdens implementaties en updates van GitLab.com.
Hoewel onze pipelines voor de Kubernetes-cluster draaien op een aparte installatie van GitLab, hebben de code repositories spiegels die publiekelijk toegankelijk zijn op de volgende adressen:
- — de configuratiewrap voor GitLab.com voor de Helm-chart van GitLab;
- — bevat configuraties voor services die niet direct met de GitLab-applicatie zijn verbonden. Dit omvat configuraties voor logging en monitoring van de cluster, evenals voor geïntegreerde tools zoals PlantUML;
- — Terraform-configuratie voor Kubernetes en de oude (legacy) VM-infrastructuur. Hier worden alle bronnen ingesteld die nodig zijn om de cluster te draaien, inclusief de cluster zelf, knooppoolen, service-accounts en IP-adres reserveringen.

Bij het aanbrengen van wijzigingen wordt een openbare getoond met een link naar de gedetailleerde diff, die SRE analyseert voordat de wijzigingen in de cluster worden aangebracht.
Voor SRE verwijst de link naar de gedetailleerde diff in de GitLab-installatie die voor de exploitatie wordt gebruikt en waarvan de toegang beperkt is. Dit stelt medewerkers en de gemeenschap zonder toegang tot het operationele project (dat alleen toegankelijk is voor SRE) in staat om de voorgestelde wijzigingen in de configuratie te bekijken. Door een openbare versie van GitLab voor code te combineren met een gesloten versie voor CI-pipelines, behouden we een uniforme workflow, terwijl we tegelijkertijd onafhankelijkheid van GitLab.com bij configuratie-updates garanderen.
Wat we hebben geleerd tijdens de migratie
Tijdens de verhuizing is er ervaring opgedaan die we toepassen op nieuwe migraties en implementaties in Kubernetes.
1. Stijging van kosten wegens verkeer tussen availability zones
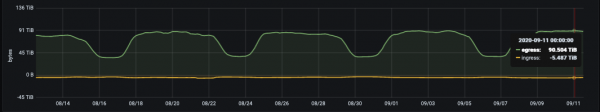
Dagelijkse egress-statistiek (bytes per dag) voor het Git-repositories op GitLab.com
Google verdeelt zijn netwerk in regio's. Deze worden op hun beurt opgesplitst in beschikbaarheidszones (AZ). Git-hosting is verbonden met grote hoeveelheden data, daarom is het belangrijk om het netwerkegress te beheersen. In het geval van intern verkeer is egress gratis, zolang het binnen de grenzen van één beschikbaarheidszone blijft. Op het moment van schrijven geven we ongeveer 100 TB data weg op een reguliere werkdag (en dat is alleen voor Git-repositories). Diensten die in onze oude topologie, gebaseerd op VM's, zich op dezelfde virtuele machines bevonden, draaien nu in verschillende pods van Kubernetes. Dit betekent dat een deel van het verkeer, dat eerder lokaal was voor VM's, potentieel buiten de beschikbaarheidszones kan komen.
Regionale GKE-clusters stellen ons in staat om meerdere beschikbaarheidszones te bestrijken voor redundantie. We overwegen om voor diensten die grote volumes verkeer genereren. Dit zal helpen om de uitgaven voor egress te verminderen, terwijl we de redundantie op cluster niveau behouden.
2. Limieten, resourceverzoeken en schaling
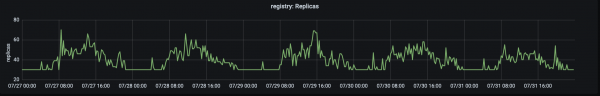
Het aantal replicas dat production-verkeer verwerkt op registry.gitlab.com. Het verkeer bereikt zijn piek rond 15:00 UTC.
Ons migratieverhaal begon in augustus 2019, toen we de eerste service – de GitLab Container Registry – naar Kubernetes verhuisden. Deze kritieke service met hoge verkeersvolume was goed geschikt voor de eerste migratie, aangezien het een stateless applicatie is met een beperkt aantal externe afhankelijkheden. Het eerste probleem waarmee we geconfronteerd werden, was het grote aantal verdreven pods door geheugengebrek op de knooppunten. Hierdoor moesten we de verzoeken en limieten aanpassen.
Er werd ontdekt dat in het geval van een applicatie waarvan het geheugengebruik in de loop van de tijd toeneemt, lage waarden voor verzoeken (die geheugen reserveren voor elke pod) in combinatie met een " genereuze" harde limiet voor gebruik leidde tot verzadiging (saturation) van knooppunten en een hoog niveau van verdrijvingen. Om dit probleem het hoofd te bieden, werd Dit verlichtte de druk op knooppunten en zorgde voor een levenscyclus van pods die niet te veel druk uitoefende op het knooppunt. Nu beginnen we met migraties met royale (en bijna gelijke) waarden voor aanvragen en limieten, die we indien nodig aanpassen.
3. Metrics en logs
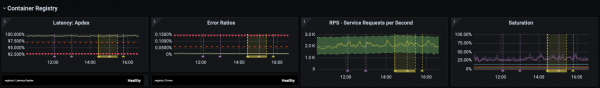
Het infrastructuurteam richt zich op vertragingen, foutpercentages en verzadiging met betrekking tot de vastgestelde (SLO), gekoppeld aan .
In het afgelopen jaar waren verbeteringen in monitoring en het werken met SLO's een van de belangrijkste gebeurtenissen in het infrastructuurteam. SLO's stelden ons in staat om doelen te stellen voor afzonderlijke diensten, die we nauwlettend volgden tijdens de migratie. Maar zelfs met zo'n verbeterde zichtbaarheid is het niet altijd mogelijk om problemen snel te zien met alleen metrics en alerts. Bijvoorbeeld, door ons te concentreren op vertragingen en foutpercentages, dekken we niet alle gebruiksscenario's van de migrerende dienst volledig.
Dit probleem werd vrijwel onmiddellijk ontdekt nadat we een deel van de werklasten naar het cluster hadden verplaatst. Het werd vooral duidelijk bij het controleren van functies waarbij het aantal aanvragen gering is, maar die zeer specifieke configuratie-afhankelijkheden hebben. Een van de belangrijkste lessen van de migratie was de noodzaak om bij monitoring niet alleen metrics, maar ook logs en de 'lange staart' in overweging te nemen. (het betreft hun distributie van fouten. Nu integreren we voor elke migratie een gedetailleerde lijst van logaanvragen (log queries) en plannen we duidelijke roll-back procedures die in geval van problemen van de ene ploeg naar de andere kunnen worden overgedragen. Parallelle afhandeling van dezelfde aanvragen op de oude VM-infrastructuur en de nieuwe op basis van Kubernetes vormde een unieke uitdaging. In tegenstelling tot lift-and-shift migratie
(snelle verhuizing van applicaties ‘zoals ze zijn’ naar de nieuwe infrastructuur, meer hierover kan gelezen worden, bijvoorbeeld, (snelle migratie van applicaties 'zoals ze zijn' naar een nieuwe infrastructuur; meer details kunnen bijvoorbeeld hier worden gelezen, – opmerking vert.), gelijktijdig werken op 'oude' VM's en Kubernetes vereist dat monitoringtools compatibel zijn met beide omgevingen en metrics in één zicht kunnen combineren. Het is belangrijk dat we dezelfde dashboards en logqueries gebruiken om consistente observatie gedurende de overgangsperiode te bereiken.
4. Verkeer omleiden naar de nieuwe cluster
Voor GitLab.com is een deel van de servers toegewezen aan . Het canary-park bedient onze interne projecten en kan ook . Maar het is voornamelijk bedoeld om veranderingen in de infrastructuur en de applicatie te testen. De eerste overgezette dienst begon met het ontvangen van een beperkte hoeveelheid intern verkeer, en we blijven deze methode gebruiken om ervoor te zorgen dat we voldoen aan de SLO voordat we al het verkeer naar de cluster leiden.
In het geval van migratie betekent dit dat verzoeken naar interne projecten eerst naar Kubernetes worden gestuurd, waarna we geleidelijk de rest van het verkeer naar de cluster omleiden door het gewicht voor de backend via HAProxy aan te passen. Tijdens de overgang van VM naar Kubernetes werd duidelijk dat het zeer voordelig is om een eenvoudige manier te hebben om verkeer tussen de oude en nieuwe infrastructuur om te leiden en om de oude infrastructuur gereed te houden voor terugval in de eerste paar dagen na de migratie.
5. Reserves van pod-capaciteit en hun gebruik
Bijna onmiddellijk werd het volgende probleem vastgesteld: pods voor de Registry-service startten snel, maar het opstarten van pods voor Sidekiq duurde tot . De langdurige opstarttijd van pods voor Sidekiq werd een probleem toen we begonnen met de migratie van werkbelasting naar Kubernetes voor werkers die jobs snel moesten verwerken en snel moesten schalen.
In dit geval was de les dat hoewel de Horizontal Pod Autoscaler (HPA) in Kubernetes goed omgaat met een toename van het verkeer, het belangrijk is om rekening te houden met de eigenschappen van de werkbelastingen en terugvalcapaciteit voor pods te reserveren (vooral onder onregelmatige vraag). In ons geval was er een plotselinge piek in jobs, wat leidde tot snelle opschaling, waardoor CPU-resources verzadigd raakten voordat we de nodepool konden schalen.
Er is altijd de verleiding om zoveel mogelijk uit de cluster te halen. Echter, nadat we aanvankelijk problemen met de prestaties ondervonden, starten we nu met een genereus pod budget en verlagen dit later, terwijl we de SLO nauwlettend in de gaten houden. Het starten van pods voor de Sidekiq-service is aanzienlijk versneld en neemt nu gemiddeld ongeveer 40 seconden in beslag. hebben zowel GitLab.com als onze gebruikers van self-managed installaties, die werken met de officiële Helm-chart van GitLab, geprofiteerd.
Conclusie
Na het migreren van elke service waren we blij met de voordelen van het gebruik van Kubernetes in productie: snellere en veiligere applicatiedeploys, schaling en efficienter resourcebeheer. Bovendien reiken de voordelen van de migratie verder dan de GitLab.com service. Elke verbetering van de officiële Helm-chart komt ook de gebruikers ten goede.
Ik hoop dat je genoten hebt van het verhaal over onze avonturen met de migratie naar Kubernetes. We blijven steeds meer services naar de cluster verplaatsen. Meer informatie kun je vinden in de volgende publicaties:
- «»;
- «»;
- .
P.S. van de vertaler
Lees ook op onze blog:
- «»;
- «»;
- «»;
- «».
Bron: habr.com
