

Die dagen zijn voorbij dat je je geen zorgen hoefde te maken over de optimalisatie van databaseprestaties. De tijd staat niet stil. Elke nieuwe ondernemer in de technologie wil de volgende Facebook creëren, terwijl hij tegelijkertijd alle gegevens verzamelt die hij kan bereiken. Deze gegevens zijn nodig voor betere modellen die helpen om winst te maken. In deze omstandigheden moeten ontwikkelaars API's creëren die snel en betrouwbaar kunnen omgaan met enorme hoeveelheden informatie.
Als je al een tijdje bezig bent met het ontwerpen van servercomponenten voor applicaties of databases, heb je waarschijnlijk code geschreven om paginaverzoeken uit te voeren. Bijvoorbeeld zo:
SELECT * FROM table_name LIMIT 10 OFFSET 40
Is dat zo?
Maar als je paginering op deze manier hebt uitgevoerd, moet ik met spijt opmerken dat je dat niet op de meest efficiënte manier hebt gedaan.
Wil je me tegenspreken? . , en maakt al gebruik van technieken waar ik vandaag over wil spreken.
Noem eens één backend-ontwikkelaar die nooit OFFSET en LIMIT heeft gebruikt om paginaverzoeken uit te voeren. In MVP's (Minimum Viable Product) en in projecten met kleine hoeveelheden gegevens is deze benadering heel goed toepasbaar. Het 'werkt gewoon'.
Maar als je betrouwbare en efficiënte systemen vanaf nul moet opbouwen, is het belangrijk om van tevoren te zorgen voor de efficiëntie van databasequery's die in dergelijke systemen worden gebruikt.
Vandaag zullen we het hebben over de problemen die gepaard gaan met de veelgebruikte (jammer genoeg) implementaties van pagineringmechanismen en hoe we hoge prestaties kunnen bereiken bij het uitvoeren van dergelijke queries.
Wat is er mis met OFFSET en LIMIT?
Zoals eerder gezegd, OFFSET en LIMIT presteren ze uitstekend in projecten waarbij geen grote hoeveelheden gegevens hoeven te worden verwerkt.
Het probleem doet zich voor wanneer de database zo groot wordt dat deze niet meer in het geheugen van de server past. Maar terwijl je met deze database werkt, moet je paginaverzoeken blijven gebruiken.
Om dit probleem te laten optreden, moet er een situatie ontstaan waarin de database (DBMS) gebruikmaakt van een inefficiënte operatie van een volledige tabelscan (Full Table Scan) bij het uitvoeren van elke aanvraag met paginering (terwijl er tegelijkertijd gegevensinvoeg- en verwijderingsoperaties plaatsvinden, en verouderde gegevens zijn dan niet nodig!).
Wat is een ‘volle tabelscan’ (of ‘sequentiële tabelweergave’, Sequential Scan)? Dit is een operatie waarbij de DBMS elke rij van de tabel sequentieel leest, dat wil zeggen de daarin aanwezige gegevens, en controleert of deze voldoen aan de opgegeven voorwaarde. Het is bekend dat dit type tabelscan de langzaamste is. Dit komt omdat bij de uitvoering ervan veel invoer/uitvoeroperaties plaatsvinden, die de schijfsubsystemen van de server beïnvloeden. De situatie wordt verergerd door de vertragingen die gepaard gaan met het werken met gegevens die op schijven zijn opgeslagen, en het feit dat het overdragen van gegevens van de schijf naar het geheugen een middelenintensievere operatie is.
Stel dat je records hebt van 100000000 gebruikers, en je voert een aanvraag uit met de constructie OFFSET 50000000. Dit betekent dat de DBMS al deze records moet laden (en ze zijn zelfs niet nodig!), ze in het geheugen moet plaatsen en pas daarna, bijvoorbeeld, 20 resultaten moet nemen die zijn vermeld in LIMIT.
Laten we zeggen dat het er zo uit kan zien: ‘selecteer rijen van 50000 tot 50020 uit 100000’. Dat wil zeggen, het systeem moet eerst 50000 rijen laden om de aanvraag uit te voeren. Zie je hoeveel onnodig werk het moet doen?
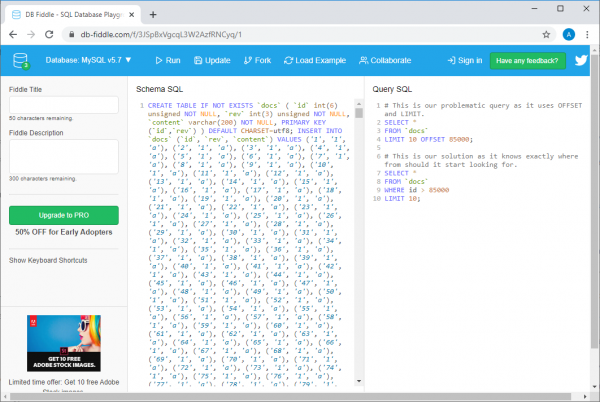
Als je het niet gelooft, kijk dan eens naar het voorbeeld dat ik heb gemaakt met behulp van .
Voorbeeld op db-fiddle.com
Daar, aan de linkerkant in het veld Schema SQL, staat de code die het invoegen van 100000 rijen in de database uitvoert, en rechts in het veld Query SQL, staan twee aanvragen. De eerste, traag, ziet er zo uit:
SELECT *
FROM `docs`
LIMIT 10 OFFSET 85000;
En de tweede, die een effectieve oplossing voor dezelfde taak is, is als volgt:
SELECT *
FROM `docs`
WHERE id > 85000
LIMIT 10;
Om deze aanvragen uit te voeren, hoef je alleen maar op de knop te drukken Run boven aan de pagina. Door dit te doen, kunnen we de informatie over de uitvoeringstijden van de aanvragen vergelijken. Blijkt dat het uitvoeren van een inefficiënte aanvraag minstens 30 keer meer tijd kost dan het uitvoeren van de tweede (tussen de uitvoeringen kan dit tijdsverschil variëren; bijvoorbeeld, het systeem kan rapporteren dat het 37 ms kostte om de eerste aanvraag uit te voeren en 1 ms voor de tweede).
En als er meer gegevens zijn, ziet het er nog slechter uit (om dit te bevestigen, kijk naar mijn met 10 miljoen rijen).
Wat we zojuist hebben besproken, zou je enige inzicht moeten geven in hoe databaseverzoeken daadwerkelijk worden verwerkt.
Houd er rekening mee dat hoe hoger de waarde is, OFFSET hoe langer de aanvraag zal duren.
Wat moet je gebruiken in plaats van een combinatie van OFFSET en LIMIT?
In plaats van de combinatie, OFFSET en LIMIT kan je beter een constructie gebruiken die als volgt is opgebouwd:
SELECT * FROM table_name WHERE id > 10 LIMIT 20
Dit is een paginering op basis van cursors (Cursor based pagination).
In plaats van de huidige waarden lokaal op te slaan OFFSET en LIMIT en deze met elke aanvraag door te geven, moet je de laatst ontvangen primaire sleutel opslaan (meestal is dit ID) en LIMIT, waardoor de aanvragen ontstaan die lijken op de bovenstaande.
Waarom? Omdat je, door expliciet de identificatiemarker van de laatste gelezen rij op te geven, je DBMS vertelt waar het moet beginnen met het zoeken naar de benodigde gegevens. Bovendien zal het zoeken, dankzij het gebruik van de sleutel, efficiënt zijn; het systeem hoeft zich niet te concentreren op rijen buiten het aangegeven bereik.
Laten we eens kijken naar de volgende vergelijking van de prestaties van verschillende aanvragen. Hier is een inefficiënte aanvraag.
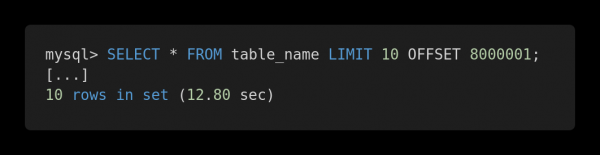
Langzame aanvraag
En dit is de geoptimaliseerde versie van deze aanvraag.
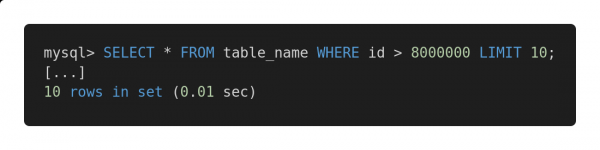
Snelle aanvraag
Beide aanvragen geven precies dezelfde hoeveelheid gegevens terug. Maar de eerste neemt 12,80 seconden in beslag, terwijl de tweede er 0,01 seconde over doet. Voel je het verschil?
Mogelijke problemen
Om de effectieve werking van de voorgestelde methode voor het uitvoeren van verzoeken te waarborgen, moet er in de tabel een kolom (of kolommen) aanwezig zijn met unieke, opeenvolgend geplaatste indexen, zoals een geheel getal identificator. In sommige specifieke gevallen kan dit het succes van het toepassen van dergelijke verzoeken om de snelheid van de database te verbeteren, bepalen.
Bij het construeren van verzoeken moet men natuurlijk rekening houden met de architectonische eigenschappen van tabellen en de mechanismen kiezen die het beste presteren op de beschikbare tabellen. Bijvoorbeeld, als het nodig is om in verzoeken met grote hoeveelheden gerelateerde gegevens te werken, kan u geïnteresseerd zijn in dit artikel.
Als we geconfronteerd worden met het probleem van het ontbreken van een primaire sleutel, bijvoorbeeld als er een tabel is met een "veel-op-veel" relatie, dan is de traditionele aanpak die het gebruik van OFFSET en LIMIT, gegarandeerd geschikt voor ons. Maar het gebruik ervan kan leiden tot potentieel trage verzoeken. In dergelijke gevallen zou ik aanbevelen een primaire sleutel met auto-increment te gebruiken, ook al is deze alleen nodig voor het organiseren van verzoeken met paginering.
Als u geïnteresseerd bent in dit onderwerp — , en — hier zijn enkele nuttige materialen.
Conclusies
De belangrijkste conclusie die we kunnen trekken, is dat, ongeacht de grootte van de databases, altijd de snelheid van verzoeken geanalyseerd moet worden. In deze tijd is schaalbaarheid van oplossingen uiterst belangrijk. En als alles vanaf het begin goed wordt ontworpen in een systeem, kan dit de ontwikkelaar in de toekomst veel problemen besparen.
Hoe analyseert en optimaliseert u verzoeken naar databases?
Bron: habr.com
