

Voorwoord
Zeer vaak komen gebruikers, ontwikkelaars en databasebeheerders van MS SQL Server problemen met de prestaties van de database of de databasebeheersystemen in het algemeen tegen. Daarom is het monitoren van MS SQL Server zeer relevant.
Dit artikel is een aanvulling op het artikel en hierin worden enkele aspecten van het monitoren van MS SQL Server besproken, in het bijzonder: hoe snel te bepalen welke middelen ontbreken en aanbevelingen voor het configureren van traceflags.
Om de volgende scripts te laten werken, is het noodzakelijk om het schema inf in de gewenste database als volgt aan te maken:
Creëren van het schema inf
use ;
go
create schema inf;
Methode om gebrek aan RAM te identificeren
De eerste indicatie van een tekort aan RAM is het geval wanneer de instantie van MS SQL Server al het toegewezen RAM verbruikt.
Daarom maken we het volgende weergave inf.vRAM aan:
Creëren van de weergave inf.vRAM
CREATE view [inf].[vRAM] as
select a.[TotalAvailOSRam_Mb]						-- hoeveel vrij RAM op de server in MB
		 , a.[RAM_Avail_Percent]					-- percentage vrij RAM op de server
		 , a.[Server_physical_memory_Mb]				-- totaal RAM op de server in MB
		 , a.[SQL_server_committed_target_Mb]			-- totaal RAM toegewezen aan MS SQL Server in MB
		 , a.[SQL_server_physical_memory_in_use_Mb] 		-- totaal RAM verbruikt door MS SQL Server op dit moment in MB
		 , a.[SQL_RAM_Avail_Percent]				-- percentage vrij RAM voor MS SQL Server ten opzichte van het totaal toegewezen RAM voor MS SQL Server
		 , a.[StateMemorySQL]						-- is er voldoende RAM voor MS SQL Server
		 , a.[SQL_RAM_Reserve_Percent]				-- percentage gereserveerd RAM voor MS SQL Server ten opzichte van het totaal RAM van de server
		 -- is er voldoende RAM voor de server
		, (case when a.[RAM_Avail_Percent]5 and a.[TotalAvailOSRam_Mb]<8192 then 'Waarschuwing' when a.[RAM_Avail_Percent]<=5 and a.[TotalAvailOSRam_Mb]<2048 then 'Gevaren' else 'Normaal' end) as [StateMemoryServer]
	from
	(
		select cast(a0.available_physical_memory_kb/1024.0 as int) as TotalAvailOSRam_Mb
			 , cast((a0.available_physical_memory_kb/cast(a0.total_physical_memory_kb as float))*100 as numeric(5,2)) as [RAM_Avail_Percent]
			 , a0.system_low_memory_signal_state
			 , ceiling(b.physical_memory_kb/1024.0) as [Server_physical_memory_Mb]
			 , ceiling(b.committed_target_kb/1024.0) as [SQL_server_committed_target_Mb]
			 , ceiling(a.physical_memory_in_use_kb/1024.0) as [SQL_server_physical_memory_in_use_Mb]
			 , cast(((b.committed_target_kb-a.physical_memory_in_use_kb)/cast(b.committed_target_kb as float))*100 as numeric(5,2)) as [SQL_RAM_Avail_Percent]
			 , cast((b.committed_target_kb/cast(a0.total_physical_memory_kb as float))*100 as numeric(5,2)) as [SQL_RAM_Reserve_Percent]
			 , (case when (ceiling(b.committed_target_kb/1024.0)-1024)<ceiling(a.physical_memory_in_use_kb/1024.0) then 'Waarschuwing' else 'Normaal' end) as [StateMemorySQL]
		from sys.dm_os_sys_memory as a0
		cross join sys.dm_os_process_memory as a
		cross join sys.dm_os_sys_info as b
		cross join sys.dm_os_sys_memory as v
	) as a;
Om te bepalen dat de instantie van MS SQL Server al het toegewezen geheugen verbruikt, kan de volgende query worden gebruikt:
select  SQL_server_physical_memory_in_use_Mb,  SQL_server_committed_target_Mb
from [inf].[vRAM];
Als de waarde van SQL_server_physical_memory_in_use_Mb voortdurend niet minder is dan SQL_server_committed_target_Mb, moet de wachtstatistiek worden gecontroleerd.
Om het gebrek aan RAM-geheugen via de wachtstatistiek te bepalen, creëren we de weergave inf.vWaits:
Het maken van de weergave inf.vWaits
CREATE view [inf].[vWaits] as
WITH [Waits] AS
    (SELECT
        [wait_type], --naam van het wacht-type
        [wait_time_ms] / 1000.0 AS [WaitS],--Totaal wachtijd voor dit type in milliseconden. Deze tijd omvat signal_wait_time_ms
        ([wait_time_ms] - [signal_wait_time_ms]) / 1000.0 AS [ResourceS],--Totaal wachtijd voor dit type in milliseconden zonder signal_wait_time_ms
        [signal_wait_time_ms] / 1000.0 AS [SignalS],--Verschil tussen de signaal tijd van de wachtende thread en de tijd waarop deze is gestart
        [waiting_tasks_count] AS [WaitCount],--Aantal wachttijden voor dit type. Deze teller neemt elk keer toe bij het begin van een wacht
        100.0 * [wait_time_ms] / SUM ([wait_time_ms]) OVER() AS [Percentage],
        ROW_NUMBER() OVER(ORDER BY [wait_time_ms] DESC) AS [RowNum]
    FROM sys.dm_os_wait_stats
    WHERE [waiting_tasks_count]>0
		and [wait_type] NOT IN (
        N'BROKER_EVENTHANDLER',         N'BROKER_RECEIVE_WAITFOR',
        N'BROKER_TASK_STOP',            N'BROKER_TO_FLUSH',
        N'BROKER_TRANSMITTER',          N'CHECKPOINT_QUEUE',
        N'CHKPT',                       N'CLR_AUTO_EVENT',
        N'CLR_MANUAL_EVENT',            N'CLR_SEMAPHORE',
        N'DBMIRROR_DBM_EVENT',          N'DBMIRROR_EVENTS_QUEUE',
        N'DBMIRROR_WORKER_QUEUE',       N'DBMIRRORING_CMD',
        N'DIRTY_PAGE_POLL',             N'DISPATCHER_QUEUE_SEMAPHORE',
        N'EXECSYNC',                    N'FSAGENT',
        N'FT_IFTS_SCHEDULER_IDLE_WAIT', N'FT_IFTSHC_MUTEX',
        N'HADR_CLUSAPI_CALL',           N'HADR_FILESTREAM_IOMGR_IOCOMPLETION',
        N'HADR_LOGCAPTURE_WAIT',        N'HADR_NOTIFICATION_DEQUEUE',
        N'HADR_TIMER_TASK',             N'HADR_WORK_QUEUE',
        N'KSOURCE_WAKEUP',              N'LAZYWRITER_SLEEP',
        N'LOGMGR_QUEUE',                N'ONDEMAND_TASK_QUEUE',
        N'PWAIT_ALL_COMPONENTS_INITIALIZED',
        N'QDS_PERSIST_TASK_MAIN_LOOP_SLEEP',
        N'QDS_CLEANUP_STALE_QUERIES_TASK_MAIN_LOOP_SLEEP',
        N'REQUEST_FOR_DEADLOCK_SEARCH', N'RESOURCE_QUEUE',
        N'SERVER_IDLE_CHECK',           N'SLEEP_BPOOL_FLUSH',
        N'SLEEP_DBSTARTUP',             N'SLEEP_DCOMSTARTUP',
        N'SLEEP_MASTERDBREADY',         N'SLEEP_MASTERMDREADY',
        N'SLEEP_MASTERUPGRADED',        N'SLEEP_MSDBSTARTUP',
        N'SLEEP_SYSTEMTASK',            N'SLEEP_TASK',
        N'SLEEP_TEMPDBSTARTUP',         N'SNI_HTTP_ACCEPT',
        N'SP_SERVER_DIAGNOSTICS_SLEEP', N'SQLTRACE_BUFFER_FLUSH',
        N'SQLTRACE_INCREMENTAL_FLUSH_SLEEP',
        N'SQLTRACE_WAIT_ENTRIES',       N'WAIT_FOR_RESULTS',
        N'WAITFOR',                     N'WAITFOR_TASKSHUTDOWN',
        N'WAIT_XTP_HOST_WAIT',          N'WAIT_XTP_OFFLINE_CKPT_NEW_LOG',
        N'WAIT_XTP_CKPT_CLOSE',         N'XE_DISPATCHER_JOIN',
        N'XE_DISPATCHER_WAIT',          N'XE_TIMER_EVENT')
    )
, ress as (
	SELECT
	    [W1].[wait_type] AS [WaitType],
	    CAST ([W1].[WaitS] AS DECIMAL (16, 2)) AS [Wait_S],--Totaal wachtijd voor dit type in milliseconden. Deze tijd omvat signal_wait_time_ms
	    CAST ([W1].[ResourceS] AS DECIMAL (16, 2)) AS [Resource_S],--Totaal wachtijd voor dit type in milliseconden zonder signal_wait_time_ms
	    CAST ([W1].[SignalS] AS DECIMAL (16, 2)) AS [Signal_S],--Verschil tussen de signaal tijd van de wachtende thread en de tijd waarop deze is gestart
	    [W1].[WaitCount] AS [WaitCount],--Aantal wachttijden voor dit type. Deze teller neemt elk keer toe bij het begin van een wacht
	    CAST ([W1].[Percentage] AS DECIMAL (5, 2)) AS [Percentage],
	    CAST (([W1].[WaitS] / [W1].[WaitCount]) AS DECIMAL (16, 4)) AS [AvgWait_S],
	    CAST (([W1].[ResourceS] / [W1].[WaitCount]) AS DECIMAL (16, 4)) AS [AvgRes_S],
	    CAST (([W1].[SignalS] / [W1].[WaitCount]) AS DECIMAL (16, 4)) AS [AvgSig_S]
	FROM [Waits] AS [W1]
	INNER JOIN [Waits] AS [W2]
	    ON [W2].[RowNum] <= [W1].[RowNum]
	GROUP BY [W1].[RowNum], [W1].[wait_type], [W1].[WaitS],
	    [W1].[ResourceS], [W1].[SignalS], [W1].[WaitCount], [W1].[Percentage]
	HAVING SUM ([W2].[Percentage]) - [W1].[Percentage] < 95 -- percentage drempel
)
SELECT [WaitType]
      ,MAX([Wait_S]) as [Wait_S]
      ,MAX([Resource_S]) as [Resource_S]
      ,MAX([Signal_S]) as [Signal_S]
      ,MAX([WaitCount]) as [WaitCount]
      ,MAX([Percentage]) as [Percentage]
      ,MAX([AvgWait_S]) as [AvgWait_S]
      ,MAX([AvgRes_S]) as [AvgRes_S]
      ,MAX([AvgSig_S]) as [AvgSig_S]
  FROM ress
  group by [WaitType];
In dit geval kan het tekort aan RAM-geheugen worden vastgesteld met de volgende query:
SELECT [Percentage]
      ,[AvgWait_S]
  FROM [inf].[vWaits]
  where [WaitType] in (
    'PAGEIOLATCH_XX',
    'RESOURCE_SEMAPHORE',
    'RESOURCE_SEMAPHORE_QUERY_COMPILE'
  );
Hier moet gelet worden op de waarden Percentage en AvgWait_S. Als ze in hun samenhang aanzienlijk zijn, is de kans groot dat de MS SQL Server instance onvoldoende RAM-geheugen heeft. Wat als aanzienlijke waarden wordt beschouwd, hangt af van elk specifiek systeem. Een goed startpunt is echter de volgende drempel: Percentage >= 1 en AvgWait_S >= 0.005.
Voor het naar de monitoring systeem (bijvoorbeeld Zabbix) verzenden van gegevens, kunnen de volgende twee queries worden aangemaakt:
- hoeveel procent de verschillende soorten wachten op RAM innemen (totaal van alle dergelijke wachttypes):
select coalesce(sum([Percentage]), 0.00) as [Percentage] from [inf].[vWaits] where [WaitType] in ( 'PAGEIOLATCH_XX', 'RESOURCE_SEMAPHORE', 'RESOURCE_SEMAPHORE_QUERY_COMPILE' ); - hoeveel milliseconden de verschillende soorten wachten op RAM innemen (de grootste waarde van alle gemiddelde vertragingen voor alle dergelijke wachttypes):
select coalesce(max([AvgWait_S])*1000, 0.00) as [AvgWait_MS]
from [inf].[vWaits]
       where [WaitType] in (
            'PAGEIOLATCH_XX',
            'RESOURCE_SEMAPHORE',
            'RESOURCE_SEMAPHORE_QUERY_COMPILE'
  );
Op basis van de dynamiek van de verkregen waarden voor deze twee indicatoren kan worden geconcludeerd of er voldoende RAM-geheugen is voor de MS SQL Server instance.
Methode voor het identificeren van overmatige belasting van de CPU
Om een tekort aan processor tijd vast te stellen, kan het systeemzicht sys.dm_os_schedulers worden gebruikt. Hier, als de waarde van runnable_tasks_count constant groter is dan 1, bestaat de grote kans dat het aantal kernen niet voldoende is voor de MS SQL Server instance.
Voor het naar de monitoring systeem (bijvoorbeeld Zabbix) verzenden van de waarde, kan de volgende query worden aangemaakt:
select max([runnable_tasks_count]) as [runnable_tasks_count]
from sys.dm_os_schedulers
where scheduler_id < 255;
Op basis van de dynamiek van de verkregen waarden voor deze indicator kan worden geconcludeerd of er voldoende processor tijd (aantal CPU-kernen) is voor de MS SQL Server instance.
Het is echter belangrijk om te onthouden dat de aanvragen meerdere threads tegelijk kunnen aanvragen. Soms kan de optimizer de complexiteit van de aanvraag niet correct inschatten. In dat geval kunnen er te veel threads aan de aanvraag worden toegewezen, die op dat moment niet gelijktijdig kunnen worden verwerkt. Dit veroorzaakt ook een wachttype dat verband houdt met een tekort aan CPU-tijd en een groeiende wachtrij voor schedulers die specifieke CPU-kernen gebruiken. Hierdoor zal de indicator runnable_tasks_count in dergelijke omstandigheden toenemen.
In dat geval moet, voordat je het aantal CPU-kernen verhoogt, de eigenschap van parallelisme van de MS SQL Server-instantie correct worden ingesteld, en voor versies vanaf 2016 moeten de parallelisme-eigenschappen van de benodigde databases ook goed worden ingesteld:
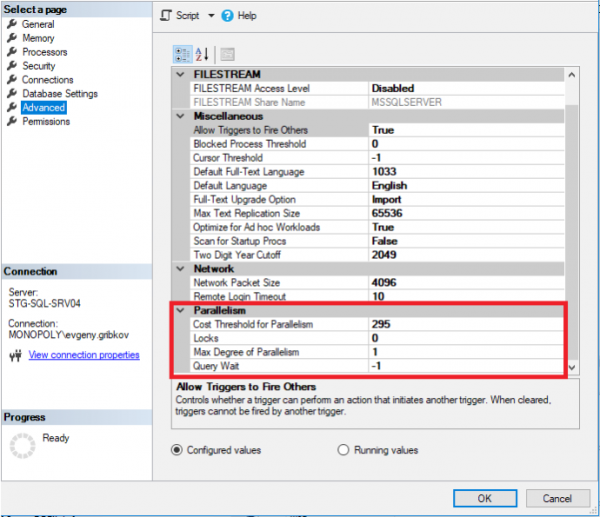
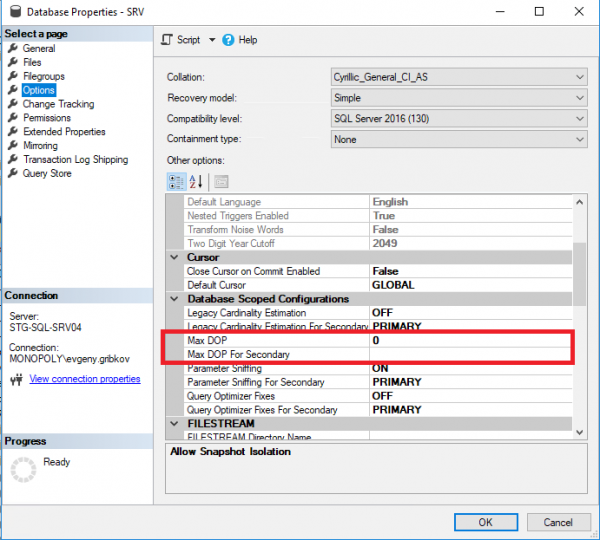
Hierbij moet je letten op de volgende parameters:
- Max Degree of Parallelism stelt het maximale aantal threads in dat aan elke aanvraag kan worden toegewezen (standaard is dit 0 - de beperking ligt alleen bij het besturingssysteem en de editie van MS SQL Server).
- Cost Threshold for Parallelism - de geschatte kosten voor parallelisme (standaard is dit 5).
- Max DOP stelt het maximale aantal threads in dat aan elke aanvraag op het database-niveau kan worden toegewezen (maar niet meer dan de waarde van de eigenschap 'Max Degree of Parallelism') (standaard is dit 0 - de beperking ligt alleen bij het besturingssysteem en de editie van MS SQL Server, evenals de beperking van de eigenschap 'Max Degree of Parallelism' van de gehele MS SQL Server-instantie).
Hier is het onmogelijk om een uniform recept voor alle gevallen te geven, wat betekent dat zware aanvragen geanalyseerd moeten worden.
Uit eigen ervaring raad ik het volgende algoritme aan voor OLTP-systemen voor het instellen van de eigenschappen van parallelisme:
- verplicht eerst parallelisme uit te schakelen door het niveau van de gehele instantie Max Degree of Parallelism op 1 in te stellen.
- analyseer de zwaarste aanvragen en bepaal het optimale aantal threads voor hen.
- stel Max Degree of Parallelism in op het optimale aantal threads dat is verkregen in punt 2, en stel ook voor specifieke databases de Max DOP-waarde in die is verkregen in punt 2 voor elke database.
- analyseer de zwaarste aanvragen en identificeer de negatieve effecten van multithreading. Als deze er zijn, verhoog dan de Cost Threshold for Parallelism.
Voor systemen zoals 1C, Microsoft CRM en Microsoft NAV is het in de meeste gevallen voldoende om multithreading uit te schakelen.
Als de Standard-editie is geïnstalleerd, is in de meeste gevallen een beperking van multi-threading geschikt, vanwege het feit dat deze editie beperkt is in het aantal CPU-kernen.
Voor OLAP-systemen is het bovenstaande algoritme niet geschikt.
Op basis van mijn eigen ervaring raad ik het volgende stappenplan aan voor het instellen van parallelisme-eigenschappen in OLAP-systemen:
- analyseer de zwaarste aanvragen en bepaal het optimale aantal threads voor hen.
- stel de Max Degree of Parallelism in op een optimaal aantal threads, zoals verkregen in punt 1, en stel bovendien de Max DOP-waarde die uit punt 1 is verkregen in voor specifieke databases in.
- analyseer de zwaarste aanvragen en identificeer de negatieve effecten die voortkomen uit de beperking van parallelisme. Als deze er zijn, verlaag dan de waarde van Cost Threshold for Parallelism of herhaal stappen 1-2 van dit algoritme.
Dus voor OLTP-systemen gaan we van single-thread naar multi-threading, terwijl we voor OLAP-systemen omgekeerd van multi-thread naar single-thread gaan. Op deze manier kan een optimale configuratie voor parallelisme worden gekozen, zowel voor een specifieke database als voor de gehele MS SQL Server-instantie.
Het is ook belangrijk te beseffen dat de instellingen voor parallelisme-eigenschappen in de loop van de tijd moeten worden aangepast, gebaseerd op de resultaten van de prestaties van MS SQL Server.
Aanbevelingen voor het instellen van traceerflags.
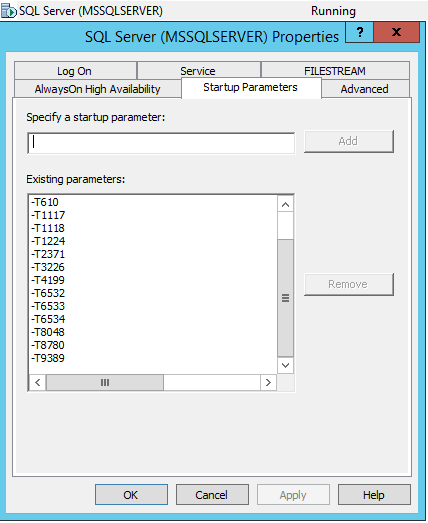
Op basis van mijn eigen ervaring en die van mijn collega's raad ik aan voor een optimale werking de volgende traceerflags in te stellen op het niveau van het starten van de MS SQL Server-dienst voor de versies 2008-2016:
- 610 — Vermindert het loggen van invoegingen in indexeertabellen. Dit kan nuttig zijn voor tabellen met een groot aantal records en vele transacties, bij frequente lange wachttijden bij WRITELOG door wijzigingen in indexen.
- 1117 — Als een bestand in de bestandsgroep voldoet aan de vereisten voor automatische vergrotingsdrempel, worden alle bestanden in de bestandsgroep vergroot.
- 1118 — Zorgt ervoor dat alle objecten in verschillende extents worden geplaatst (verboden gemengde extents), wat de noodzaak van het scannen van de SGAM-pagina minimaliseert, die wordt gebruikt voor het bijhouden van gemengde extents.
- 1224 — Schakelt het samenvoegen van vergrendelingen uit op basis van het aantal vergrendelingen. Echter, te actief geheugenverbruik kan het samenvoegen van vergrendelingen weer inschakelen.
- 2371 — Wijzigt de drempel voor vaste automatische statistiekenupdates naar de drempel voor dynamische automatische statistiekenupdates. Belangrijk voor het bijwerken van queryplannen met betrekking tot grote tabellen, waar een verkeerde bepaling van het aantal records leidt tot onjuiste uitvoeringsplannen.
- 3226 — Onderdrukt berichten over succesvolle back-ups in het foutlogboek.
- 4199 — Schakelt wijzigingen in de query-optimalisator in die zijn uitgebracht in cumulatieve updates en SQL Server-updates.
- 6532-6534 — Schakelt prestatieverbeteringen in voor query-operaties met ruimtelijke datatypen.
- 8048 — Zet NUMA-gepartitioneerde geheugenobjecten om naar CPU-gepartitioneerde geheugenobjecten.
- 8780 — Schakelt extra tijd in voor het opstellen van het queryplan. Sommige queries kunnen zonder deze vlag worden afgewezen omdat ze geen queryplan hebben (een zeer zeldzame fout).
- 8780 — 9389 — Schakelt een extra dynamisch tijdelijk toegewezen geheugenbuffer in voor batchmodusoperators, waardoor de batchmodusoperator extra geheugen kan aanvragen en gegevensoverdracht naar tempdb kan vermijden als extra geheugen beschikbaar is.
Tot versie 2016 is het ook nuttig om trace-vlag 2301 in te schakelen, die optimalisatie voor uitgebreide besluitvorming inschakelt en zo helpt bij het kiezen van betere queryplannen. Vanaf versie 2016 heeft het echter vaak een negatief effect op de totale uitvoeringstijd van queries.
Voor systemen met veel indexen (bijvoorbeeld voor 1C-databases) raad ik ook aan om trace-vlag 2330 in te schakelen, die het verzamelen van indexgebruik uitschakelt, wat over het algemeen gunstig is voor het systeem.
Meer gedetailleerde informatie over trace-vlaggen is beschikbaar.
Bij de bovenstaande link is het ook belangrijk om de versies en builds van MS SQL Server in overweging te nemen, aangezien voor nieuwere versies sommige trace-vlaggen standaard zijn ingeschakeld of geen effect hebben.
Trace-vlaggen kunnen worden in- en uitgeschakeld met de commando's DBCC TRACEON en DBCC TRACEOFF. Voor meer details zie.
De status van trace-vlaggen kan worden verkregen met het commando DBCC TRACESTATUS:
Om trace-vlaggen in de automatische opstart van de MS SQL Server-service op te nemen, moet je naar de SQL Server Configuration Manager gaan en in de eigenschappen van de service de trace-vlaggen toevoegen via -T:
Conclusies
In dit artikel zijn enkele aspecten van het monitoren van MS SQL Server besproken, waarmee je snel het gebrek aan RAM en CPU-tijd kunt identificeren, evenals een aantal andere minder voor de hand liggende problemen. De meest gebruikte trace-vlaggen zijn behandeld.
Bronnen:
»
»
»
»
»
»
»
Bron: habr.com
