

LINQ is introduced in .NET as a powerful new language for data manipulation. LINQ to SQL, as part of it, allows for convenient interaction with databases using tools like Entity Framework. However, developers often overlook the actual SQL query that the queryable provider, in this case, Entity Framework, will generate.
Let's break down two main points using an example.
For this, we will create a database named Test in SQL Server, and within it, we will create two tables using the following query:
Tabellen aanmaken
USE [TEST]
GO

SET ANSI_NULLS ON
GO

SET QUOTED_IDENTIFIER ON
GO

CREATE TABLE [dbo].[Ref](
	[ID] [int] NOT NULL,
	[ID2] [int] NOT NULL,
	[Name] [nvarchar](255) NOT NULL,
	[InsertUTCDate] [datetime] NOT NULL,
 CONSTRAINT [PK_Ref] PRIMARY KEY CLUSTERED
(
	[ID] ASC
)WITH (PAD_INDEX = OFF, STATISTICS_NORECOMPUTE = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS = ON, ALLOW_PAGE_LOCKS = ON) ON [PRIMARY]
) ON [PRIMARY]
GO

ALTER TABLE [dbo].[Ref] ADD  CONSTRAINT [DF_Ref_InsertUTCDate]  DEFAULT (getutcdate()) FOR [InsertUTCDate]
GO

USE [TEST]
GO

SET ANSI_NULLS ON
GO

SET QUOTED_IDENTIFIER ON
GO

CREATE TABLE [dbo].[Customer](
	[ID] [int] NOT NULL,
	[Name] [nvarchar](255) NOT NULL,
	[Ref_ID] [int] NOT NULL,
	[InsertUTCDate] [datetime] NOT NULL,
	[Ref_ID2] [int] NOT NULL,
 CONSTRAINT [PK_Customer] PRIMARY KEY CLUSTERED
(
	[ID] ASC
)WITH (PAD_INDEX = OFF, STATISTICS_NORECOMPUTE = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS = ON, ALLOW_PAGE_LOCKS = ON) ON [PRIMARY]
) ON [PRIMARY]
GO

ALTER TABLE [dbo].[Customer] ADD  CONSTRAINT [DF_Customer_Ref_ID]  DEFAULT ((0)) FOR [Ref_ID]
GO

ALTER TABLE [dbo].[Customer] ADD  CONSTRAINT [DF_Customer_InsertUTCDate]  DEFAULT (getutcdate()) FOR [InsertUTCDate]
GO
Now we will populate the Ref table by executing the following script:
Populating the Ref table
USE [TEST]
GO

DECLARE @ind INT=1;

WHILE(@ind<1200000)
BEGIN
	INSERT INTO [dbo].[Ref]
           ([ID]
           ,[ID2]
           ,[Name])
    SELECT
           @ind
           ,@ind
           ,CAST(@ind AS NVARCHAR(255));

	SET @ind=@ind+1;
END
GO
Similarly, we will populate the Customer table using the following script:
Populating the Customer table
GEbruik [TEST]
GA

DECLARE @ind INT=1;
DECLARE @ind_ref INT=1;

TERWIJL(@ind<=12000000)
BEGIN
	IF(@ind%3=0) SET @ind_ref=1;
	ELSE IF (@ind%5=0) SET @ind_ref=2;
	ELSE IF (@ind%7=0) SET @ind_ref=3;
	ELSE IF (@ind=0) SET @ind_ref=4;
	ELSE IF (@ind=0) SET @ind_ref=5;
	ELSE IF (@ind=0) SET @ind_ref=6;
	ELSE IF (@ind=0) SET @ind_ref=7;
	ELSE IF (@ind=0) SET @ind_ref=8;
	ELSE IF (@ind=0) SET @ind_ref=9;
	ELSE IF (@ind=0) SET @ind_ref=10;
	ELSE IF (@ind=0) SET @ind_ref=11;
	ELSE SET @ind_ref=@ind90000;

	INSERT INTO [dbo].[Customer]
	 ([ID]
	 ,[Name]
	 ,[Ref_ID]
	 ,[Ref_ID2])
	 SELECT
	 @ind,
	 CAST(@ind AS NVARCHAR(255)),
	 @ind_ref,
	 @ind_ref;


	SET @ind=@ind+1;
END
GA
Thus, we have obtained two tables, one containing over 1 million rows of data, and the other over 10 million rows of data.
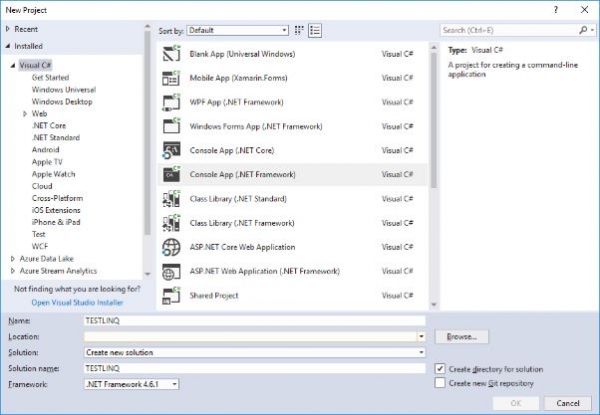
Now in Visual Studio, you need to create a test project Visual C# Console App (.NET Framework):
Next, you need to add a library for Entity Framework for database interaction.
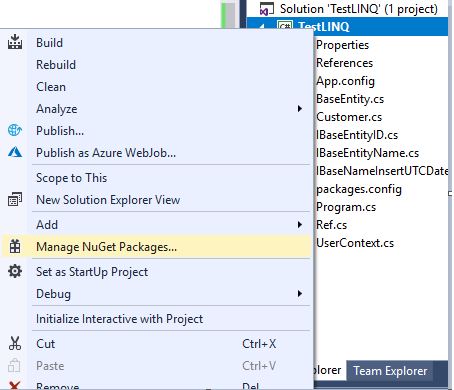
Om dit toe te voegen, klikken we met de rechtermuisknop op het project en kiezen we in het contextmenu voor Beheer NuGet-pakketten:
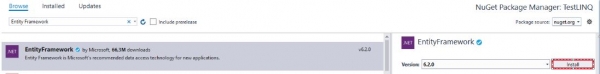
Voer vervolgens in het geopende venster voor het beheren van NuGet-pakketten het woord «Entity Framework» in het zoekvenster in en selecteer het Entity Framework-pakket om het te installeren:
Vervolgens moeten we in het bestand App.config na de sluiting van het element configSections de volgende sectie toevoegen:
In de connectionString moet de verbindingsreeks worden ingevuld.
Laten we nu in aparte bestanden 3 interfaces aanmaken:
- Implementatie van de interface IBaseEntityID
namespace TestLINQ { public interface IBaseEntityID { int ID { get; set; } } } - Implementatie van de interface IBaseEntityName
namespace TestLINQ { public interface IBaseEntityName { string Name { get; set; } } } - Implementatie van de interface IBaseNameInsertUTCDate
namespace TestLINQ
{
    public interface IBaseNameInsertUTCDate
    {
        DateTime InsertUTCDate { get; set; }
    }
}
En in een apart bestand creëren we de basisklasse BaseEntity voor onze twee entiteiten, waarin de gemeenschappelijke velden worden opgenomen:
Implementatie van de basisklasse BaseEntity
namespace TestLINQ
{
    public class BaseEntity : IBaseEntityID, IBaseEntityName, IBaseNameInsertUTCDate
    {
        public int ID { get; set; }
        public string Name { get; set; }
        public DateTime InsertUTCDate { get; set; }
    }
}
Vervolgens maken we in aparte bestanden onze twee entiteiten aan:
- Implementatie van de klasse Ref
using System.ComponentModel.DataAnnotations.Schema; namespace TestLINQ { [Table("Ref")] public class Ref : BaseEntity { public int ID2 { get; set; } } } - Implementatie van de klasse Customer
using System.ComponentModel.DataAnnotations.Schema;

namespace TestLINQ
{
    [Table("Customer")]
    public class Customer: BaseEntity
    {
        public int Ref_ID { get; set; }
        public int Ref_ID2 { get; set; }
    }
}
Laten we nu in een apart bestand de context UserContext aanmaken:
Implementatie van de klasse UserContext
using System.Data.Entity;

namespace TestLINQ
{
    public class UserContext : DbContext
    {
        public UserContext()
            : base("DbConnection")
        {
            Database.SetInitializer(null);
        }

        public DbSet Customer { get; set; }
        public DbSet Ref { get; set; }
    }
}
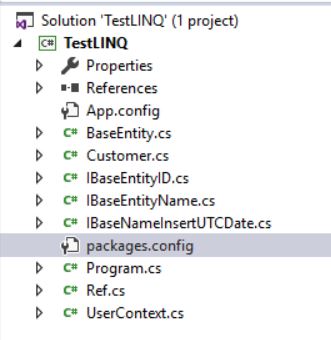
We hebben een kant-en-klare oplossing gekregen voor het uitvoeren van optimalisatietests met LINQ to SQL via EF voor MS SQL Server:
Laten we nu de volgende code in het bestand Program.cs invoeren:
Bestand Program.cs
using System;
using System.Collections.Generic;
using System.Linq;

namespace TestLINQ
{
    class Program
    {
        static void Main(string[] args)
        {
            using (UserContext db = new UserContext())
            {
                var dblog = new List();
                db.Database.Log = dblog.Add;

                var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                 && (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };

                var result = query.Take(1000).ToList();

                Console.WriteLine(dblog[1]);

                Console.ReadKey();
            }
        }
    }
}
Laten we ons project nu starten.
Aan het einde van de uitvoering zal op de console worden weergegeven:
De gegenereerde SQL-query
SELECT TOP (1000)
    [Extent1].[Ref_ID] AS [Ref_ID],
    [Extent1].[Name] AS [Name],
    [Extent2].[Name] AS [Name1]
    FROM  [dbo].[Customer] AS [Extent1]
    INNER JOIN [dbo].[Ref] AS [Extent2] ON ([Extent1].[Ref_ID] = [Extent2].[ID]) AND ([Extent1].[Ref_ID2] = [Extent2].[ID2])
Met andere woorden, de LINQ-query heeft een behoorlijk goede SQL-query naar de MS SQL Server gegenereerd.
Laten we nu de AND-voorwaarde in de LINQ-query veranderen naar OR:
LINQ-query
var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                || (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };
En laten we onze applicatie opnieuw starten.
De uitvoering zal met een fout eindigen die verband houdt met een time-out van 30 seconden:
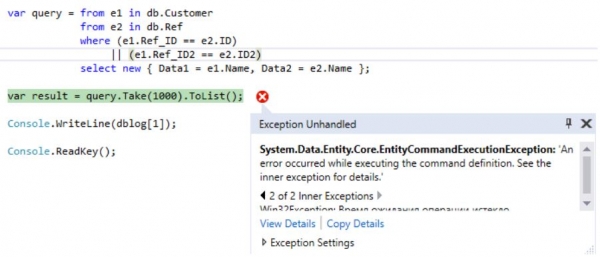
Als we kijken naar welke query LINQ in dit geval heeft gegenereerd:
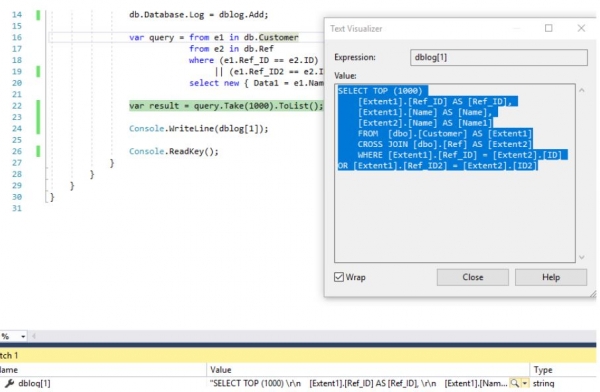
, dan kunnen we bevestigen dat de selectie plaatsvindt door het cartesisch product van twee verzamelingen (tabellen):
De gegenereerde SQL-query
SELECT TOP (1000)
    [Extent1].[Ref_ID] AS [Ref_ID],
    [Extent1].[Name] AS [Name],
    [Extent2].[Name] AS [Name1]
    FROM  [dbo].[Customer] AS [Extent1]
    CROSS JOIN [dbo].[Ref] AS [Extent2]
    WHERE [Extent1].[Ref_ID] = [Extent2].[ID] OR [Extent1].[Ref_ID2] = [Extent2].[ID2]
Laten we de LINQ-query als volgt herschrijven:
Geoptimaliseerde LINQ-query
var query = (from e1 in db.Customer
                   join e2 in db.Ref
                   on e1.Ref_ID equals e2.ID
                   select new { Data1 = e1.Name, Data2 = e2.Name }).Union(
                        from e1 in db.Customer
                        join e2 in db.Ref
                        on e1.Ref_ID2 equals e2.ID2
                        select new { Data1 = e1.Name, Data2 = e2.Name });
We krijgen dan de volgende SQL-query:
SQL-query
SELECT
    [Limit1].[C1] AS [C1],
    [Limit1].[C2] AS [C2],
    [Limit1].[C3] AS [C3]
    FROM ( SELECT DISTINCT TOP (1000)
        [UnionAll1].[C1] AS [C1],
        [UnionAll1].[Name] AS [C2],
        [UnionAll1].[Name1] AS [C3]
        FROM  (SELECT
            1 AS [C1],
            [Extent1].[Name] AS [Name],
            [Extent2].[Name] AS [Name1]
            FROM  [dbo].[Customer] AS [Extent1]
            INNER JOIN [dbo].[Ref] AS [Extent2] ON [Extent1].[Ref_ID] = [Extent2].[ID]
        UNION ALL
            SELECT
            1 AS [C1],
            [Extent3].[Name] AS [Name],
            [Extent4].[Name] AS [Name1]
            FROM  [dbo].[Customer] AS [Extent3]
            INNER JOIN [dbo].[Ref] AS [Extent4] ON [Extent3].[Ref_ID2] = [Extent4].[ID2]) AS [UnionAll1]
    )  AS [Limit1]
Helaas kan er maar één join-voorwaarde zijn in LINQ-queries, daarom is het mogelijk om een equivalente query te maken door twee queries voor elke voorwaarde te doen en deze vervolgens samen te voegen via Union om dubbele rijen te verwijderen.
Ja, de queries zullen in het algemeen niet equivalent zijn, aangezien volledige dubbele rijen kunnen worden teruggegeven. In de praktijk zijn volledige dubbele rijen echter niet nodig en proberen we deze te verwijderen.
Laten we nu de uitvoeringsplannen van deze twee queries vergelijken:
- voor CROSS JOIN is de gemiddelde uitvoeringstijd 195 sec:

- voor INNER JOIN-UNION is de gemiddelde uitvoeringstijd minder dan 24 sec:

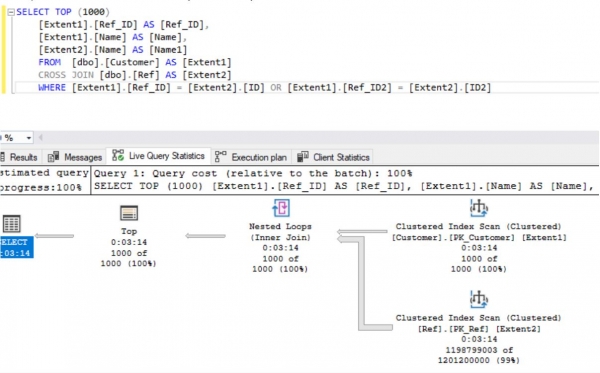
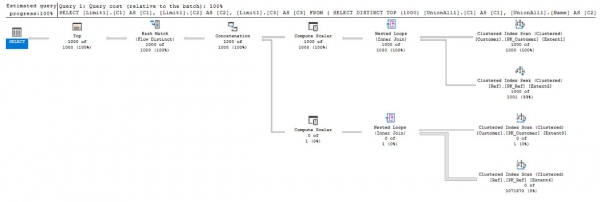
Uit de resultaten blijkt dat de geoptimaliseerde LINQ-query voor twee tabellen met miljoenen records veel sneller werkt dan de niet-geoptimaliseerde.
Voor de optie met AND in de LINQ-query van het type:
LINQ-query
var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                 && (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };
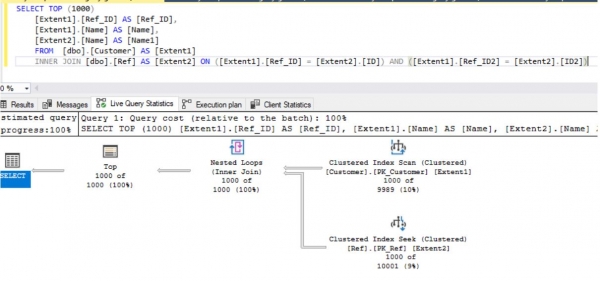
zal bijna altijd de juiste SQL-query worden gegenereerd, die gemiddeld ongeveer 1 sec duurt:
Ook voor manipulaties in LINQ to Objects in plaats van een query van het type:
LINQ-query (eerste variant)
var query = from e1 in seq1
                            from e2 in seq2
                            where (e1.Key1==e2.Key1)
                               && (e1.Key2==e2.Key2)
                            select new { Data1 = e1.Data, Data2 = e2.Data };
kan een query van het type worden gebruikt:
LINQ-query (tweede variant)
var query = from e1 in seq1
                            join e2 in seq2
                            on new { e1.Key1, e1.Key2 } equals new { e2.Key1, e2.Key2 }
                            select new { Data1 = e1.Data, Data2 = e2.Data };
waarbij:
Definitie van twee arrays
Para[] seq1 = new[] { new Para { Key1 = 1, Key2 = 2, Data = "777" }, new Para { Key1 = 2, Key2 = 3, Data = "888" }, new Para { Key1 = 3, Key2 = 4, Data = "999" } };
Para[] seq2 = new[] { new Para { Key1 = 1, Key2 = 2, Data = "777" }, new Para { Key1 = 2, Key2 = 3, Data = "888" }, new Para { Key1 = 3, Key2 = 5, Data = "999" } };
, en het type Para wordt als volgt gedefinieerd:
Definitie van het type Para
class Para
{
        public int Key1, Key2;
        public string Data;
}
Zo hebben we verschillende aspecten van de optimalisatie van LINQ-queries voor MS SQL Server besproken.
Helaas vergeten zelfs ervaren en toonaangevende .NET-ontwikkelaars dat het noodzakelijk is om te begrijpen wat er achter de schermen gebeurt met de instructies die ze gebruiken. Anders worden ze configuratoren en kunnen ze een tijdgeconfigureerde bom leggen, zowel bij de opschaling van de softwareoplossing als bij kleine wijzigingen in de omgevingsomstandigheden.
Er werd ook een kleine review uitgevoerd en .
De bronbestanden voor de test – het project zelf, het creëren van tabellen in de database TEST, evenals het vullen van deze tabellen met gegevens bevindt zich .
Daarnaast bevinden er zich in deze repository in de map Plans plannen voor het uitvoeren van verzoeken met de voorwaarden OF.
Bron: habr.com
