

Tijdens de overgang van een monolithische applicatie naar een microservices-architectuur stuiten we op nieuwe problemen.
In een monolithische applicatie is het meestal voldoende om eenvoudig te bepalen in welk onderdeel van het systeem de fout is opgetreden. Waarschijnlijk ligt het probleem in de code van de monoliet zelf of in de database. Maar wanneer we beginnen met het zoeken naar het probleem in een microservices-architectuur, is het niet meer zo vanzelfsprekend. We moeten de hele weg vinden die het verzoek heeft afgelegd van begin tot eind, en deze isoleren uit honderden microservices. Bovendien hebben veel van deze microservices ook hun eigen opslag, waar zowel logische fouten als problemen met prestaties en beschikbaarheid kunnen optreden.
Ik heb lang gezocht naar een tool die zou helpen bij het omgaan met dergelijke problemen (ik schreef hierover op Habr: , ), maar uiteindelijk heb ik mijn eigen open-source oplossing gemaakt. In dit artikel bespreek ik de voordelen van de service mesh-aanpak en deel ik een nieuwe tool voor de implementatie ervan.
Gedistrubueerde tracing is een veelvoorkomende oplossing voor het probleem van het vinden van fouten in gedistribueerde systemen. Maar wat als er in het systeem nog geen dergelijke aanpak is geïmplementeerd voor het verzamelen van informatie over netwerkinteracties, of, wat erger is, als het in een deel van het systeem al goed functioneert, maar in een ander deel niet, omdat het niet is toegevoegd aan de oudere services? Om de exacte oorzaak van het probleem te bepalen, is het noodzakelijk om een volledig beeld te hebben van wat er in het systeem gebeurt. Het is vooral belangrijk om te begrijpen welke microservices betrokken zijn bij de belangrijkste, kritieke bedrijfsprocessen.
Hier kan de service mesh-aanpak ons helpen, die de hele machinewerking voor het verzamelen van netwerkinformatie op een lager niveau beheert dan de services zelf werken. Deze aanpak stelt ons in staat om al het verkeer te onderscheppen en dit in real-time te analyseren. Bovendien hoeven de applicaties er niets van te weten.
Service mesh aanpak
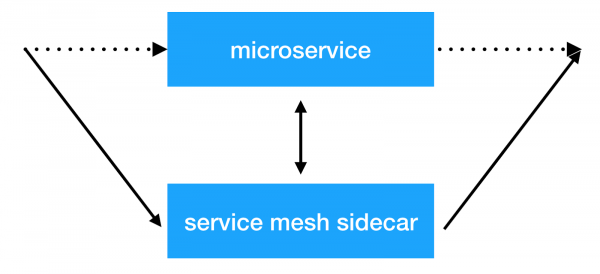
Het belangrijkste idee achter de service mesh aanpak is het toevoegen van een extra infrastructuurlag boven op het netwerk, waardoor we alles kunnen doen met de interactie tussen microservices. De meeste implementaties werken als volgt: aan elke microservice wordt een extra sidecar-container toegevoegd met een transparante proxy, waardoor al het binnenkomende en uitgaande verkeer van de service gaat. Dit is de plek waar we client-side load balancing kunnen uitvoeren, beveiligingsbeleid kunnen toepassen, beperkingen op het aantal verzoeken kunnen invoeren en belangrijke informatie over de interacties van services in productie kunnen verzamelen.
Oplossingen
Er zijn al verschillende implementaties van deze aanpak: en . Ze bieden veel mogelijkheden out-of-the-box. Maar tegelijkertijd komt er ook een grote overhead aan middelen bij kijken. Hoe groter het cluster waarin zo'n systeem draait, hoe meer middelen er nodig zijn om de nieuwe infrastructuur te onderhouden. Bij Avito exploiteren we Kubernetes-clusters met duizenden exemplaren van services (en dat aantal blijft snel groeien). In de huidige implementatie verbruikt Istio ongeveer 300 Mb RAM per service-exemplaar. Vanwege het grote aantal mogelijkheden heeft transparante load balancing ook invloed op de totale responstijd van de services (tot 10 ms).
Uiteindelijk hebben we gekeken naar welke mogelijkheden we op dit moment nodig hebben en besloten dat de belangrijkste reden waarom we dergelijke oplossingen zijn gaan implementeren, de mogelijkheid was om tracinginformatie uit het hele systeem transparant te verzamelen. Ook wilden we controle hebben over de interactie tussen services en verschillende manipulaties met de headers uitvoeren die tussen de services worden verzonden.
Uiteindelijk zijn we tot onze oplossing gekomen: .
Netramesh
— dit is een lichtgewicht service mesh oplossing met de mogelijkheid tot oneindige schaalbaarheid, ongeacht het aantal services in het systeem.
De belangrijkste doelen van de nieuwe oplossing waren een lage resource overhead en een hoge prestaties. Van de belangrijkste mogelijkheden wilden we onmiddellijk de mogelijkheid hebben om tracing spans transparant naar ons Jaeger-systeem te verzenden.
Tegenwoordig worden de meeste cloudoplossingen gerealiseerd in Golang. En natuurlijk zijn er goede redenen voor. Het schrijven van netwerken in Golang die asynchroon werken met invoer-uitvoer en die naar behoefte kunnen schalen op de cores, is handig en relatief eenvoudig. En wat ook zeer belangrijk is, de prestaties zijn voldoende om deze taak uit te voeren. Daarom hebben wij ook voor Golang gekozen.
Prestaties
We hebben onze inspanningen gericht op het bereiken van maximale prestaties. Voor een oplossing die naast elke service-instantie wordt gedeployed, is een laaggeheugen- en CPU-verbruik noodzakelijk. En natuurlijk moet de responstijd ook minimaal zijn.
Laten we eens kijken naar de resultaten die we hebben behaald.
RAM
Netramesh verbruikt ongeveer 10 MB zonder verkeer en maximaal 50 MB met een belasting tot 10000 RPS op één instantie.
Istio envoy proxy verbruikt altijd ongeveer 300 MB in onze clusters met duizenden instanties. Dit maakt het onmogelijk om het over het hele cluster te schalen.
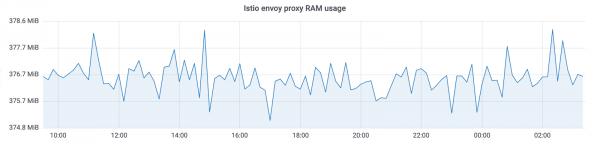
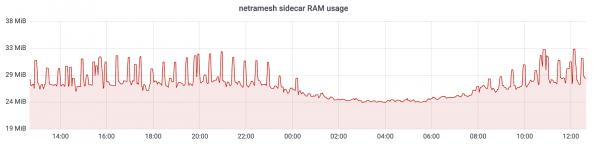
Met Netramesh hebben we het geheugengebruik met ongeveer 10 keer verminderd.
CPU
Het CPU-gebruik is relatief gelijk onder belasting. Het hangt af van het aantal verzoeken per tijdseenheid naar de sidecar. Waarden bij 3000 verzoeken per seconde op het piekmoment:
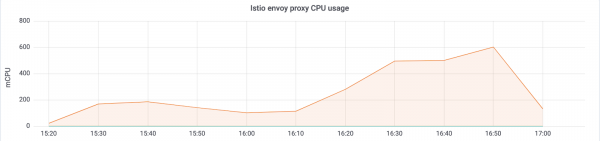
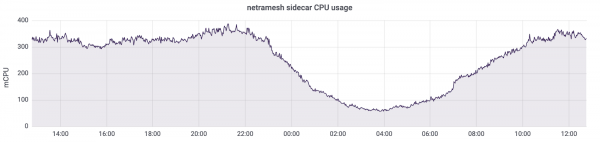
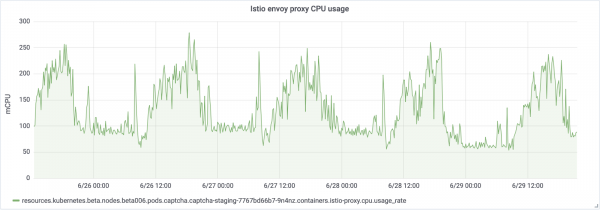
Er is nog een belangrijk punt: Netramesh is een oplossing zonder control plane en verbruikt geen CPU-tijd zonder belasting. Bij Istio updaten de sidecars altijd de endpoints van de services. Uiteindelijk kunnen we de volgende situatie zonder belasting zien:
We gebruiken HTTP/1 voor interactie tussen services. De verlenging van de responstijd bij Istio tijdens proxying via envoy was tot 5-10 ms, wat vrij veel is voor services die binnen een milliseconde willen antwoorden. Met Netramesh is deze tijd verminderd tot 0,5-2 ms.
Schaalbaarheid
De kleine hoeveelheid bronnen die door elke proxy wordt verbruikt, maakt het mogelijk om deze naast elke service te plaatsen. Netramesh is opzettelijk zonder control plane-component ontworpen om de lichtheid van elke sidecar eenvoudig te onderhouden. Vaak in service mesh-oplossingen verspreidt de control plane service discovery-informatie naar elke sidecar. Samen met deze informatie komen ook timeout-instellingen en load balancing-instellingen. Dit stelt ons in staat om veel nuttige dingen te doen, maar helaas zorgt het voor een grotere omvang van de sidecars.
Service discovery

Netramesh voegt geen extra mechanismen toe voor service discovery. Al het verkeer wordt transparant geproxy'd via de netra sidecar.
Netramesh ondersteunt het HTTP/1-toepassingsprotocol. Voor de definitie wordt een configureerbare lijst van poorten gebruikt. Gewoonlijk zijn er in het systeem meerdere poorten waarmee de communicatie via HTTP plaatsvindt. Bijvoorbeeld, voor de interactie tussen services en externe verzoeken gebruiken we 80, 8890, 8080. In dat geval kunnen ze worden ingesteld met behulp van een omgevingsvariabele. NETRA_HTTP_PORTS.
Als je Kubernetes als orchestrator gebruikt en zijn Service-entiteitenmechanisme voor intra-cluster interactie tussen services, blijft het mechanisme precies hetzelfde. Eerst verkrijgt de microservice het service-IP-adres via kube-dns en opent een nieuwe verbinding ermee. Deze verbinding wordt eerst ingesteld met de lokale netra-sidecar en alle TCP-pakketten komen in eerste instantie binnen in netra. Vervolgens stelt de netra-sidecar de verbinding in met het oorspronkelijke bestemmingspunt. NAT op pod-IP op de node blijft precies hetzelfde als zonder netra.
Gedstribueerde tracing en contextdoorpassing
Netramesh biedt functionaliteit voor het verzenden van tracing spans over HTTP-interacties. De netra-sidecar parseert het HTTP-protocol, meet de latencies van aanvragen en haalt de benodigde informatie uit de HTTP-header. Uiteindelijk krijgen we al onze traces in één enkele Jaeger-systeem. Voor fijne configuratie kunnen ook omgevingsvariabelen worden gebruikt die de officiële bibliotheek biedt. .
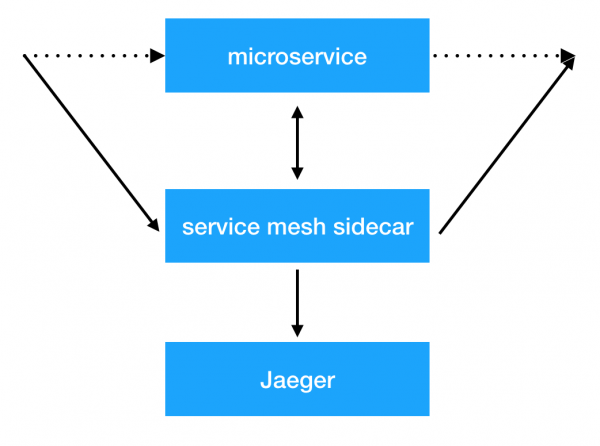
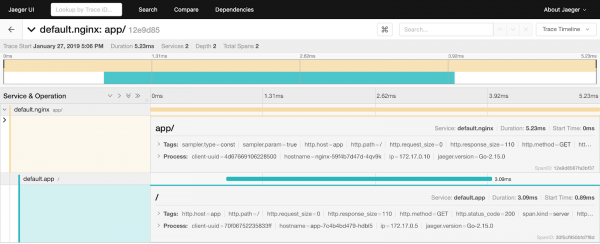
Maar er is een probleem. Totdat services een speciale uber-header genereren en doorgeven, zullen we de verbonden tracing spans in het systeem niet zien. En dat is wat we nodig hebben voor een snelle zoekactie naar de oorzaak van problemen. Hier heeft Netramesh opnieuw een oplossing. De proxy's lezen de HTTP-headers en, als ze geen uber trace-id bevatten, genereren ze deze. Netramesh slaat ook informatie op over binnenkomende en uitgaande verzoeken in de sidecar en koppelt ze door de benodigde headers aan de uitgaande verzoeken toe te voegen. Alles wat nodig is in de services, is om slechts één header door te geven. X-Request-Id, die kan worden geconfigureerd met een omgevingsvariabele. NETRA_HTTP_REQUEST_ID_HEADER_NAME. Voor het beheer van de contextgrootte in Netramesh kunnen de volgende omgevingsvariabelen worden ingesteld: NETRA_TRACING_CONTEXT_EXPIRATION_MILLISECONDS (de tijdsduur waarin de context zal worden bewaard) en NETRA_TRACING_CONTEXT_CLEANUP_INTERVAL (de frequentie van contextopruiming).
Het is ook mogelijk om meerdere paden in uw systeem te combineren door ze te markeren met een speciale sessiemarker. Netra maakt het mogelijk om HTTP_HEADER_TAG_MAP om HTTP-headers om te zetten in de overeenkomstige tracing span-tags. Dit kan bijzonder nuttig zijn voor testen. Na het doorlopen van een functionele test kan worden bekeken welk deel van het systeem is aangetast, gefilterd op de overeenkomstige sessiesleutel.
Bepaling van de bron van het verzoek
Om te bepalen waar het verzoek vandaan kwam, kan de functionaliteit voor het automatisch toevoegen van een bronheader worden gebruikt. Met de omgevingsvariabele NETRA_HTTP_X_SOURCE_HEADER_NAME kan de naam van de header worden opgegeven, die automatisch zal worden ingesteld. Met behulp van NETRA_HTTP_X_SOURCE_VALUE kan waarden worden opgegeven voor de X-Source-header op alle uitgaande verzoeken.
Dit maakt het mogelijk om dit nuttige header uniform in het hele netwerk te verspreiden. Vervolgens kan het worden gebruikt in services en toegevoegd aan logs en metrics.
Traffic routing en de werking van Netramesh
Netramesh bestaat uit twee hoofcomponenten. De eerste, netra-init, stelt netwerkregels in om verkeer te onderscheppen. Het gebruikt om al dan niet een deel van het verkeer naar de sidecar te onderscheppen, wat de tweede hoofcomponent van Netramesh is. Het is mogelijk om in te stellen welke poorten moeten worden onderschept voor binnenkomende en uitgaande TCP-sessies: INBOUND_INTERCEPT_PORTS, OUTBOUND_INTERCEPT_PORTS.
Het hulpmiddel heeft ook een interessante functie — probabilistische routering. Als Netramesh uitsluitend voor het verzamelen van tracing spans wordt gebruikt, kan in een productieomgeving middelen worden bespaard door probabilistische routering in te schakelen met de variabelen NETRA_INBOUND_PROBABILITY en NETRA_OUTBOUND_PROBABILITY (tussen 0 en 1). De standaardwaarde is 1 (al het verkeer wordt onderschept).
Na succesvolle onderschepping accepteert de netra sidecar een nieuwe verbinding en gebruikt de SO_ORIGINAL_DST socket-optie om het oorspronkelijke doel te verkrijgen. Vervolgens opent Netra een nieuwe verbinding naar het oorspronkelijke IP-adres en stelt een bidirectionele TCP-communicatie in tussen de partijen, waarbij al het passerende verkeer wordt beluisterd. Als de poort is gedefinieerd als HTTP, probeert Netra deze te parseren en te traceren. Als de parsing van HTTP niet succesvol is, valt Netra terug op TCP en proxyt transparant de bytes.
Opbouw van de afhankelijkheidsgrafiek
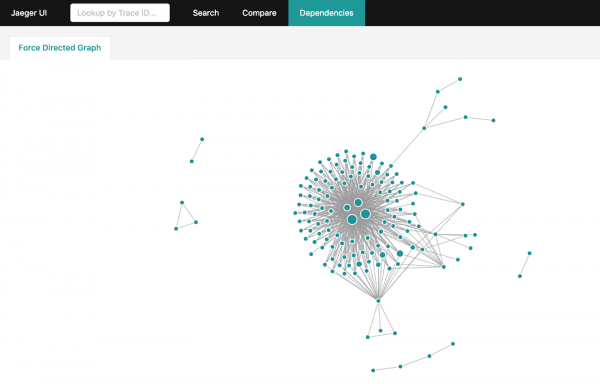
Na het ontvangen van een grote hoeveelheid tracing-informatie in Jaeger, wil je een volledig interactiegrafiek in het systeem krijgen. Maar als je systeem vrij druk is en er gedurende de dag miljarden tracing-spans worden verzameld, wordt het samenvoegen ervan een minder eenvoudige taak. Er is een officiële manier om dit te doen: . Het zal echter uren duren om de volledige grafiek op te bouwen en zal vereisen dat je de volledige dataset van Jaeger voor de afgelopen 24 uur downloadt.
Als je Elasticsearch gebruikt voor het opslaan van tracing-spans, kun je gebruik maken van , die dezelfde grafiek in enkele minuten zal opbouwen, gebruikmakend van de functies en mogelijkheden van Elasticsearch.
Hoe Netramesh te gebruiken
Netra kan eenvoudig aan elke service worden toegevoegd die draait onder een willekeurige orchestrator. Je kunt een voorbeeld bekijken .
Op dit moment heeft Netra geen mogelijkheid voor automatische uitrol van de sidecar naar services, maar er zijn plannen voor implementatie.
Toekomst van Netramesh
Het belangrijkste doel is het behalen van minimale resourcekosten en hoge prestaties, terwijl het de basisfunctionaliteiten voor observability en controle van interservice-interactie biedt.
In de toekomst zal Netramesh ondersteuning bieden voor andere applicatielaagprotocollen naast HTTP. Binnenkort zal er L7-routing beschikbaar komen.
Gebruik Netramesh als je met dergelijke problemen wordt geconfronteerd en neem contact met ons op met vragen en suggesties.
Bron: habr.com
