

Ik zal de titel van het artikel meteen uitleggen. Aanvankelijk was het de bedoeling om goed, betrouwbaar advies te geven over het versnellen van het gebruik van reflectie aan de hand van een eenvoudig, maar realistisch voorbeeld. Echter, tijdens het benchmarken bleek dat reflectie niet zo traag werkt als ik dacht, maar LINQ is langzamer dan in mijn ergste dromen. Uiteindelijk bleek dat ik ook een fout maakte in de metingen... De details van dit levensverhaal staan onder de cat en in de opmerkingen. Aangezien het voorbeeld vrij alledaags is en in principe zoals gewoonlijk in de enterprise is uitgevoerd, denk ik dat het een interessante demonstratie van het leven is: de invloed op de snelheid van het hoofdonderwerp van het artikel was niet merkbaar door externe logica: Moq, Autofac, EF Core en andere 'omhulsels'.
Ik begon mijn werk onder de indruk van dit artikel:
Zoals te zien is, stelt de auteur voor om gecompileerde delegaten te gebruiken in plaats van direct naar de methoden van reflectietypes te verwijzen als een uitstekende manier om de prestaties van de applicatie aanzienlijk te versnellen. Er is daar natuurlijk ook IL-emissie, maar die willen we vermijden, omdat dit de meest arbeidsintensieve manier is om de taak uit te voeren, die ook nog eens foutgevoelig is.
Gezien het feit dat ik altijd een soortgelijke mening over de snelheid van reflectie heb gehad, had ik geen speciale twijfels over de conclusies van de auteur.
Ik kom niet zelden het naïeve gebruik van reflectie in de enterprise tegen. Een type wordt genomen. Informatie over een eigenschap wordt gehaald. De methode SetValue wordt aangeroepen en iedereen is blij. De waarde komt in het doelveld terecht, iedereen is tevreden. Mensen zijn best slim — senior en teamleiders — ze schrijven hun uitbreidingen voor objecten, gebaseerd op zo'n naïeve implementatie van 'universiële' mappers van het ene type naar het andere. Het idee is meestal als volgt: neem alle velden, neem alle eigenschappen, itereer erover: bij overeenkomsten van lidnamen van types voer je SetValue uit. Af en toe vangen we uitzonderingen op misses daar waar we een bepaalde eigenschap van een van de types niet konden vinden, maar ook hier is er een oplossing die de prestaties verbetert. Try/catch.
Ik heb gezien hoe mensen parsers en mappers herontwerpen zonder volledig geïnformeerd te zijn over hoe de fietsen die hen voorgingen werken. Ik heb gezien hoe mensen hun naïeve implementaties verbergen achter strategieën, interfaces en injecties, alsof dat de daaropvolgende chaos zou rechtvaardigen. Van zulke implementaties draaide ik mijn neus om. In feite heb ik geen echte prestatieverlies gemeten en veranderde ik, waar mogelijk, de implementatie in een meer 'optimale' als mijn handen het toelieten. Daarom hebben de eerste metingen waarover hieronder wordt gesproken me behoorlijk in verwarring gebracht.
Ik denk dat velen van jullie, terwijl je Richter of andere ideologen leest, zijn gestuit op een volledig rechtvaardige uitspraak dat reflectie in code een fenomeen is dat een uiterst negatieve invloed heeft op de prestaties van de applicatie.
De aanroep van reflectie dwingt de CLR om assemblies door te lopen op zoek naar de benodigde, de metadata ervan op te halen, het te parseren, enzovoort. Bovendien leidt reflectie tijdens het doorlopen van verzamelingen tot het toewijzen van een grote hoeveelheid geheugen. We verbruiken geheugen, de CLR ontgrendelt de GC en daar gaan we met haperingen. Dit moet merkbaar traag zijn, geloof me. De enorme hoeveelheden geheugen van moderne productie servers of cloudmachines beschermen je niet tegen hoge verwerkingsvertragingen. Feitelijk geldt: hoe meer geheugen, hoe groter de kans dat je OPLET dat de GC aan het werk is. Reflectie is in principe een overbodige rode doek voor hem.
Toch gebruiken we allemaal zowel IoC-containers als datamappers, waarvan het werkingsprincipe ook is gebaseerd op reflectie, maar vragen over hun prestaties ontstaan doorgaans niet. Nee, niet omdat afhankelijkheidsinjectie en abstractie van modellen in een externe, beperkte context zo noodzakelijke dingen zijn dat we in ieder geval concessies moeten doen op het gebied van prestaties. Het is eenvoudiger - ze hebben inderdaad geen grote invloed op de prestaties.
Het punt is dat de meest voorkomende frameworks die op reflectietechnologie zijn gebaseerd, allerlei trucs gebruiken voor een optimalere werking. Meestal is dit caching. Gewoonlijk zijn dit Expressions en gecompileerde delegaten uit een expressieboom. De AutoMapper zelf houdt een concurrerende woordenlijst bij die typen koppelt aan functies die elkaar kunnen converteren zonder aanroep van reflectie.
Hoe wordt dit bereikt? In wezen verschilt het niet van de logica die het platform zelf gebruikt voor het genereren van JIT-code. Bij de eerste aanroep van de methode wordt deze gecompileerd (en ja, dit proces is niet snel); bij de daaropvolgende aanroepen wordt de controle al overgedragen aan de gecompileerde methode, en hier zullen er geen aanzienlijke prestatieschommelingen zijn.
In ons geval kan JIT-compilatie ook worden gebruikt en kan vervolgens het gecompileerde gedrag worden gebruikt met dezelfde prestaties als de AOT-tegenhangers. Uitdrukkingen zullen ons in dit geval helpen.
Kort gezegd kan het principe waar het hier om draait als volgt worden geformuleerd:
Het is zinvol om het uiteindelijke resultaat van de reflectie op te slaan in de vorm van een delegatie die de gecompileerde functie bevat. Ook is het logisch om alle benodigde objecten met type-informatie op te slaan in de velden van uw type - de worker - die buiten de objecten zijn opgeslagen.
Daar is logica in. Gezond verstand vertelt ons dat als iets kan worden gecompileerd en gecached, we dat moeten doen.
Vooruitlopend op de zaken moet gezegd worden dat caching bij reflectie zijn voordelen heeft, zelfs als de voorgestelde methode voor het compileren van uitdrukkingen niet wordt gebruikt. Eigenlijk herhaal ik hier de stellingen van de auteur van het artikel waar ik hierboven naar verwijs.
Laten we het nu over de code hebben. Laten we een voorbeeld bekijken dat is gebaseerd op mijn recente pijnpunt waarmee ik te maken had in een serieuze productieomgeving van een gerenommeerde kredietinstelling. Alle entiteiten zijn verzonnen, zodat niemand iets kan afleiden.
Er is een bepaalde entiteit. Laten we het Contact noemen. Er zijn brieven met een gestandaardiseerde inhoud, waaruit de parser en hydrator deze contacten creëren. Een brief is binnengekomen, we hebben deze gelezen, ontleed in sleutel-waarde paren, een contact aangemaakt en opgeslagen in de database.
Dit is elementair. Stel dat het contact eigenschappen heeft zoals Naam, Leeftijd en telefoonnummer. Deze gegevens worden in de brief verzonden. Ook wil de business dat de supportteams snel nieuwe sleutels kunnen toevoegen voor het mappen van de eigenschappen van de entiteit naar paren in de inhoud van de brief. Voor het geval iemand een typfout heeft gemaakt in de sjabloon of als de mapping van een nieuwe partner snel moet worden uitgevoerd voor de release, aangepast aan het nieuwe formaat. Dan kunnen we de nieuwe correlatie van de mapping toevoegen als een goedkope datafix. Dit is dus een levensecht voorbeeld.
We implement and create tests. It works.
I will not provide the code: there are many source files, and they are available on GitHub via the link at the end of the article. You can download them, modify them beyond recognition, and measure how that would affect your case. I will only provide the code for two template methods that differentiate between the hydrator that should have been fast and the one that should have been slow.
The logic is as follows: the template method receives pairs formed by the basic logic of the parser. The LINQ level is the parser and the basic logic of the hydrator that makes a query to the database context and matches the keys with pairs from the parser (there is code without LINQ for comparison for these functions). Then, the pairs are passed to the main hydration method, and the property values are set in the corresponding entity properties.
"Fast" (Prefix Fast in benchmarks):
 protected override Contact GetContact(PropertyToValueCorrelation[] correlations)
        {
            var contact = new Contact();
            foreach (var setterMapItem in _proprtySettersMap)
            {
                var correlation = correlations.FirstOrDefault(x => x.PropertyName == setterMapItem.Key);
                setterMapItem.Value(contact, correlation?.Value);
            }
            return contact;
        }
As we can see, a static collection with property setters is used – compiled lambdas that call the entity setter. They are created with the following code:
        static FastContactHydrator()
        {
            var type = typeof(Contact);
            foreach (var property in type.GetProperties())
            {
                _proprtySettersMap[property.Name] = GetSetterAction(property);
            }
        }

        private static Action GetSetterAction(PropertyInfo property)
        {
            var setterInfo = property.GetSetMethod();
            var paramValueOriginal = Expression.Parameter(property.PropertyType, "value");
            var paramEntity = Expression.Parameter(typeof(Contact), "entity");
            var setterExp = Expression.Call(paramEntity, setterInfo, paramValueOriginal).Reduce();

            var lambda = (Expression<Action>)Expression.Lambda(setterExp, paramEntity, paramValueOriginal);

            return lambda.Compile();
        }
In general, it's clear. We go through the properties, create delegates for them that call the setters, and store them. Then we call them when needed.
"Slow" (Prefix Slow in benchmarks):
        protected override Contact GetContact(PropertyToValueCorrelation[] correlations)
        {
            var contact = new Contact();
            foreach (var property in _properties)
            {
                var correlation = correlations.FirstOrDefault(x => x.PropertyName == property.Name);
                if (correlation?.Value == null)
                    continue;

                property.SetValue(contact, correlation.Value);
            }
            return contact;
        }
Here, we immediately go through the properties and directly call SetValue.
Voor de duidelijkheid en als referentie heb ik een naïeve methode geïmplementeerd die de waarden van hun correlatieparen direct in de velden van de entiteit schrijft. Het prefix is Manual.
Laten we nu BenchmarkDotNet nemen en de prestaties onderzoeken. En plotseling… (spoiler — dit is niet het juiste resultaat, details hieronder)
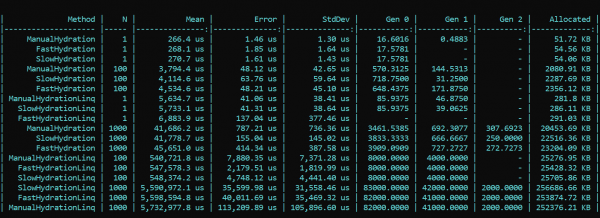
Wat zien we hier? Methoden met de winnende prefix Fast zijn in bijna alle runs trager dan de methoden met de prefix Slow. Dit geldt zowel voor allocatie als voor snelheid. Aan de andere kant kost een mooie en elegante implementatie van mapping met het gebruik van LINQ-methoden, waar mogelijk, echter veel prestatie. Het verschil is aanzienlijk. De trend verandert niet met een verschillend aantal runs. Het verschil ligt alleen in de schalen. Met LINQ is het 4 — 200 keer trager, en er is veel meer afval in diezelfde verhoudingen.
BIJGEWERKT
Ik kon mijn ogen niet geloven, maar belangrijker nog, noch mijn ogen, noch mijn code geloofde onze collega — . Door mijn oplossing opnieuw te controleren ontdekte hij briljant de fout die ik over het hoofd had gezien door een serie veranderingen in de implementatie van begin tot eind. Na het corrigeren van de gevonden bug in de Moq-configuratie stonden alle resultaten weer op hun plaats. Op basis van de retest verandert de belangrijkste trend niet — LINQ heeft nog steeds meer invloed op de prestaties dan reflectie. Het is echter plezierig dat het werken met de compilatie van expressies niet voor niks is, en het resultaat is zichtbaar zowel in allocatie als in uitvoeringstijd. De eerste run, wanneer de statische velden worden geïnitialiseerd, is logisch trager bij de “snelle” methode, maar daarna verandert de situatie.
Hier is het resultaat van de retest:
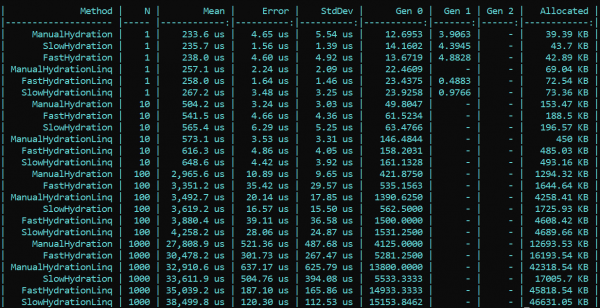
Conclusie: bij het gebruik van reflectie in de enterprise zijn er speciaal geen kunstgrepen nodig — LINQ zal de prestaties sterker beïnvloeden. Desalniettemin kunnen in hoogbelaste methoden, die optimalisatie vereisen, reflectie worden bewaard in de vorm van initializers en compiler-delegaten die later de “snelle” logica zullen waarborgen. Op deze manier kunt u zowel de flexibiliteit van reflectie als de snelheid van de applicatie behouden.
De code met de benchmark is hier beschikbaar. Iedereen die wil kan mijn woorden verifiëren:
PS: de code in de tests gebruikt IoC, terwijl de benchmarks een expliciete constructie gebruiken. Het probleem is dat ik in de uiteindelijke implementatie alle factoren die de prestaties kunnen beïnvloeden en de resultaten kunnen verstoren, heb verwijderd.
PPS: Dank aan de gebruiker voor het ontdekken van mijn fout in de Moq-configuratie, die invloed had op de eerste metingen. Als iemand van de lezers genoeg karma heeft, geef hem dan alsjeblieft een duim omhoog. Deze persoon nam de tijd om te lezen, te controleren en wees de fout aan. Ik vind dat dit respect en sympathie verdient.
PPPS: dank aan die kritische lezer die zich met de stijl en presentatie bemoeide. Ik sta voor uniformiteit en gemak. De diplomatieke aanpak laat te wensen over, maar ik heb de kritiek in overweging genomen. Laten we aan de slag gaan.
Bron: habr.com
