

Tot voor kort werden er ongeveer 50 TB aan gegevens in real-time verwerkt in SQL Server bij Odnoklassniki. Voor zo'n volume is het praktisch onmogelijk om een snelle, betrouwbare en ook fouttolerante datacenter-toegang te bieden met een SQL-database. Gewoonlijk worden in dergelijke gevallen een van de NoSQL-opslagplaatsen gebruikt, maar niet alles kan naar NoSQL worden overgezet: bepaalde entiteiten vereisen ACID-transactiegaranties.
Dit bracht ons ertoe om een NewSQL-opslagplaats te gebruiken, dat wil zeggen een DBMS dat fouttolerantie, schaalbaarheid en snelheid biedt van NoSQL-systemen, maar tegelijkertijd de bekende ACID-garanties van klassieke systemen behoudt. Er zijn niet veel werkende industriële systemen van deze nieuwe klasse, daarom hebben we zo'n systeem zelf geïmplementeerd en in commerciële exploitatie gebracht.
Hoe dit werkt en wat we hebben bereikt — lees verder.
Vandaag de dag bedraagt het maandelijkse publiek van 'Odnoklassniki' meer dan 70 miljoen unieke bezoekers. Wij grootste sociale netwerken ter wereld, en behoren tot de twintig websites waar gebruikers de meeste tijd doorbrengen. De infrastructuur van 'OK' verwerkt zeer hoge belasting: meer dan een miljoen HTTP-verzoeken per seconde aan de fronten. Delen van het serverpark, bestaande uit meer dan 8000 stuks, zijn dicht bij elkaar gelegen — in vier datacentra in Moskou, wat zorgt voor een netwerklatentie van minder dan 1 ms tussen hen.
We gebruiken Cassandra sinds 2010, te beginnen met versie 0.6. Vandaag de dag zijn er tientallen clusters in gebruik. Het snelste cluster verwerkt meer dan 4 miljoen operaties per seconde, en het grootste slaat 260 TB op.
Echter, al deze zijn gewone NoSQL-clusters, die worden gebruikt voor het opslaan van gegevens. Wij wilden echter de belangrijkste consistente opslag vervangen, Microsoft SQL Server, dat sinds de oprichting van 'Odnoklassniki' werd gebruikt. De opslag bestond uit meer dan 300 SQL Server Standard Edition machines, waarop 50 TB aan gegevens — zakelijke entiteiten — waren opgeslagen. Deze gegevens worden gemodificeerd in het kader van ACID-transacties en vereisen .
Voor de verdeling van gegevens over de knooppunten van SQL Server hebben we zowel verticale als horizontale (sharding). Historisch gezien hebben we een eenvoudige datascharnier schema gebruikt: elke entiteit werd gekoppeld aan een token – een functie van de entiteit ID. Entiteiten met dezelfde token werden op dezelfde SQL-server geplaatst. De master-detail relatie werd zo gerealiseerd dat de tokens van het hoofd- en afgeleide record altijd overeenkwamen en zich op dezelfde server bevonden. In het sociale netwerk worden bijna alle records gegenereerd namens de gebruiker – dat betekent dat alle gebruikersgegevens binnen een functioneel subsysteem op één server worden opgeslagen. Dit betekent dat bijna altijd tabellen van dezelfde SQL-server betrokken waren bij zakelijke transacties, wat het mogelijk maakte om gegevensconsistentie te waarborgen met lokale ACID-transacties, zonder de noodzaak voor gebruik gedistribueerde ACID-transacties.
Dankzij sharding en om de werking van SQL te versnellen:
- We gebruiken geen Foreign key constraints, aangezien bij sharding de entiteit ID zich op een andere server kan bevinden.
- We gebruiken geen opgeslagen procedures en triggers vanwege de extra belasting op de CPU van de DBMS.
- We gebruiken geen JOINs vanwege al het bovenstaande en talloze willekeurige leesacties vanaf de schijf.
- Buiten transacties gebruiken we het isolatieniveau Read Uncommitted om deadlocks te minimaliseren.
- We voeren alleen korte transacties uit (gemiddeld korter dan 100 ms).
- We gebruiken geen multi-row UPDATE en DELETE vanwege het grote aantal deadlocks – we werken alleen één record bij.
- De queries worden altijd uitsluitend via de indexen uitgevoerd – een query met een plan voor een volledige tabelscan betekent voor ons een overbelasting van de database en een storing.
Deze stappen hebben ons geholpen bijna het maximale uit SQL-servers te halen. Echter, de problemen werden steeds talrijker. Laten we ze bekijken.
Problemen met SQL
- Omdat we onze eigen sharding hebben gebruikt, werd het toevoegen van nieuwe shards handmatig door beheerders uitgevoerd. Gedurende deze tijd behandelden schaalbare gegevensreplica's geen aanvragen.
- Naarmate het aantal records in de tabel groeide, nam de snelheid van invoegen en modificeren af; het toevoegen van indexen aan een bestaande tabel leidde tot een significante snelheidsdaling, en het maken en opnieuw maken van indexen ging gepaard met downtime.
- Het hebben van een beperkt aantal Windows voor SQL Server in productie bemoeilijkt het beheer van de infrastructuur.
Maar het grootste probleem is —
Resilience
Een traditionele SQL-server heeft een slechte fouttolerantie. Stel dat u maar één database-server heeft en deze om de drie jaar uitvalt. Tijdens deze tijd is de website 20 minuten niet bereikbaar, wat acceptabel is. Maar als u 64 servers heeft, dan is de website om de drie weken niet bereikbaar. En als u 200 servers heeft, dan is de website elke week niet bereikbaar. Dat is een probleem.
Wat kan er gedaan worden om de fouttolerantie van de SQL-server te verbeteren? Wikipedia stelt voor om een : te bouwen waar, in geval van uitval van een van de componenten, er een duplicaat is.
Dit vereist een park dure apparatuur: talrijke duplicaten, glasvezel, gedeelde opslag, en het inschakelen van reserve werkt onbetrouwbaar; ongeveer 10% van de inschakelingen eindigt in een storing van de reserveknoop die de hoofdknop volgt.
Maar het grootste nadeel van zo'n high-availability cluster is de nulbeschikbaarheid bij uitval van het datacenter waar het zich bevindt. 'Odnoklassniki' heeft vier datacenters, en we moeten ervoor zorgen dat we blijven functioneren bij een totale storing in een van hen.
Hiervoor zouden we replicatie kunnen toepassen, ingebouwd in SQL Server. Deze oplossing is veel duurder door de softwarekosten en lijdt aan de bekende problemen met replicatie — onvoorspelbare transactievertragingen bij synchrone replicatie en vertragingen bij het toepassen van replicaties (en als gevolg daarvan verloren aanpassingen) bij asynchrone replicatie. Tevens impliceert het dit alternatief volledig ongeschikt voor ons.
Al deze problemen vereisten een radicale oplossing en we begonnen met een gedetailleerde analyse. Hier moeten we kennismaken met wat SQL Server voornamelijk doet — transacties.
Een eenvoudige transactie
Laten we de eenvoudigste transactie beschouwen, vanuit het perspectief van een SQL-programmeur: het toevoegen van een foto aan een album. Albums en foto's worden in verschillende tabellen opgeslagen. Een album heeft een teller voor openbare foto's. Dan wordt zo'n transactie opgedeeld in de volgende stappen:
- We vergrendelen het album op sleutel.
- We creëren een record in de fototabel.
- Als de foto een openbaar statuut heeft, verhogen we de teller voor openbare foto's in het album, werken we het record bij en committeren we de transactie.
Of in de vorm van pseudocode:
TX.start("Albums", id);
Album album = albums.lock(id);
Photo photo = photos.create(…);

if (photo.status == PUBLIC ) {
    album.incPublicPhotosCount();
}
album.update();

TX.commit();
We zien dat het meest voorkomende scenario voor zakelijke transacties is om gegevens uit de database naar het geheugen van de applicatieserver te lezen, iets te wijzigen en de nieuwe waarden opnieuw in de database op te slaan. Gewoonlijk werken we in zo'n transactie meerdere entiteiten en tabellen bij.
Tijdens de uitvoering van een transactie kan er concurrerende wijziging van dezelfde gegevens uit een ander systeem plaatsvinden. Bijvoorbeeld, Antispam kan besluiten dat een gebruiker verdacht is, waardoor alle foto's van die gebruiker niet langer openbaar moeten zijn, ze moeten naar moderatie worden gestuurd, wat betekent dat photo.status op een andere waarde moet worden gezet en de bijbehorende tellers moeten worden aangepast. Het is duidelijk dat als deze operatie plaatsvindt zonder garanties voor de atomariteit van de toepassing en isolatie van concurrerende wijzigingen, zoals in , het resultaat niet zal zijn wat nodig is — of de fotocounter een onjuiste waarde zal tonen, of niet alle foto's zullen naar moderatie worden verzonden.
Er is in de geschiedenis van Odnoklassniki veel code geschreven die met verschillende zakelijke entiteiten binnen één transactie manipuleert. Uit ervaring met migraties naar NoSQL met weten we dat de grootste moeilijkheden (en de meeste tijdsinvesteringen) voortkomen uit de noodzaak om code te ontwikkelen die gericht is op het handhaven van de consistentie van gegevens. Daarom beschouwden we als belangrijkste vereiste voor de nieuwe opslag de garantie voor de applicatielogica van echte ACID-transacties.
Andere niet minder belangrijke vereisten waren:
- Bij een storing van het datacenter moeten zowel lezen als schrijven naar de nieuwe opslag beschikbaar zijn.
- Behoud van de huidige snelheid van ontwikkeling. Dat betekent dat bij het werken met de nieuwe opslag de hoeveelheid code ongeveer hetzelfde moet blijven, zonder dat er de noodzaak ontstaat om iets aan de opslag toe te voegen, conflictoplossingsalgoritmen te ontwikkelen, secundaire indexen, enz. te onderhouden.
- De snelheid van de nieuwe opslag moet hoog genoeg zijn, zowel bij het lezen van gegevens als bij het verwerken van transacties, wat effectief het gebruik van academisch strikte, universele, maar langzame oplossingen, zoals .
- Automatische schaling in real-time.
- Gebruik van gewone goedkope servers, zonder dat er exotische hardware aangeschaft hoeft te worden.
- De mogelijkheid om de opslag te ontwikkelen met hulp van de ontwikkelaars van het bedrijf. Met andere woorden, de voorkeur ging uit naar eigen of op open-source gebaseerde oplossingen, bij voorkeur in Java.
Oplossingen, oplossingen
Bij het analyseren van mogelijke oplossingen zijn we aangekomen bij twee mogelijke architectuurkeuzes:
De eerste is om een SQL-server te nemen en de nodige fouttolerantie, schaalmechanisme, fouttolerante cluster, conflictresolutie en gedistribueerde, betrouwbare en snelle ACID-transacties te implementeren. We hebben deze optie als vrij complex en tijdrovend beoordeeld.
De tweede optie is om een kant-en-klaar NoSQL-opslag te nemen met geïmplementeerde schaling, een fouttolerant cluster, conflictresolutie en zelf transacties en SQL te implementeren. Op het eerste gezicht lijkt zelfs de taak om SQL te implementeren, om nog maar te zwijgen van ACID-transacties, een klus voor jaren. Maar toen realiseerden we ons dat de set mogelijkheden van SQL die we in de praktijk gebruiken, zo ver van ANSI SQL verwijderd is als ver weg van ANSI SQL. Toen we nog eens goed naar CQL keken, realiseerden we ons dat het vrij dicht bij was wat we nodig hadden.
Cassandra en CQL
Dus, wat maakt Cassandra interessant, welke mogelijkheden heeft het?
Ten eerste, hier kunnen tabellen worden aangemaakt die verschillende datatypes ondersteunen, en je kunt SELECT of UPDATE uitvoeren op de primaire sleutel.
CREATE TABLE photos (id bigint KEY, owner bigint,…);
SELECT * FROM photos WHERE id=?;
UPDATE photos SET … WHERE id=?;
Om de consistentie van de gegevensreplica's te waarborgen, gebruikt Cassandra . In de eenvoudigste zin betekent dit dat wanneer drie replicaten van dezelfde rij op verschillende knooppunten van het cluster worden geplaatst, de registratie als succesvol wordt beschouwd als de meerderheid van de knooppunten (d.w.z. twee van de drie) het succes van deze registratieoperatie bevestigt. De gegevens van de rij worden als consistent beschouwd als de meerderheid van de knooppunten is ondervraagd en deze heeft bevestigd. Hierdoor garandeert de aanwezigheid van drie replicaten volledige en onmiddellijke gegevensconsistentie bij uitval van één knooppunt. Deze aanpak stelde ons in staat om een nog betrouwbaardere regeling te implementeren: altijd verzoeken naar alle drie replicaten te sturen, wachtend op een reactie van de twee snelste. De vertraagde reactie van de derde replica wordt in dit geval afgewezen. Het vertraagde knooppunt kan ernstige problemen ondervinden — vertraging, garbage collection in de JVM, direct memory reclaim in de Linux-kernel, hardwarestoringen, loskoppeling van het netwerk. Echter, dit heeft geen invloed op de operaties van de klant en op de gegevens.
De aanpak waarbij we drie knooppunten aanspreken en een antwoord van twee ontvangen, wordt : een verzoek naar overtollige replicaten wordt al verzonden voordat het 'uiteindelijk uitvalt'.
Een ander voordeel van Cassandra is Batchlog — een mechanisme dat garandeert dat een pakket met wijzigingen volledig wordt toegepast of volledig niet wordt toegepast. Dit stelt ons in staat om de A in ACID — atomiciteit uit de doos — op te lossen.
Het dichtst bij transacties in Cassandra zijn de zogenaamde. Maar ze zijn verre van 'echte' ACID-transacties: in feite is het de mogelijkheid om op gegevens van slechts één record uit te voeren, gebruikmakend van consensus via het zware Paxos-protocol. Daarom is de snelheid van dergelijke transacties laag.
Wat ons ontbrak in Cassandra
Dus, we moesten echte ACID-transacties in Cassandra implementeren. Met behulp waarvan we gemakkelijk twee andere handige mogelijkheden van traditionele DBMS konden realiseren: consistente snelle indexen, wat ons zou in staat stellen om niet alleen op de primaire sleutel te selecteren, en een gewone generator van monotone auto-increment ID's.
C*One
Hieruit ontstond een nieuwe database C*One, bestaande uit drie typen serverknopen:
- Opslag — (bijna) standaard Cassandra-servers die verantwoordelijk zijn voor het opslaan van gegevens op lokale schijven. Naarmate de belasting en de hoeveelheid gegevens toenemen, kan hun aantal eenvoudig worden opgeschaald tot tientallen en honderden.
- Transactioncoördinatoren zorgen voor de uitvoering van transacties.
- Klanten zijn de applicatieservers die bedrijfsoperaties uitvoeren en transacties initiëren. Er kunnen duizenden van deze klanten zijn.
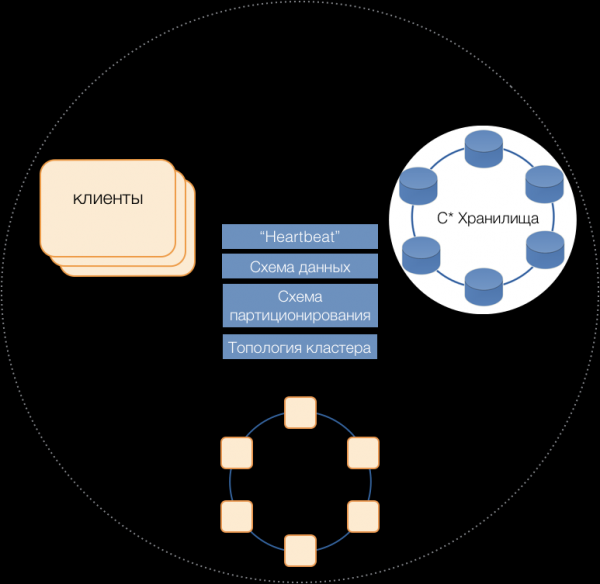
Servers van alle typen maken deel uit van een algemeen cluster, gebruiken het interne berichtenprotocol Cassandra voor communicatie met elkaar en voor uitwisseling van clusterinformatie. Met behulp van Heartbeat leren servers van elkaars falen, onderhouden ze een uniforme datamodel – tabellen, hun structuur en replicatie; de partitionering schema, topologie van het cluster, enz.
Klanten
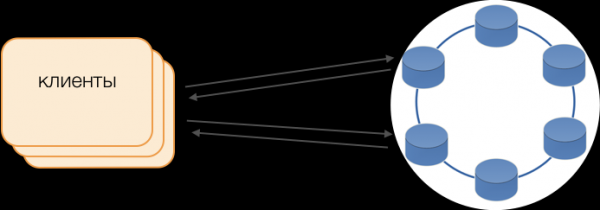
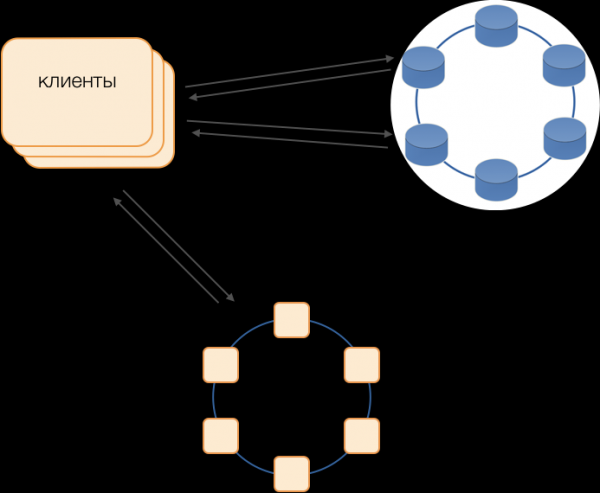
In plaats van standaarddrivers wordt de modus van Fat Client gebruikt. Zo'n node slaat geen gegevens op, maar kan fungeren als coördinator voor de uitvoering van verzoeken, dat wil zeggen dat de klant zelf de functie van coördinator van zijn verzoeken uitvoert: het vraagt de replicaten van de opslag en lost conflicten op. Dit is niet alleen betrouwbaarder en sneller dan de standaarddriver die communicatie met een externe coördinator vereist, maar stelt ook in staat de overdracht van verzoeken te beheren. Buiten een open transactie op de client worden verzoeken naar de opslag verzonden. Als de klant echter een transactie heeft geopend, worden alle verzoeken binnen de transactie naar de transactiecoördinator gestuurd.
Transactiecoördinator C*One
De coördinator is wat we vanaf nul hebben geïmplementeerd voor C*One. Hij is verantwoordelijk voor het beheer van transacties, vergrendelingen en de volgorde van de toepassing van transacties.
Voor elke bediende transactie genereert de coördinator een tijdstempel: elke volgende is groter dan de vorige transactie. Aangezien in Cassandra het systeem voor conflictoplossing is gebaseerd op tijdstempels (van twee conflicterende records wordt de meest actuele beschouwd met de laatste tijdstempel), zal een conflict altijd in het voordeel van de volgende transactie worden opgelost. Op deze manier hebben we — een goedkope manier om conflicten in een gedistribueerd systeem op te lossen.
Vergrendelingen
Om isolatie te waarborgen, hebben we besloten de eenvoudigste manier te gebruiken — pessimistische vergrendelingen op de primaire sleutel van het record. Met andere woorden, in de transactie moet het record eerst worden vergrendeld, daarna gelezen, gemodificeerd en opgeslagen. Pas na een succesvolle commit kan het record worden ontgrendeld, zodat concurrerende transacties het kunnen gebruiken.
De implementatie van een dergelijke blokkering is eenvoudig in een niet-gedistribueerde omgeving. In een gedistribueerd systeem zijn er twee hoofdwegen: ofwel een gedistribueerde blokkering implementeren binnen het cluster, ofwel de transacties verdelen zodat de transacties met betrekking tot een bepaalde registratie altijd door dezelfde coördinator worden afgehandeld.
Aangezien de gegevens in ons geval al zijn verdeeld over groepen van lokale transacties in SQL, is besloten om coördinatoren te koppelen aan groepen lokale transacties: één coördinator voert alle transacties uit met tokens van 0 tot 9, de tweede coördinator met tokens van 10 tot 19, enzovoort. Dit resulteert erin dat elk van de coördinatoren de master van de transactiegroep wordt.
Blokkeringen kunnen dan worden geïmplementeerd als een eenvoudige HashMap in het geheugen van de coördinator.
Falen van coördinatoren
Aangezien één coördinator uitsluitend een groep transacties bedient, is het van groot belang om snel het falen van deze coördinator vast te stellen, zodat de herhaling van de uitvoering van de transactie binnen de timeout past. Om dit snel en betrouwbaar te doen, hebben we een volledig verbonden quorum-heartbeatprotocol toegepast:
In elk datacenter zijn er minimaal twee coördinatornodes aanwezig. Periodiek verzendt elke coördinator heartbeat-berichten naar de andere coördinatoren en informeert hen over zijn werking, evenals over welke heartbeat-berichten van welke coördinatoren in het cluster hij voor het laatst heeft ontvangen.
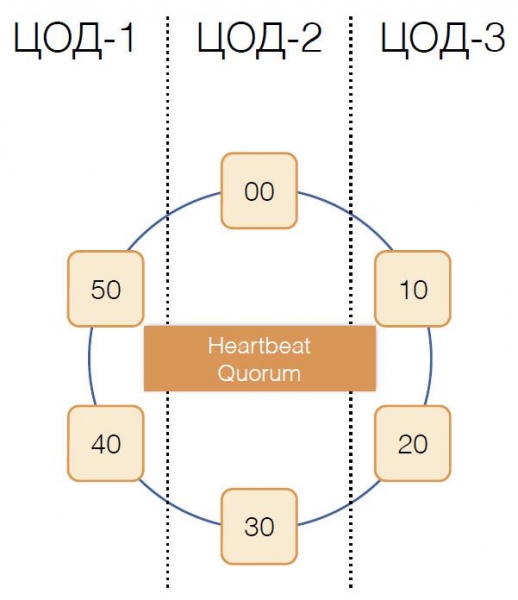
Door vergelijkbare informatie van de anderen te ontvangen in hun heartbeat-berichten, beslist elke coördinator voor zichzelf welke nodes in het cluster operationeel zijn en welke niet, volgens het quorumprincipe: als node X informatie heeft ontvangen over normale ontvangst van berichten van node Y van de meerderheid van de nodes in het cluster, betekent dit dat Y werkt. Omgekeerd, zodra de meerderheid meldt geen berichten meer van node Y te ontvangen, betekent dit dat Y heeft gefaald. Het is interessant dat als het quorum node X meldt dat het geen berichten meer ontvangt, node X zichzelf zal beschouwen als zijnde in storing.
Heartbeat-berichten worden met een hoge frequentie verzonden, ongeveer 20 keer per seconde, met een interval van 50 ms. In Java is het moeilijk om de respons van de applicatie binnen 50 ms te garanderen vanwege de vergelijkbare duur van pauzes die worden veroorzaakt door de garbage collector. We hebben in staat kunnen stellen om deze responstijd te bereiken door de G1 garbage collector te gebruiken, die het mogelijk maakt om een doel te stellen voor de duur van GC-pauzes. Echter, soms, en dat is zeldzaam, overschrijden de pauzes van de garbage collector de 50 ms, wat kan leiden tot een valse detectie van uitval. Om dit te voorkomen, rapporteert de coördinator de uitval van een externe node niet bij het missen van de eerste heartbeat-bericht van die node, alleen als er meerdere op rij zijn verdwenen. Op deze manier konden we de uitval van de coördinator node binnen 200 ms detecteren.
Maar het is niet genoeg om snel te begrijpen welke node gestopt is met functioneren. We moeten hier iets mee doen.
Redundantie
Het klassieke schema voorziet, in geval van uitval van de master, in het starten van verkiezingen voor een nieuwe via een van de algoritmen. Echter, dergelijke algoritmen hebben goed bekende problemen met convergentie in de tijd en de duur van het verkiezingsproces zelf. Dergelijke extra vertragingen konden we vermijden door gebruik te maken van een schema voor het vervangen van coördinatoren in een volledig verbonden netwerk:
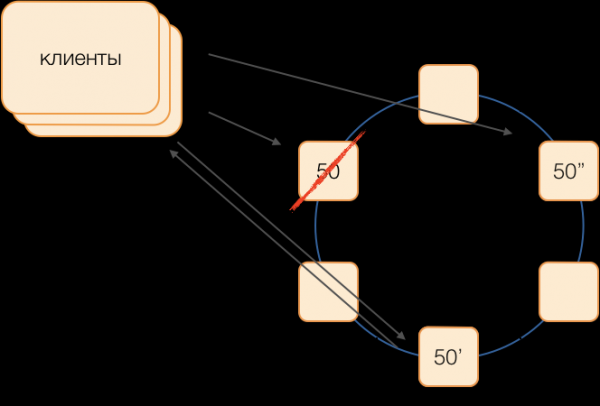
Stel dat we een transactie willen uitvoeren in groep 50. We definiëren van tevoren het vervangingsschema, dat wil zeggen welke nodes de transacties van groep 50 zullen uitvoeren in het geval van uitval van de hoofdcoördinator. Ons doel is om de werking van het systeem te behouden bij de uitval van een datacenter. We bepalen dat de eerste reserve een node uit een ander datacenter zal zijn, en de tweede reserve een node uit een derde. Dit schema wordt één keer gekozen en verandert niet totdat de topologie van het cluster verandert, dat wil zeggen totdat er nieuwe nodes bij komen (wat zeer zelden gebeurt). De volgorde van het kiezen van een nieuwe actieve master bij de uitval van de oude zal altijd als volgt zijn: de eerste reserve wordt de actieve master, en als deze ook stopt met functioneren, dan de tweede reserve.
Dit schema is betrouwbaarder dan een universeel algoritme, aangezien voor het activeren van een nieuwe master het voldoende is om het feit van de uitval van de oude vast te stellen.
Maar hoe begrijpen klanten welke meester momenteel aan het werk is? Het is onmogelijk om binnen 50 ms informatie naar duizenden klanten te verzenden. Er kan een situatie ontstaan waarin een klant een verzoek indient voor het openen van een transactie, zonder te weten dat deze meester al niet meer functioneert, en het verzoek blijft hangen in een time-out. Om dit te voorkomen, sturen klanten speculatief een verzoek naar de groep meester en beide reserves, maar alleen diegene die op dat moment actief is, zal op dit verzoek reageren. Alle verdere communicatie binnen de transactie zal de klant alleen met de actieve meester uitvoeren.
Reserve-meesters plaatsen ontvangen verzoeken voor transacties die niet van henzelf zijn in de wachtrij van ongeboren transacties, waar ze enige tijd worden bewaard. Als de actieve meester sterft, verwerkt de nieuwe meester de verzoeken voor het openen van transacties uit zijn wachtrij en reageert op de klant. Als de klant al een transactie heeft geopend met de oude meester, wordt het tweede antwoord genegeerd (en zal deze transactie, uiteraard, niet worden voltooid en opnieuw door de klant worden uitgevoerd).
Hoe de transactie werkt
Stel dat de klant een verzoek heeft gestuurd naar de coördinator om een transactie te openen voor een bepaalde entiteit met een bepaalde primaire sleutel. De coördinator blokkeert deze entiteit en plaatst deze in de blokkeringstabel in het geheugen. Indien nodig leest de coördinator deze entiteit uit de opslag en slaat de verkregen gegevens op in de status van de transactie in het geheugen van de coördinator.
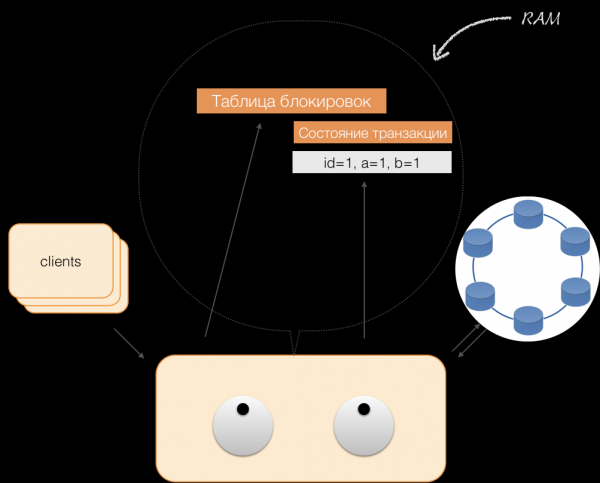
Wanneer de klant gegevens in de transactie wil wijzigen, stuurt hij een verzoek voor modificatie van de entiteit naar de coördinator, die de nieuwe gegevens in de tabel van transactietoestanden in het geheugen plaatst. Hier eindigt de registratie — er vindt geen registratie in de opslag plaats.
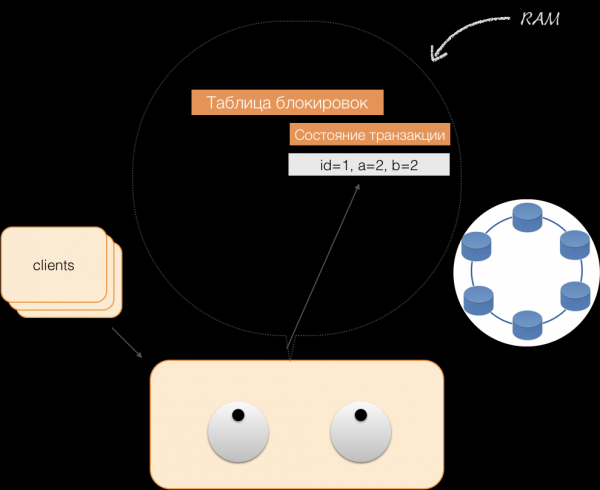
Wanneer de klant binnen een actieve transactie om zijn eigen gewijzigde gegevens vraagt, handelt de coördinator als volgt:
- als het ID al in de transactie bestaat, worden de gegevens uit het geheugen gehaald;
- als het ID niet in het geheugen staat, worden de ontbrekende gegevens uit de opslagknopen gelezen, gecombineerd met de al aanwezige gegevens in het geheugen, en het resultaat wordt aan de klant gegeven.
Op deze manier kan de klant zijn eigen wijzigingen lezen, terwijl andere klanten deze wijzigingen niet zien, omdat ze alleen in het geheugen van de coördinator worden opgeslagen; ze zijn nog niet in de Cassandra-knopen.
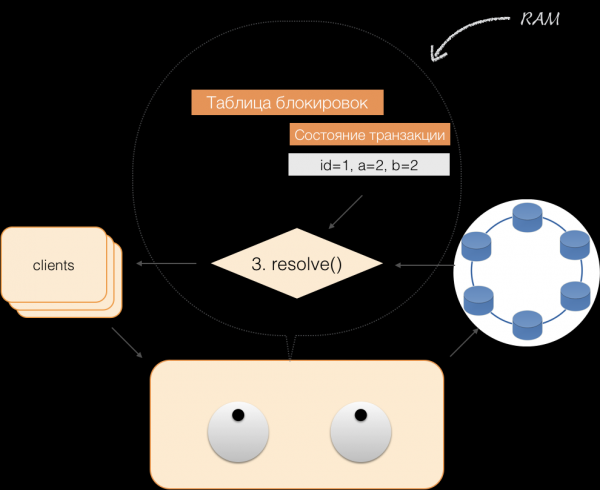
Wanneer een klant een commit verzendt, wordt de toestand die in het geheugen van de service aanwezig was door de coördinator opgeslagen in de logged batch, en deze wordt vervolgens in de vorm van een logged batch naar de opslaglocaties in Cassandra verzonden. De opslaglocaties zorgen ervoor dat deze batch atomair (volledig) wordt toegepast en retourneren een antwoord aan de coördinator, die vervolgens de vergrendelingen vrijgeeft en de succesvolle transactie aan de klant bevestigt.
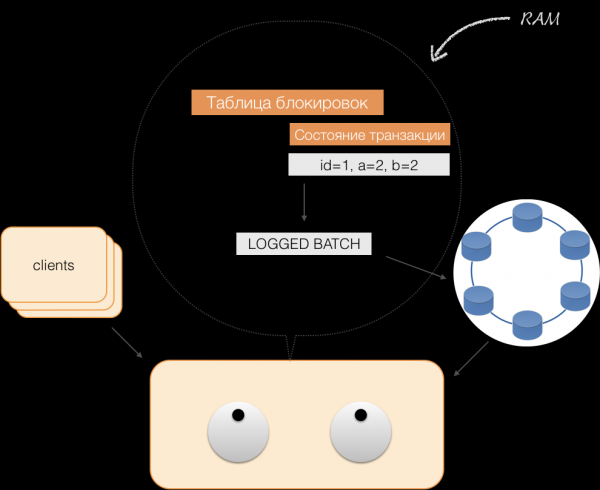
En om terug te draaien, hoeft de coördinator alleen maar het geheugengebruik van de transactie vrij te geven.
Als gevolg van de bovengenoemde verbeteringen hebben we de ACID-principes geïmplementeerd:
- Atomiciteit. Dit garandeert dat geen enkele transactie gedeeltelijk in het systeem wordt vastgelegd, alle suboperaties worden ofwel allemaal uitgevoerd ofwel geen enkele. Dit principe wordt bij ons gehandhaafd door middel van de logged batch in Cassandra.
- Consistentie. Elke succesvolle transactie legt per definitie alleen geldige resultaten vast. Als na het openen van de transactie en het uitvoeren van een deel van de operaties blijkt dat het resultaat ongeldig is, wordt er een terugrol uitgevoerd.
- Isolatie. Bij het uitvoeren van een transactie mogen parallelle transacties geen invloed hebben op het resultaat. Concurrente transacties worden geïsoleerd door middel van pessimistische vergrendelingen op de coördinator. VoorLeesoperaties buiten de transactie wordt het isolatieprincipe op het niveau van Read Committed gehandhaafd.
- Veerkracht. Ongeacht de problemen op lagere niveaus - systeemuitval, hardwarestoringen - moeten wijzigingen die door een succesvol voltooide transactie zijn aangebracht, bewaard blijven na het hervatten van de werking.
Lezen via indexen
Laten we een eenvoudige tabel nemen:
CREATE TABLE photos (
id bigint primary key,
eigenaar bigint,
gewijzigd timestamp,
…)
Deze heeft een ID (primaire sleutel), een eigenaar en een wijzigingsdatum. We moeten een heel eenvoudige query maken - kies gegevens op basis van de eigenaar met de wijzigingsdatum 'in de afgelopen 24 uur'.
SELECT *
WHERE owner=?
AND modified>?
Om een dergelijke query snel uit te voeren, moet er in een klassieke SQL-database een index voor de kolommen (owner, modified) worden gemaakt. Dit kunnen we vrij eenvoudig doen, aangezien we nu garanties hebben voor ACID!
Indexen in C*One
Er is een oorsprongstabel met foto's, waarbij de ID van de record de primaire sleutel is.
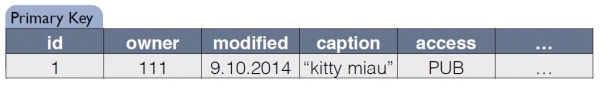
Voor de index creëert C*One een nieuwe tabel die een kopie van de oorspronkelijke is. De sleutel komt overeen met de indexexpressie, bovendien omvat deze ook de primaire sleutel van de record uit de oorspronkelijke tabel:
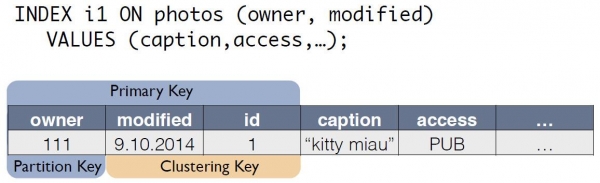
De nu beschikbare query voor 'eigenaar van de laatste 24 uur' kan herschreven worden als select uit een andere tabel:
SELECT * FROM i1_test
WHERE owner=?
AND modified>?
De consistentie van de oorspronkelijke tabel photos en de index tabel i1 wordt automatisch door de coördinator gehandhaafd. Op basis van alleen het datamodel genereert en onthoudt de coördinator wijzigingen niet alleen voor de hoofdtabel, maar ook voor de kopieën. Er zijn geen extra handelingen nodig met de index tabel, logs worden niet gelezen, en er worden geen blokkeringen gebruikt. Dit betekent dat het toevoegen van indexen bijna geen middelen verbruikt en praktisch geen invloed heeft op de snelheid van de aanpassing van modificaties.
Met behulp van ACID hebben we 'indexen zoals in SQL' kunnen realiseren. Ze zijn consistent, kunnen schalen, werken snel, kunnen samengesteld zijn en zijn ingebouwd in de CQL-querytaal. Voor de ondersteuning van indexen zijn er geen wijzigingen in de applicatiecode nodig. Het is zo eenvoudig als in SQL. En het belangrijkste is dat indexen geen invloed hebben op de snelheid van de uitvoering van modificaties van de transactiehoofdtabel.
Wat we hebben verkregen
We hebben C*One drie jaar geleden ontwikkeld en in productie genomen.
Wat hebben we uiteindelijk bereikt? Laten we dit evalueren aan de hand van het voorbeeld van het subsysteem voor de verwerking en opslag van foto's, een van de belangrijkste datatypes in sociale netwerken. Het gaat niet om de foto-inhoud zelf, maar om de verschillende metadata. Op dit moment zijn er in 'Odноклассники' ongeveer 20 miljard van dergelijke records, en het systeem verwerkt 80.000 leesverzoeken per seconde, tot 8.000 ACID-transacties per seconde gerelateerd aan datamodificaties.
Toen we SQL gebruikte met een replicatiefactor = 1 (maar in RAID 10), werd de metadata van de foto's opgeslagen op een hoogbeschikbare cluster van 32 machines met Microsoft SQL Server (plus 11 back-ups). Daarnaast waren er 10 servers toegewezen voor het opslaan van back-ups. In totaal 50 dure machines. Het systeem werkte echter bij nominale belasting, zonder reserve.
Na de migratie naar het nieuwe systeem hebben we een replicatiefactor = 3 gekregen — één kopie in elk datacenter. Het systeem bestaat uit 63 Cassandra-opslagnodes en 6 coördinatormachines, in totaal 69 servers. Maar deze machines zijn aanzienlijk goedkoper, hun totale kosten bedragen ongeveer 30% van de kosten van het systeem op SQL. De belasting blijft op ongeveer 30%.
Met de implementatie van C*One zijn de vertragingen verminderd: in SQL duurde de schrijfbewerking ongeveer 4,5 ms. In C*One is dat ongeveer 1,6 ms. De transactieduur is gemiddeld minder dan 40 ms, de commit vindt plaats in 2 ms, de lees- en schrijfduren zijn gemiddeld 2 ms. De 99e percentiel is slechts 3-3,1 ms, het aantal time-outs is met 100 keer verminderd — alles dankzij het brede gebruik van speculaties.
Op dit moment zijn de meeste SQL Server-nodes al uit gebruik genomen, nieuwe producten worden alleen ontwikkeld met gebruik van C*One. We hebben C*One aangepast voor gebruik in onze cloud. , wat het mogelijk maakte om de implementatie van nieuwe clusters te versnellen, de configuratie te vereenvoudigen en het onderhoud te automatiseren. Zonder de broncode zou dit veel moeilijker en omslachtiger zijn geweest.
Momenteel zijn we bezig met het migreren van andere opslagplaatsen naar de cloud — maar dat is al een heel ander verhaal.
Bron: habr.com
