

Een klassieke vraag die een ontwikkelaar bijna altijd aan zijn DBA of een bedrijfsleider aan de PostgreSQL-consultant stelt, klinkt vrijwel altijd hetzelfde: „Waarom duren de queries zo lang op de database?”
Een traditioneel scala aan oorzaken:
- een inefficiënte algoritme
wanneer je besloot meerdere CTE's te JOINEN met een paar tienduizend records - verouderde statistieken
als de werkelijke gegevensverdeling in de tabel al sterk verschilt van die in de laatste ANALYZE - „knelpunten” in de middelen
en er niet genoeg toegewezen rekenkracht van CPU is, of er voortdurend gigabytes aan geheugen worden doorgegeven of de schijf achterblijft bij alle „wensen” van de database - blokkering door concurrerende processen
En als het moeilijk is om blokkades te vangen en te analyseren, hebben we voor de rest genoeg aan het uitvoeringsplan, dat we kunnen verkrijgen met de (het beste is natuurlijk om direct EXPLAIN (ANALYZE, BUFFERS) ...) of .
Maar zoals in dezelfde documentatie is vermeld,
„Het begrijpen van een plan is een kunst, en om het meester te maken is bepaalde ervaring nodig, …”
Maar je kunt ook zonder het, als je een geschikt hulpmiddel gebruikt!
Hoe ziet een uitvoeringsplan eruit? Zoiets:
Index Scan using pg_class_relname_nsp_index on pg_class (werkelijke tijd=0.049..0.050 rijen=1 loops=1)
  Index Cond: (relname = $1)
  Filter: (oid = $0)
  Buffers: shared hit=4
  InitPlan 1 (geeft $0,$1 terug)
    ->  Limit (werkelijke tijd=0.019..0.020 rijen=1 loops=1)
          Buffers: shared hit=1
          ->  Seq Scan on pg_class pg_class_1 (werkelijke tijd=0.015..0.015 rijen=1 loops=1)
                Filter: (relkind = 'r'::"char")
                Rijen Verwijderd door Filter: 5
                Buffers: shared hit=1
of zo:
"Append  (kost=868.60..878.95 rijen=2 breedte=233) (werkelijke tijd=0.024..0.144 rijen=2 loops=1)"
"  Buffers: shared hit=3"
"  CTE cl"
"    ->  Seq Scan on pg_class  (kost=0.00..868.60 rijen=9972 breedte=537) (werkelijke tijd=0.016..0.042 rijen=101 loops=1)"
"          Buffers: shared hit=3"
"  ->  Limit  (kost=0.00..0.10 rijen=1 breedte=233) (werkelijke tijd=0.023..0.024 rijen=1 loops=1)"
"        Buffers: shared hit=1"
"        ->  CTE Scan on cl  (kost=0.00..997.20 rijen=9972 breedte=233) (werkelijke tijd=0.021..0.021 rijen=1 loops=1)"
"              Buffers: shared hit=1"
"  ->  Limit  (kost=10.00..10.10 rijen=1 breedte=233) (werkelijke tijd=0.117..0.118 rijen=1 loops=1)"
"        Buffers: shared hit=2"
"        ->  CTE Scan on cl cl_1  (kost=0.00..997.20 rijen=9972 breedte=233) (werkelijke tijd=0.001..0.104 rijen=101 loops=1)"
"              Buffers: shared hit=2"
"Planningstijd: 0.634 ms"
"Uitvoeringstijd: 0.248 ms"
Maar het is zeer moeilijk en onduidelijk om het plan in tekstvorm „van papier” te lezen:
- in de knoop wordt de som van de middelen van de subboom
Dat wil zeggen, om te begrijpen hoeveel tijd het heeft gekost om een specifieke node uit te voeren, of hoeveel deze gegevens uit de tabel van de schijf heeft opgevraagd - je moet inderdaad het een van het ander aftrekken. - De tijd van de node is nodig. Je moet vermenigvuldigen met loops.
Ja, aftrekken is nog niet de meest complexe operatie die je 'in je hoofd' moet uitvoeren - de uitvoertijd is gemiddeld voor één uitvoering van de node, en er kunnen er honderden zijn. - Nou, en al dit samen maakt het moeilijk om de belangrijkste vraag te beantwoorden - wie is dat? de "zwakste schakel".?
Toen we dit probeerden uit te leggen aan enkele honderden van onze ontwikkelaars, beseften we dat het van buitenaf ongeveer zo uitziet:
Aha, dus we hebben nodig...
Hulpmiddel
Hierin hebben we geprobeerd alle belangrijke mechanismen te verzamelen die helpen om op basis van plannen en verzoeken te begrijpen 'wie is de schuldige en wat te doen'. En ook een deel van onze ervaring te delen met de gemeenschap.
Ontmoet en gebruik -
Visualisering van plannen.
Is het gemakkelijk om een plan te begrijpen wanneer het er zo uitziet?
Seq Scan op pg_class (werkelijke tijd=0.009..1.304 rijen=6609 loops=1)
  Buffers: shared hit=263
Plannings Tijd: 0.108 ms
Uitvoering Tijd: 1.800 ms
Niet echt.
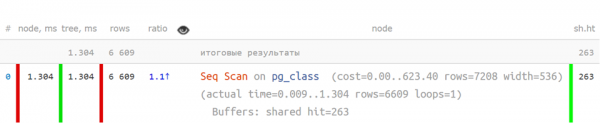
Maar zo, in verkorte vorm,, wanneer de belangrijke indicatoren zijn gescheiden - wordt het al veel duidelijker:
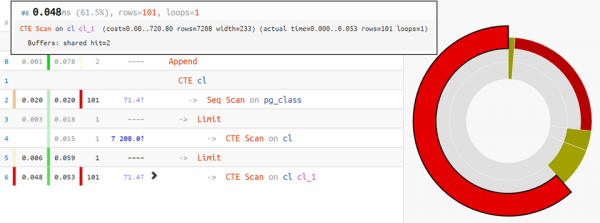
Maar als het plan complexer is, komt er hulp van taartdiagram van tijddistributie per node:
Nou, en voor de meest complexe varianten komt er hulp van uitvoeringsdiagram.:
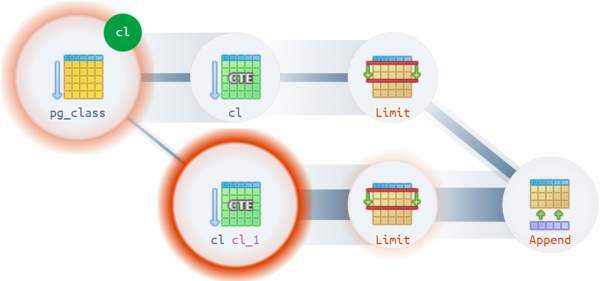
Bijvoorbeeld, er zijn nogal niet-triviale situaties waarin een plan meer dan één feitelijke root kan hebben:
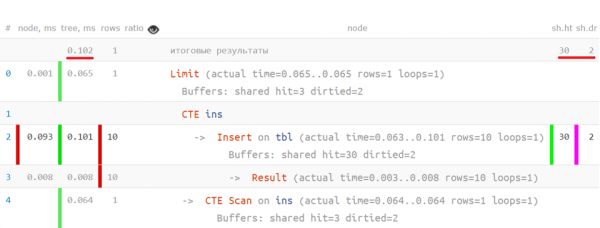
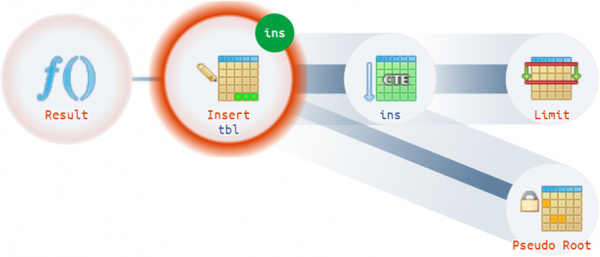
Structurele aanwijzingen.
Nou, als de hele structuur van het plan en zijn pijnpunten al zijn uitgesplitst en zichtbaar zijn - waarom deze dan niet aan de ontwikkelaar markeren en 'in gewone taal' uitleggen?
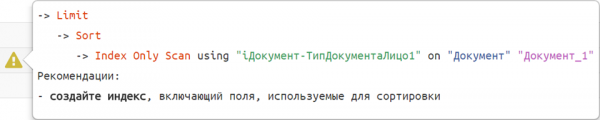 We hebben inmiddels tientallen van dergelijke aanbevelingssjablonen verzameld.
Regel-voor-regel profielen van verzoeken.
Nu, als je de oorspronkelijke query op de geanalyseerde planning legt, kun je zien hoeveel tijd er is besteed aan elke individuele operator - ongeveer zo:
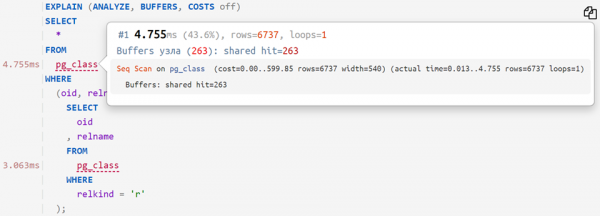
… of zelfs zo:
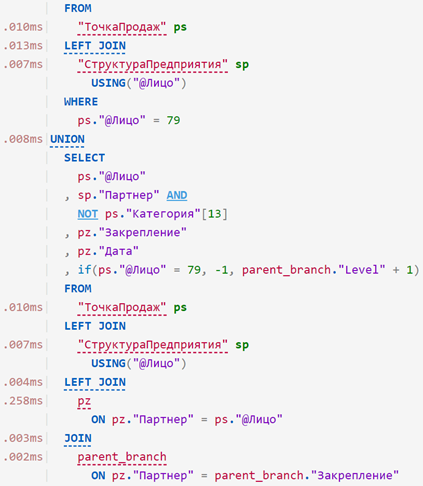
Parameterinvoegen in de query.
Als je niet alleen de query, maar ook de parameters uit de DETAIL-regel van de log aan het plan hebt 'gehecht', kun je deze ook in een van de varianten kopiëren:
- met waarden ingevoegd in de query
voor directe uitvoering op je eigen database en verdere profiling.SELECT 'const', 'param'::text; - met waarden ingevoegd via PREPARE/EXECUTE.
voor het emuleren van de werking van de planner, wanneer het parametrische gedeelte kan worden genegeerd — bijvoorbeeld bij het werken met gepartitioneerde tabellenDEALLOCATE ALL; PREPARE q(text) AS SELECT 'const', $1::text; EXECUTE q('param'::text);
Archief van plannen
Plaats, analyseer, deel met collega's! Plannen blijven in het archief, en je kunt later naar hen terugkeren:
Maar als je niet wilt dat anderen je plan zien, vergeet dan niet om het vinkje "niet publiceren in het archief" te zetten.
In de volgende artikelen zal ik de moeilijkheden en oplossingen bespreken die zich voordoen bij het analyseren van het plan.
Bron: habr.com
