

Als je terechtkomt in een product dat al meer dan tien jaar ontwikkelt, is het niet verrassend dat je verouderde technologieën tegenkomt. Maar wat als je over zes maanden een belasting moet aankunnen die tien keer zo hoog is, en de kosten van uitval honderden keren stijgen? In dat geval heb je een geweldige Highload Engineer nodig. Maar aangezien die er niet is, werd mij de taak toevertrouwd om het probleem op te lossen. In het eerste deel van dit artikel zal ik uitleggen hoe we overstapten van Redis naar Redis-cluster, en in het tweede deel geef ik advies over hoe je met cluster kunt beginnen en waar je op moet letten bij het gebruik.
Keuze van technologie
Is aparte Redis zo slecht? Aparte Redis (standalone redis) in de configuratie van 1 master en N slaves? Waarom noem ik het een verouderde technologie? Nee, Redis is niet zo slecht… Er zijn echter enkele tekortkomingen die je niet kunt negeren.
Ten eerste ondersteunt Redis geen mechanismen voor noodherstel na een master-uitval. Voor dit probleem hebben we een configuratie gebruikt met automatische omleiding van VIP's naar de nieuwe master, waarbij de rol van een van de slaves werd gewijzigd en de anderen werden omgeschakeld. Dit mechanisme werkte, maar als een betrouwbare oplossing kon je het niet beschouwen. Ten eerste waren er valse meldingen, en ten tweede was het een eenmalige actie, en na een uitval waren er handmatige handelingen nodig om de situatie weer op te lossen.
Ten tweede leidde het feit dat er maar één master was, tot problemen met sharding. We moesten meerdere onafhankelijke clusters '1 master en N slaves' creëren, en daarna handmatig de databases over deze machines verspreiden in de hoop dat morgen een van de databases niet zo groot zou worden dat deze naar een aparte instantie moest worden verplaatst.
Wat zijn de opties?
De duurste en meest uitgebreide oplossing is Redis-Enterprise. Dit is een kant-en-klaar oplossing met volledige technische ondersteuning. Hoewel het technisch gezien ideaal lijkt, kwam het om ideologische redenen niet voor ons in aanmerking.
- Redis-cluster. Uit de doos is er ondersteuning voor noodovergang van de master en sharding. De interface verschilt bijna niet van de normale versie. Het ziet er veelbelovend uit, we zullen later over de valkuilen praten.
- Redis-cluster. Uit de doos is er ondersteuning voor noodovergang van de master en sharding. De interface verschilt bijna niet van de normale versie. Het ziet er veelbelovend uit, we zullen later over de valkuilen praten.
- Tarantool, Memcache, Aerospike en andere. Al deze tools doen ongeveer hetzelfde. Maar elke heeft zijn eigen tekortkomingen. We hebben besloten om niet al onze eieren in één mand te leggen. Memcache en Tarantool gebruiken we voor andere taken, en vooruitlopend kan ik zeggen dat we in onze praktijk meer problemen met hen hebben ervaren.
Specificiteit van gebruik
Laten we eens kijken naar welke taken we historisch gezien met Redis hebben opgelost en welke functionaliteiten we hebben gebruikt:
- Cache voor verzoeken naar externe services zoals 2GIS | Golang
GET SET MGET MSET "SELECT DB"
- Cache voor MYSQL | PHP
GET SET MGET MSET SCAN "KEY BY PATTERN" "SELECT DB"
- Hoofdlager voor de service voor het werken met sessies en de coördinaten van bestuurders | Golang
GET SET MGET MSET "SELECT DB" "ADD GEO KEY" "GET GEO KEY" SCAN
Zoals je ziet, geen hogere wiskunde. Wat is dan de moeilijkheid? Laten we elk methodes apart bekijken.
Methode
Omschrijving
Kenmerken van Redis-cluster
Oplossing
GET SET
Sleutel schrijven/lezen
MGET MSET
Meerdere sleutels schrijven/lezen
Sleutels staan op verschillende nodes. Beschikbare bibliotheken kunnen alleen Multi-operaties binnen één node uitvoeren.
Vervang MGET door een pipeline van N GET-operaties
SELECT DB
Kies de database waarmee we gaan werken
Ondersteunt geen meerdere databases
Alles in één database opslaan. Voeg prefixen toe aan de sleutels
SCAN
Door alle sleutels in de database lopen
Omdat we één database hebben, is het te kostbaar om door alle sleutels in het cluster te lopen
De invariant binnen één sleutel ondersteunen en HSCAN op deze sleutel uitvoeren. Of helemaal opgeven.
GEO
Operaties met geo-sleutels
Geo-sleutel is niet geschard
KEY BY PATTERN
Zoek sleutel op patroon
Omdat we één database hebben, gaan we zoeken door alle sleutels in het cluster. Te kostbaar.
Of opgeven of de invariant ondersteunen, zoals in het geval van SCAN.
Redis vs Redis-cluster
Wat verliezen we en wat winnen we bij de overstap naar een cluster?
- Nadelen: we verliezen functionaliteit van meerdere databases.
- Als we logisch niet gerelateerde gegevens in één cluster willen opslaan, moeten we trucs toepassen in de vorm van prefixen.
- We verliezen alle operaties 'per database', zoals SCAN, DBSIZE, CLEAR DB, enz.
- Multi-operaties zijn aanzienlijk moeilijker te implementeren, omdat het nodig kan zijn om meerdere nodes aan te roepen.
- Voordelen:
- Weerbaarheid door noodoverdracht van de master.
- Shardering aan de Redis-kant.
- Verplaatsing van gegevens tussen nodes atomair en zonder downtime.
- Toevoegen en herverdelen van capaciteit en belasting zonder downtime.
Ik zou concluderen dat als je geen hoog niveau van beschikbaarheid nodig hebt, een verhuizing naar een cluster niet de moeite waard is, omdat dit een niet triviale taak kan zijn. Maar als je van tevoren moet kiezen tussen een aparte versie en een cluster, dan is het beter om voor een cluster te kiezen, want dit is niet slechter en het zal bovendien een deel van je hoofdpijn verlichten.
Voorbereiding op verhuizing
Laten we beginnen met de vereisten voor de verhuizing:
- Het moet naadloos zijn. Een volledige stop van de service van 5 minuten komt voor ons niet in aanmerking.
- Het moet zo veilig en geleidelijk mogelijk zijn. We willen enige controle over de situatie hebben. Direct alles overzetten en bidden dat de terugknop werkt, is niets voor ons.
- Minimale dataverlies tijdens de verhuizing. We begrijpen dat het heel moeilijk zal zijn om atomair te verhuizen, daarom staan we enige desynchronisatie tussen de gegevens in de reguliere en cluster Redis toe.
Onderhoud van het cluster
Vlak voor de verhuizing moet je nadenken of we het cluster kunnen ondersteunen:
- Grafieken. We gebruiken Prometheus en Grafana voor grafieken van CPU-belasting, gebruikte geheugen, aantal klanten, aantal GET-, SET-, AUTH-operaties, enz.
- Expertise. Stel je voor dat je morgen verantwoordelijk bent voor een enorm cluster. Als het kapot gaat, kan niemand anders het repareren, behalve jij. Als het begint te traag te worden, zullen ze allemaal naar jou komen. Als er middelen toegevoegd of de belasting herverdeeld moet worden, zal er weer naar jou gekeken worden. Om te voorkomen dat je op je 25ste grijs wordt, is het verstandig om deze gevallen te anticiperen en van tevoren te controleren hoe de technologie zich zal gedragen bij verschillende acties. We zullen dit verder bespreken in het gedeelte 'Expertise'.
- Monitoring en waarschuwingen. Wanneer het cluster kapot gaat, wil je daar als eerste van op de hoogte zijn. We hebben ons hierbij beperkt tot waarschuwingen dat alle knooppunten dezelfde informatie over de status van het cluster rapporteren (ja, het kan ook anders zijn). Andere problemen zijn sneller op te merken via de waarschuwingen van de Redis-clientservices.
Verhuizing
Hoe we de verhuizing zullen aanpakken:
- Allereerst moet de bibliotheek worden voorbereid voor gebruik met het cluster. We hebben go-redis als basis genomen voor de Go-versie en deze enigszins aangepast. We hebben Multi-methoden geïmplementeerd via pipelines en ook enkele regels voor het herhalen van aanvragen aangepast. Voor de PHP-versie waren er meer problemen, maar uiteindelijk hebben we gekozen voor php-redis. Zij hebben onlangs ondersteuning voor clusters geïntroduceerd, en naar onze mening ziet het er goed uit.
- Vervolgens moet het cluster zelf worden uitgerold. Dit gebeurt letterlijk met twee commando's op basis van het configuratiebestand. Meer details over de instellingen bespreken we hieronder.
- Voor de geleidelijke overgang gebruiken we de dry-mode. Aangezien we twee versies van de bibliotheek met dezelfde interface hebben (één voor de reguliere versie, de andere voor het cluster), is het eenvoudig om een wrapper te maken die met de afzonderlijke versie werkt en tegelijkertijd alle verzoeken naar het cluster dupliceert, de antwoorden vergelijkt en discrepanties in de logboekschrijft (in ons geval naar NewRelic). Zo, zelfs als de cluster versie faalt tijdens de lancering, heeft dat geen invloed op onze productie.
- Bij het uitrollen van het cluster in dry-mode kunnen we rustig naar de grafiek van de discrepanties kijken. Als het percentage fouten langzaam maar zeker naar een bepaalde kleine constante beweegt, dan is alles goed. Waarom zijn er toch discrepanties? Omdat de opname in de afzonderlijke versie iets eerder plaatsvindt dan in het cluster, en door de micro-vertraging kunnen de gegevens uiteenlopen. We hoeven alleen maar naar de discrepantie-logboeken te kijken, en als ze allemaal te verklaren zijn door het niet-atomisch karakter van de opname, kunnen we verder gaan.
- Nu kunnen we de dry-mode omdraaien. We zullen schrijven en lezen uit het cluster en naar de afzonderlijke versie dupliceren. Waarom? In de komende week willen we het functioneren van het cluster observeren. Mocht blijken dat er problemen zijn met de piekbelasting, of dat we iets over het hoofd hebben gezien, dan hebben we altijd een noodrollback naar de oude code en actuele gegevens dankzij de dry-mode.
- We moeten de dry-mode uitschakelen en de afzonderlijke versie afbreken.
Expertise
Eerst een korte uitleg over de structuur van het cluster.
Allereerst is Redis een key-value opslag. Voor sleutels worden willekeurige strings gebruikt. Voor waarden kunnen getallen, strings en complexe structuren worden gebruikt. Laten we dat laatste even overslaan; voor een algemeen begrip van de structuur is dit niet belangrijk.
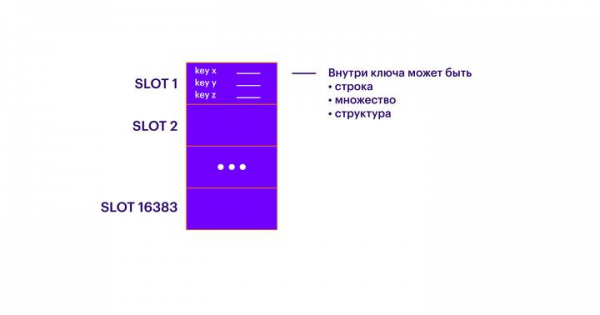
Het niveau van abstractie dat volgt op sleutels zijn de slots (SLOTS). Elke sleutel behoort tot een van de 16.383 slots. In elk slot kunnen onbeperkt sleutels zijn. Zo vallen alle sleutels uiteen in 16.383 niet-overlappende verzamelingen.
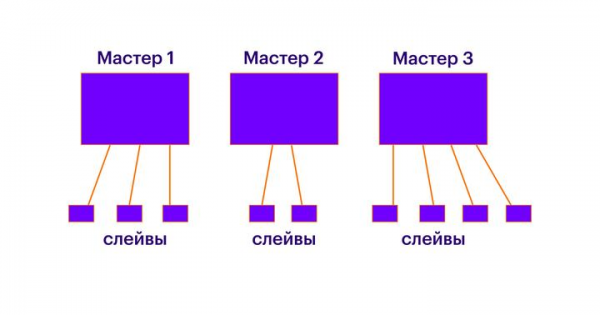
Vervolgens moet er N master-nodes in de cluster zijn. Iedere node kan worden gezien als een afzonderlijke Redis-instantie die alles weet over andere nodes binnen de cluster. Elke master-node bevat een aantal slots. Elke slot behoort alleen tot één master-node. Alle slots moeten verdeeld worden over de nodes. Als er slots zijn die niet zijn verdeeld, zullen de sleutels die erin zijn opgeslagen niet toegankelijk zijn. Het heeft zin om elke master-node op een aparte logische of fysieke machine te draaien. Ook is het goed om te onthouden dat elke node alleen op één core draait, en als je meerdere Redis-instanties op één logische machine wilt draaien, zorg er dan voor dat ze op verschillende cores draaien (we hebben dit niet geprobeerd, maar in theorie zou alles moeten werken). In wezen zorgen master-nodes voor gewone sharding, en een groter aantal master-nodes maakt het mogelijk om schrijf- en leesverzoeken te schalen.
Nadat alle sleutels zijn verdeeld over de slots, en de slots zijn verspreid over de master-nodes, kan er een willekeurig aantal slave-nodes aan elke master-node worden toegevoegd. Binnen elke dergelijke 'master-slave' koppeling zal gebruikelijke replicatie plaatsvinden. Slaves zijn nodig voor het schalen van leesverzoeken en voor failover in het geval de master uitvalt.
Laten we nu eens kijken naar de operaties die we zouden moeten kunnen uitvoeren.
We zullen het systeem benaderen via Redis-CLI. Aangezien Redis geen enkel toegangspunt heeft, kunnen de volgende operaties op elk van de nodes worden uitgevoerd. In elk punt wijs ik speciaal op de mogelijkheid om de operatie onder belasting uit te voeren.
- Het eerste en belangrijkste dat we nodig hebben: de operatie cluster nodes. Deze geeft de status van de cluster weer, toont de lijst van nodes, hun rollen, de verdeling van slots, enz. Verdere informatie kan worden verkregen met cluster info en cluster slots.
- Het zou goed zijn om nodes toe te kunnen voegen en te verwijderen. Hiervoor zijn de operaties cluster meet en cluster forget. Let op dat cluster forget op ELKE node moet worden toegepast, zowel op masters als op replicas. Cluster meet hoeft daarentegen slechts op één node te worden aangeroepen. Dit verschil kan ontmoedigend zijn, dus het is beter om hiervan op de hoogte te zijn voordat je het cluster in gebruik neemt. Het toevoegen van een node kan veilig in de praktijk worden uitgevoerd en heeft geen invloed op de werking van het cluster (wat logisch is). Als je echter een node uit het cluster wilt verwijderen, moet je ervoor zorgen dat er geen slots meer op staan (anders riskeer je de toegang tot alle sleutels op deze node te verliezen). Verwijder ook geen master die slaves heeft, anders zal er onnodig gestemd worden voor een nieuwe master. Als er al geen slots meer op de nodes zijn, is dit een klein probleem, maar waarom zouden we extra keuzemogelijkheden willen als we de slaves eerst kunnen verwijderen?
- Als je de master en slave geforceerd wilt omwisselen, is de command cluster failover geschikt. Houd er rekening mee dat de master tijdens de uitvoering van de operatie niet beschikbaar zal zijn. Gewoonlijk gebeurt de overdracht in minder dan een seconde, maar niet atomair. Je kunt verwachten dat een deel van de verzoeken naar de master in deze tijd met een fout zal eindigen.
- Voordat u een node uit het cluster verwijdert, mogen er geen slots meer op aanwezig zijn. Het is beter om ze te herschikken met het commando cluster reshard. Slots worden van de ene master naar de andere overgebracht. De hele operatie kan enkele minuten duren, afhankelijk van de hoeveelheid over te dragen gegevens, maar het proces van overdracht is veilig en heeft geen invloed op het functioneren van het cluster. Op deze manier kunnen alle gegevens onder belasting van de ene node naar de andere worden overgebracht, zonder dat u zich zorgen hoeft te maken over hun beschikbaarheid. Er zijn echter enkele nuances. Ten eerste gaat de overdracht van gegevens gepaard met een bepaalde belasting op zowel de ontvangende als de verzendende node. Als de ontvangende node al zwaar belast is wat betreft CPU, moet u deze niet verder belasten met het ontvangen van nieuwe gegevens. Ten tweede, zodra er op de verzendende master geen slots meer over zijn, zullen al zijn slaves onmiddellijk overschakelen naar de master waar deze slots naartoe zijn overgebracht. Het probleem is dat al deze slaves tegelijkertijd de gegevens willen synchroniseren. En u heeft nog geluk als dit een partiële in plaats van een volledige synchronisatie is. Houd hier rekening mee en combineer de operaties voor het overdragen van slots en het uitschakelen/verplaatsen van slaves. Of hoop gewoon dat u voldoende capaciteit heeft.
- Wat te doen als u bij de overdracht ontdekt dat u slots kwijt bent geraakt? Ik hoop dat dit probleem u niet zal raken, maar als dat zo is, is er de operatie cluster fix. Deze zal, hoe dan ook, de slots willekeurig over de nodes verdelen. Ik raad aan om de werking ervan te controleren door eerst een node met de verdeelde slots uit het cluster te verwijderen. Aangezien de gegevens in de niet verdeelde slots toch niet toegankelijk zijn, is het te laat om zich zorgen te maken over de problemen met de beschikbaarheid van deze slots. Aan de andere kant heeft de operatie geen invloed op de verdeelde slots.
- Een andere handige operatie is monitor. Hiermee kunt u in real-time de volledige lijst van verzoeken die naar de node gaan, zien. Bovendien kunt u er grep op toepassen en nagaan of er gewenst verkeer is.
Het is ook vermeldenswaardig dat er een failover-procedure voor de master is. Kort gezegd, deze bestaat, en naar mijn mening werkt deze uitstekend. Maar het is niet zo dat als je de stekker uit het stopcontact trekt van de machine met de master-node, Redis onmiddellijk overschakelt en de clients geen onderbreking merken. In mijn ervaring duurt het enkele seconden voordat de overschakeling plaatsvindt. Gedurende deze tijd zullen sommige gegevens niet beschikbaar zijn: de onbeschikbaarheid van de master wordt vastgesteld, de nodes stemmen voor een nieuwe, de slaves schakelen over, en de gegevens worden gesynchroniseerd. De beste manier om zelf te verifiëren of het schema werkt, is door lokale oefeningen uit te voeren. Start het cluster op je laptop, geef een minimale belasting, simuleer een uitval (bijvoorbeeld door de poorten te blokkeren), en beoordeel de overschakelsnelheid. Naar mijn mening kan je pas na een dag of twee spelen met zulke oefeningen zeker zijn van de werking van de technologie. Of je moet hopen dat software die door de helft van het internet wordt gebruikt, ongetwijfeld goed werkt.
Configuratie
Vaak is de configuratie het eerste dat nodig is om aan de slag te gaan met de tool. En wanneer alles eenmaal werkt, wil je de configuratie niet meer aanpassen. Er zijn bepaalde inspanningen nodig om jezelf terug te dwingen naar de instellingen en deze grondig door te nemen. In mijn herinnering hebben we minstens twee ernstige blunders gehad door onophoudelijke aandacht voor de configuratie. Let vooral op de volgende punten:
- timeout 0
De tijd waarna inactieve verbindingen worden gesloten (in seconden). 0 - worden niet gesloten.
Niet elke bibliotheek van ons kon verbindingen correct sluiten. Door deze instelling uit te schakelen, lopen we het risico tegen de limiet van het aantal clients aan te lopen. Aan de andere kant, als dit probleem zich voordoet, kan de automatische verbreking van verloren verbindingen het verbergen, en merken we het misschien niet. Bovendien is het niet raadzaam om deze instelling in te schakelen bij het gebruik van persistente verbindingen. - Save x y & appendonly yes
Opslaan van RDB-snapshot.
We zullen RDB/AOF-problemen hieronder in detail bespreken. - stop-writes-on-bgsave-error no & slave-serve-stale-data yes
Als dit is ingeschakeld, zal de master stoppen met het accepteren van wijzigingsverzoeken bij een defect RDB-snapshot. Als de verbinding met de master verloren is, kan de slave doorgaan met het beantwoorden van verzoeken (ja). Of zal het stoppen met reageren (nee).
We zijn niet blij met een situatie waarin Redis in een pompoen verandert. - repl-ping-slave-period 5
Na deze periode beginnen we ons zorgen te maken dat de master is vastgelopen en dat het tijd is voor de failoverprocedure.
Vervolgens moet je handmatig een balans vinden tussen valse alarmen en het starten van de failover. In onze praktijk is dit 5 seconden. - repl-backlog-size 1024mb & epl-backlog-ttl 0
Dit is de hoeveelheid gegevens die we in de buffer kunnen opslaan voor de uitgevallen replica. Als de buffer vol is, moet volledige synchronisatie plaatsvinden.
De praktijk leert dat het beter is om een groter getal in te stellen. Er zijn genoeg redenen waarom een replica achter kan raken. Als ze achterloopt, dan heeft je master waarschijnlijk al moeite en zal volledige synchronisatie de laatste druppel zijn. - maxclients 10000
Het maximale aantal gelijktijdige klanten.
Uit onze ervaring is het beter om een hoger getal in te stellen. Redis kan prima omgaan met 10.000 verbindingen. Zorg er alleen voor dat het systeem genoeg sockets heeft. - maxmemory-policy volatile-ttl
De regel voor het verwijderen van sleutels bij het bereiken van de beschikbare geheugenlimiet.
Hier is het niet zozeer de regel die belangrijk is, maar het begrip hoe dit zal gebeuren. Redis verdient lof voor zijn vermogen om normaal te functioneren bij het bereiken van de geheugengrens.
Problemen met RDB en AOF
Hoewel Redis alle informatie in het RAM opslaat, is er ook een mechanisme voor het opslaan van gegevens op schijf. Meer bepaald zijn er drie mechanismen:
- RDB-snapshot — een volledige snapshot van alle gegevens. Dit wordt ingesteld met de configuratie SAVE X Y en gelezen als 'sla een volledige snapshot van alle gegevens op elke X seconden, als er ten minste Y sleutels zijn gewijzigd'.
- Append-only file — een lijst van bewerkingen in volgorde van uitvoering. Voegt nieuwe binnenkomende bewerkingen elke X seconden of elke Y bewerkingen aan het bestand toe.
- RDB en AOF — een combinatie van de twee voorgaande.
Alle methoden hebben hun eigen voordelen en nadelen, ik zal niet alles opsommen, maar ik wil graag op een paar niet voor de hand liggende punten wijzen.
Ten eerste vereist het maken van een RDB-snapshot dat FORK wordt aangeroepen. Als er veel gegevens zijn, kan dit Redis enkele milliseconden tot een seconde vastzetten. Bovendien heeft het systeem geheugen nodig voor zo'n snapshot, wat betekent dat de logische machine een dubbele hoeveelheid RAM moet hebben: als 8 GB voor Redis is toegewezen, moet er op de virtuele machine 16 GB beschikbaar zijn.
Ten tweede zijn er problemen met partiële synchronisatie. In AOF-modus kan bij het opnieuw verbinden van de slave in plaats van partiële synchronisatie een volledige synchronisatie worden uitgevoerd. Waarom dit gebeurt, kon ik niet achterhalen. Maar het is belangrijk om dit in gedachten te houden.
Deze twee punten doen ons al nadenken over de vraag of we deze gegevens op schijf nodig hebben, aangezien alles al wordt gedupliceerd door slaves. Gegevens kunnen alleen verloren gaan als alle slaves uitvallen, en dat is een probleem van het niveau 'brand in datacenter'. Als compromis kunnen we voorstellen om gegevens alleen op slaves op te slaan, maar in dat geval moet ervoor worden gezorgd dat deze slaves nooit de master worden bij een noodbewaking (daarvoor is er een instelling voor de prioriteit van slaves in hun configuratie). Voor onszelf overwegen we in elk specifiek geval of het nodig is om gegevens op de schijf op te slaan, en het antwoord is meestal 'nee'.
Conclusie
Tot slot hoop ik dat ik een algemeen beeld heb kunnen schetsen van de werking van redis-cluster voor degenen die er nog nooit van gehoord hebben, en heb ik aandacht besteed aan enkele minder voor de hand liggende punten voor degenen die het al lang gebruiken.
Bedankt voor uw tijd en zoals gewoonlijk zijn opmerkingen over het onderwerp welkom.
Bron: habr.com
