

Een andere gebruiker wil een nieuw stuk data op de harde schijf schrijven, maar heeft niet voldoende vrije ruimte. Verwijderen wil hij ook niet, want "alles is heel belangrijk en nodig". Wat moeten we met hem doen?
Dit probleem komt niet alleen bij hem voor. Op onze harde schijven ligt terabytes aan informatie opgeslagen, en deze hoeveelheid lijkt niet te verminderen. Maar hoe uniek is deze informatie? Uiteindelijk zijn alle bestanden gewoon reeksen bits van een bepaalde lengte en waarschijnlijk verschilt een nieuw bestand niet veel van een bestaand bestand.
Het is duidelijk dat het zoeken naar al opgeslagen stukjes informatie op de harde schijf een taak is die, als het niet faalt, althans niet efficiënt is. Aan de andere kant, als het verschil klein is, kunnen we misschien een beetje aanpassen...
TL;DR - een tweede poging om een vreemde methode voor data-optimalisatie met JPEG-bestanden uit te leggen, nu in een begrijpelijker formaat.
Over bits en verschillen
Als we twee volledig willekeurige stukken data nemen, komt gemiddeld de helft van de bits overeen. Het klopt, want onder de mogelijke combinaties voor elk paar ('00, 01, 10, 11') heeft exact de helft gelijke waarden, dat is eenvoudig.
Maar natuurlijk, als we gewoon twee bestanden nemen en de ene aanpassen aan de andere, verliezen we een van beiden. Als we echter de wijzigingen opslaan, herontdekken we gewoon , wat zonder ons al goed bestaat, ook al wordt het normaal niet voor dezelfde doeleinden gebruikt. We kunnen proberen een kleinere reeks in een grotere in te voegen, maar zelfs dan riskeren we het verlies van kritieke datasegmenten bij ondoordacht gebruik.
Waar kunnen we dan het verschil elimineren? Nou, dat wil zeggen, het nieuwe bestand dat door de gebruiker wordt geschreven - gewoon een reeks bits, waarmee we op zich niets kunnen doen. Dus moeten we gewoon op de harde schijf bits vinden die we kunnen wijzigen zonder de noodzaak om het verschil op te slaan, zodat we ze kunnen verliezen zonder ernstige gevolgen. En er is ook zin om niet alleen het bestand op het bestandssysteem te wijzigen, maar ook minder gevoelige informatie binnenin. Maar welke en hoe?
Aanpassingsmethoden
Gecomprimeerde bestanden met verlies komen te hulp. Al deze jpeg-, mp3-bestanden en dergelijke, hoewel ze compressie met verlies zijn, bevatten een hoop bits die veilig kunnen worden gewijzigd. Er kunnen geavanceerde technieken worden gebruikt die hun componenten op verschillende coderingslocaties subtiel wijzigen. Wacht even. Geavanceerde technieken... subtiele wijziging... enkele bits voor andere... dit is bijna !
Inderdaad, het insluiten van de ene informatie in de andere doet denken aan zijn methoden. Ook is de onopvallendheid van de aangebrachte wijzigingen voor het menselijke zintuig indrukwekkend. Hier divergeren de paden - onze taak beperkt zich tot het toevoegen van informatie door de gebruiker op zijn harde schijf, wat alleen maar schadelijk voor hem kan zijn. Hij zal het nog vergeten.
Dus, hoewel we ze kunnen gebruiken, moeten we enkele aanpassingen doen. En verder zal ik deze demonstreren aan de hand van een van de bestaande methoden en een gangbaar bestandsformaat.
Over jacksals
Als je al moet comprimeren, dan het meest gecomprimeerde ter wereld. Het gaat hier natuurlijk over JPEG-bestanden. Niet alleen bestaan er talloze hulpmiddelen en bestaande methoden voor het insluiten van gegevens erin, het is ook nog eens het populairste grafische formaat op deze planeet.
Toch, om niet in hondenfokkerij te vervallen, moet men zijn werkterrein beperken tot bestanden van dit formaat. Niemand houdt van eentonige vierkantjes die ontstaan door overmatige compressie, dus moet men zich beperken tot het werken met een al gecomprimeerd bestand, waarbij opnieuw coderen wordt vermeden. Concreet gezegd - met gehele coefficienten, die overblijven na operaties die verantwoordelijk zijn voor gegevensverlies - DCT en kwantisatie, wat prachtig wordt weergegeven in het coderingsschema (dank aan de wiki van de nationale bibliotheek van Bauman):
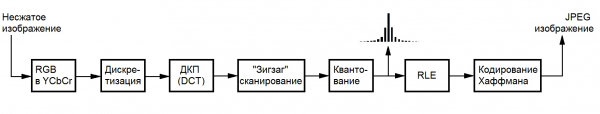
Er zijn tal van mogelijke methoden voor het optimaliseren van jpeg-bestanden. Er is compressie zonder verlies (jpegtran), er is de compressie ““, die in feite nog meer bijdragen, maar ons niet interesseren. Want als een gebruiker bereid is om de ene informatie in de andere in te sluiten voor het vergroten van de vrije ruimte op de schijf, dan heeft hij zijn afbeeldingen of al geoptimaliseerd, of wil hij dat helemaal niet doen uit angst voor kwaliteitsverlies.
F5
Voor deze voorwaarden is er een hele reeks algoritmen geschikt, waarmee men zich kan vertrouwd maken. . Het meest geavanceerde van hen is het algoritme onder leiding van Andreas Westfeld, die werkt met het coëfficiënt van de helderheidscomponenten, omdat het menselijke oog het minst gevoelig is voor veranderingen daarin. Bovendien maakt het gebruik van een inbeddingsmethodiek, gebaseerd op matrixcodering, waardoor het mogelijk is om minder veranderingen aan te brengen bij het inbedden van dezelfde hoeveelheid informatie, naarmate de grootte van de gebruikte container toeneemt.
De veranderingen zelf komen neer op het verlagen van de absolute waarde van de coëfficiënten met één in bepaalde omstandigheden (dat wil zeggen, niet altijd), wat het mogelijk maakt om F5 te gebruiken voor het optimaliseren van de opslag van gegevens op een harde schijf. Het punt is dat de coëfficiënt na zo'n wijziging waarschijnlijk minder bits zal innemen na het uitvoeren van Huffman-codering vanwege de statistische verdeling van waarden in JPEG, en de nieuwe nullen zullen voordelen bieden bij het coderen ervan met behulp van RLE.
De noodzakelijke aanpassingen komen neer op het verwijderen van het gedeelte dat verantwoordelijk is voor de geheimhouding (wachtwoordverwisseling), wat helpt om middelen en uitvoeringstijd te besparen, en het toevoegen van een mechanisme dat met meerdere bestanden tegelijk werkt in plaats van één per keer. Gedetailleerdere informatie over het wijzigingsproces zal de lezer waarschijnlijk niet interesseren, dus laten we overgaan naar de beschrijving van de implementatie.
Hoogtechnologie
Om te demonstreren hoe deze aanpak werkt, heb ik een methode geïmplementeerd in puur C en een reeks optimalisaties uitgevoerd, zowel qua uitvoeringstijd als qua geheugen (je kunt je niet voorstellen hoeveel die afbeeldingen zonder compressie zelfs tot DCT wegen). Cross-platform functionaliteit is bereikt door een combinatie van bibliotheken te gebruiken. , en , waarvoor mijn dank. Dit wordt allemaal samengebracht met ‘make’, dus Windows-gebruikers willen misschien Cygwin installeren om het uit te proberen, of zelf aan de slag gaan met Visual Studio en de bibliotheken.
De implementatie is beschikbaar als een consoletool en bibliotheek. Meer over het gebruik van de laatste kunnen geïnteresseerden lezen in de readme in de repository op GitHub, waarvan ik de link aan het einde van de post zal bijvoegen.
Hoe te gebruiken?
Voorzichtig. De gebruikte afbeeldingen voor de verpakking worden geselecteerd via reguliere expressies in de opgegeven rootdirectory. Na voltooiing kunnen bestanden naar wens binnen deze directory worden verplaatst, hernoemd en gekopieerd, kunnen besturingssystemen en bestandsformaten worden veranderd, enzovoorts. Het is echter uiterst belangrijk om voorzichtig te zijn en de directe inhoud niet aan te passen. Het verlies van slechts één bit kan leiden tot een onomkeerbaar verlies van informatie.
Na het uitvoeren van het programma laat de tool een speciaal archiefbestand achter met alle noodzakelijke informatie voor het uitpakken, inclusief gegevens over de gebruikte afbeeldingen. Dit bestand is zelf ongeveer een paar kilobyte groot en heeft geen significant effect op de gebruikte schijfruimte.
Je kunt de mogelijke capaciteit analyseren met de vlag ‘-a’: ‘./f5ar -a [zoekmap] [Perl-compatibele reguliere expressie]’. Verpakking gebeurt met het commando ‘./f5ar -p [zoekmap] [Perl-compatibele reguliere expressie] [te verpakken bestand] [archiefnaam]’, en uitpakken gebeurt met ‘./f5ar -u [archiefbestand] [herstelde bestandsnaam]’.
Demonstratie van het werk
Om de effectiviteit van de methode te tonen, heb ik een verzameling van 225 volledig gratis hondenfoto's van de service geüpload. en vond een groot pdf-bestand van 45 meter van deel twee in de documenten Knuth.
De volgorde is vrij eenvoudig:
$ du -sh knuth.pdf dogs/
44M knuth.pdf
633M dogs/

$ ./f5ar -p dogs/ .*jpg knuth.pdf dogs.f5ar
Lezen van het te comprimeren bestand... ok
Initiëren van het archief... ok
Analyseren van de bibliografische capaciteit... gedaan in 17.0s
Gegarandeerde capaciteit gedetecteerd van 48439359 bytes
Mogelijke capaciteit tot 102618787 bytes gedetecteerd
Comprimeren... gedaan in 39.4s
Opslaan van het archief... ok

$ ./f5ar -u dogs/dogs.f5ar knuth_unpacked.pdf
Initiëren van het archief... ok
Lezen van het archiefbestand... ok
Vullen van het archief met bestanden... gedaan in 1.4s
Decomprimeren... gedaan in 21.0s
Schrijven van geëxtraheerde gegevens... ok

$ sha1sum knuth.pdf knuth_unpacked.pdf
5bd1f496d2e45e382f33959eae5ab15da12cd666 knuth.pdf
5bd1f496d2e45e382f33959eae5ab15da12cd666 knuth_unpacked.pdf

$ du -sh dogs/
551M dogs/
Schermafbeeldingen voor liefhebbers
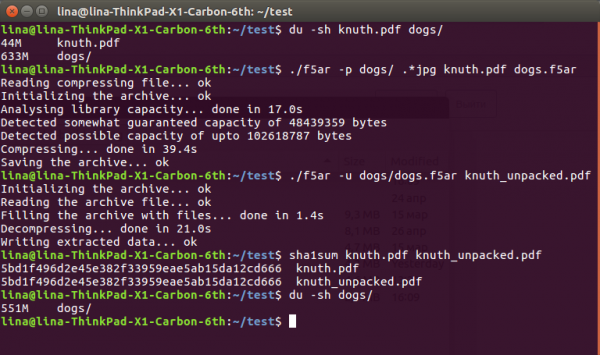
Het uitgepakte bestand kan en moet nog steeds gelezen worden:
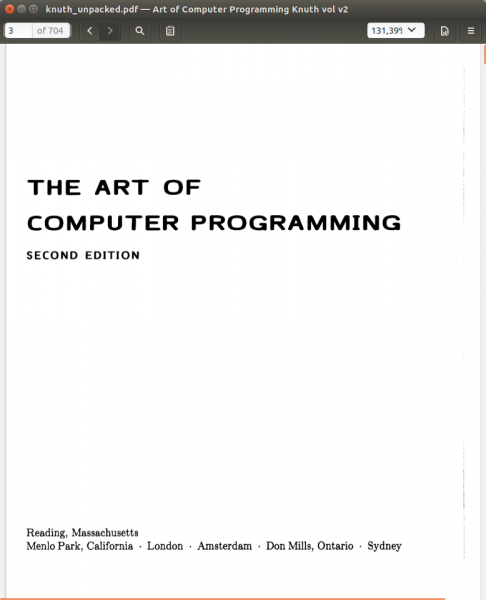
Zoals te zien is, zijn we van de oorspronkelijke 633 + 36 == 669 megabyte gegevens op de harde schijf gekomen naar een aangenamere 551. Dit radicale verschil wordt verklaard door de afname van de waarden van de coëfficiënten, die invloed hebben op hun latere verliesloze compressie: een vermindering van slechts één kan gemakkelijk een paar bytes van het uiteindelijke bestand "snijden". Desondanks zijn dit nog steeds gegevensverlies, hoe klein ook, waarmee we moeten leren omgaan.
Gelukkig zijn ze voor het oog absoluut niet zichtbaar. Onder de spoiler (aangezien habrastorage niet met grote bestanden om kan gaan) kan de lezer het verschil zowel visueel als de intensiteit beoordelen die verkregen is door de waarden van de gewijzigde componenten van de originele af te trekken: , , (hoe vervager de kleur, hoe kleiner het verschil in het blok).
Ter afsluiting
Gezien al deze complicaties kan het kopen van een harde schijf of het uploaden van alles naar de cloud een veel eenvoudigere oplossing voor het probleem lijken. Maar hoewel we nu in zulke prachtige tijden leven, zijn er geen garanties dat we morgen nog steeds op internet kunnen komen en al onze overtollige gegevens ergens kunnen uploaden. Of naar de winkel kunnen gaan en een nieuwe harde schijf van duizend terabyte kunnen kopen. Maar met wat er al thuis ligt, kan altijd gebruikt worden.
->
Bron: habr.com
