

De ontwikkeling van een datawarehouse is een langdurige en serieuze aangelegenheid.
Veel in het leven van een project hangt af van hoe goed het objectmodel en de database-structuur bij de start zijn doordacht.
De gangbare aanpak blijft in verschillende varianten van de combinatie van het 'ster'-schema met de derde normale vorm. Over het algemeen geldt het principe: brondgegevens — 3NF, datawarehouses — ster. Deze benadering, die door de tijd heen is bewezen en ondersteund wordt door een groot aantal studies, is het eerste (en soms het enige) waar een ervaren DWH-specialist aan denkt als het gaat om hoe een analytisch datawarehouse eruit zou moeten zien.
Aan de andere kant is het bedrijfsleven in het algemeen en de eisen van de klant in het bijzonder onderhevig aan snelle veranderingen, terwijl gegevens zowel 'in diepte' als 'in breedte' groeien. En hier blijkt het belangrijkste nadeel van de ster — de beperkte flexibiliteit.
En als er plotseling in uw rustige en gezellige leven van een DWH-ontwikkelaar:
- de taak is ontstaan om 'snel iets te doen, en dan zien we wel';
- er een snelgroeiend project is, met de aansluiting van nieuwe bronnen en een herziening van het businessmodel minimaal eenmaal per week;
- er een klant is die niet weet hoe het systeem eruit zou moeten zien en welke functies het uiteindelijk moet vervullen, maar wel bereid is om te experimenteren en het gewenste resultaat stapsgewijs te verduidelijken;
- er een projectmanager langskwam met het blije nieuws: 'En nu hebben we agile!'.
Of als u gewoon benieuwd bent naar andere manieren om datawarehouses te bouwen - welkom onder de kat!
Wat betekent 'flexibiliteit'
Laten we beginnen met te bepalen welke eigenschappen het systeem moet hebben, zodat we het 'flexibel' kunnen noemen.
Het moet apart worden opgemerkt dat de beschreven eigenschappen specifiek betrekking moeten hebben op het netwerk, en niet op het proces van zijn ontwikkeling. Dus als u wilde lezen over Agile als ontwikkelingsmethodologie, kunt u beter andere artikelen raadplegen. Bijvoorbeeld, hier op Habr zijn er veel interessante materialen (zoals en , als voor ).
Dit betekent echter niet dat het ontwikkelingsproces en de structuur van het datawarehouse helemaal niet met elkaar zijn verbonden. Over het algemeen zou het ontwikkelen van een flexibele architectuur volgens Agile aanzienlijk eenvoudiger moeten zijn. In de praktijk komen echter vaker varianten voor waarbij Agile wordt toegepast op een klassiek DWH volgens Kimball of DataVault — met watervalmethodes, eerder dan gelukkig toeval van flexibiliteit in beide vormen in één project.
En wat voor mogelijkheden moet een flexibel datawarehouse bevatten? Hier kunnen drie punten worden onderscheiden:
- Vroeg leveren en snel aanpassen — dit betekent dat in een ideaal scenario de eerste zakelijke resultaten (bijvoorbeeld de eerste werkende rapporten) zo snel mogelijk moeten worden behaald, dus nog voordat het systeem volledig is ontworpen en geïmplementeerd. Daarbij zou elke volgende aanpassing ook zo min mogelijk tijd moeten kosten.
- Iteratieve aanpassing — dit betekent dat bij elke volgende aanpassing in principe de reeds werkende functionaliteit niet mag worden aangetast. Dit punt is vaak de grootste nachtmerrie in grote projecten — vroeg of laat beginnen afzonderlijke objecten zoveel relaties te krijgen dat het gemakkelijker wordt om de logica compleet te dupliceren in een nieuwe kopie dan om een veld aan een bestaande tabel toe te voegen. En als je je afvraagt waarom de impactanalyse van een aanpassing op bestaande objecten meer tijd kan kosten dan de aanpassing zelf — dan heb je waarschijnlijk nog niet met grote datawarehouses in de banksector of telecom gewerkt.
- Voortdurende aanpassing aan veranderende zakelijke eisen — de algemene objectstructuur moet niet alleen zijn ontworpen met het oog op mogelijke uitbreiding, maar ook met de veronderstelling dat de richting van deze uitbreiding je op het moment van ontwerp niet kon worden voorgesteld.
En ja, het voldoen aan al deze eisen in één systeem is mogelijk (natuurlijk onder bepaalde omstandigheden en met enkele voorwaarden).
Hieronder bespreek ik de twee populairste methodologieën voor flexibele ontwerpprincipes voor datawarehouses — Anchor model en Data Vault. Buiten beschouwing blijven prachtige technieken zoals EAV, 6NF (in zuivere vorm) en alles wat betrekking heeft op NoSQL-oplossingen - niet omdat ze op een of andere manier slechter zijn, en ook niet omdat het anders het artikel zou laten uitgroeien tot het volume van een gemiddelde scriptie. Het is gewoon dat alles dit betreft oplossingen van een andere klasse - of technieken die je in specifieke gevallen kunt toepassen, ongeacht de algemene architectuur van je project (zoals EAV), of fundamenteel andere paradigma's voor gegevensopslag (zoals bijvoorbeeld grafdatabases en andere vormen van NoSQL).
Problemen van de 'klassieke' aanpak en hun oplossingen in flexibele methodologieën
Met de 'klassieke' aanpak bedoel ik de oude vertrouwde ster (ongeacht de specifieke implementatie van de onderliggende lagen, vergeef me de aanhangers van Kimball, Inmon en CDM).
1. Strikte kardinaliteit van relaties
In de basis van dit model ligt een duidelijke scheiding van gegevens in dimensies (Dimension) en feiten (Fact). En dat is, verdomd, logisch - immers, data-analyse komt in de meeste gevallen neer op de analyse van bepaalde numerieke indicatoren (feiten) in bepaalde snits (dimensies).
De relaties tussen objecten worden vastgelegd in de vorm van relaties tussen tabellen via een vreemde sleutel. Dit lijkt heel natuurlijk, maar leidt onmiddellijk tot de eerste beperking van flexibiliteit - de strikte definitie van de kardinaliteit van relaties.
Dit betekent dat je in de ontwerpfase van tabellen precies moet bepalen of elk paar gerelateerde objecten kan worden geclassificeerd als veel-op-veel, of alleen één-op-veel, en 'in welke richting'. Dit heeft direct invloed op welke tabel de primaire sleutel en welke de vreemde sleutel zal hebben. Het wijzigen van deze relatie bij nieuwe vereisten zal zeer waarschijnlijk leiden tot herontwerp van de database.
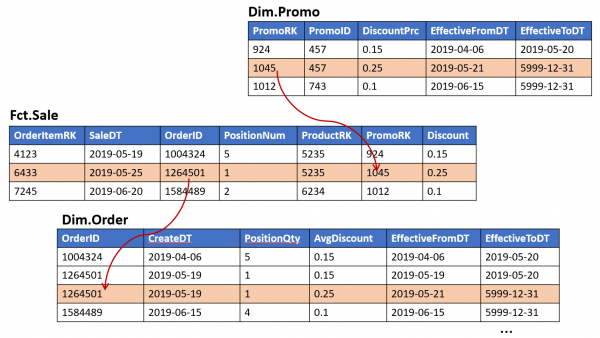
Bijvoorbeeld, wanneer je het object 'aankoopbon' ontwerpt, heb je, vertrouwend op de plechtige beloften van de verkoopafdeling, de mogelijkheid voorzien voor de werking van één promotieactie op meerdere bonlijnen (maar niet vice versa):
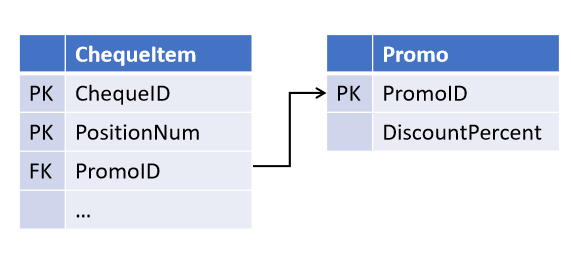
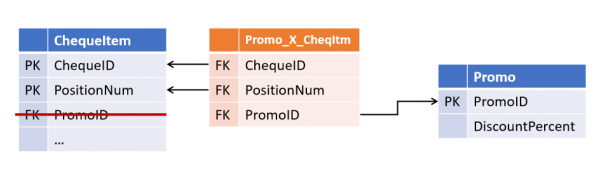
En na een tijdje heeft de marketingafdeling een nieuwe strategie ingevoerd, waarbij meerdere promotieacties tegelijkertijd voor dezelfde positie kunnen gelden. En nu moet je de tabellen aanpassen door de relatie in een apart object te выделить..
(Alle afgeleide objecten waarin de join check op promoties plaatsvindt, hebben nu ook aanpassingen nodig).
Relaties in Data Vault en Anchor Model
Het bleek vrij eenvoudig om zo'n situatie te vermijden: geloof de salesafdeling niet, daarvoor is het voldoende om alle relaties in aparte tabellen te bewaren en te verwerken als veel-naar-veel.
Deze aanpak werd voorgesteld door Dan Linstedt als onderdeel van de paradigma Data Vault en werd volledig ondersteund door Lars Rönnbäck in Anchor Model.
Uiteindelijk krijgen we de eerste onderscheidende eigenschap van flexibele methodologieën:
Relaties tussen objecten worden niet opgeslagen in de attributen van ouderentiteiten, maar vormen een apart type objecten.
In Data Vault Deze verbindende tabellen worden genoemd Link, en in Anchor Model — Tie. Op het eerste gezicht lijken ze erg op elkaar, hoewel hun verschillen niet alleen door de namen worden uitgedrukt (daarover later meer). In beide architecturen kunnen verbindende tabellen elke hoeveelheid entiteiten koppelen (niet noodzakelijk 2).
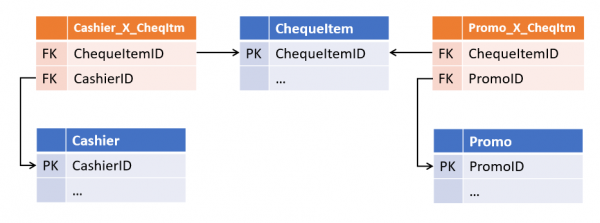
Deze op het eerste gezicht redundantie biedt aanzienlijke flexibiliteit bij aanpassingen. Deze structuur wordt tolerant, niet alleen voor wijzigingen in de kardinaliteit van bestaande relaties, maar ook voor het toevoegen van nieuwe — als er nu een verwijzing naar de kassière die de bon heeft geboekt, aan de bonnenpositie wordt toegevoegd, wordt het ontstaan van zo'n verbinding eenvoudig een uitbreiding bovenop bestaande tabellen zonder invloed op bestaande objecten en processen.
2. Gegevensduplicatie
Het tweede probleem dat flexibele architecturen oplossen is minder voor de hand liggend en is vooral kenmerkend voor SCD2-type metingen (sloom veranderende metingen van de tweede soort), hoewel niet alleen voor hen.
In een klassiek gegevensmagazijn vertegenwoordigt een meting meestal een tabel die een surrogaat sleutel (als PK) bevat, evenals een set zakelijke sleutels en attributen in afzonderlijke kolommen.
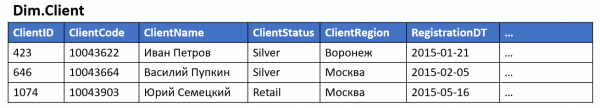
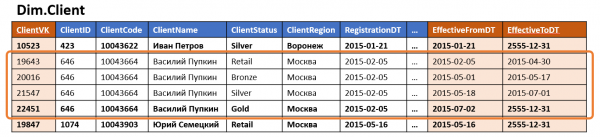
Als de meting versiebeheer ondersteunt, worden tijdslimieten voor de versie aan de standaard set velden toegevoegd, en in de bron verschijnt meerdere versies in het opslag (één voor elke wijziging van de versieattributen).
Als de meting ten minste één vaak veranderende versie-attribuut bevat, zal het aantal versies van die meting aanzienlijk zijn (zelfs als de andere attributen niet-versioneerbaar zijn of nooit veranderen), en als er meerdere van dergelijke attributen zijn, kan het aantal versies geometrisch toenemen naarmate hun aantal groeit. Zo'n meting kan een aanzienlijke hoeveelheid schijfruimte innemen, hoewel het grootste deel van de opgeslagen gegevens eenvoudig duplicaten zijn van de waarden van onveranderlijke attributen uit andere rijen.
Vaak wordt ook denormalisatie toegepast — sommige attributen worden opzettelijk als waarde opgeslagen, in plaats van als verwijzing naar een referentietabel of andere metingen. Deze aanpak versnelt de toegang tot gegevens en vermindert het aantal joins bij het opvragen van de meting.
In de regel leidt dit ertoe dat dezelfde informatie tegelijkertijd op meerdere plaatsen wordt opgeslagen. Bijvoorbeeld, informatie over de woonregio en de categorie waartoe een klant behoort, kan tegelijkertijd worden opgeslagen in de metingen "Klant" en in de feiten "Aankoop", "Levering" en "Contact met de klantenservice", evenals in de verbindende tabel "Klant — Klantenmanager."
In het algemeen geldt wat hierboven is beschreven ook voor gewone (niet-versioneerbare) metingen, maar bij versioneerbare metingen kan dit een andere schaal hebben: het verschijnen van een nieuwe versie van een object (vooral met terugwerkende kracht) leidt niet alleen tot een update van alle gerelateerde tabellen, maar tot een cascade van nieuwe versies van gerelateerde objecten — wanneer Tabel 1 wordt gebruikt bij het opbouwen van Tabel 2, en Tabel 2 bij het opbouwen van Tabel 3, enz. Zelfs als geen enkel attribuut uit Tabel 1 bij het opbouwen van Tabel 3 betrokken is (waarbij andere attributen uit Tabel 2, verkregen uit andere bronnen, betrokken zijn), zal de versionering van deze opstelling minstens extra overhead met zich meebrengen, en maximaal leiden tot onnodige versies in Tabel 3, die hier eigenlijk “niet bij betrokken” is, en verderop in de keten.
3. Niet-lineaire complexiteit van verbeteringen
Bij elke nieuwe etalage die op basis van een andere is opgebouwd, neemt het aantal plaatsen toe waar gegevens kunnen "afwijken" bij wijzigingen in ETL. Dit leidt op zijn beurt tot een toename van de complexiteit (en duur) van elke volgende aanpassing.
Als het bovenstaande van toepassing is op systemen met zelden aangepaste ETL-processen, is het mogelijk om in zo'n paradigma te blijven — het enige wat nodig is, is ervoor te zorgen dat nieuwe aanpassingen correct in alle gerelateerde objecten worden aangebracht. Als de aanpassingen echter vaak plaatsvinden, neemt de kans aanzienlijk toe dat er per ongeluk enkele verbindingen "verloren gaan."
Als we daarnaast in overweging nemen dat een "versie-gebaseerde" ETL aanzienlijk complexer is dan een "niet-versie-gebaseerde," wordt het redelijk moeilijk om fouten te vermijden bij frequente aanpassingen aan al deze zaken.
Opslag van objecten en attributen in Data Vault en Anchor Model
De aanpak die door de auteurs van flexibele architecturen wordt voorgesteld, kan als volgt worden samengevat:
Het is noodzakelijk om te scheiden wat verandert van wat onveranderlijk blijft. Dat wil zeggen, de sleutels apart opslaan van de attributen.
Bij dit alles moet men niet verwarren niet-versie-gebaseerd attribut met onveranderlijk: de eerste houdt geen geschiedenis van de wijzigingen bij, maar kan wel veranderen (bijvoorbeeld bij het corrigeren van invoerfouten of het ontvangen van nieuwe gegevens), de tweede verandert nooit.
De meningen over wat precies als onveranderlijk kan worden beschouwd in Data Vault en het Anchor Model lopen uiteen.
Vanuit architecturaal perspectief Data Vault, kan men beschouwen als onveranderlijk de hele set sleutels — natuurlijke (BTW-nummer van de organisatie, productcode in het bronsysteem, enz.) en surrogaten. De overige attributen kunnen worden ingedeeld in groepen op basis van bron en/of wijzigingsfrequentie en voor elke groep moet een aparte tabel worden beheerd met een onafhankelijke set versies.
In de paradigm van het Anchor Model wordt als onveranderlijk beschouwd slechts de surrogatesleutel van de entiteit. Alles wat daarbij komt (inclusief natuurlijke sleutels) is gewoon een bijzonder geval van zijn attributen. Hierbij zijn alle attributen standaard onafhankelijk van elkaar, dus voor elk attribuut moet er een aparte tabel worden aangemaakt..
In Data Vault De tabellen die de sleutels van de entiteiten bevatten, worden Hubs genoemd.Hubs bevatten altijd een vaste set velden:
- Natuurlijke sleutels van de entiteit
- Surrogatesleutel
- Verwijzing naar de bron
- Tijdstip van toevoeging van het record
Records in Hubs worden nooit gewijzigd en hebben geen versies.. Extern lijkt de hub veel op ID-map tabellen die in sommige systemen worden gebruikt voor het genereren van surrogaten, maar in Data Vault wordt aanbevolen om niet een geheel getal sequence als surrogaten toe te passen, maar een hash van de set van zakelijke sleutels. Deze aanpak vereenvoudigt het laden van relaties en attributen uit bronnen (er is geen join nodig op de hub om het surrogate te verkrijgen, het is voldoende om eenvoudig de hash van de natuurlijke sleutel te berekenen), maar kan andere problemen veroorzaken (bijvoorbeeld met botsingen, hoofdletters en niet-afdrukbare symbolen in string sleutels, enz.), daarom is het geen algemeen geaccepteerde methode.
Alle andere attributen van entiteiten worden opgeslagen in speciale tabellen die Satellieten worden genoemd (Satellit). Eén hub kan meerdere satellieten hebben die verschillende sets attributen opslaan.
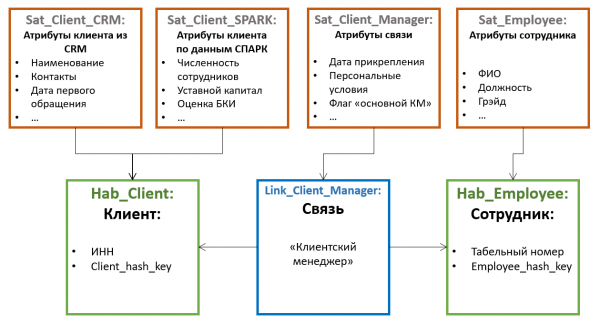
De verdeling van attributen over satellieten gebeurt volgens het principe van gezamenlijke wijziging — in één satelliet kunnen niet-versie-attributen worden opgeslagen (bijvoorbeeld geboortedatum en BSN voor een natuurlijk persoon), in een andere — zelden veranderende versie-attributen (bijvoorbeeld achternaam en paspoortnummer), in een derde — vaak veranderende (bijvoorbeeld bezorgadres, categorie, datum van de laatste bestelling, enz.). De versiebaarheid wordt hierbij op het niveau van afzonderlijke satellieten beheerd, en niet op het niveau van de entiteit als geheel, daarom is het zinvol om attributen zo te verdelen dat de overlap van versies binnen één satelliet minimaal is (wat de totale hoeveelheid opgeslagen versies verkort).
Daarnaast worden, ter optimalisatie van het gegevensladingsproces, vaak attributen die uit verschillende bronnen worden verkregen in aparte satellieten geplaatst.
Satellieten worden verbonden met de hub via een buitenlandse sleutel (wat overeenkomt met de cardinaliteit van 1 tot veel). Dit betekent dat meervoudige waardeattributen (bijvoorbeeld meerdere telefoonnummers voor één klant) door deze architectuur standaard worden ondersteund.
In Het Anker Model (Anchor Model) tabellen die sleutels opslaan, worden genoemd Ankers (Anchor). En ze slaan op:
- Alleen surrogaten sleutels
- Verwijzing naar de bron
- Tijdstip van toevoeging van het record
Natuurlijke sleutels worden vanuit het perspectief van het Anker Model beschouwd als gewone attributen. Deze optie kan complexer lijken om te begrijpen, maar biedt veel meer ruimte voor de identificatie van objecten.
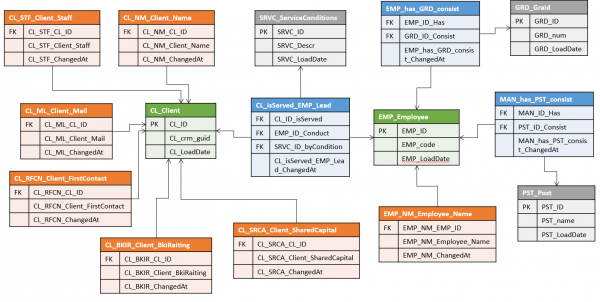
Bijvoorbeeld, als gegevens over dezelfde entiteit vanuit verschillende systemen komen, waarbij elk systeem zijn eigen natuurlijke sleutel gebruikt. In Data Vault kan dit leiden tot nogal omvangrijke constructies van meerdere hubs (één per bron + een samenvoegende masterversie), terwijl in het Anker Model de natuurlijke sleutel van elke bron in zijn eigen attribuut terechtkomt en onafhankelijk van alle andere kan worden gebruikt tijdens het laden.
Maar hier schuilt een sluw punt: als in één entiteit attributen uit verschillende systemen worden samengevoegd, zijn er hoogstwaarschijnlijk bepaalde regels voor samenvoeging, waar de systeem moet begrijpen dat records uit verschillende bronnen overeenkomen met één exemplaar van de entiteit.
In Data Vault Deze regels zullen waarschijnlijk het vormen van "surrogaten hubs" van master-entiteiten en hebben geen invloed op de Hubs die de natuurlijke sleutels van bronnen en hun oorspronkelijke attributen opslaan. Als op een gegeven moment de samenvoegingsregels veranderen (of er een update van de attributen komt waarmee deze wordt uitgevoerd), zal het voldoende zijn om de surrogaten hubs opnieuw te vormen.
In Het Anker Model zo'n entiteit waarschijnlijk in één enkele anker. Dit betekent dat alle attributen, ongeacht de bron waarvan ze afkomstig zijn, aan hetzelfde surrogate zullen worden gekoppeld. Het scheiden van onterecht samengevoegde records en het in het algemeen volgen van de actualiteit van de samenvoeging kan in zo'n systeem aanzienlijk moeilijker blijken te zijn, vooral als de regels behoorlijk complex zijn en vaak veranderen, en hetzelfde attribuut uit verschillende bronnen kan worden verkregen (hoewel dit precies mogelijk is, aangezien elke versie van het attribuut een link naar zijn bron bewaard).
In ieder geval, als in uw systeem functionaliteiten van deduplicatie, record-samenvoeging en andere MDM-elementenworden verondersteld, is het bijzonder belangrijk om de aspecten van het opslaan van natuurlijke sleutels in flexibele methodologieën zorgvuldig te bestuderen. Vermoedelijk zal de meer omvangrijke constructie van Data Vault plotseling veiliger blijken te zijn wat betreft samenvoegfouten.
Het Anker Model biedt ook een extra type object aan, genaamd Knoop (Knot) dit is in wezen een speciale degenerate vorm van een anker, die slechts één attribuut kan bevatten. Knoopstructuren zijn bedoeld voor het opslaan van platte gegevensmodellen (zoals geslacht, burgerlijke staat, klantenservicecategorieën, enz.). In tegenstelling tot Ankers hebben Knopen geen verbonden attribuuttabellen, en het enige attribuut (naam) wordt altijd in dezelfde tabel met de sleutel opgeslagen. Knopen worden aan Ankers verbonden via verbindings-tabellen (Tie), net zoals ankers aan elkaar.
Er is geen eenduidige mening over het gebruik van Knopen. Bijvoorbeeld, , die het gebruik van het Ankermodel in Rusland actief promoot, is (niet zonder reden) van mening dat voor geen enkele gegevensstructuur met zekerheid kan worden gesteld dat deze altijd statistisch en eendimensionaal zal zijn, en daarom is het beter om voor alle objecten meteen een volledig Anker te gebruiken.
Een ander belangrijk verschil tussen Data Vault en het Ankermodel is het bestaan van attributen bij verbindingen.:
In Data Vault Verbonden objecten zijn net zo volwaardige objecten als Hubs, en kunnen eigen attributen hebben.wordt een tabel met wijzigingen en instructies voor de overgang naar de nieuwe configuratie gegeven. Voor meer informatie, zie Het Anker Model Verbonden objecten worden alleen gebruikt om Ankers te verbinden en kunnen geen eigen attributen hebben.. Dit verschil leidt tot wezenlijk verschillende benaderingen van modelvorming, feiten, waarover later meer.
Opslag van feiten
Tot nu toe hebben we voornamelijk over het modelleren van dimensies gesproken. Het is minder eenduidig met feiten.
In Data Vault Een typisch object voor het opslaan van feiten is Verbinding (Link), waarin reële indicatoren worden opgeslagen in Satellieten.
Deze benadering lijkt intuïtief begrijpelijk. Het biedt gemakkelijke toegang tot te analyseren indicatoren en lijkt in het algemeen op een traditionele feitentabel (alleen worden de indicatoren niet in de tabel zelf opgeslagen, maar in een 'buren'-tabel). Maar er zijn ook verborgen complicaties: een van de typische uitbreidingen van het model — het uitbreiden van de feitensleutel — leidt tot de noodzaak van het toevoegen van een nieuwe externe sleutel in de Link.. Dit 'breekt' op zijn beurt de modulariteit en kan potentieel tot aanpassingen van andere objecten leiden.
In Het Anker Model Een verbinding kan geen eigen attributen hebben, dus deze benadering zal niet werken — alle attributen en indicatoren moeten een specifieke binding aan een bepaalde anker hebben. De conclusie is eenvoudig — voor elk feit is ook een eigen anker nodig.Voor een deel van wat we gewend zijn als feiten, lijkt dit natuurlijk — bijvoorbeeld, de aankoop kan worden teruggebracht tot het object 'bestelling' of 'bon', een bezoek aan de website tot een sessie, enzovoort. Maar er zijn ook feiten waarvoor het niet zo eenvoudig is om zo'n natuurlijk 'drager-object' te vinden — zoals de voorraad van goederen op de voorraad bij aanvang van elke dag.
Bijgevolg zijn er geen problemen met de modulariteit bij het uitbreiden van de feitelijke sleutel in het Anker-model (het is genoeg om eenvoudig een nieuwe Relatie aan de bijbehorende Anker toe te voegen), maar het ontwerpen van de model voor het weergeven van feiten is minder eenduidig; er kunnen 'artificiële' Ankers ontstaan die de objectieve bedrijfsmodel niet duidelijk weergeven.
Hoe flexibiliteit wordt bereikt
De resulterende constructie bevat in beide gevallen aanzienlijk meer tabellen, dan traditionele metingen. Maar kan aanzienlijk minder schijfruimte innemen met dezelfde set versie-attributen als de traditionele meting. Uiteraard is hier geen magie — het is allemaal een kwestie van normalisatie. Door attributen te verdelen over Satellieten (in Data Vault) of afzonderlijke tabellen (Anker-model), verminderen we (of elimineren we helemaal) het dupliceren van waarden van sommige attributen bij het wijzigen van andere.
Voor Data Vault de winst zal afhangen van de verdeling van attributen over Satellieten, en voor Het Anker Model — is Praktisch recht evenredig met het gemiddelde aantal versies op het meetobject.
Echter, de winst in gebruikte ruimte is een belangrijk, maar niet het belangrijkste voordeel van afzonderlijke opslag van attributen. Samen met de afzonderlijke opslag van relaties, maakt deze benadering het opslagmodel modulaire constructie. Dit betekent dat het toevoegen van zowel afzonderlijke attributen als hele nieuwe domeinen in zo'n model eruitziet als een uitbreiding bovenop de bestaande set objecten zonder deze te wijzigen. En dat is precies wat de beschreven methodologieën flexibel maakt.
Het doet ook denken aan de overgang van stukproductie naar massaproductie — als in de traditionele benadering elke tabel in het model uniek is en afzonderlijke aandacht vereist, dan in flexibele methodologieën — is dit al een set standaard 'onderdelen'. Enerzijds worden er meer tabellen, en de processen voor het laden en ophalen van gegevens moeten er complexer uitzien. Aan de andere kant — ze worden standaard. En dat betekent dat ze kunnen zijn geautomatiseerd en beheerd met metadata. De vraag "hoe gaan we het indelen?" was voorheen een aanzienlijk deel van het ontwerpproces voor wijzigingen; deze vraag is nu eenvoudigweg niet meer aan de orde (net zoals de vraag over de impact van modelwijzigingen op de lopende processen).
Dit betekent niet dat analisten in zo'n systeem helemaal niet nodig zijn - iemand moet nog steeds een set objecten met attributen doorwerken en begrijpen waar en hoe dit alles geladen wordt. Maar de hoeveelheid werk en de kans en kosten van fouten nemen aanzienlijk af. Zowel in de analysefase als tijdens de ontwikkeling van ETL, wat voor een groot deel kan neerkomen op het bewerken van metadata.
De donkere kant
Alles wat hierboven is beschreven, maakt beide benaderingen echt flexibel, technologisch en geschikt voor iteratieve aanpassingen. Natuurlijk is er ook een "vuiltje in de pruimencompote", waarvan je waarschijnlijk al een idee hebt.
De decompositie van gegevens, die ten grondslag ligt aan de modulariteit van flexibele architecturen, leidt tot een toename van het aantal tabellen en dus overheadkosten voor joins bij het selecteren. Om simpelweg alle meetattributen te verkrijgen, is in een klassiek datacenter slechts één select nodig, terwijl een flexibele architectuur een hele reeks joins vereist. En als deze joins voor rapporten vooraf kunnen worden geschreven, zullen analisten die gewend zijn om SQL met de hand te schrijven, dubbel lijden.
Er zijn verschillende feiten die deze situatie vergemakkelijken:
Bij het werken met grote dimensies worden bijna nooit alle attributen tegelijk gebruikt. Dit betekent dat het aantal joins minder kan zijn dan het op het eerste gezicht lijkt. In Data Vault kan ook rekening worden gehouden met de verwachte frequentie van gezamenlijk gebruik bij het verdelen van attributen over satellites. De hubs of anchors zijn in eerste instantie vooral nodig voor de generatie en mapping van surrogate keys tijdens de laadfase en worden zelden in queries gebruikt (dit geldt vooral voor anchors).
Alle joins zijn op sleutel. Bovendien verlaagt een 'compactere' manier van gegevensopslag de overhead voor het scannen van tabellen waar dat nodig is (bijvoorbeeld bij filtering op attribuutwaarden). Dit kan ertoe leiden dat een query uit een genormaliseerde database met veel joins zelfs sneller is dan het scannen van één grote dimensietabel met veel versies per regel.
Bijvoorbeeld, in dit artikel is er een gedetailleerde vergelijkingstest van de Prestatiemodel met een sample uit één tabel.
Een en ander hangt af van de engine. Veel moderne platforms hebben interne mechanismen voor het optimaliseren van joins. Bijvoorbeeld, MS SQL en Oracle kunnen joins naar tabellen overslaan als hun gegevens nergens anders worden gebruikt dan in andere joins en geen invloed hebben op de uiteindelijke query (table/join elimination), en MPP Vertica heeft volgens , zich bewezen als een uitstekende engine voor het Prestatiemodel met enige handmatige optimalisatie van het queryplan. Aan de andere kant lijkt het opslaan van het Prestatiemodel, bijvoorbeeld op Click House, dat beperkte ondersteuning voor joins heeft, voorlopig geen goede idee.
Bovendien bestaan er voor beide architecturen speciale technieken, die de toegang tot gegevens vergemakkelijkt (zowel vanuit het perspectief van query-prestaties als voor eindgebruikers). Bijvoorbeeld, Point-In-Time tabellen in Data Vault of speciale tabel functies in het Prestatiemodel.
Total
De essentie van de besproken flexibele architecturen ligt in de modulariteit van hun 'constructie'.
Precies deze eigenschap maakt het mogelijk:
- Na enige initiële voorbereiding, die verband houdt met de implementatie van metadata en het schrijven van basis ETL-algoritmen, snel de eerste resultaten aan de klant te leveren in de vorm van een paar rapporten die gegevens van slechts enkele gegevensbronnen bevatten. Het is niet nodig om de gehele objectmodel grondig te plannen (zelfs op een hoog niveau) voor dit doel.
- Een datamodel kan al beginnen te functioneren (en waarde te leveren) met slechts 2-3 objecten, en kan daarna geleidelijk uitbreiden (met betrekking tot het Prestatiemodel gebruikte Nikolai De meeste aanpassingen, waaronder de uitbreiding van het toepassingsgebied en het toevoegen van nieuwe bronnen,
- hebben geen invloed op de bestaande functionaliteit en vormen geen risico om iets wat al werkt te breken. raakt de bestaande functionaliteit niet aan en vormt geen gevaar om iets dat al werkt te breken.
- Door de decompositie in standaardelementen lijken ETL-processen in dergelijke systemen op elkaar, hun schrijven kan worden geautomatiseerd en uiteindelijk geautomatiseerd worden.
De prijs voor deze flexibiliteit is de prestaties. Dit betekent niet dat het bereiken van acceptabele prestaties met dergelijke modellen onmogelijk is. Vaak heeft u gewoon meer inspanning en aandacht voor details nodig om de gewenste metrische waarden te bereiken.
Applicaties
Type entiteiten Data Vault
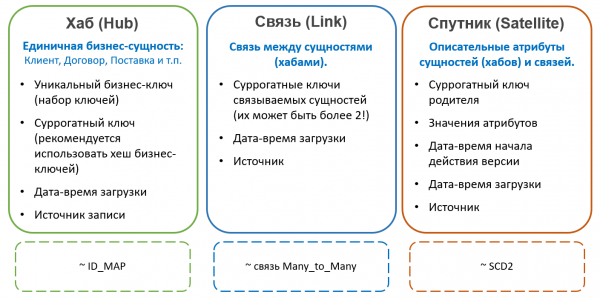
Meer over Data Vault:
Types entiteiten Anchor Model
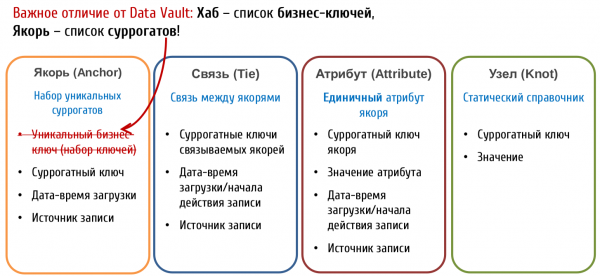
Meer over Anchor Model:
Een samenvattende tabel met gemeenschappelijke kenmerken en verschillen tussen de besproken benaderingen:
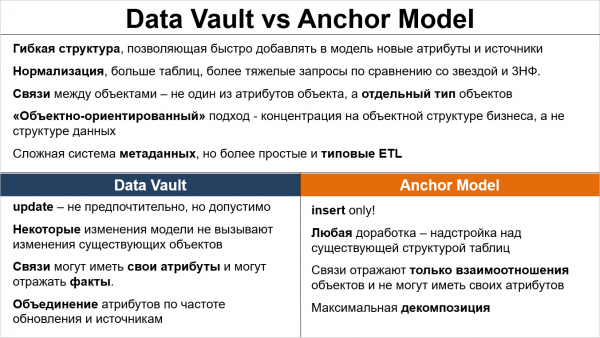
Bron: habr.com
