

Steeds meer bedrijven migreren hun infrastructuur van fysieke servers en eigen virtuele machines naar de cloud. Deze beslissing is eenvoudig te verklaren: er is geen noodzaak om je zorgen te maken over hardware, een cluster kan op vele verschillende manieren eenvoudig worden geconfigureerd... en het belangrijkste is dat de bestaande technologieën (zoals Kubernetes) eenvoudig schaalbaarheid van rekenkracht mogelijk maken, afhankelijk van de belasting.
Ook de financiële kant is altijd belangrijk. De tool waar we het in dit artikel over gaan hebben, is ontworpen om budgetten te helpen verlagen bij het gebruik van cloudinfrastructuur met Kubernetes.
Inleiding
— een Californische startup opgericht door ex-Google medewerkers, die een oplossing creëert voor het bijhouden van kosten van infrastructuur in cloudservices (binnen een Kubernetes-cluster + gedeelde middelen), het opsporen van knelpunten in de clusterconfiguratie en het verzenden van bijbehorende meldingen naar Slack.
We hebben klanten met Kubernetes in zowel de bekende clouds AWS en GCP als in de minder gebruikelijke Azure voor de Linux-gemeenschap — kortom, op alle platforms die door Kubecost worden ondersteund. Voor enkele van hen berekenen we de kosten van intra-cluster services zelfstandig (volgens een methodologie die lijkt op die van Kubecost), en houden we de infrastructuurkosten in de gaten en proberen we ze te optimaliseren. Daarom is het logisch dat we geïnteresseerd zijn in de mogelijkheid om dergelijke taken te automatiseren.
De broncode van de belangrijkste Kubecost-module is open onder een Open Source-licentie (Apache License 2.0). Het kan vrij worden gebruikt, en de beschikbare functies moeten voldoende zijn voor kleine projecten. Maar business is business: de rest van het product is gesloten, en kan worden gebruikt op , die ook commerciële ondersteuning bieden. Daarnaast bieden de auteurs een gratis licentie aan voor kleine clusters (1 cluster met 10 nodes — op het moment van schrijven is deze limiet uitgebreid tot 20 nodes) of een proefperiode met volledige mogelijkheden van 1 maand.
Hoe alles is geregeld
Dus, het belangrijkste deel van Kubecost is een applicatie , geschreven in Go. De Helm-chart die het hele systeem beschrijft, heet en is in wezen een bundel van cost-model met Prometheus, Grafana en verschillende dashboards.
In het algemeen heeft het kostenmodel zijn eigen webinterface die grafieken en gedetailleerde statistieken over uitgaven in tabelvorm toont, evenals uiteraard tips voor het optimaliseren van kosten. De in het Grafana-dashboard gepresenteerde gegevens zijn een eerdere fase in de ontwikkeling van Kubecost en bevatten grotendeels dezelfde gegevens als het kostenmodel, aangevuld met gebruikelijke statistieken over CPU-, geheugen-, netwerk- en schijfruimteverbruik in de cluster en de onderdelen daarvan.
Hoe werkt Kubecost?
- Het kostenmodel verkrijgt de prijzen voor diensten via de API van cloudproviders.
- Vervolgens wordt, afhankelijk van het type hardware van de node en de regio, de kosten per node berekend.
- Op basis van de kosten van de nodes ontvangt elke uiteindelijke pod een prijs per uur voor het gebruik van de processor, het gebruik van een gigabyte geheugen en de kosten per uur voor het opslaan van een gigabyte gegevens, afhankelijk van de node waarop deze draaide of de opslagklasse.
- Afhankelijk van de kosten van afzonderlijke pods wordt de betaling per namespaces, services, deployments en statefulsets berekend.
- Voor het berekenen van statistieken worden de metriek van kube-state-metrics en node-exporter gebruikt.
Het is belangrijk om te onthouden dat Kubecost standaard alleen de resources meet die beschikbaar zijn in Kubernetes. Externe databases, GitLab-servers, S3-opslag en andere diensten die niet in de cluster aanwezig zijn (ook al bevinden ze zich in dezelfde cloud), zijn voor hem niet zichtbaar. Hoewel voor GCP en AWS de sleutels van je serviceaccounts kunnen worden toegevoegd om alles samen te berekenen.
Installatie
Voor het functioneren van Kubecost zijn de volgende benodigd:
- Kubernetes versie 1.8 of hoger;
- kube-state-metrics;
- Prometheus;
- node-exporter.
Het toeval wil dat al deze voorwaarden van tevoren in onze clusters waren vervuld, zodat het voldoende was om alleen de juiste endpoint voor toegang tot Prometheus op te geven. Toch bevat de officiële Helm-chart van kubecost alles wat nodig is om te starten, zelfs op een 'naakte' cluster.
Kubecost kan op verschillende manieren worden geïnstalleerd:
- De standaardinstallatiemethode, beschreven in op de website van de ontwikkelaar. Het is nodig om de Helm-repository cost-analyzer toe te voegen en daarna de chart te installeren. Je hoeft alleen maar de poort door te geven en de instellingen handmatig (via kubectl) en/of met behulp van de webinterface van het kostenmodel aan te passen naar de gewenste staat.
We haven't even tried this method, as we do not use third-party ready-made configurations, but it looks like a good option to just experiment for yourself. If you already have part of the system components installed or want more fine-tuning, it's better to consider the second path.
- Essentially use , but configure and install it yourself in any convenient way.
As mentioned, in addition to kubecost itself, this chart contains the Grafana and Prometheus charts, which can also be configured to your liking.
Included in the chart
values.yamlfor cost-analyzer allows configuring:- the list of cost-analyzer components to deploy;
- your endpoint for Prometheus (if you already have one);
- domains and other ingress settings for cost-model and Grafana;
- annotations for pods;
- the necessity to use persistent storage and their size.
A complete list of available configuration options with descriptions can be found in .
Since kubecost in its basic version does not limit access, basic-auth needs to be configured immediately for the web panel.
- Installeer only the core of the system — cost-model. To do this, you need to have Prometheus installed in the cluster and specify the corresponding value of its address in the variable
prometheusEndpointfor Helm. After that — apply in de cluster.Again, you will have to manually add Ingress with basic-auth. Finally, you will need to add a section for collecting metrics from cost-model in
extraScrapeConfigsin the Prometheus config:- job_name: kubecost honor_labels: true scrape_interval: 1m scrape_timeout: 10s metrics_path: /metrics scheme: http dns_sd_configs: - names: - type: 'A' port: 9003
What do we get?
With a full installation, we have the kubecost web panel and Grafana with a set of dashboards at our disposal.
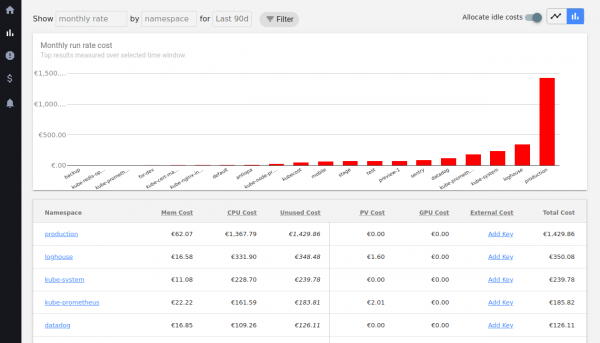
Total cost, displayed on the main screen, essentially shows the estimated resource cost for the month. This is the projected price, reflecting the cost of cluster usage (per month) at the current level of resource consumption.
This metric is more for analyzing expenses and optimizing them. Overall costs for an abstract July in kubecost are not very convenient to see: for that you will have to go to billing. However, you can look at costs broken down by namespaces, labels, pods over 1/2/7/30/90 days, which billing will never show you.
Speaking of labels. Ga meteen naar de instellingen en stel de namen van de labels in die zullen worden gebruikt als extra categorieën voor het groeperen van kosten:
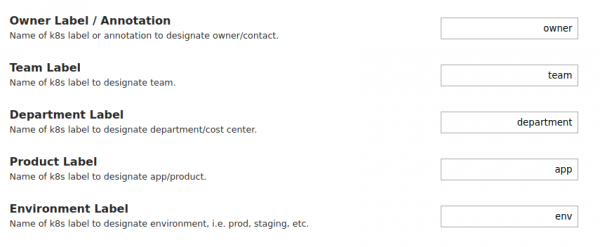
Je kunt aan deze labels elke benaming hangen — handig als je al een eigen labelingssysteem hebt.
Daar kun je ook het API-endpoint aanpassen waarmee het kostenmodel verbinding maakt, de korting in GCP instellen en je eigen prijzen voor middelen en valuta voor hun meting invoeren (deze functie lijkt echter geen invloed te hebben op de totale kosten).
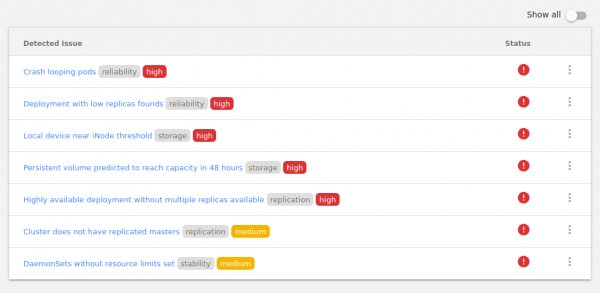
Kubecost kan verschillende problemen in de cluster (en kan zelfs alarmeren in geval van gevaar). Helaas is deze optie niet configureerbaar, en daarom — als je ontwikkelomgevingen hebt die worden gebruikt, zul je constant iets soortgelijks kunnen waarnemen:
Een belangrijk hulpmiddel is — Cluster Savings. Het meet de activiteit van pods (bronnenverbruik, inclusief netwerken) en berekent hoeveel geld en waar je kunt besparen.
Het kan lijken alsof de optimalisatieadviezen vrij voor de hand liggend zijn, maar ervaring leert dat er altijd iets is om op te letten. In het bijzonder wordt de netwerkinactiviteit van de pods gevolgd (Kubecost adviseert om aandacht te besteden aan inactieve), de gevraagde en werkelijke geheugenen CPU-verbruik wordt vergeleken, evenals de CPU die door de clusterknopen wordt gebruikt (het stelt voor om meerdere knopen tot één samen te voegen), de belasting op de schijven en een paar andere tientallen parameters.
Zoals bij elke kwestie die met optimalisatie te maken heeft, moet je de optimalisatie van middelen op basis van de gegevens van Kubecost met voorzichtigheid benaderen. Cluster Savings stelt bijvoorbeeld voor om knopen te verwijderen, terwijl het beweert dat dit veilig is, maar negeert het feit dat er op de geïnstalleerde pods node-selectors en taints kunnen zijn die op de andere knopen ontbreken. En zelfs de auteurs van het product in hun (overigens kan dit erg nuttig zijn voor degenen die geïnteresseerd zijn in het project) adviseren om niet zomaar in de optimalisatie van kosten te duiken, maar het onderwerp doordacht te benaderen.
Conclusies
Na een maand gebruik van kubecost op een paar projecten kunnen we concluderen dat dit een interessante (en ook gemakkelijk te gebruiken en te installeren) tool is voor de analyse en optimalisatie van de uitgaven aan cloudprovider-diensten die worden gebruikt voor Kubernetes-clusters. De berekeningen zijn behoorlijk nauwkeurig: in onze experimenten kwamen ze overeen met wat de providers in werkelijkheid vroegen.
Er zijn echter ook nadelen: er zijn niet-kritieke bugs en de functionaliteit dekt soms niet de specifieke behoeften van sommige projecten. Maar als je snel wilt begrijpen waar het geld heen gaat en wat je kunt 'snijden' om de rekeningen voor clouddiensten met 5-30% te verlagen (wat in ons geval ook gebeurde), is dit een uitstekende optie.
P.S.
Lees ook op onze blog:
- «»;
- «»;
- «».
Bron: habr.com
