

Inleiding tot besturingssystemen
Hallo, Habr! Ik wil jullie een serie vertaalde artikelen voorstellen van een literatuur die ik interessant vind - OSTEP. In dit materiaal wordt diep ingegaan op de werking van Unix-achtige besturingssystemen, met name - hoe processen werken, verschillende planners, geheugen en andere soortgelijke componenten die een modern besturingssysteem vormen. Het origineel van al het materiaal kunt u hier bekijken . Houd er rekening mee dat de vertaling niet professioneel is uitgevoerd (vrij vrij), maar ik hoop dat ik de algemene betekenis heb behouden.
Laboratoriumopdrachten voor dit onderwerp kun je hier vinden:
Andere delen:
En je kunt ook mijn kanaal bezoeken op =)
Introductie tot de planner
De kern van het probleem: Hoe ontwikkel je een plannerbeleid?
Hoe moeten de basisstructuren van het plannerbeleid worden ontwikkeld? Wat zijn de belangrijkste aannames? Welke metrics zijn belangrijk? Welke basistechnieken werden eerder in rekenmachines gebruikt?
Aannames over de werklast
Voordat we mogelijke beleidsmaatregelen bespreken, laten we eerst een paar vereenvoudigende opmerkingen maken over de processen die in het systeem draaien, die samen de werklastvormen. Het definiëren van de werklast is een cruciaal onderdeel bij het opstellen van beleid, en hoe meer je weet over de werklast, hoe beter beleid je kunt schrijven.
Laten we de volgende aannames maken over de in het systeem draaiende processen, soms ook wel jobs taken genoemd. Bijna al deze aannames zijn onrealistisch, maar noodzakelijk voor de ontwikkeling van het denken.
- Elke taak draait een gelijke hoeveelheid tijd,
- Alle taken worden gelijktijdig gestart,
- Een geplaatste taak draait totdat deze is voltooid,
- Alle taken gebruiken alleen CPU,
- De draaitijd van elke taak is bekend.
Metrics van de planner
Naast enkele aannames over de werklast is er ook een bepaalde vergelijkingstool nodig voor verschillende planningspolitieken: metrics van de planner. Een metric is simpelweg een maatstaf voor iets. Er zijn verschillende metrics die kunnen worden gebruikt om planningssystemen te vergelijken.
Als voorbeeld zullen we de metric gebruiken die doorlooptijd wordt genoemd. De doorlooptijd van een taak wordt gedefinieerd als het verschil tussen de voltooiingstijd van de taak en de tijd waarop de taak in het systeem aankomt.
Tturnaround=Tcompletion−Tarrival
Aangezien we hebben aangenomen dat alle taken op hetzelfde moment aankwamen, is Ta=0 en bijgevolg Tt=Tc. Deze waarde zal natuurlijk veranderen wanneer we de bovengenoemde aannames aanpassen.
Een andere metric is eerlijkheid. Prestaties en eerlijkheid zijn vaak tegenstrijdige kenmerken in planning. Een planner kan bijvoorbeeld de prestaties optimaliseren, maar ten koste van de wachttijd voor andere taken, waardoor de eerlijkheid afneemt.
EERST IN, EERST UIT (FIFO)
Het meest basale algoritme dat we kunnen implementeren, wordt FIFO of eerste komt (in), eerste diende (uit)Dit algoritme heeft verschillende voordelen: het is erg eenvoudig te implementeren en het voldoet aan al onze aannames, waarbij het het werk vrij goed uitvoert.
Laten we een simpel voorbeeld overwegen. Stel dat 3 taken tegelijkertijd zijn ingesteld. Maar stel dat taak A iets eerder is binnengekomen dan de andere, waardoor ze eerder in de uitvoeringlijst komt, net zoals B ten opzichte van C. Stel dat elke taak 10 seconden duurt. Wat zou in dit geval de gemiddelde uitvoeringstijd van deze taken zijn?
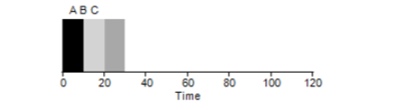
Door de waarden te tellen — 10+20+30 en dit te delen door 3, krijgen we een gemiddelde uitvoeringstijd van het programma van 20 seconden.
Laten we nu proberen onze aannames te wijzigen. In het bijzonder aanname 1, en dus gaan we er niet meer vanuit dat elke taak dezelfde hoeveelheid tijd verbruikt. Hoe zal FIFO zich deze keer gedragen?
Het blijkt dat verschillende uitvoeringstijden van taken een extreem negatieve invloed hebben op de productiviteit van het FIFO-algoritme. Stel dat taak A 100 seconden in beslag neemt, terwijl B en C nog steeds elk 10 seconden zijn.
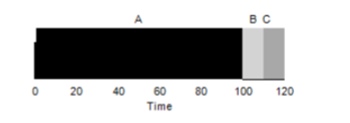
Zoals te zien is op de afbeelding, zal de gemiddelde tijd voor het systeem zijn (100+110+120)/3=110. Dit effect noemt men het convoy-effect, waarbij sommige kortstondige verbruikers van een bepaalde bron in de rij staan achter een zware verbruiker. Dit is vergelijkbaar met een rij in de supermarkt, wanneer er een klant voor je staat met een volle winkelwagentje. De beste oplossing voor dit probleem is om van kassa te wisselen of gewoon te ontspannen en diep adem te halen.
Shortest Job First
Is er een manier om een dergelijke situatie met zware processen op te lossen? Natuurlijk. Een ander type planning heetShortest Job First (SJF). Het algoritme is ook vrij primitief — zoals uit de naam blijkt, worden de kortste taken als eerste één voor één uitgevoerd.
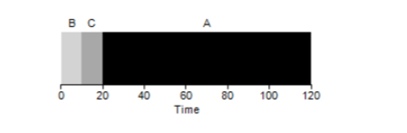
In dit voorbeeld zal het uitvoeren van dezelfde processen resulteren in een verbetering van de gemiddelde doorlooptijd van programma's, en deze zal gelijk zijn aan 50 in plaats van 110, wat praktisch 2 keer beter is.
Dus, aangenomen dat alle taken tegelijk aankomen, lijkt het SJF-algoritme het meest optimale algoritme. Onze aannames lijken echter nog steeds niet realistisch. Dit keer wijzigen we aanname 2 en stellen we voor dat taken op elk moment kunnen aankomen, niet allemaal tegelijk. Welke problemen kan dit veroorzaken?
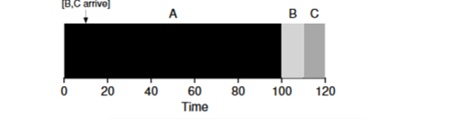
Stel dat taak A (100s) als eerste aankomt en begint te draaien. Op tijd t=10 komen taken B en C aan, die elk 10 seconden duren. Het gemiddelde uitvoeringstijd is dan (100+(110-10)+(120-10))/3 = 103. Wat kan de scheduler doen om de situatie te verbeteren?
Shortest Time-to-Completion First (STCF)
Om de situatie te verbeteren, laten we aanname 3 vallen dat het programma draait totdat het is voltooid. We hebben bovendien hardwareondersteuning nodig en zoals je misschien al kunt raden, gaan we gebruikmaken van een timer om de lopende taak te onderbreken en contextwisselingen. Zo kan de scheduler iets ondernemen op het moment dat taken B en C binnenkomen — taak A onderbreken en de taken B en C behandelen, en na hun voltooiing taak A weer hervatten. Zo'n scheduler wordt STCFof Preemptive Job First.
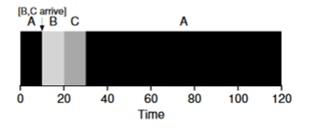
Het resultaat van deze scheduler zal als volgt zijn: ((120-0)+(20-10)+(30-10))/3=50. Dit maakt deze scheduler nog optimaler voor onze taken.
Response Time-metriek
Als we dus de werktijden van de taken en het feit dat deze taken alleen de CPU gebruiken weten, zal STCF de beste oplossing zijn. En ooit in de vroege dagen werkten deze algoritmes goed. Maar nu brengt de gebruiker de meeste tijd door aan de terminal en verwacht een productieve interactieve interactie. Zo is de nieuwe metriek ontstaan — antwoordtijd (response time).
De responstijd wordt als volgt berekend:
Tresponse = Tfirstrun − Tarrival
Voor het vorige voorbeeld zal de responstijd zijn: A=0, B=0, C=10 (abg=3,33).
En het lijkt erop dat het STCF-algoritme niet zo goed is in situaties waarin 3 taken tegelijk aankomen — het zal moeten wachten totdat de kleine taken volledig zijn afgerond. Dus, het algoritme is goed voor de doorlooptijd-metriek, maar slecht voor de interactiemetriek. Stel je voor dat je achter een terminal zit en probeert symbolen te typen in een editor, maar je moet meer dan 10 seconden wachten omdat een andere taak de processor bezet houdt. Dat is niet al te prettig.
Daarom stuiten we op een ander probleem — hoe kunnen we een scheduler bouwen die gevoelig is voor de responstijd?
Round Robin
Om dit probleem op te lossen is er een algoritme ontwikkeld Round Robin (RR). Het centrale idee is vrij eenvoudig: in plaats van taken uit te voeren tot hun voltooiing, starten we elke taak voor een bepaalde tijdsduur (een zogenaamde tijdsquantum) en schakelen dan over naar een andere taak in de wachtrij. Het algoritme herhaalt zijn werking totdat alle taken zijn voltooid. Daarbij moet de tijdsduur van het programma een veelvoud zijn van de tijd waarover de timer het proces onderbreekt. Bijvoorbeeld, als de timer het proces elke x=10ms onderbreekt, dan moet de uitvoertijd van het proces een veelvoud zijn van 10 en kan het 10, 20 of x*10 zijn.
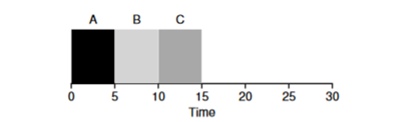
Laten we een voorbeeld overwegen: Taken A, B en C komen tegelijkertijd het systeem binnen en elk wil 5 seconden werken. Het SJF-algoritme zal elke taak tot het einde uitvoeren voordat het een andere start. In tegenstelling tot dat zal het RR-algoritme met een startvenster van 1s de taken als volgt doorlopen (zie fig. 4.3):
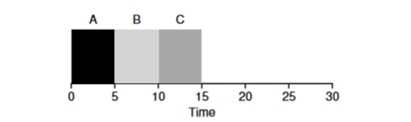
(SJF Again (Slecht voor Responstijd)
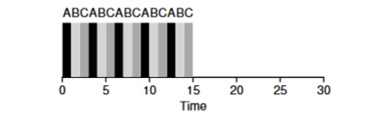
(Round Robin (Goed voor Responstijd)
De gemiddelde responstijd voor het RR-algoritme (0+1+2)/3=1, terwijl het voor SJF (0+5+10)/3=5 is.
Het is logisch om aan te nemen dat de tijdsvenster een zeer belangrijke parameter is voor RR; hoe korter het is, des te hoger de responstijd. Echter, het mag ook niet te klein zijn, omdat de tijd voor contextwisselingen ook een rol speelt in de algehele prestaties. Daarom wordt de keuze van de uitvoeringstijd ingesteld door de OS-architect en hangt deze af van de taken die daarin uitgevoerd moeten worden. Contextwisseling is niet de enige systeemoperatie die tijd kost; een draaiende applicatie heeft met veel meer te maken, zoals verschillende caches, en bij elke wisseling moeten deze omgevingen worden opgeslagen en hersteld, wat ook veel tijd kan vergen.
RR is een uitstekende scheduler, als het alleen om de responstijd gaat. Maar hoe gedraagt de doorlooptijd van de taak zich met dit algoritme? Laten we het bovenstaande voorbeeld bekijken, wanneer de tijden van A, B, C = 5s zijn en ze tegelijkertijd binnenkomen. Taak A eindigt om 13, B om 14, C om 15s en de gemiddelde doorlooptijd is 14s. Dus, RR is de slechtste algoritme voor de doorlooptijd metric.
In algemenere bewoordingen, elk algoritme van het type RR is eerlijk; het verdeelt de CPU-tijd gelijkmatig over alle processen. En zo zijn deze metrics voortdurend met elkaar in conflict.
Daarom hebben we een aantal tegenstrijdige algoritmes en blijven er enkele veronderstellingen over; dat de taakduur bekend is en dat de taak alleen de CPU gebruikt.
Mengeling met I/O
Laten we als eerste veronderstelling 4 weghalen, dat het proces alleen de CPU gebruikt; dat is natuurlijk niet waar en processen kunnen ook andere apparatuur aanspreken.
Op het moment dat een proces een invoer-uitvoeroperatie aanvraagt, gaat het proces in de geblokkeerde toestand en wacht op de voltooiing van de I/O. Als de I/O naar de harde schijf wordt gestuurd, kan deze operatie enkele milliseconden of langer duren, en de processor zal op dat moment idle zijn. In deze tijd kan de scheduler de processor toewijzen aan elk ander proces. De volgende beslissing die de scheduler moet nemen is wanneer het proces zijn I/O zal voltooien. Wanneer dit gebeurt, zal er een onderbreking plaatsvinden en het OS zal het proces dat de I/O heeft aangevraagd in de gereed-toestand zetten.
Laten we een voorbeeld bekijken met verschillende taken. Elke taak heeft 50 ms verwerkings tijd nodig. De eerste taak zal echter elke 10 ms naar I/O gaan (dat ook elke 10 ms zal worden uitgevoerd). Taak B gebruikt gewoon 50 ms van de verwerkings tijd zonder I/O.
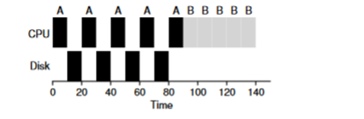
In dit voorbeeld gaan we de STCF-scheduler gebruiken. Hoe zal de scheduler zich gedragen als we taak A starten? Hij zal het volgende doen: eerst werkt hij taak A volledig af, en daarna taak B.
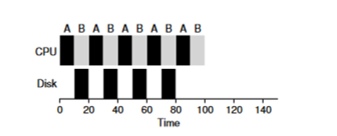
De traditionele benadering om dit probleem op te lossen is om elke 10 ms subtaak van taak A als een aparte taak te interpreteren. Bij het starten met het STJF-algoritme is de keuze tussen de 50 ms taak en de 10 ms taak duidelijk. Nadat subtaak A is voltooid, wordt taak B en de I/O gestart. Na de voltooiing van de I/O zal besloten worden om weer taak A van 10 ms te starten in plaats van taak B. Zo kan overlappen worden gerealiseerd, waarbij de CPU door een andere taak wordt gebruikt terwijl de eerste op I/O wacht. Het resultaat is dat het systeem beter wordt benut — op het moment dat interactieve taken op I/O wachten, kunnen andere taken op de CPU worden uitgevoerd.
De Oracle is er niet meer.
Laten we proberen het vermoeden los te laten dat de tijdsduur van een taak bekend is. Dit is in feite de slechtste en meest onrealistische veronderstelling van allemaal. In de meeste gangbare besturingssystemen weet het besturingssysteem zelf meestal heel weinig over de uitvoeringstijd van taken, hoe zouden we dan een scheduler kunnen bouwen zonder te weten hoe lang een taak zal draaien? Misschien kunnen we enkele principes van RR gebruiken om dit probleem op te lossen?
Conclusie
We hebben de basisideeën van taakplanning besproken en twee families van schedulers bekeken. De eerste start de kortste taak eerst, waardoor de doorlooptijd wordt verhoogd, terwijl de tweede zich gelijkmatig tussen alle taken verdeeld, waardoor de responstijd verbetert. Beide algoritmen zijn slecht waar de andere families goed zijn. We hebben ook bekeken hoe parallel gebruik van CPU en I/O de prestaties kan verbeteren, maar hebben het probleem van de 'heldere visie' van het besturingssysteem nog niet opgelost. In de volgende les gaan we een scheduler bekijken die naar het dichtstbijzijnde verleden kijkt en probeert de toekomst te voorspellen. Deze wordt de multi-level feedback queue genoemd.
Bron: habr.com
