

Microservicesarchitectuur heeft, net als alles in deze wereld, zijn voor- en nadelen. Sommige processen worden eenvoudiger, andere complexer. En omwille van de snelheid van veranderingen en een betere schaalbaarheid moeten er offers worden gebracht. Een daarvan is de complicatie van analytics. In een monolith kan alle operationele analytics worden teruggebracht tot SQL-query's naar de analytische replica, maar in een multi-service architectuur heeft elke service zijn eigen database, en het lijkt alsof je niet met één query kunt werken (of kun je dat misschien wel?). Voor degenen die geïnteresseerd zijn in hoe we het probleem van operationele analytics in ons bedrijf hebben opgelost en hoe we met deze oplossing hebben leren leven — welkom.
Mijn naam is Pavel Sivaš, bij DomClick werk ik in het team dat verantwoordelijk is voor het onderhoud van het analytische datawarehouse. We kunnen onze werkzaamheden ruwweg onderbrengen in data engineering, maar in werkelijkheid is het scala aan taken veel breder. Er zijn standaardtaken voor data engineering zoals ETL/ELT, ondersteuning en aanpassing van tools voor data-analyse en de ontwikkeling van onze eigen tools. In het bijzonder hebben we voor operationele rapportage besloten 'te doen alsof' we een monolith hebben en de analisten één database te geven waarin alle benodigde gegevens staan.
Over het algemeen hebben we verschillende opties overwogen. We hadden een volledige opslag kunnen opzetten — we hebben het zelfs geprobeerd, maar eerlijk gezegd is het ons niet gelukt om de vrij frequente wijzigingen in de logica te combineren met het vrij trage proces van het opbouwen van de opslag en het aanbrengen van wijzigingen (als iemand het gelukt is, laat dan in de reacties weten hoe). We hadden de analisten kunnen zeggen: "Jongens, leer Python en ga naar de analytische replica's", maar dat zou een extra vereiste voor het personeel zijn en het leek beter dit te vermijden, als dat mogelijk was. We besloten de technologie FDW (Foreign Data Wrapper) te gebruiken: in wezen is dit een standaard dblink die in de SQL-standaard voorkomt, maar met een veel gebruiksvriendelijker interface. Op basis daarvan hebben we een oplossing gemaakt die uiteindelijk is aangenomen en waar we op zijn teruggekomen. De details ervan zijn het onderwerp van een apart artikel, misschien zelfs meerdere, omdat we veel willen vertellen: van schema-synchronisatie tot toegangsbeheer en het anonimiseren van persoonsgegevens. Het moet ook worden opgemerkt dat deze oplossing geen vervanging is voor echte analytische databases en opslagplaatsen; het lost alleen een specifiek probleem op.
Op hoofdlijnen ziet het er als volgt uit:
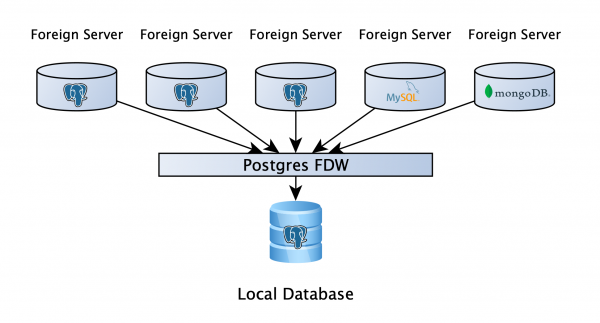
Er is een PostgreSQL-database, daar kunnen gebruikers hun werkgegevens opslaan, en het belangrijkste is dat deze database via FDW is gekoppeld aan de analytische replica's van alle diensten. Dit maakt het mogelijk om een query naar verschillende databases te schrijven, ongeacht of dit nu PostgreSQL, MySQL, MongoDB of iets anders is (een bestand, API; als er geen geschikte wrapper is, kan je zelf een schrijven). Nou, dat lijkt me alles, geweldig! Laten we het hierbij laten?
Als alles zo snel en eenvoudig eindigde, zou er waarschijnlijk geen artikel zijn.
Het is belangrijk om duidelijk te begrijpen hoe PostgreSQL verzoeken naar externe servers verwerkt. Dit lijkt logisch, maar wordt vaak over het hoofd gezien: PostgreSQL verdeeld een verzoek in delen die onafhankelijk op externe servers worden uitgevoerd, verzamelt deze gegevens en voert de uiteindelijke berekeningen zelf uit, waardoor de snelheid van de uitvoering van het verzoek sterk afhankelijk zal zijn van de manier waarop het is geschreven. Het moet ook worden opgemerkt: wanneer gegevens van een externe server komen, zijn ze al zonder indexen, zonder iets dat de planner kan helpen, dus kunnen we hem alleen zelf helpen en aanwijzingen geven. En daarover wil ik graag meer zeggen.
Eenvoudig verzoek en plan daarmee
Om te laten zien hoe PostgreSQL een aanvraag uitvoert op een tabel met 6 miljoen regels op afstand de server, kijken we naar een eenvoudig plan.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table;

Aggregate  (cost=418383.23..418383.24 rows=1 width=8) (actual time=3857.198..3857.198 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.00..402376.14 rows=6402838 width=0) (actual time=4.874..3256.511 rows=6406868 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Remote SQL: SELECT NULL FROM fdw_schema.table
Planning time: 0.986 ms
Execution time: 3857.436 ms
Het gebruik van de VERBOSE-instructie stelt ons in staat om de aanvraag te zien die naar de externe server wordt verzonden en waarvan we de resultaten krijgen voor verdere verwerking (regel RemoteSQL).
Laten we iets verder gaan en enkele filters aan onze aanvraag toevoegen: een op boolean veld, een op aanwezigheid timestamp in het interval en een op jsonb.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active is True
AND created_dt BETWEEN CURRENT_DATE - INTERVAL '7 month'
AND CURRENT_DATE - INTERVAL '6 month'
AND meta->>'source' = 'test';

Aggregate  (cost=577487.69..577487.70 rows=1 width=8) (actual time=27473.818..25473.819 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.00..577469.21 rows=7390 width=0) (actual time=31.369..25372.466 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: (("table".is_active IS TRUE) AND (("table".meta ->> 'source'::text) = 'test'::text) AND ("table".created_dt >= (('now'::cstring)::date - '7 mons'::interval)) AND ("table".created_dt <= ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)))
        Rows Removed by Filter: 5046843
        Remote SQL: SELECT created_dt, is_active, meta FROM fdw_schema.table
Planning time: 0.665 ms
Execution time: 27474.118 ms
Hier ligt echt het punt dat je moet opmerken bij het schrijven van aanvragen. De filters werden niet doorgestuurd naar de externe server, wat betekent dat PostgreSQL alle 6 miljoen regels ophaalt om deze vervolgens lokaal te filteren (regel Filter) en aggregatie uit te voeren. Het geheim van succes is om de aanvraag zo te schrijven dat de filters naar de externe machine worden gestuurd, zodat we alleen de benodigde rijen ontvangen en aggregeren.
Dat is wat booleanshit
Met booleanvelden is alles eenvoudig. In de oorspronkelijke aanvraag ontstond het probleem door de operator is. Als we deze vervangen door =, krijgen we het volgende resultaat:
leg uit analyseer gedetailleerd
SELECT count(1)
FROM fdw_schema.table
WHERE is_active = True
AND created_dt BETWEEN CURRENT_DATE - INTERVAL '7 maanden'
AND CURRENT_DATE - INTERVAL '6 maanden'
AND meta->>'source' = 'test';

Aggregate (cost=508010.14..508010.15 rows=1 width=8) (werkelijke tijd=19064.314..19064.314 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan op fdw_schema."table"  (cost=100.00..507988.44 rows=8679 width=0) (werkelijke tijd=33.035..18951.278 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: ((("table".meta ->> 'source'::text) = 'test'::text) AND ("table".created_dt >= (('now'::cstring)::date - '7 maanden'::interval)) AND ("table".created_dt <= ((('now'::cstring)::date)::timestamp with time zone - '6 maanden'::interval)))
        Rijen verwijderd door Filter: 3567989
        Remote SQL: SELECT created_dt, meta FROM fdw_schema.table WHERE (is_active)
Plannings tijd: 0.834 ms
Uitvoering tijd: 19064.534 ms
Zoals u kunt zien, is de filter naar de externe server gegaan en is de uitvoeringstijd verkort van 27 seconden naar 19 seconden.
Het is belangrijk op te merken dat de operator is verschilt van de operator = op de manier dat deze null-waarden kan verwerken. Dit betekent dat is not True in de filter waarden False en Null behoudt, terwijl != True alleen waarden False behoudt. Daarom, bij het vervangen van de operator is not moeten twee voorwaarden met de operator OR in de filter worden doorgegeven, bijvoorbeeld, WHERE (col != True) OR (col is null).
Met boolean hebben we een oplossing, laten we verder gaan. Laten we de filter voor de booleaanse waarde terugzetten naar zijn oorspronkelijke staat om het effect van andere veranderingen onafhankelijk te bekijken.
timestamptz? hz
Over het algemeen komt het vaak voor dat we experimenteren met hoe we een query correct moeten schrijven die gebruikmaakt van externe servers, en daarna op zoek gaan naar een uitleg waarom dit precies zo gebeurt. Er is heel weinig informatie over dit onderwerp te vinden op het internet. Tijdens onze experimenten ontdekten we dat de filter op een vaste datum prima naar de externe server gaat, maar wanneer we een datum dynamisch willen instellen, zoals now() of CURRENT_DATE, gebeurt dat niet. In ons geval hebben we zo'n filter toegevoegd, zodat de kolom created_at gegevens bevat die precies 1 maand geleden zijn (BETWEEN CURRENT_DATE - INTERVAL '7 maanden' AND CURRENT_DATE - INTERVAL '6 maanden'). Wat hebben we in dit geval gedaan?
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active is True
AND created_dt >= (SELECT CURRENT_DATE::timestamptz - INTERVAL '7 months')
AND created_dt >'source' = 'test';

Aggregate  (cost=306875.17..306875.18 rows=1 width=8) (actual time=4789.114..4789.115 rows=1 loops=1)
  Output: count(1)
  InitPlan 1 (returns $0)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.007..0.008 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '7 months'::interval)
  InitPlan 2 (returns $1)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.002..0.002 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '6 months'::interval)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.02..306874.86 rows=105 width=0) (actual time=23.475..4681.419 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: (("table".is_active IS TRUE) AND (("table".meta->>'source'::text) = 'test'::text))
        Rows Removed by Filter: 76934
        Remote SQL: SELECT is_active, meta FROM fdw_schema.table WHERE ((created_dt >= $1::timestamp with time zone)) AND ((created_dt < $2::timestamp with time zone))
Planning time: 0.703 ms
Execution time: 4789.379 ms
We hebben de planner aangemoedigd om de datum in de subquery vooraf te berekenen en al een kant-en-klare variabele aan de filter door te geven. Dit advies leverde ons een prachtig resultaat op; de query werd bijna 6 keer sneller!
Opnieuw is het belangrijk om voorzichtig te zijn: het datatypen in de subquery moet hetzelfde zijn als dat van het veld waarvoor we filteren, anders besluit de planner dat omdat de types verschillen, het eerst alle gegevens moet ophalen en deze lokaal moet filteren.
Laten we de datumfilter terugzetten naar de oorspronkelijke waarde.
Freddy vs. Jsonb
Over het algemeen hebben booleaanse velden en data onze query al behoorlijk versneld, maar er blijft nog één datatype over. De strijd om de filtering daarop is, eerlijk gezegd, nog steeds niet voorbij, hoewel er ook hier successen zijn geboekt. Dus zo hebben we het filter doorgegeven op jsonb het veld naar de externe server.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active is True
AND created_dt BETWEEN CURRENT_DATE - INTERVAL '7 months'
AND CURRENT_DATE - INTERVAL '6 months'
AND meta @> '{"source":"test"}'::jsonb;

Aggregate  (cost=245463.60..245463.61 rows=1 width=8) (actual time=6727.589..6727.590 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=1100.00..245459.90 rows=1478 width=0) (actual time=16.213..6634.794 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: (("table".is_active IS TRUE) AND ("table".created_dt >= (('now'::cstring)::date - '7 months'::interval)) AND ("table".created_dt  '{"source": "test"}'::jsonb))
Planning time: 0.747 ms
Execution time: 6727.815 ms
In plaats van filteroperatoren moeten we de aanwezigheidsoperator gebruiken. jsonb in een andere. 7 seconden in plaats van de oorspronkelijke 29. Tot nu toe is dit de enige succesvolle manier om filters door te geven jsonb naar een externe server, maar hier moet men één beperking in gedachten houden: we gebruiken versie 9.6 van de database, maar we zijn van plan om tegen het einde van april de laatste tests te voltooien en over te stappen op versie 12. Zodra we zijn bijgewerkt, zullen we schrijven hoe dit van invloed was, want er zijn veel veranderingen waar we op hopen: json_path, nieuw gedrag voor CTE, push down (bestaande sinds versie 10). We willen het zo snel mogelijk uitproberen.
Finish him
We hebben gecontroleerd hoe elke wijziging afzonderlijk invloed heeft op de snelheid van het verzoek. Laten we nu kijken naar wat er gebeurt als alle drie de filters correct zijn geschreven.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active = True
AND created_dt >= (SELECT CURRENT_DATE::timestamptz - INTERVAL '7 month')
AND created_dt  '{"source":"test"}'::jsonb;

Aggregate  (cost=322041.51..322041.52 rows=1 width=8) (actual time=2278.867..2278.867 rows=1 loops=1)
  Output: count(1)
  InitPlan 1 (returns $0)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.010..0.010 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '7 mons'::interval)
  InitPlan 2 (returns $1)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.003..0.003 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.02..322041.41 rows=25 width=0) (actual time=8.597..2153.809 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Remote SQL: SELECT NULL FROM fdw_schema.table WHERE (is_active) AND ((created_dt >= $1::timestamp with time zone)) AND ((created_dt  '{"source": "test"}'::jsonb))
Planning time: 0.820 ms
Execution time: 2279.087 ms
Ja, de aanvraag lijkt ingewikkelder, dat is een noodzakelijke prijs, maar de uitvoeringstijd bedraagt 2 seconden, wat meer dan 10 keer sneller is! En we hebben het hier over een eenvoudige aanvraag aan een relatief kleine dataset. Bij echte aanvragen hebben we een toename van honderden keren gezien.
Laten we de balans opmaken: als je PostgreSQL met FDW gebruikt, controleer altijd of alle filters naar de externe server worden gestuurd, en je zult gelukkig zijn... Tenminste, totdat je bij joins tussen tabellen van verschillende servers. Maar dat is al een verhaal voor een ander artikel.
Bedankt voor uw aandacht! Ik kijk ernaar uit om vragen, opmerkingen en verhalen over uw ervaringen in de reacties te horen.
Bron: habr.com
