

Opmerking vertaler.: In dit artikel deelt Banzai Cloud een voorbeeld van het gebruik van zijn speciale hulpprogramma's om het beheer van Kafka binnen Kubernetes te vergemakkelijken. De gegeven instructies illustreren hoe de optimale grootte van de infrastructuur kan worden bepaald en hoe Kafka zelf kan worden geconfigureerd om de vereiste doorvoersnelheid te bereiken.
Apache Kafka is een gedistribueerd streamingplatform voor het creëren van betrouwbare, schaalbare en hoogperformante streamingsystemen in realtime. De indrukwekkende mogelijkheden ervan kunnen worden uitgebreid met Kubernetes. Hiervoor hebben we ontwikkeld en een hulpmiddel genaamd . Deze stellen je in staat om Kafka in Kubernetes te draaien en verschillende functies ervan te gebruiken, zoals fijn afstemmen van de brokerconfiguratie, schaling op basis van metrics met herbalanceerbaarheid, rack awareness, ‘graceful’ (graceful) uitrol van updates, enzovoort.
Probeer Supertubes in je cluster:
curl https://getsupertubes.sh | sh en supertubes install -a --no-democluster --kubeconfigOf neem contact op met . Je kunt ook lezen over enkele mogelijkheden van Kafka die zijn geautomatiseerd met behulp van Supertubes en de Kafka-operator. Daarover hebben we al geblogd:
- ;
- ;
- ;
- ;
- ;
- ;
- .
Als je besluit om een Kafka-cluster in Kubernetes op te zetten, kom je ongetwijfeld de uitdaging tegen om de optimale grootte van de onderliggende infrastructuur te bepalen en de configuratie van Kafka fijn af te stemmen om te voldoen aan de vereisten voor de doorvoersnelheid. De maximale prestaties van elke broker hangen af van de prestaties van de infrastructuurcomponenten eronder, zoals geheugen, CPU, schijf snelheid, netwerkdoorvoer, enzovoort.
Idealiter zou de configuratie van de broker zodanig moeten zijn dat alle infrastructuurelementen op hun maximaal vermogen worden benut. In de praktijk is zo'n instelling echter behoorlijk ingewikkeld. Het is waarschijnlijker dat gebruikers de configuratie van brokers zodanig instellen dat ze het gebruik van één of twee componenten (schijf, geheugen of processor) maximaliseren. Over het algemeen vertoont een broker de beste prestaties wanneer de configuratie het mogelijk maakt om het langzaamste component ten volle te benutten. Zo kunnen we een schatting maken van de belasting waaraan een enkele broker kan voldoen.
Theoretisch kunnen we ook het aantal brokers schatten dat nodig is om met een bepaalde belasting om te gaan. In de praktijk zijn er echter zoveel configuratieopties op verschillende niveaus, dat het moeilijk is om de potentiële prestaties van een bepaalde configuratie te beoordelen (bijna onmogelijk). Met andere woorden, het is erg moeilijk om een configuratie te plannen op basis van een bepaalde prestatie-eis.
Voor Supertubes-gebruikers passen we doorgaans de volgende aanpak toe: we beginnen met een bepaalde configuratie (infrastructuur + instellingen), meten de prestaties, passen de instellingen van de broker aan en herhalen het proces nogmaals. Dit gaat door totdat het potentieel van het langzaamste component van de infrastructuur volledig is benut.
Op deze manier krijgen we een duidelijker beeld van hoeveel brokers nodig zijn voor een cluster om een bepaalde belasting aan te kunnen (aantal brokers hangt ook af van andere factoren, zoals het minimale aantal berichtenreplica's voor betrouwbaarheid, het aantal partition-leiders, enzovoort). Bovendien krijgen we inzicht in welk infrastructuurelement het meest geschikt is voor verticale schaalvergroting.
In dit artikel bespreken we de stappen die we ondernemen om het maximale uit de langzaamste componenten in de initiële configuraties te halen en de doorvoercapaciteit van de Kafka-cluster te meten. Een hoog beschikbare configuratie vereist ten minste drie actieve brokers.min.insync.replicas=3), verspreid over drie verschillende beschikbaarheidszones. Voor de configuratie, schaalvergroting en monitoring van de Kubernetes-infrastructuur gebruiken we ons eigen containerbeheersplatform voor hybride clouds — . Het ondersteunt on-premise (bare metal, VMware) en vijf soorten clouds (Alibaba, AWS, Azure, Google, Oracle), evenals hun willekeurige combinaties.
Overwegingen met betrekking tot de infrastructuur en configuratie van de Kafka-cluster
Voor de onderstaande voorbeelden hebben we AWS gekozen als cloudprovider en EKS als Kubernetes-distributie. Een soortgelijke configuratie kan worden gerealiseerd met — een Kubernetes-distributie van Banzai Cloud, gecertificeerd door CNCF.
Schijf
Amazon biedt verschillende . De basis van gp2 en io1 bestaat uit SSD-schijven, maar om een hoge doorvoer te garanderen, gp2 consumeert het opgebouwde credits (I/O credits), daarom geven we de voorkeur aan het type io1, dat een stabiele hoge doorvoer biedt.
Types instanties
De prestaties van Kafka zijn sterk afhankelijk van de paginacache van het besturingssysteem, daarom hebben we instanties nodig met voldoende geheugen voor de brokers (JVM) en de paginacache. De instantie c5.2xlarge is een goede start, aangezien deze 16 GB geheugen heeft en . Het nadeel is dat het in staat is om maximale prestaties te leveren gedurende niet meer dan 30 minuten per 24 uur. Als de werklast maximale prestaties vereist gedurende een langere periode, moeten we naar andere types instanties kijken. Dat is precies wat we hebben gedaan, waarmee we gekozen hebben voor c5.4xlarge. Het biedt een maximale doorvoer van 593,75 MB/s. De maximale doorvoer van het EBS-volume io1 is hoger dan die van de instantie c5.4xlarge, daarom lijkt het langzaamste element van de infrastructuur de I/O-doorvoer van dit soort instantie te zijn (wat ook moet worden bevestigd door de resultaten van onze belastingtests).
Netwerk
De netwerksnelheid moet aanzienlijk hoger zijn dan de prestaties van de VM-instantie en de schijf, anders wordt het netwerk de bottleneck. In ons geval ondersteunt de netwerkinterface c5.4xlarge een snelheid tot 10 Gbps, wat aanzienlijk hoger is dan de I/O-doorvoer van de VM-instantie.
De inzet van brokers
Brokers moeten uitgerold worden (gepland in Kubernetes) op dedicated nodes om concurrentie met andere processen voor CPU-, geheugen-, netwerken- en schijfrmiddelen te vermijden.
Java-versie
Een logische keuze is Java 11, omdat het compatibel is met Docker in die zin dat de JVM correct de beschikbare processors en het geheugen voor de container bepaalt waarin de broker draait. Wetende dat CPU-limieten belangrijk zijn, stelt de JVM intern en transparant het aantal GC-threads en JIT-compiler-threads in. We hebben het Kafka-image gebruikt banzaicloud/kafka:2.13-2.4.0, inclusief versie Kafka 2.4.0 (Scala 2.13) op Java 11.
Als je meer wilt weten over Java/JVM op Kubernetes, let dan op onze volgende publicaties:
- ;
- .
Geheugeninstellingen voor de broker
Er zijn twee belangrijkste aspecten bij het instellen van het geheugen voor de broker: instellingen voor de JVM en voor de Kubernetes-pod. De geheugenlimiet die voor de pod is ingesteld, moet groter zijn dan de maximale heap-grootte, zodat de JVM ruimte heeft voor de Java-meta-ruimte, die in eigen geheugen zit, en voor de pagina-cache van het besturingssysteem, die Kafka actief gebruikt. In onze tests draaiden we Kafka-brokers met de parameters -Xmx4G -Xms2G, terwijl de geheugenlimiet voor de pod 10 Giwas. Merk op dat geheugeninstellingen voor de JVM automatisch verkregen kunnen worden met -XX:MaxRAMPercentage en -X:MinRAMPercentage, gebaseerd op de geheugenlimiet voor de pod.
Processorinstellingen voor de broker
Over het algemeen kan de prestaties worden verhoogd door de parallelisme te vergroten door het aantal threads dat door Kafka wordt gebruikt te verhogen. Hoe meer processors beschikbaar zijn voor Kafka, hoe beter. In onze test begonnen we met een limiet van 6 processors en verhoogden we dit geleidelijk (in iteraties) tot 15. Daarnaast stelden we in num.network.threads=12 in de brokerinstellingen om het aantal threads dat gegevens uit het netwerk ontvangt en verzendt te verhogen. We ontdekten al snel dat follower-brokers de replica's niet snel genoeg konden ontvangen, dus verhoogden we num.replica.fetchers tot 4 om de snelheid te verhogen waarmee follower-brokers berichten van leiders repliceren.
Laadgeneratortool
Zorg ervoor dat het potentieel van de gekozen belastinggenererende tool niet opraakt voordat het Kafka-cluster (waarvan de benchmark wordt uitgevoerd) zijn maximale belasting bereikt. Met andere woorden, het is noodzakelijk om een voorlopige evaluatie van de mogelijkheden van de belastinggeneratietool uit te voeren en de types instanties te selecteren die voldoende processors en geheugen bieden. In dit geval zal onze tool meer belasting genereren dan het Kafka-cluster kan verwerken. Na veel experimenten zijn we gestopt bij drie instanties c5.4xlarge, waarbij in elk een generator is gestart.
Benchmarking
Prestatiemeting is een iteratief proces dat de volgende fasen omvat:
- infrastructuur configuratie (EKS-cluster, Kafka-cluster, belastinggeneratietool, evenals Prometheus en Grafana);
- belasting genereren gedurende een bepaalde periode om willekeurige afwijkingen in de verzamelde prestatiegegevens te filteren;
- afstemming van infrastructuur en configuratie van de broker op basis van de waargenomen prestatiegegevens;
- het proces herhalen totdat het vereiste niveau van doorvoer van het Kafka-cluster is bereikt. Dit moet stabiel reproduceerbaar zijn en minimale variaties in doorvoer vertonen.
In de volgende sectie worden de stappen beschreven die zijn uitgevoerd tijdens de benchmark van het testcluster.
Hulpmiddelen
Voor snelle implementatie van de basisconfiguratie, belastinggeneratie en prestatiemeting zijn de volgende tools gebruikt:
- voor de organisatie van het EKS-cluster van Amazon met (voor het verzamelen van Kafka- en infrastructuurmetrics) en (voor visualisatie van deze metrics). We hebben gebruikgemaakt van geïntegreerde in diensten die federatieve monitoring, gecentraliseerde logverzameling, kwetsbaarhedenscanning, herstel na storingen, bedrijfsniveau beveiliging en meer bieden.
- — een tool voor load testing van het Kafka-cluster.
- Grafana-dashboards voor het visualiseren van Kafka- en infrastructuurmetrics: , .
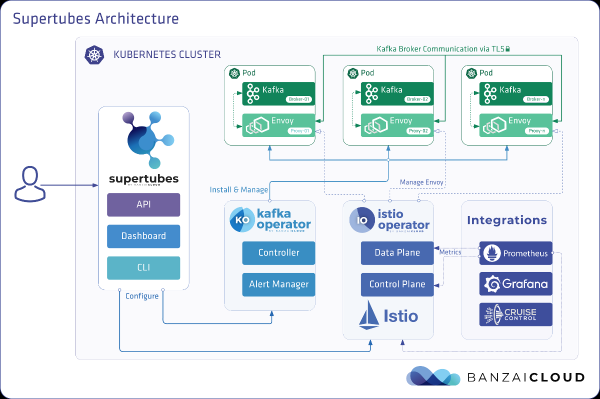
- Supertubes CLI voor de eenvoudigste configuratie van een Kafka-cluster in Kubernetes. Zookeeper, Kafka-operator, Envoy en vele andere componenten zijn geïnstalleerd en correct geconfigureerd voor het draaien van een productieklare Kafka-cluster in Kubernetes.
- klonen we de overeenkomstige repository van GitHub: supertubes CLI maak gebruik van de instructies die hier zijn gegeven .
EKS-cluster
Bereid het EKS-cluster voor met toegewezen werkknopen c5.4xlarge in verschillende beschikbaarheidszones voor pods met Kafka-brokers, evenals speciale knopen voor de belastinggenerator en monitoringinfrastructuur.
banzai cluster create -f https://raw.githubusercontent.com/banzaicloud/kafka-operator/master/docs/benchmarks/infrastructure/cluster_eks_202001.jsonZodra het EKS-cluster operationeel is, schakel de geïntegreerde in — het zal Prometheus en Grafana in het cluster implementeren.
Systeemcomponenten van Kafka
Installeer de systeemcomponenten van Kafka (Zookeeper, kafka-operator) in EKS met behulp van supertubes CLI:
supertubes install -a --no-democluster --kubeconfigKafka-cluster
Standaard worden in EKS EBS-volumes van het type gp2, dus moet er een aparte opslageenheid worden aangemaakt op basis van volumes io1 voor het Kafka-cluster:
kubectl create -f - <<EOF
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: fast-ssd
provisioner: kubernetes.io/aws-ebs
parameters:
  type: io1
  iopsPerGB: "50"
  fsType: ext4
volumeBindingMode: WaitForFirstConsumer
EOF
Stel voor de brokers de parameter min.insync.replicas=3 in en implementeer de brokers op knopen in drie verschillende beschikbaarheidszones:
supertubes cluster create -n kafka --kubeconfig -f https://raw.githubusercontent.com/banzaicloud/kafka-operator/master/docs/benchmarks/infrastructure/kafka_202001_3brokers.yaml --wait --timeout 600Topics
We hebben tegelijkertijd drie instanties van de belastinggenerator uitgevoerd. Elk van hen schrijft naar zijn eigen topic, dus we hebben in totaal drie topics nodig:
supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
  name: perftest1
spec:
  name: perftest1
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF

supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
    name: perftest2
spec:
  name: perftest2
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF

supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
  name: perftest3
spec:
  name: perftest3
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF
Voor elk topic is de replicatiefactor 3 — de minimale aanbevolen waarde voor hoogbeschikbare productiesystemen.
Laadgeneratortool
We hebben drie exemplaren van de load generator gestart (elke schreef naar een aparte topic). Voor de pods van de load generator moet node affinity worden ingesteld, zodat ze alleen op de aan hen toegewezen knooppunten worden gepland:
apiVersion: extensions/v1beta1
kind: Deployment
metadata:
  labels:
    app: loadtest
  name: perf-load1
  namespace: kafka
spec:
  progressDeadlineSeconds: 600
  replicas: 1
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      app: loadtest
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      creationTimestamp: null
      labels:
        app: loadtest
    spec:
      affinity:
        nodeAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            nodeSelectorTerms:
            - matchExpressions:
              - key: nodepool.banzaicloud.io/name
                operator: In
                values:
                - loadgen
      containers:
      - args:
        - -brokers=kafka-0:29092,kafka-1:29092,kafka-2:29092,kafka-3:29092
        - -topic=perftest1
        - -required-acks=all
        - -message-size=512
        - -workers=20
        image: banzaicloud/perfload:0.1.0-blog
        imagePullPolicy: Always
        name: sangrenel
        resources:
          limits:
            cpu: 2
            memory: 1Gi
          requests:
            cpu: 2
            memory: 1Gi
        terminationMessagePath: /dev/termination-log
        terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      terminationGracePeriodSeconds: 30
Enkele aandachtspunten zijn:
- De load generator genereert berichten van 512 bytes en publiceert deze in Kafka in batches van 500 berichten.
- Met het argument
-required-acks=allwordt een publicatie als succesvol beschouwd wanneer alle gesynchroniseerde replica's van het bericht door de Kafka-brokers zijn ontvangen en bevestigd. Dit betekent dat we in de benchmark niet alleen de snelheid gemeten hebben van de leiders die berichten ontvangen, maar ook van hun volgers die de berichten repliceren. Het doel van deze test is niet om de leessnelheid van net ontvangen berichten te evalueren, (consumers) die nog in de pagina-cache van het besturingssysteem blijven en deze te vergelijken met de leessnelheid van berichten die op de schijf zijn opgeslagen. - De load generator start 20 workers parallel (
-workers=20). Elke worker bevat 5 producers die samen de verbinding van de worker met de Kafka-cluster benutten. In totaal heeft iedere generator 100 producers, en zij sturen allemaal berichten naar de Kafka-cluster.
Monitoring van de status van de cluster
Tijdens de belastingstest van het Kafka-cluster hielden we ook de gezondheid ervan in de gaten om ervoor te zorgen dat er geen pods opnieuw werden opgestart, geen gedesynchroniseerde replica's waren en dat de maximale doorvoer met minimale fluctuaties werd gerealiseerd:
- De belastinggenerator schrijft standaardstatistieken over het aantal gepubliceerde berichten en het foutpercentage. Het percentage fouten moet op het niveau blijven van
0,00%. - , uitgevoerd door de kafka-operator, biedt een dashboard waarop we ook de status van het cluster kunnen observeren. Voer de volgende opdracht uit om dit dashboard te bekijken:
supertubes cluster cruisecontrol show -n kafka --kubeconfig - Het niveau ISR (aantal ‘in-sync’ replica's) shrink en expansion is gelijk aan 0.
Meetresultaten
3 brokers, berichtgrootte - 512 bytes
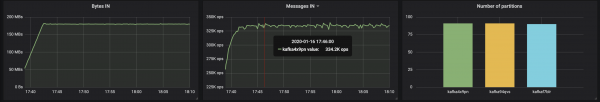
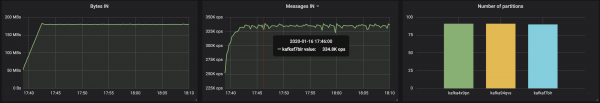
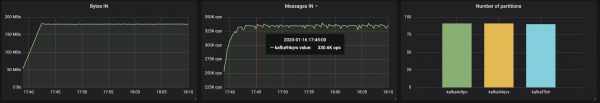
Met partitions gelijkmatig verdeeld over drie brokers, konden we een doorvoer bereiken van ~500 MB/s (ongeveer 990.000 berichten per seconde):
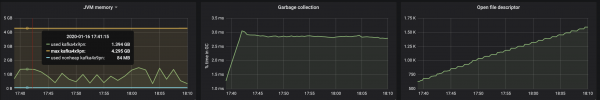
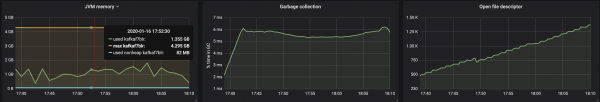
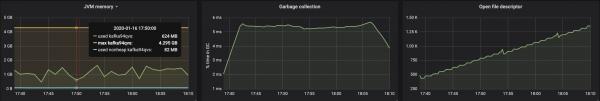
Het geheugenverbruik van de JVM virtuele machine overschreed niet de 2 GB:
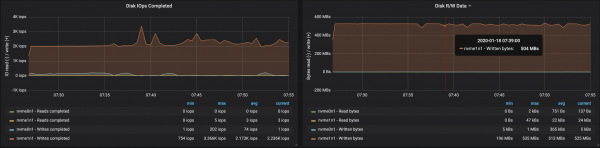
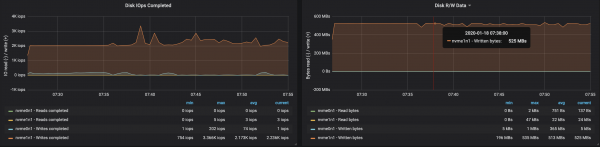
De schijfdoorvoer bereikte de maximale I/O-capaciteit van de node op alle drie de instanties waar de brokers draaiden:
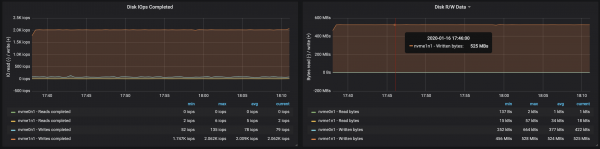
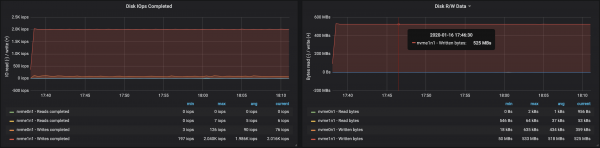
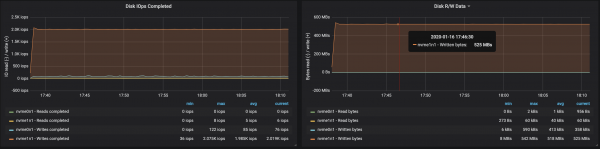
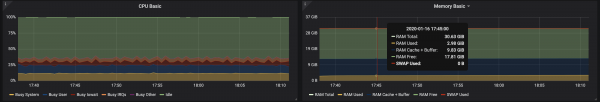
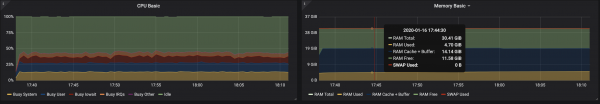
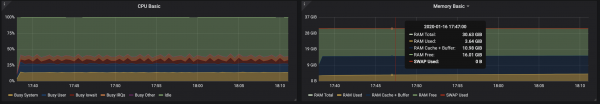
Uit de gegevens over het geheugengebruik door de nodes blijkt dat systeembuffering en caching ongeveer 10-15 GB in beslag namen:
3 brokers, berichtgrootte - 100 bytes
Met de vermindering van de berichtgrootte daalt de doorvoer met ongeveer 15-20%: dit heeft te maken met de tijd die nodig is voor de verwerking van elk bericht. Bovendien is de belasting op de processor bijna verdubbeld.
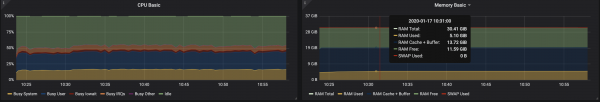
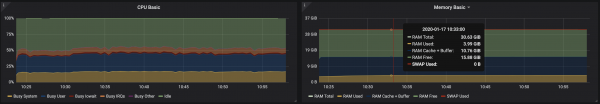
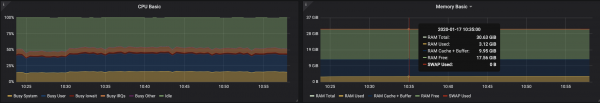
Aangezien er nog ongebruikte cores op de broker-nodes zijn, kan de prestatie worden verbeterd door de Kafka-configuratie aan te passen. Dit is een complexe taak, daarom is het beter om met grotere berichten te werken om de doorvoer te verhogen.
4 brokers, berichtgrootte - 512 bytes
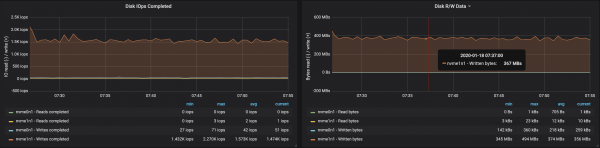
De prestaties van het Kafka-cluster kunnen eenvoudig worden verhoogd door gewoon nieuwe brokers toe te voegen en de balans van de partitions te behouden (dit zorgt voor een evenwichtige verdeling van de belasting tussen brokers). In ons geval steeg de doorvoer van het cluster na het toevoegen van een broker tot ~580 MB/s (~1,1 miljoen berichten per seconde). De stijging was minder dan verwacht: dit werd voornamelijk toegeschreven aan de ongelijkheid van de partitions (niet alle brokers opereren op volle capaciteit).
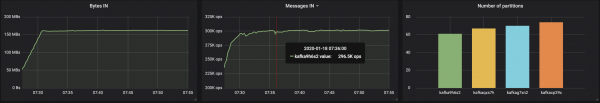
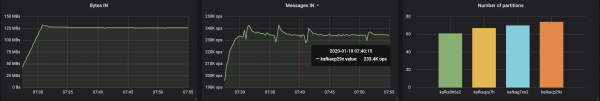
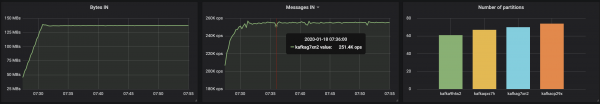
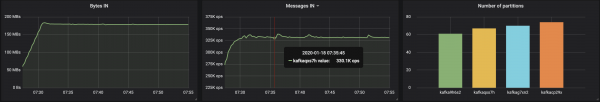
Het geheugengebruik door de JVM-machine blijft onder de 2 GB:
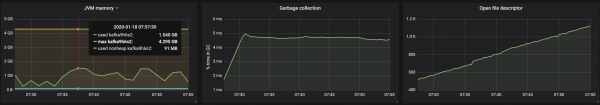
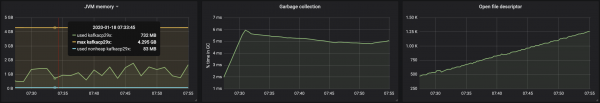
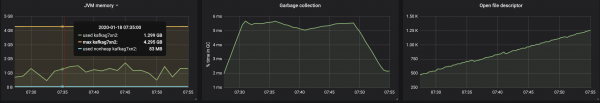
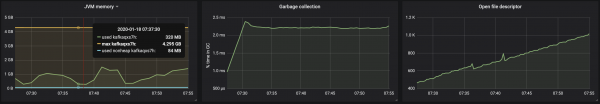
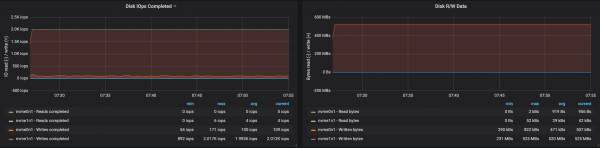
De werking van brokers met opslagmedia wordt beïnvloed door de disbalans van partitionen:
Conclusies
De hierboven gepresenteerde iteratieve aanpak kan worden uitgebreid om meer complexe scenario's te omvatten, inclusief honderden consumers, repartitioning, rolling updates, pod-herstarts, enz. Dit stelt ons in staat om de grenzen van de mogelijkheden van de Kafka-cluster onder verschillende omstandigheden te evalueren, knelpunten in de werking te identificeren en manieren te vinden om deze aan te pakken.
We hebben Supertubes ontwikkeld voor het snelle en gemakkelijke uitrollen van de cluster, het configureren ervan, het toevoegen/verwijderen van brokers en topics, het reageren op meldingen en het waarborgen van de correcte werking van Kafka in Kubernetes in het algemeen. Ons doel is om je te helpen je te concentreren op de kerntaak ('berichten genereren' en 'consumeren') en al het zware werk aan Supertubes en de Kafka-operator over te laten.
Als je geïnteresseerd bent in de technologieën en Open Source-projecten van Banzai Cloud, volg het bedrijf dan op , of .
P.S. van de vertaler
Lees ook op onze blog:
- «»;
- «»;
- «».
Bron: habr.com
